Cuando un agente de voz falla en llamadas reales, el LLM o la voz suelen ser la causa menos probable. El problema empieza un paso antes, en el audio que escucha el agente, ya sea que entre en un sistema de voz a texto (STT) o directamente en un modelo de voz a voz. Los STT modernos manejan bien el tráfico y el aire acondicionado. Lo que no pueden manejar es una segunda persona hablando: un colega, una televisión, el agente del escritorio contiguo en un centro de llamadas. Los escucha también, y el agente actúa según palabras que la persona que llama nunca dijo.
Krisp Voice Isolation se sitúa delante del STT y elimina todas las voces excepto la del hablante principal. Para esta reseña leí el benchmark y la documentación de Krisp, me registré en la API de autoservicio y pasé ocho grabaciones reales del conjunto de datos público de Krisp a través de ella. Luego transcribí el audio antes y después con un modelo STT de código abierto para ver qué cambió realmente.
El veredicto breve: si tu agente recibe llamadas desde oficinas, hogares, centros de llamadas o cualquier lugar donde haya gente hablando de fondo, Voice Isolation merece un lugar en tu pipeline. En mi prueba, el habla de fondo que se había convertido en 331 palabras de transcripción falsa cayó a cero. Las contrapartidas son reales pero pequeñas: un ligero costo en audio telefónico limpio, una API disponible solo en la región de EE. UU. y menos modelos en la API que en el SDK.
El problema: voces de fondo, no ruido de fondo
Los modelos STT están entrenados para captar el habla, no para decidir qué habla es relevante. El ruido se puede filtrar porque no se parece al habla. Una segunda voz se parece exactamente al habla, porque lo es.
El propio ejemplo de Krisp es muy ilustrativo. Una persona llama para cancelar una suscripción mientras un colega cercano pregunta por el almuerzo. El STT devuelve un único flujo de palabras sin nada que marque cuáles vinieron de la persona que llama, así que el agente recibe ambas como una sola petición.
Eso rompe un agente de voz de tres maneras:
- Transcripciones incorrectas. Las palabras del espectador terminan en la transcripción, y el LLM responde a cosas que la persona que llama nunca dijo.
- Interrupciones falsas. El agente escucha al espectador, cree que la persona que llama está interrumpiendo y se detiene a mitad de frase.
- Gestión de turnos rota. El habla de fondo hace que parezca que la persona que llama sigue hablando, así que el agente no puede saber cuándo ha terminado su turno.
En cada caso, la lógica del agente funciona como está diseñada. Está reaccionando a una voz que nunca debería haber oído.
Las cifras muestran la magnitud de la brecha. En la prueba de lanzamiento de Voice Isolation 2.5 de Krisp, 10 sistemas STT promediaron una tasa de error de palabras (WER) del 2.10 % en audio limpio de un solo hablante. Con una segunda persona hablando sobre la persona que llama, los mismos sistemas promediaron un 35.92 %. La supresión de ruido no cierra esa brecha, porque la interferencia es habla.
Qué es Krisp Voice Isolation
La API y SDK de Krisp Voice Isolation elimina las voces y el ruido de fondo de un flujo de audio en vivo y solo deja pasar al hablante principal. Está diseñada para agentes de voz con IA, y es la misma tecnología central que Krisp ofrece para llamadas humanas bajo el nombre Background Voice Cancellation (BVC).
Va primero en el pipeline del agente, de modo que todos los modelos posteriores escuchan una sola voz:
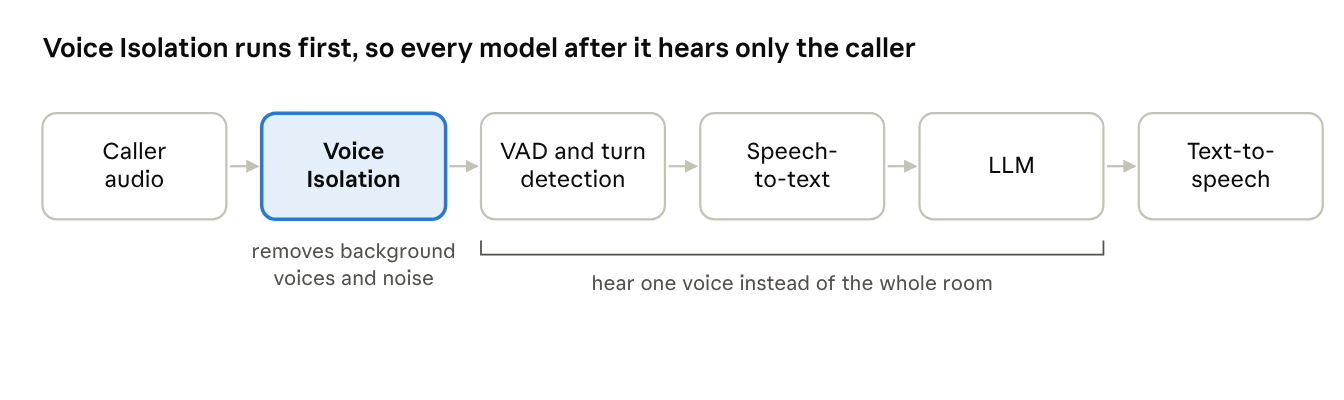
Dónde se sitúa Voice Isolation en el pipeline de un agente de voz
Esa ubicación importa. Sin ella, el VAD y la detección de turnos también escuchan al espectador, que es de donde provienen las interrupciones falsas.
Krisp lleva unos nueve años trabajando en IA de voz y dice que procesa más de 1 billón de minutos de voz al año. Voice Isolation es uno de los productos de su línea de API de IA de voz y SDK. Voice Isolation forma parte de VIVA, el conjunto de modelos en tiempo real de Krisp para agentes de voz, junto con Turn-Taking, Interrupt Prediction y VAD. Funciona junto con la gestión de turnos, no la reemplaza.
Los cuatro modelos te dan control sobre la agresividad con la que se eliminan las voces y el ruido de fondo. Con agresividad máxima (la configuración por defecto), Default es el que más elimina. Balanced procesa la voz principal de forma más ligera, con la misma computación. Lite usa alrededor de un tercio de la computación de Default. HD está pensado para flujos WebRTC de 32 kHz en lugar de audio telefónico. La agresividad es un ajuste en tiempo de ejecución que puedes cambiar sin modificar la computación; en la API es el parámetro suppression_level, de 0 a 100.
Una limitación conviene conocer de antemano: los modelos de eliminación de voz asumen que el hablante está cerca del micrófono. Como guía aproximada, a partir de unos 30 cm la propia voz del hablante principal puede ser suprimida. No es una regla estricta; es una recomendación general, y la distancia real depende de las condiciones acústicas. Para dispositivos de campo lejano como altavoces inteligentes, Krisp ofrece un modelo aparte que solo elimina ruido.
La versión 2.5 se lanzó en agosto de 2026, y Krisp publicó un benchmark abierto y un conjunto de datos en septiembre. El modelo ya está disponible como API de autoservicio además de como SDK.
Lo que muestran los benchmarks de Krisp
En el benchmark abierto de Krisp, Voice Isolation redujo la tasa media de error de palabras del 23.24 % al 6.24 %, una caída del 73 %.
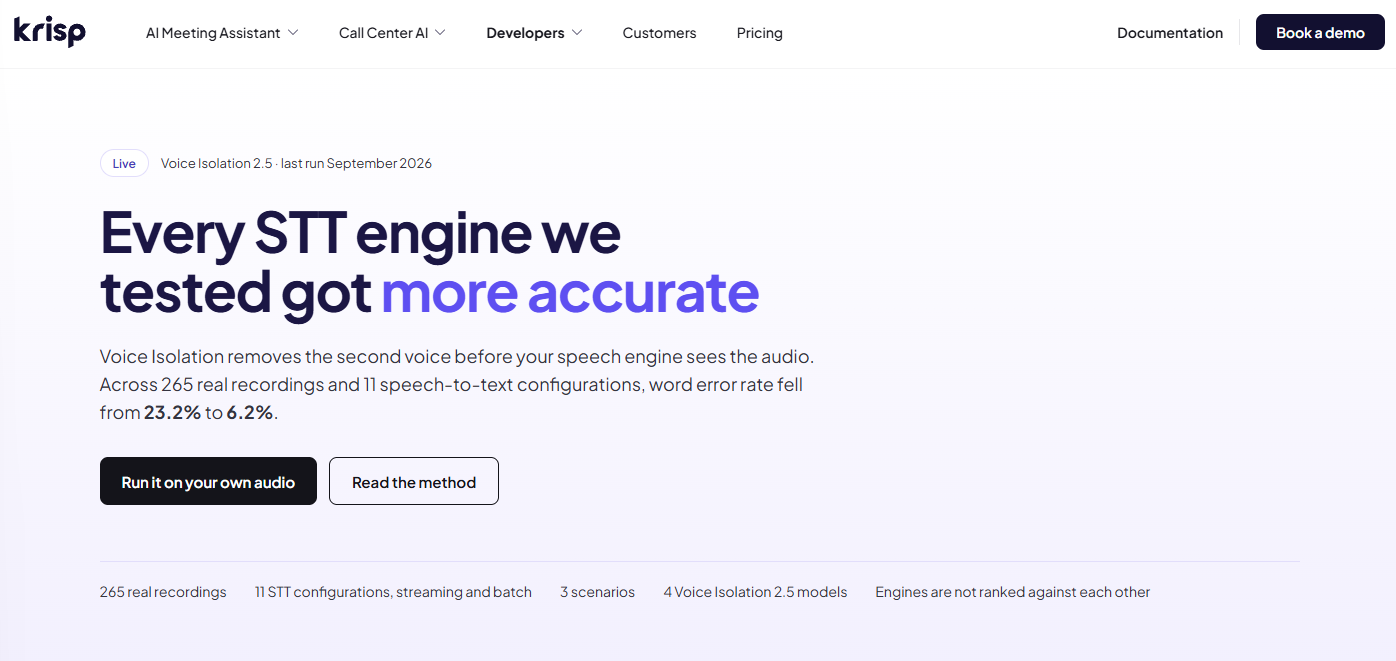
La página del benchmark de Krisp resume el resultado principal.
El benchmark usa 265 grabaciones reales de oficinas, hogares, cuatro plantas de centros de llamadas en funcionamiento y coches. Nada fue simulado ni mezclado después. La mayoría de las grabaciones siguen el mismo guion: el hablante principal habla, una segunda persona se une, el hablante principal se calla mientras la otra sigue hablando, y luego el hablante principal vuelve. Esa ventana de silencio es la prueba real, porque la transcripción correcta para ella está vacía. Cada archivo se pasó por 11 configuraciones STT de nueve motores, con y sin aislamiento.
Fuente: benchmark de voice isolation de Krisp, oct. 2026 · 11 configuraciones STT, todos los escenarios agrupados
Todos los motores mejoraron y ninguno empeoró. El resultado más útil es lo que ocurre con la brecha entre motores: en audio sin procesar tiene unos 20 puntos de ancho, y tras el aislamiento se reduce a unos 5. Si tu agente escucha voces de fondo, limpiar la entrada cambia tu WER más que cambiar de proveedor de STT.
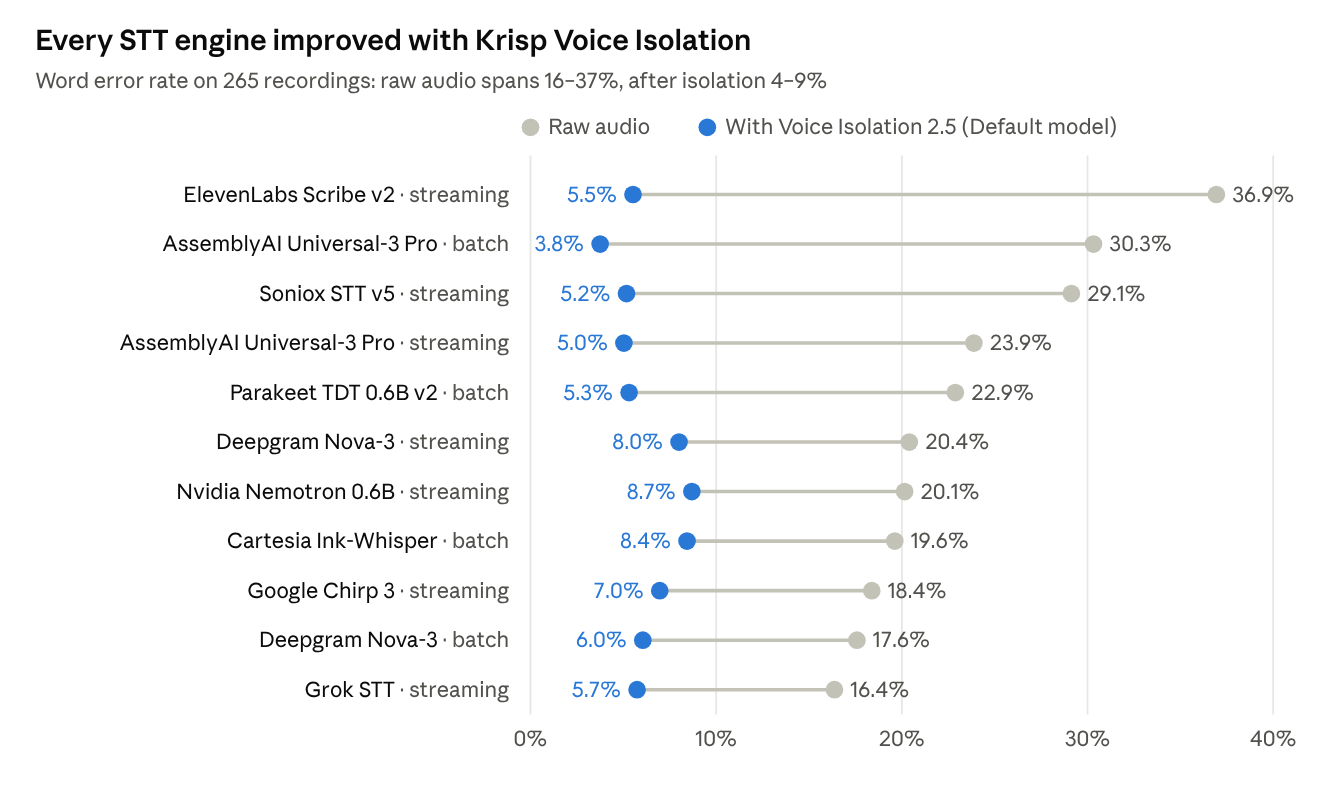
Por escenario, la ganancia depende de si hay una segunda voz presente:
Dónde no ayuda
Krisp publica sus puntos débiles, y creo que esa es la parte más convincente del informe.
- El audio telefónico limpio empeora ligeramente. Sin una segunda voz que eliminar, el aislamiento solo puede afectar a la voz principal. El WER de llamadas telefónicas subió del 3.48 % al 3.91 %, y un archivo pasó del 9.42 % al 21.65 %. El modelo Balanced es el mejor aquí, con un 3.53 %.
- El eco fuerte sigue siendo un problema. En la prueba de lanzamiento de la 2.5 aparte, las grabaciones de un solo hablante con acústica difícil obtuvieron un 11.61 % con aislamiento frente a un 8.02 % sin él. Es mucho mejor que la versión 2.1 (15.42 %), pero sigue siendo peor que no hacer nada.
- La sobreeliminación causa errores silenciosos. Krisp explica que los modelos anteriores a veces eliminaban fragmentos de la voz principal. Una persona seguía entendiendo el audio, pero el STT descartaba cláusulas completas y la transcripción se leía de forma limpia pero con huecos. La versión 2.5 se ajustó para STT en lugar de para oídos humanos para corregir esto.
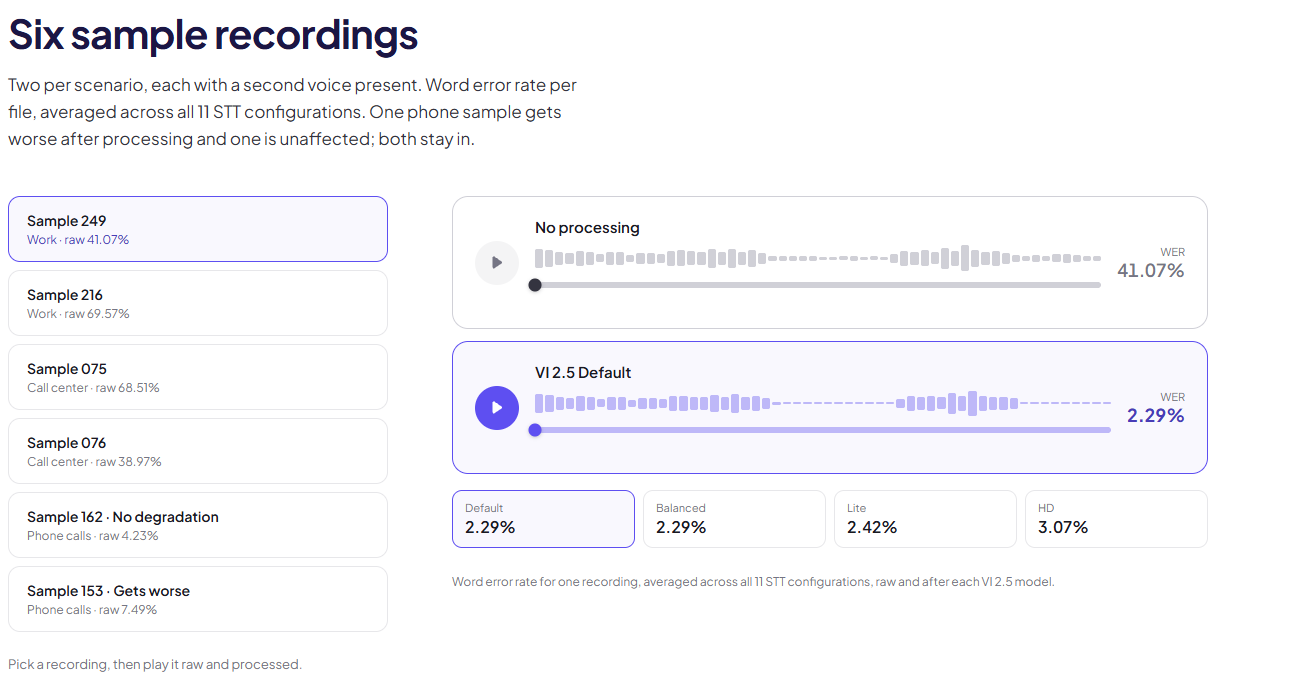
La página del benchmark te permite reproducir seis grabaciones sin procesar y procesadas. La muestra 153, una llamada telefónica, está etiquetada como "Gets worse" (empeora).
Dos cosas más que tener en cuenta. La cifra del 73 % y la del 46.4 % que verás en el sitio de Krisp provienen de pruebas distintas: 265 grabaciones en el benchmark abierto y 1.685 grabaciones en la prueba de lanzamiento de la 2.5. Y los resultados de Krisp comparan audio con y sin su propio aislamiento, no contra los productos de aislamiento de otros proveedores.
Las grabaciones, las transcripciones escritas a mano, las etiquetas de segmentos y la salida de cada modelo están públicas en Hugging Face, así que cualquiera puede repetir la prueba. Eso es lo que hice después.
En la práctica: probando la API de Voice Isolation
En mi prueba, Voice Isolation eliminó todas las palabras del habla de fondo de las transcripciones, y el WER agrupado cayó del 40.1 % al 10.2 %.
Configuración
Registrarse en el Portal para desarrolladores es rápido, con inicio de sesión mediante Google, Microsoft o correo electrónico. La prueba me dio 30 $ en créditos y un límite de dos sesiones simultáneas. Desde ahí es API Keys → Create key, y obtienes una clave que solo puedes copiar una vez.
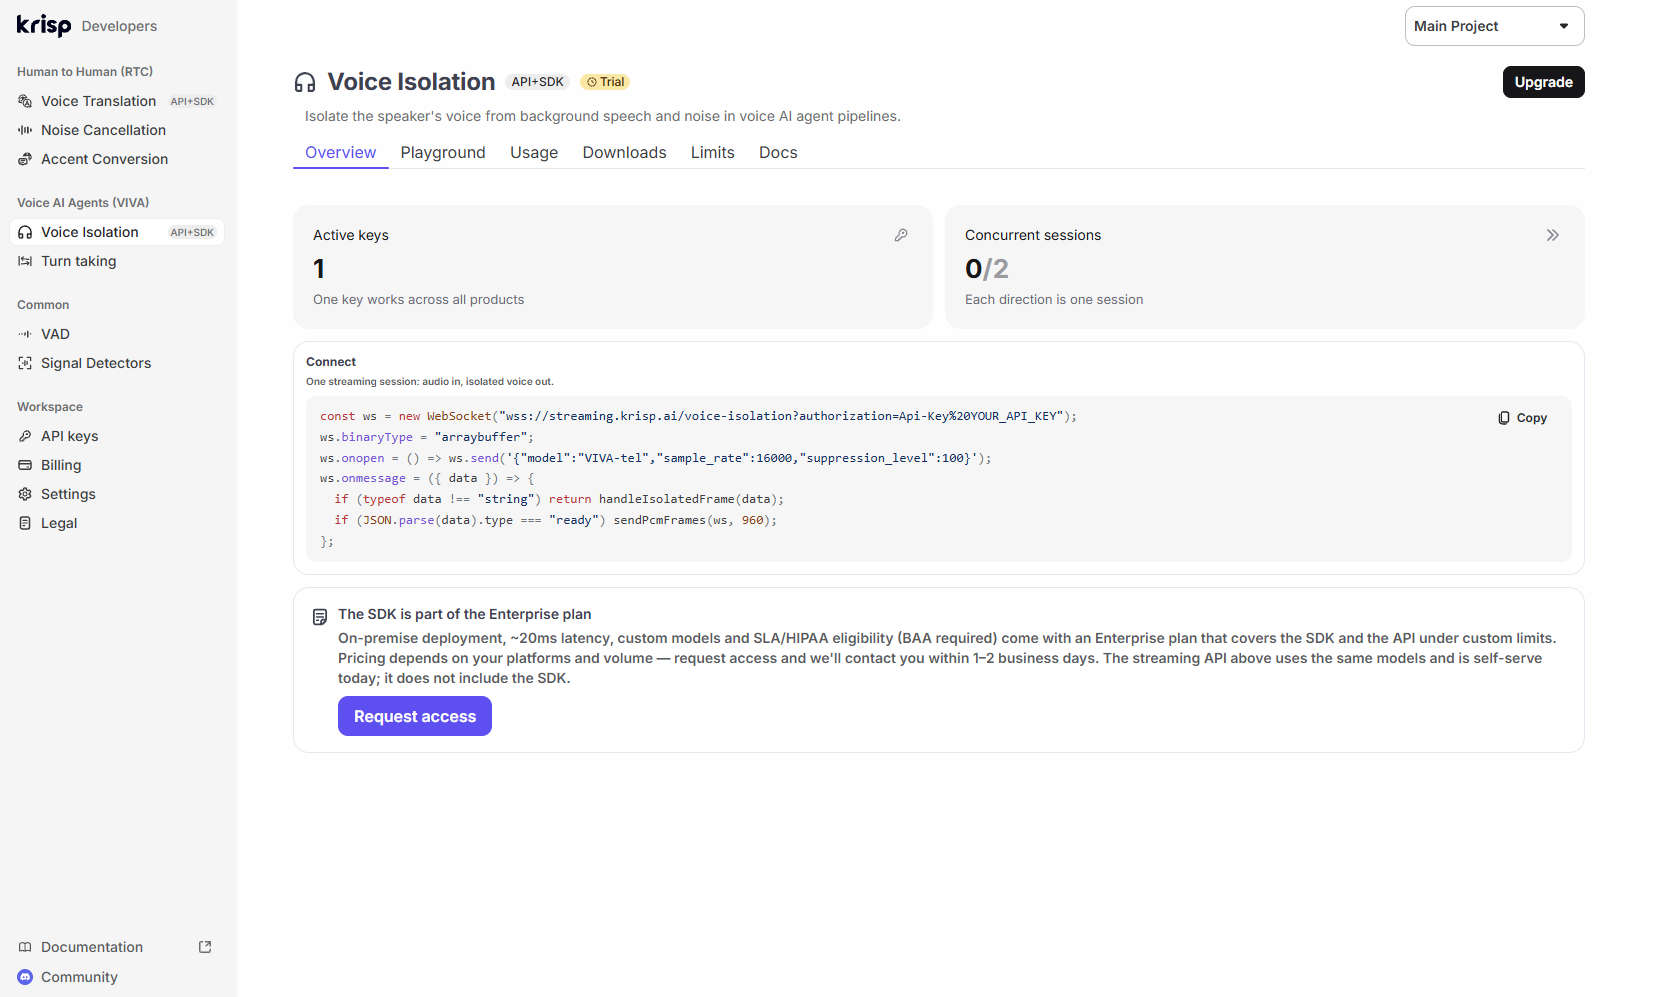
La página de Voice Isolation en el Portal para desarrolladores con el plan de prueba.
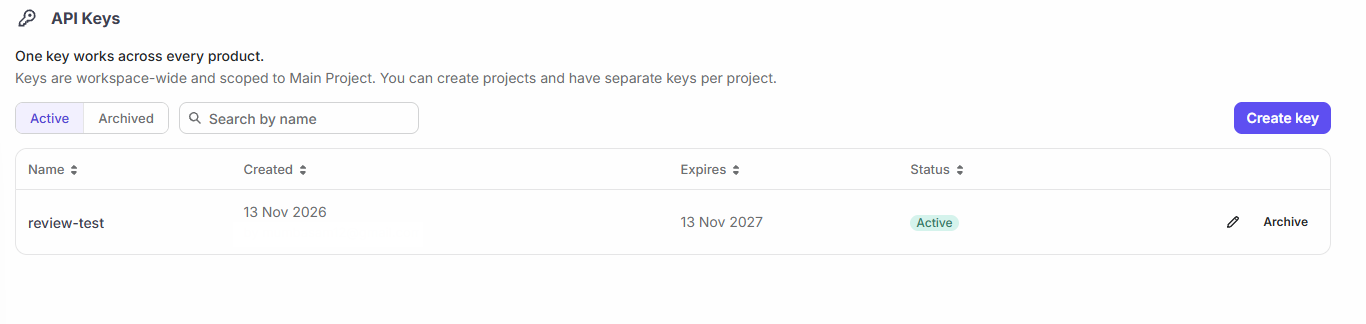
La clave de API que creé para esta reseña. Una sola clave funciona con todos los productos de API de Krisp, incluida la API de Voice Translation. .
La API es un WebSocket. Tu backend canjea la clave de API por un token de sesión de vida corta, el cliente envía un pequeño saludo JSON, espera a ready, y luego transmite PCM mono de 16 bits y recibe el audio limpio fotograma a fotograma:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
Eso está cerca del quickstart de la API de Krisp, un script corto de Python que limpia un archivo WAV. Una regla atrapa a muchos: cada mensaje de audio debe tener exactamente 30 ms. Cualquier otra cosa termina la sesión con un error invalid_frame_duration, así que rellena el último fotograma con silencio.
Para la prueba elegí ocho grabaciones del conjunto de datos público de Krisp: tres grabaciones de oficina, tres de plantas de centros de llamadas y dos llamadas telefónicas desde un coche, unos 11 minutos en total. Transmití cada una a través de la API a velocidad en tiempo real, desde Asia. Luego transcribí el audio sin procesar y el limpio con Parakeet TDT 0.6B v2 de NVIDIA, uno de los motores del benchmark de Krisp, y puntué cada segmento etiquetado contra las transcripciones humanas.
Resultados
Casi toda la mejora vino de un solo lugar: las ventanas donde el hablante principal estaba en silencio y otra persona seguía hablando. En el audio sin procesar, Parakeet convirtió ese habla de fondo en 331 palabras de transcripción. Después de Voice Isolation no produjo ninguna. La voz de fondo quedó entre 13 y 34 dB más silenciosa en esas ventanas, mientras que el nivel del hablante principal apenas se movió (dentro de 1 dB).
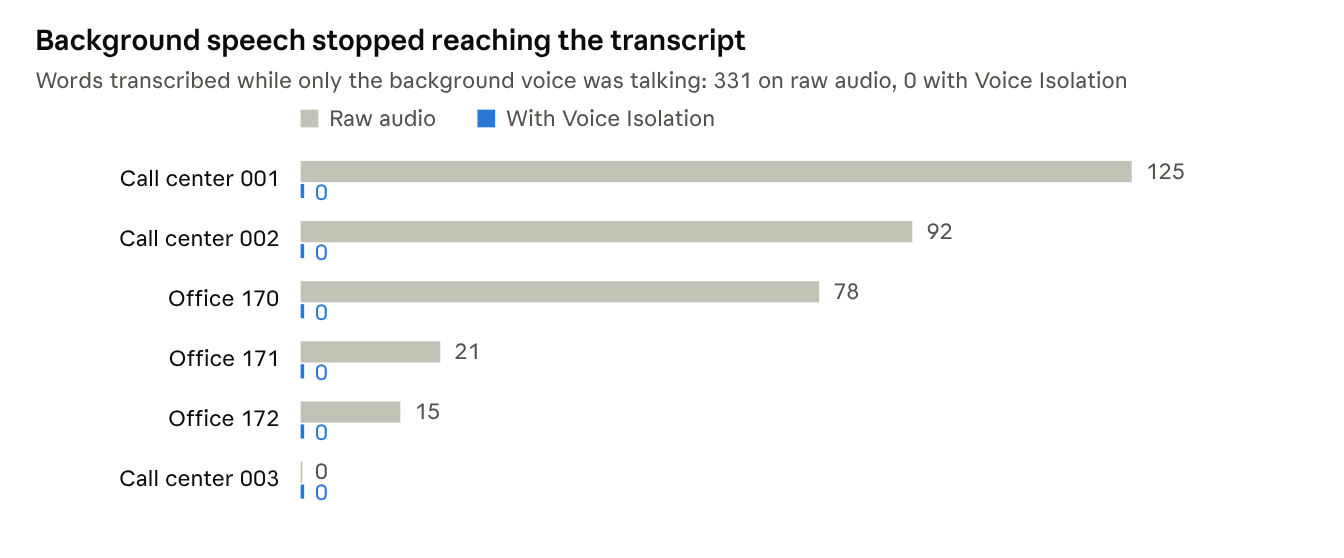
Mi prueba · API de Krisp (VIVA-tel), transcrito con Parakeet TDT 0.6B v2 · las 6 grabaciones con una ventana de solo fondo
El ejemplo del centro de llamadas muestra por qué esto importa. Mientras el agente que estaba probando hacía una pausa, el agente del escritorio contiguo estaba en otra llamada. La transcripción sin procesar recogió esa llamada palabra por palabra:
gracias por llamar al banco meridian antes de empezar necesito confirmar su identidad por seguridad podría darme su nombre completo su fecha de nacimiento...
Un agente de voz trataría eso como si fuera la persona que llama. Con Voice Isolation, la misma ventana volvió vacía.
Cuando ambas personas hablaban a la vez, el cambio fue pequeño: 13.2 % sin procesar frente a 12.5 % limpio. Parakeet ya favorecía a la voz más fuerte y cercana en esos tramos. La mayoría de los errores restantes allí son de formato de números en mi puntuación (números de teléfono, precios, códigos postales), que afectaban por igual a ambas versiones.
En las dos llamadas telefónicas limpias, un archivo acumuló un error extra y el otro perdió dos. Eso coincide con el hallazgo propio de Krisp de que el costo en audio limpio es pequeño.
Latencia y fiabilidad desde fuera de EE. UU.
La API actualmente funciona solo en la región de EE. UU., y la documentación de Krisp advierte que los clientes de otros lugares verán latencia adicional. Desde Asia, el recorrido de ida y vuelta mediano para un fotograma (enviar y recibir el audio limpio) fue de 260–520 ms según la sesión, y configurar una sesión solía tomar entre 1.5 y 3 segundos. Eso es distancia de red, no del modelo: Krisp indica 15 ms de latencia algorítmica. Pero si tu agente sirve a usuarios lejos de EE. UU., lo notarás, y el SDK en tus propios servidores lo evita.
Una de mis nueve sesiones se cayó unos 70 segundos después de empezar con un cierre anormal. Volver a ejecutarla funcionó. Atribuiría eso a la larga ruta desde Asia más que al servicio, pero es un recordatorio para gestionar las reconexiones en producción.
Sobre esta prueba: ocho archivos es una muestra pequeña, no un benchmark. Reamplifiqué las grabaciones de 32 kHz a 16 kHz para el modelo de telefonía (VIVA-tel), usé un solo motor STT y mantuve la normalización de texto simple, así que mis números absolutos no son comparables con los de Krisp. Lo que comprobaba era la dirección y la magnitud del cambio, y coincidió con lo que Krisp reporta.
Experiencia de desarrollador: API o SDK
Voice Isolation se ofrece de dos maneras, y cuál puedas usar depende de tu plan.
La API es la forma más sencilla de empezar: no hay archivos de modelo que distribuir y nada que ejecutar en tu CPU. Las contrapartidas son que tu audio va a la nube de Krisp y que obtienes dos modelos en lugar de cuatro: VIVA-tel para audio telefónico de 8 o 16 kHz, y VIVA-pro para audio de banda ancha de 32 kHz. VIVA-pro aún no aparece en la referencia de la API, pero está en el Playground del portal, la API lo aceptó en mi prueba y Krisp confirmó que está disponible.
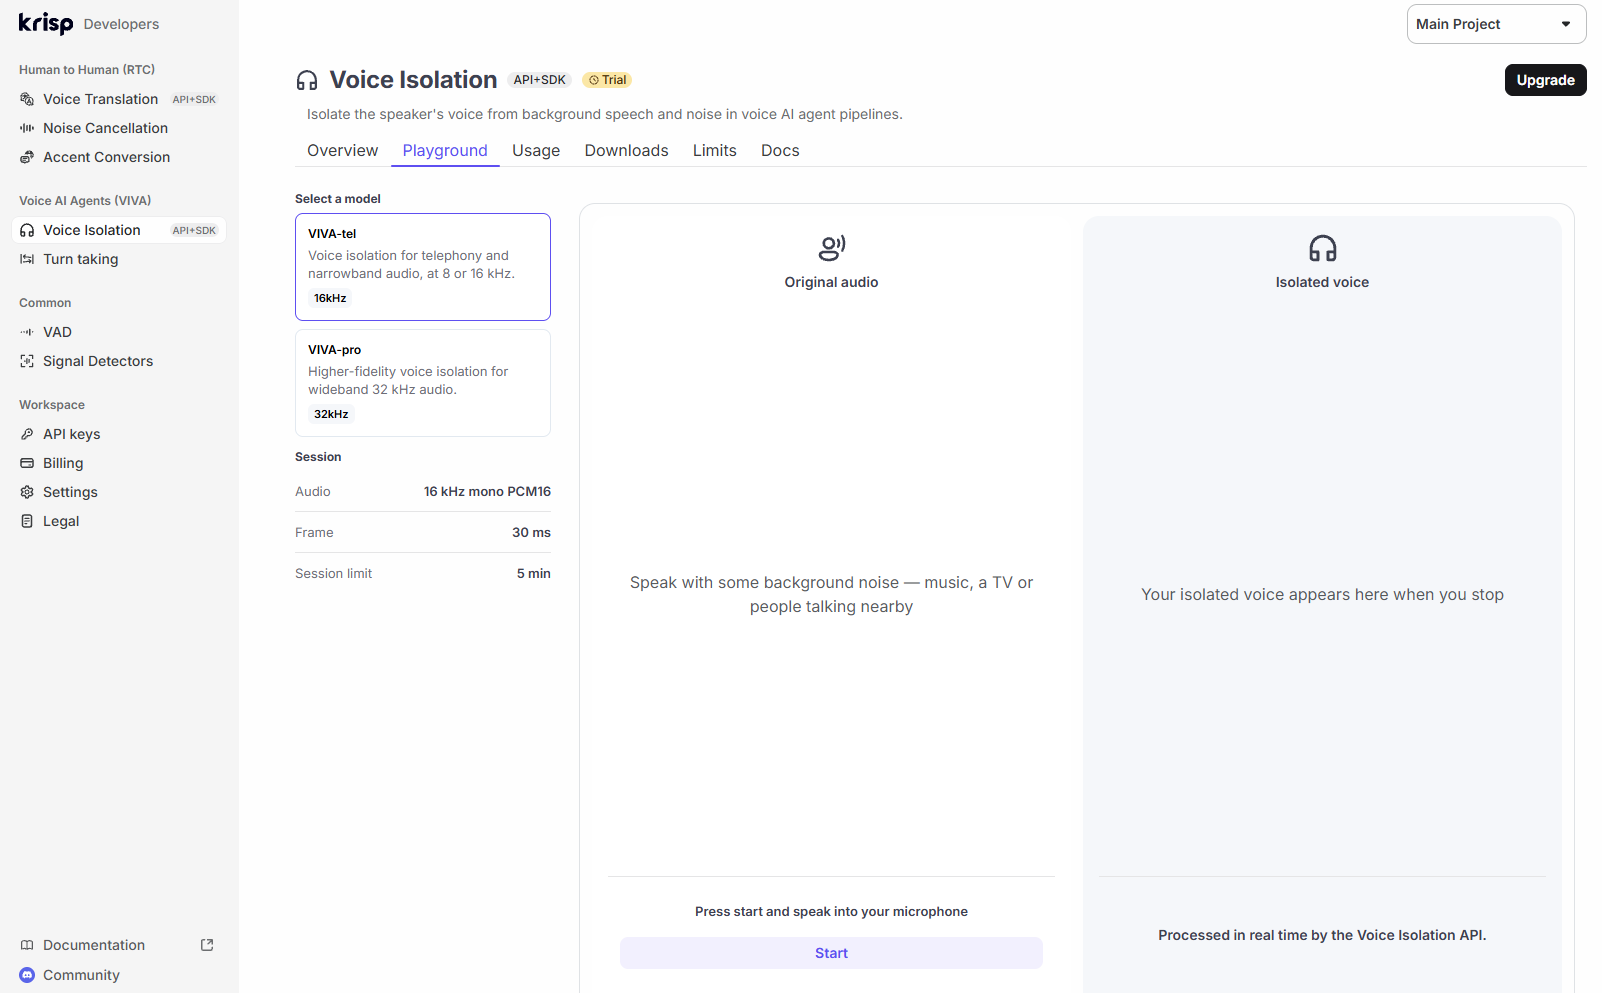
El Playground del portal te permite probar cualquiera de los modelos de la API con tu propio micrófono antes de escribir código.
El SDK mantiene el audio en tus propios servidores y solo se conecta para verificar su licencia. También es donde la historia de costos se pone interesante. La entrada sobre CPU de Krisp muestra que una sola opción del SDK, enableLowPrecisionExecution, aproximadamente duplica las llamadas que un servidor puede limpiar en CPU con soporte FP16. Una instancia AWS Graviton3 de 16 vCPU pasó de 76 llamadas en vivo a 137, y el modelo Lite maneja unas tres veces más flujos que los modelos completos. En chips Intel Ice Lake más antiguos, la opción no hace nada.
Integraciones
- Pipecat tiene un filtro listo para usar. Añades KrispVivaFilter() como filtro de entrada de audio en tu transport, y puedes combinarlo con KrispVivaTurn para la detección de turnos. Ten en cuenta que usa el SDK, así que necesitas acceso al SDK y los archivos de modelo, no solo una clave de API.
- LiveKit ofrece modelos de Krisp en LiveKit Cloud, incluida la cancelación de voz de fondo (noise_cancellation.BVC()) para agentes. LiveKit cobra extra por sus modelos de aislamiento de voz.
- Los pipelines de WebRTC y telefonía pueden usar el SDK directamente, y la API funciona con cualquier cosa que pueda abrir un WebSocket.
La documentación es clara y está al día. El quickstart funcionó a la primera, y los mensajes de error te dicen exactamente qué salió mal, hasta el tamaño de fotograma esperado y recibido. Mi única queja es la nomenclatura: el blog habla de Default, Balanced, Lite y HD, las descargas del SDK usan nombres de archivo como krisp-viva-vi-tel-v2.5.1, y la API llama a sus modelos VIVA-tel y VIVA-pro, con solo el primero en la referencia de la API. Una tabla de equivalencias en la documentación ayudaría.
Precios
La API se factura por hora de audio, y es lo bastante barata como para que el costo no decida si la usas.
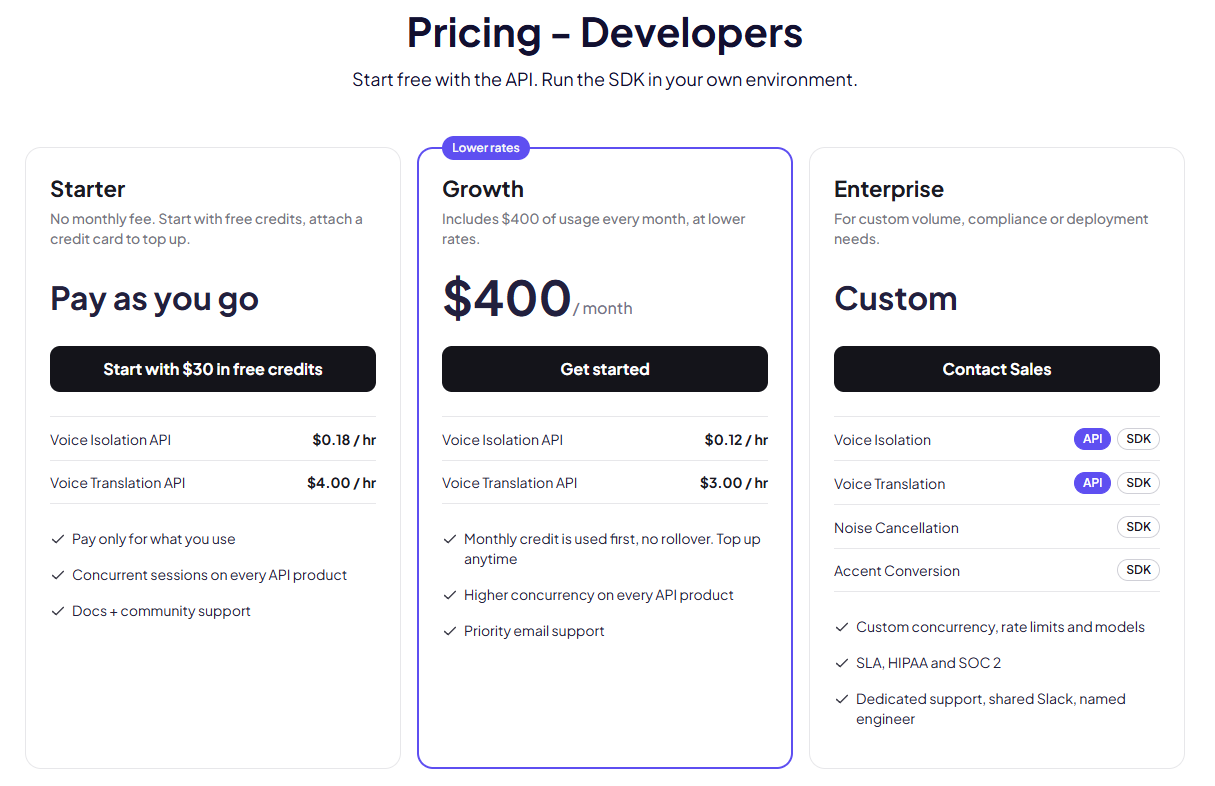
Precios para desarrolladores de Krisp, noviembre de 2026.
En el plan Starter de pago por uso, la API de Voice Isolation cuesta 0.18 $ por hora de audio, sin cuota mensual. La tarifa es la misma para ambos modelos de la API, VIVA-tel y VIVA-pro. Growth cuesta 400 $ al mes, incluye 400 $ de uso y reduce la tarifa a 0.12 $ por hora, con mayor concurrencia y soporte prioritario. Enterprise es personalizado y es el único plan que incluye el SDK, un SLA, y HIPAA y SOC 2.
El crédito inicial de 30 $ cubre unas 166 horas de audio a la tarifa de Starter, lo cual es de sobra para probar. Los créditos duran 12 meses y el uso se factura por minuto. Para dimensionar: una llamada de 5 minutos cuesta alrededor de 1.5 centavos por limpiar en Starter.
El SDK está solo en el plan Enterprise, a un precio acordado, así que tendrás que hablar con ventas si quieres ejecutar los modelos en tus propios servidores. Las tarifas provienen de la página de precios de Krisp, verificadas en noviembre de 2026.
Alternativas
Krisp no es la única opción para eliminar voces de fondo, pero aún no existe una prueba independiente comparativa de estos productos. Cada proveedor publica sus propias cifras sobre sus propios datos, así que trata las cifras siguientes como afirmaciones.
Lo que distingue a Krisp son las pruebas. Es el único proveedor aquí con un benchmark abierto y reproducible en 11 configuraciones STT, y publica los casos en los que pierde. También es el más flexible de desplegar: API en la nube, SDK en el servidor, o integrado en LiveKit y Pipecat.
Veredicto
Krisp Voice Isolation es la solución a la que acudir cuando un agente de voz se comporta mal en llamadas reales y funciona bien en las pruebas. Elimina las voces que tu agente no debería escuchar, funciona con el STT que ya uses, y tanto el benchmark de Krisp como mi propia prueba muestran lo mismo: el habla de fondo deja de llegar a la transcripción.
Pros
- Elimina voces de fondo, no solo ruido, que es el problema que el STT no puede resolver por sí solo
- Funciona con cualquier motor STT, sin configuración por idioma ni registro de voz
- Funciona en CPU con 15 ms de latencia algorítmica
- Benchmark abierto y reproducible que incluye los casos en los que pierde
- API de autoservicio con 30 $ de crédito gratis, y barata a 0.12–0.18 $ por hora
- Filtro de Pipecat listo para usar y soporte en LiveKit
Contras
- Ligero costo de precisión en audio telefónico limpio, y sigue siendo peor que el audio sin procesar en salas con mucho eco
- La API funciona solo en la región de EE. UU., lo que añade una latencia notable en otros lugares
- La API ofrece dos modelos frente a los cuatro del SDK; el uso en instalaciones propias requiere el SDK Enterprise
Quién debería usarlo: equipos cuyos agentes reciben llamadas desde centros de llamadas, oficinas, hogares, coches o cualquier lugar donde haya otras personas hablando cerca. Empieza con la API para medir el efecto en tus propias grabaciones, y luego pasa al SDK si necesitas los otros modelos, menor latencia fuera de EE. UU., o audio que se quede en tus servidores.
Quién puede prescindir de él: agentes cuyos usuarios llaman casi siempre solos desde habitaciones silenciosas, o dispositivos de campo lejano como altavoces inteligentes, para los que los modelos de eliminación de voz no están diseñados.
Puedes probar la API de Krisp Voice Isolation con los créditos gratuitos y pasar tus propias grabaciones por ella en una tarde.
Preguntas frecuentes
¿El aislamiento de voz es lo mismo que la cancelación de ruido? No. La cancelación de ruido elimina sonidos que no son habla, como el tráfico o los teclados. El aislamiento de voz también elimina las voces de otras personas, que la cancelación de ruido deja pasar.
¿Krisp Voice Isolation funciona con mi proveedor de STT? Sí. Procesa el audio por sí mismo, así que funciona delante de cualquier motor STT. Krisp lo probó con 11 configuraciones, incluidos modelos de Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia y NVIDIA. También puede situarse delante de modelos de voz a voz. Krisp aún no ha publicado resultados para esa configuración, pero nada te impide probarlo.
¿Reemplaza la detección de turnos? No. Va antes del VAD y de la detección de turnos y les proporciona un audio más limpio. Krisp ofrece Turn-Taking como modelo aparte en el mismo SDK de VIVA.
¿Los usuarios tienen que registrar su voz? No. No necesita registro ni entrenamiento con la voz del usuario.
¿Cuánta latencia añade? Krisp indica 15 ms de latencia algorítmica, y su documentación del SDK sitúa la latencia añadida en unos 20 ms. Con la API en la nube, el tiempo de red hasta la región de EE. UU. se suma a eso.
¿Funciona en llamadas telefónicas? Sí. Maneja audio de telefonía de banda estrecha, códecs comunes como G.711, G.722, G.729 y Opus, y auriculares Bluetooth.
¿Y en llamadas entre personas? La misma tecnología se ofrece como Background Voice Cancellation (BVC) en el SDK RTC de Krisp, que se ejecuta en el dispositivo del usuario en navegadores y aplicaciones de escritorio y móviles. Los centros de contacto con agentes humanos lo obtienen a través del producto de IA para centros de llamadas de Krisp, donde mantiene las voces de los agentes cercanos fuera de las llamadas de los clientes.