
Moonshot AI lanzó Kimi K3 el 16 de julio de 2026, y la cobertura del lanzamiento lo presentó como un desafío directo a Anthropic. TechCrunch informó que se esperaba que K3 redujera la brecha con los modelos de código cerrado, citando fuentes que dijeron que podría igualar o incluso superar a Claude Opus 4.8. Este artículo compara dimensión por dimensión, con los números que podemos verificar y los que no podemos, claramente marcados.
La versión corta: K3 gana en precio, ventana de contexto y apertura; Opus 4.8 ofrece las garantías de un proveedor gestionado maduro. Dado que ambos utilizan el formato OpenAI SDK, puedes ejecutar la misma solicitud a través de cada uno y comparar las salidas, la latencia y el costo en una herramienta como Apidog.
TL;DR y el veredicto de un vistazo
Kimi K3 es un modelo de mezcla de expertos de 2.8 billones de parámetros con una ventana de contexto de 1 millón de tokens, precios de entrada económicos y pesos abiertos que llegarán alrededor del 27 de julio de 2026. Claude Opus 4.8 es un modelo propietario cerrado de la línea Opus de Anthropic, con un precio más alto, y una sólida reputación en razonamiento y capacidades de agente. La puntuación independiente de Artificial Analysis sitúa a K3 en un Índice de Inteligencia de 57, ocupando el puesto #4 de 189 modelos, el mejor de su clase entre los pesos abiertos.
Aquí está un resumen rápido:
- Elige Kimi K3 para una ventana de contexto muy grande, bajo costo a alto volumen, o la capacidad de autoalojar y ajustar pesos abiertos.
- Elige Claude Opus 4.8 para una relación con un proveedor maduro, soporte gestionado y SLAs, y un largo historial de producción en trabajos de agente complejos, si estás dispuesto a pagar el extra.
- Está cerca, no decidido. Todavía no existe una tabla de referencia independiente y comparable de K3 versus Opus 4.8, así que trata con cautela cualquier titular que diga "uno supera al otro en general".
Una nota aclaratoria. El modelo principal de Anthropic actualmente disponible es Claude Fable 5; Opus 4.8 es un nivel fuerte por debajo de esa frontera, no el modelo insignia. El blog de lanzamiento de Moonshot dice que K3 "todavía está por detrás de los modelos propietarios más potentes, Claude Fable 5 y GPT 5.6 Sol", nombrando a Fable 5 y Sol, no a Opus. Así que la historia honesta no es "modelo abierto destrona a Anthropic". Es "modelo abierto cierra la brecha, gana en precio, contexto y apertura, y solo está por detrás en el nivel más alto de calidad".
El lanzamiento y por qué existe esta comparación
K3 es el mayor avance de Moonshot en la escala de modelos de pesos abiertos, y con un total de 2.8 billones de parámetros, es el modelo de pesos abiertos más grande de China hasta la fecha. La arquitectura se basa en Kimi Delta Attention, Attention Residuals y un diseño que Moonshot denomina Stable LatentMoE, que activa 16 de 896 expertos por token. Moonshot no ha publicado el recuento de parámetros activos, por lo que no lo estimaremos. El explicador fundamental sobre qué es Kimi K3 cubre la arquitectura y el acceso en su totalidad.
La comparación existe porque las empresas siguen preguntándose si los costosos modelos cerrados valen la pena cuando un modelo de pesos abiertos se acerca en calidad y se ejecuta en su propio hardware. El planteamiento se convirtió en "K3 vs Opus 4.8" en lugar de "K3 vs Fable 5" porque Opus 4.8 es el nivel donde un contendiente abierto tiene una oportunidad plausible. El informe de TechCrunch ofrece el contexto del mercado.
Kimi K3 y Claude Opus 4.8 de un vistazo
Aquí está la comparación lado a lado de las dimensiones que influyen en una decisión de compra. Donde una cifra no está confirmada públicamente, la celda lo indica.
| Dimensión | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Proveedor | Moonshot AI | Anthropic |
| Lanzamiento | 16 de julio de 2026 | Parte de la línea Claude Opus 4 |
| Tipo de modelo | MoE de 2.8T parámetros (Stable LatentMoE, 16 de 896 expertos activos) | Propietario, arquitectura no revelada |
| ID del modelo / acceso | kimi-k3, compatible con OpenAI SDK |
API de Claude (familia claude-opus-4-8) |
| Ventana de contexto | 1,048,576 tokens (1M) | Grande, pero por debajo de la ventana de 1M de K3 |
| Precio de entrada | $0.30 / M acierto de caché, $3.00 / M fallo de caché | $5.00 / M |
| Precio de salida | $15.00 / M | $25.00 / M |
| Velocidad de salida | ~62 tokens/seg (Artificial Analysis) | No citado aquí; ver Artificial Analysis |
| Puntuación independiente | Índice de Inteligencia 57, #4 de 189 (Artificial Analysis) | Nivel propietario superior (ver Artificial Analysis) |
| Pesos | Pesos abiertos, alrededor del 27 de julio de 2026 | Cerrado |
| Posición de calidad | El mejor entre los abiertos; detrás de Fable 5 y GPT 5.6 Sol (Moonshot) | Nivel propietario fuerte por debajo de la frontera Fable 5 de Anthropic |
La mayoría de las celdas favorecen a K3 en economía y acceso. La calidad es la fila en disputa, y la analizaremos a continuación.
Inteligencia y calidad: donde el nivel superior aún se mantiene
La calidad es la dimensión más difícil de precisar, porque aún no existe un benchmark independiente compartido que compare K3 y Opus 4.8 directamente. La señal independiente más clara es Artificial Analysis, cuyo Índice de Inteligencia sitúa a K3 en o cerca de la frontera en una combinación de evaluaciones de razonamiento, codificación y conocimiento, y como el modelo de pesos abiertos mejor clasificado en esa tabla. También señala que K3 funciona más lento que el promedio y es verboso.
El contrapeso proviene de la propia Moonshot. Su blog de lanzamiento es franco: el rendimiento general de K3 "todavía está por detrás de los modelos propietarios más potentes, Claude Fable 5 y GPT 5.6 Sol". Esa frase nombra a Fable 5 y Sol, no a Opus 4.8. Así que la propia admisión de Moonshot sitúa a K3 por detrás de Fable 5 y Sol, y no dice nada sobre que K3 pierda frente a Opus 4.8.
La tabla de benchmarks del proveedor lo respalda. Según los números de lanzamiento de Moonshot, con la configuración de razonamiento máxima, K3 supera a Opus 4.8 en todos los benchmarks listados:
| Benchmark | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
Estas son cifras proporcionadas por el proveedor, no una comparación independiente directa: un laboratorio publica los conjuntos donde se ve bien. Pero son los números reales publicados por Moonshot, y muestran a K3 por delante de Opus 4.8 en todos los aspectos, incluyendo DeepSWE, la métrica de codificación de agentes más difícil del conjunto. Para una vista con etiquetas de origen, consulta el desglose de los benchmarks de Kimi K3, y para el par fronterizo que realmente supera a K3, Kimi K3 vs GPT-5.6 Sol. La conclusión honesta: con los números que tenemos, K3 está al menos a la par con Opus 4.8 y por delante en el propio conjunto de Moonshot. Las ventajas reales de Opus 4.8 no son las puntuaciones de los benchmarks; son la madurez de las herramientas de Anthropic, su historial de fiabilidad y las garantías de un proveedor gestionado.
Precio: la mayor brecha
El costo es donde los dos divergen más, y los números están publicados. Kimi K3 cobra $0.30 por millón de tokens para la entrada con acierto de caché, $3.00 para la entrada con fallo de caché y $15.00 para la salida. Claude Opus 4.8 cobra $5.00 por entrada y $25.00 por salida. Así, K3 es drásticamente más barato en la entrada en caché ($0.30 vs $5.00), todavía menos de la mitad de precio en un fallo de caché ($3.00 vs $5.00), y un 40% más barato en la salida ($15.00 vs $25.00).
Para una carga de trabajo con mucho contexto repetido, como un chatbot que reenvía el mismo prompt de sistema y documentos, el precio de acierto de caché de K3 se acumula en un gran ahorro, y para la generación de alto volumen, la brecha de precio de salida por sí sola puede reestructurar una factura mensual. Para modelar tu propio tráfico, la guía de precios de Kimi K3 explica los niveles, y la publicación sobre precios de Claude Opus 4.8 hace lo mismo por parte de Anthropic.
Una advertencia: más barato por token no siempre significa más barato por tarea. Un modelo verboso puede anular parte de su ventaja por token al generar más tokens, y Artificial Analysis señala a K3 como verboso, así que mide el costo total en prompts reales, no en la lista de tarifas.
Ventana de contexto: espacio para trabajar
El contexto es una clara victoria para K3 sobre el papel. Kimi K3 expone una ventana de 1,048,576 tokens, suficiente para contener bases de código muy grandes, conjuntos de documentos extensos o historiales multirrespuesta prolongados en una sola solicitud sin una segmentación agresiva. Claude Opus 4.8 también ofrece una ventana grande, pero por debajo del límite de 1M de K3.
Si tu carga de trabajo es realmente de contexto largo (un repositorio completo, un conjunto de contratos del tamaño de un libro, un corpus de investigación largo en un solo prompt), K3 ofrece más margen antes de que necesites construir maquinaria de recuperación. Pero una ventana más grande es una capacidad, no una garantía de calidad en todo el rango, así que valida que las respuestas sigan siendo precisas incluso con un prompt de un millón de tokens antes de confiar en ello.
Apertura: pesos abiertos versus cerrados
La apertura cambia lo que se te permite hacer con el modelo, y ninguna cantidad de precios o benchmarks lo sustituye. Los pesos de Kimi K3 se lanzarán alrededor del 27 de julio de 2026, abriendo opciones que un modelo cerrado no puede: autoalojamiento para residencia de datos o entornos aislados, ajuste fino con tus propios datos y libertad de los límites de tarifas o la hoja de ruta de un único proveedor. Para las industrias reguladas, "los pesos se ejecutan en nuestro hardware" puede ser el factor decisivo independientemente de las puntuaciones de los benchmarks.
Claude Opus 4.8 es cerrado. Lo alcanzas a través de la API de Anthropic y obtienes un servicio gestionado: alojamiento consistente, una relación de soporte, políticas publicadas y ninguna infraestructura que gestionar. La documentación de la API de Anthropic cubre la familia de modelos. K3 te otorga control y responsabilidad; Opus te ofrece comodidad y un proveedor en quien apoyarte.
Velocidad y latencia
La velocidad es más compleja que un solo número. Artificial Analysis mide K3 en aproximadamente 62 tokens de salida por segundo, por debajo de la mediana de ~73 para su nivel de precio, aunque su tiempo hasta el primer token es rápido, ~1.99 segundos. Así, K3 se siente responsivo al inicio de una respuesta, pero genera el cuerpo lentamente, y una salida verbosa hace que las finalizaciones largas se sientan aún más lentas. No tenemos una cifra independiente comparable para Opus 4.8, así que compara ambos con tus propios prompts si el rendimiento en salidas largas es importante.
Matriz de decisión por carga de trabajo
En lugar de coronar un ganador, asigna el modelo a la tarea.
| Carga de trabajo | Mejor ajuste | Por qué |
|---|---|---|
| Tareas de contexto muy largo (repositorios completos, grandes conjuntos de documentos) | Kimi K3 | La ventana de 1M de tokens reduce el trabajo de segmentación y recuperación |
| Generación de alto volumen y sensible al costo | Kimi K3 | Tarifas de entrada y salida más bajas, fuerte precio de acierto de caché |
| Autoalojamiento, residencia de datos o ajuste fino | Kimi K3 | Pesos abiertos alrededor del 27 de julio de 2026 |
| Techo de calidad más difícil en razonamiento y agentes | Probar ambos | Disputado: los propios benchmarks de lanzamiento de Moonshot ponen a K3 por delante de Opus 4.8, pero esos son ejecutados por el proveedor y Opus tiene un historial de producción más largo en agentes complejos |
| Fiabilidad y soporte de misión crítica | Claude Opus 4.8 | Servicio comercial gestionado con SLAs, soporte y políticas publicadas |
| Aplicaciones interactivas sensibles a la latencia | Probar ambos | K3 tiene un tiempo rápido hasta el primer token pero una generación más lenta y verbosa |
| Prototipos y proyectos secundarios con presupuesto limitado | Kimi K3 | Ruta más económica para una calidad cercana a la frontera |
K3 domina la economía, el contexto y el control, y según los propios benchmarks de Moonshot, también iguala o supera a Opus 4.8 en calidad. Lo que posee Opus 4.8 es la comodidad de un proveedor gestionado. La mayoría de los equipos encontrarán que algunas cargas de trabajo apuntan en una dirección y otras en la contraria, así que mantén ambos al alcance en lugar de estandarizar en uno solo.
Casos de uso en el mundo real
Una startup que desarrolla un producto de análisis de documentos. Contratos largos, alto volumen de consultas, márgenes ajustados. El contexto de 1M de K3 y sus bajos precios encajan casi a la perfección, y los pesos abiertos ofrecen una ruta de autoalojamiento si la residencia de datos se convierte en un requisito más adelante.
Una empresa que automatiza flujos de trabajo de agentes de varios pasos. La fiabilidad importa y los errores son costosos. Los benchmarks de Moonshot sitúan a K3 por delante, pero el historial de producción más largo de Opus 4.8 es lo que algunos equipos pagan un extra hasta que esos números se reproduzcan.
Un banco regulado que no puede enviar datos a APIs de terceros. El debate sobre los benchmarks es irrelevante: los pesos abiertos de K3 se ejecutan dentro del propio entorno del banco, mientras que Opus 4.8 como servicio API cerrado puede estar completamente descartado.
Probando ambos contra la misma solicitud en Apidog
Las comparaciones en papel solo te llevan hasta cierto punto. Dado que Kimi K3 es compatible con el SDK de OpenAI y Claude Opus 4.8 es accesible a través de su propia API, puedes configurar ambos como solicitudes en Apidog y enviar la misma carga útil a cada uno.
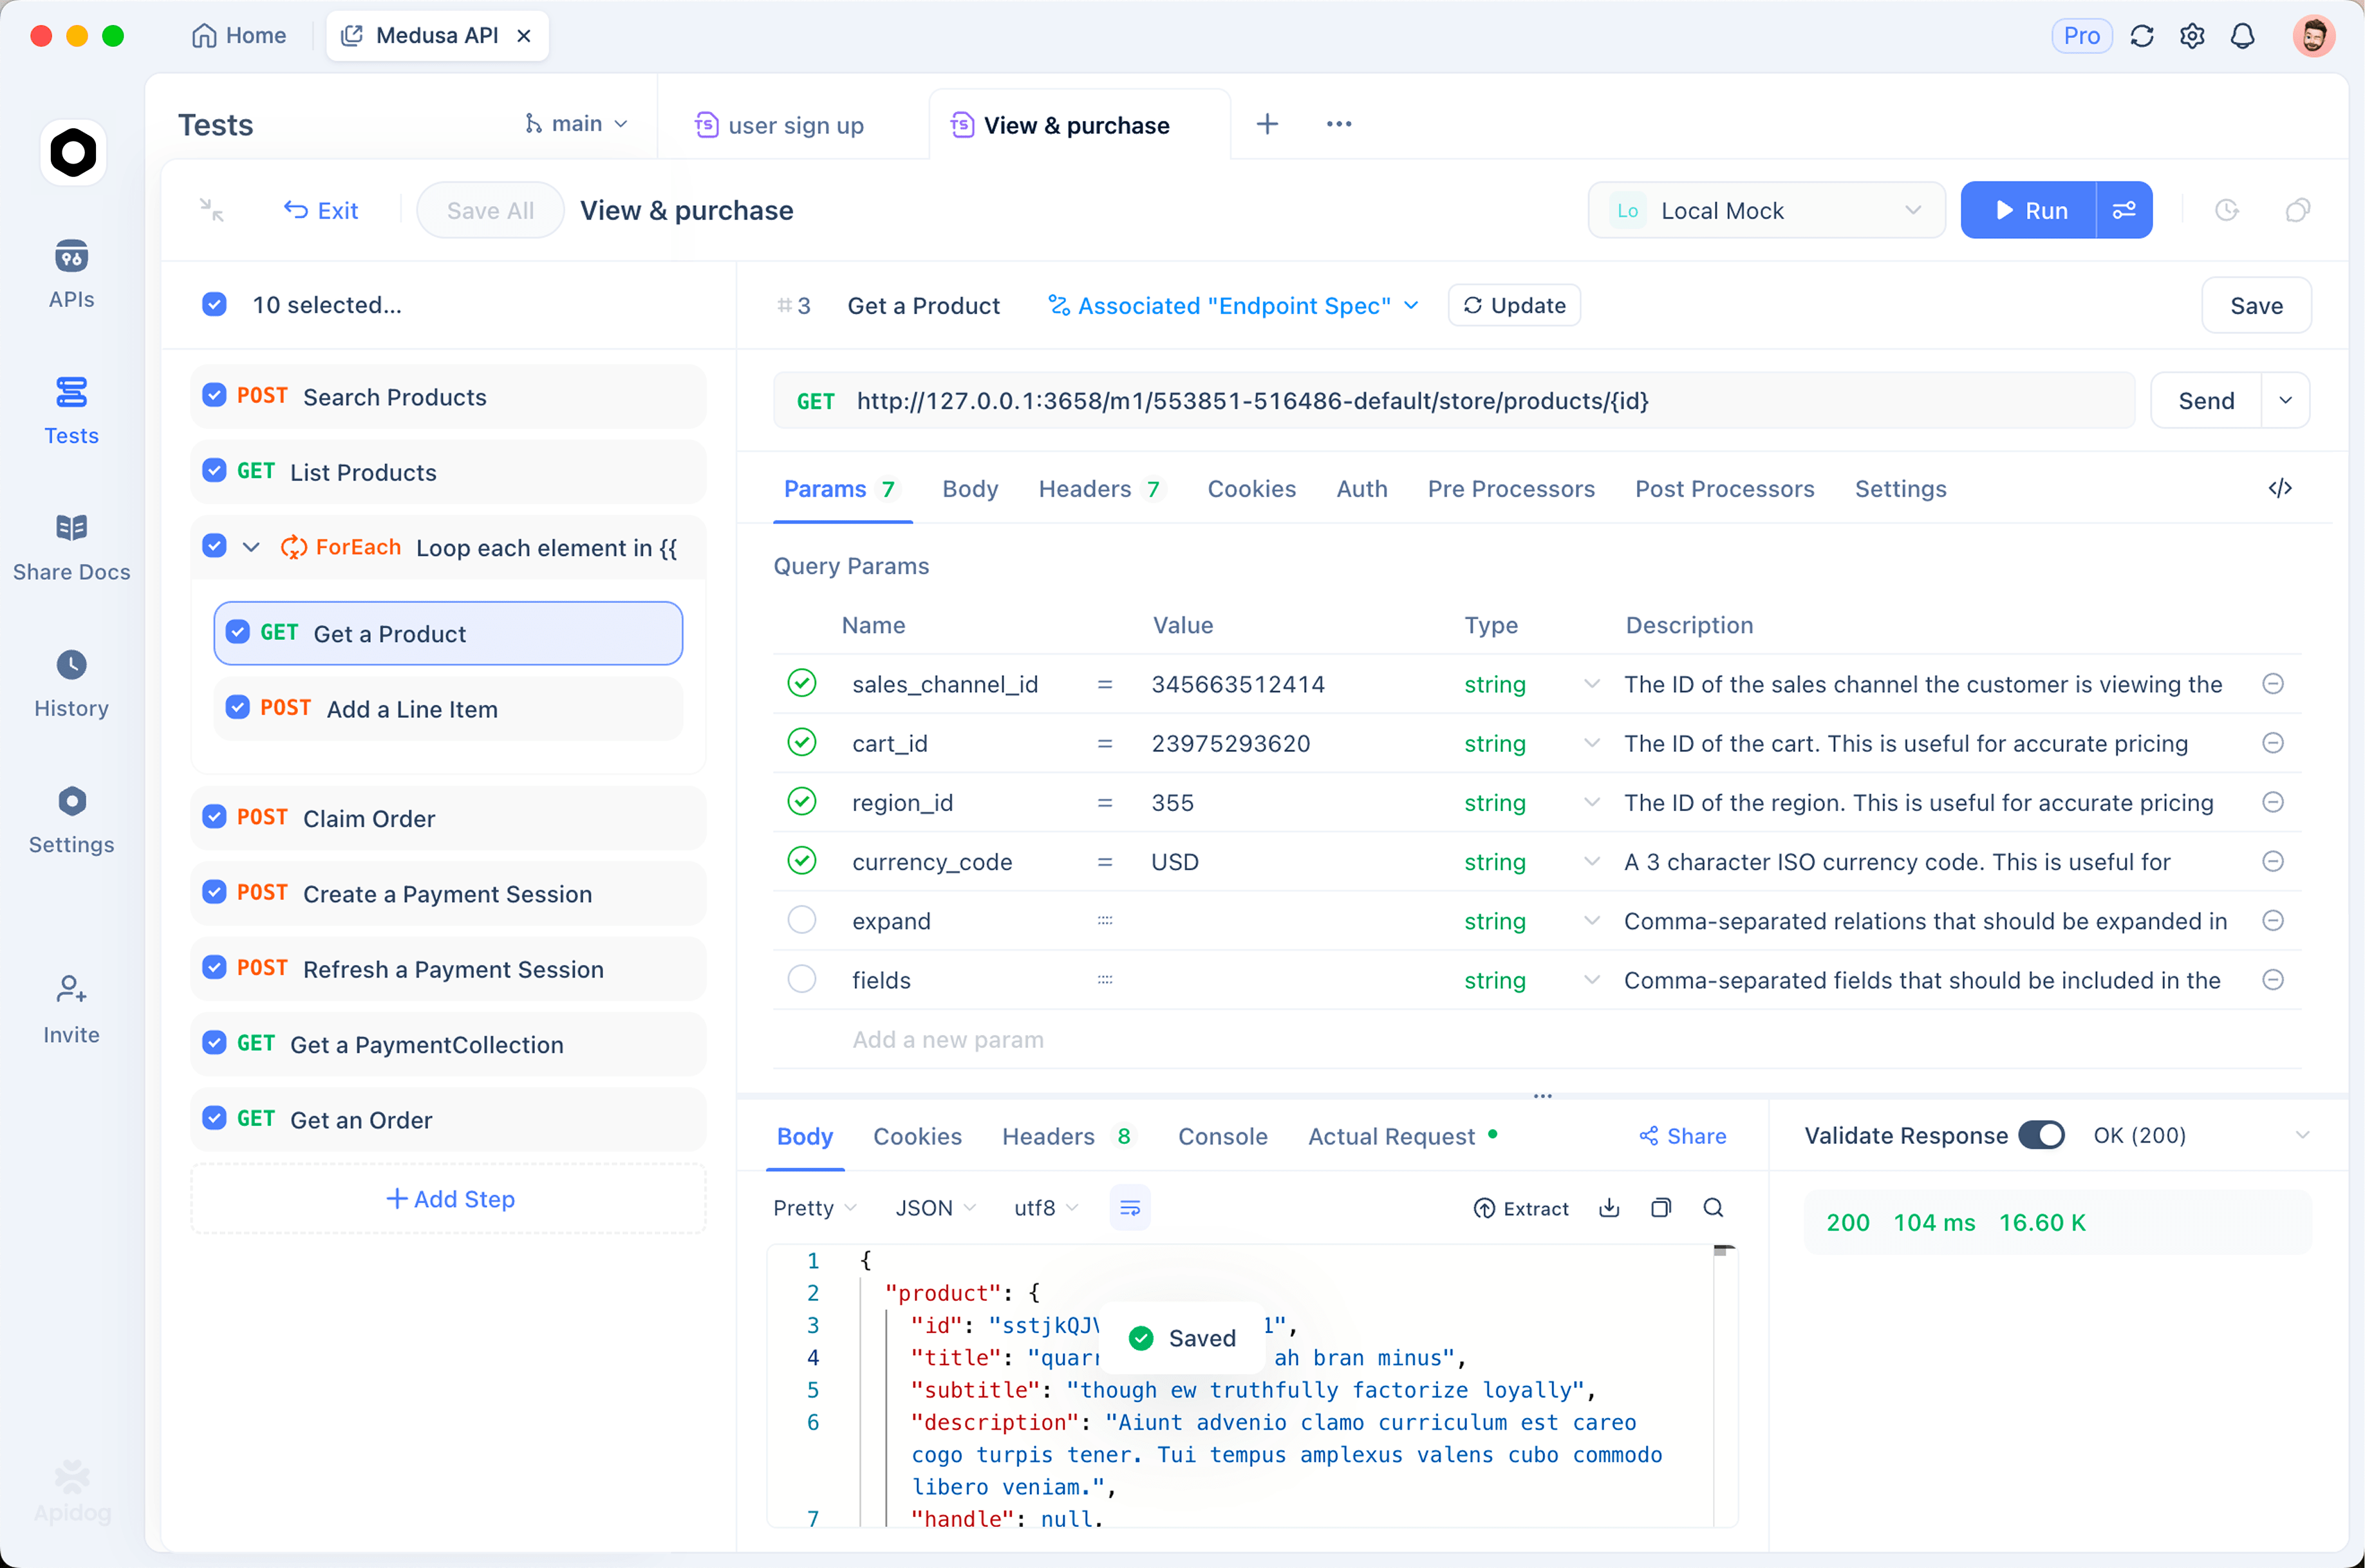
Crea una solicitud para el endpoint de K3 y otra para Opus, almacena tus claves y URLs base como variables de entorno, luego envía el mismo prompt a ambos. Apidog muestra el cuerpo de la respuesta, el estado y la temporización de cada llamada, para que puedas comparar la calidad de la respuesta, la latencia y el costo por token en entradas idénticas, y guardarlos como una colección te proporciona un arnés repetible para volver a ejecutar cada vez que cualquiera de los modelos se actualice. Puedes realizar estas verificaciones con Apidog dentro de VS Code, y el enfoque también sirve como prueba de API sin Postman. Descarga Apidog para configurarlo tú mismo. El objetivo: reemplazar "¿qué modelo es mejor en general?" por "¿cuál es mejor para este prompt, a este costo y a esta latencia?".
Conclusión
Kimi K3 supera a Claude Opus 4.8 de manera decisiva en precio, ventana de contexto y apertura, y en los propios benchmarks de lanzamiento de Moonshot, también supera a Opus 4.8 en calidad, aunque esos números son ejecutados por el proveedor y aún no han sido reproducidos de forma independiente. Lo que Opus 4.8 mantiene es el lado de la seguridad: un proveedor gestionado, políticas publicadas y un historial probado de fiabilidad en trabajos de agente complejos. Si tu carga de trabajo es de contexto largo, sensible al costo o necesita autoalojamiento, K3 es la elección pragmática; si deseas una relación comercial y un historial probado, Opus 4.8 se gana su prima. Dado que aún no existe una comparación independiente directa, prueba ambos con tus propios prompts antes de comprometerte.
Preguntas frecuentes
¿Es Kimi K3 mejor que Claude Opus 4.8? Está cerca, y con los números que tenemos, K3 parece al menos igual. Gana en precio, contexto y apertura, y en los propios benchmarks de lanzamiento de Moonshot, supera a Opus 4.8 en cada tarea listada, aunque esos números son ejecutados por el proveedor y aún no han sido reproducidos de forma independiente. Moonshot dice que K3 está por detrás de los principales modelos propietarios, pero nombra a Fable 5 y GPT-5.6 Sol, no a Opus 4.8, por lo que la verdadera ventaja de Opus 4.8 es su historial y soporte gestionado, no una ventaja en benchmarks.
¿Cuánto más barato es Kimi K3? K3 lista $0.30 por millón de tokens para la entrada con acierto de caché, $3.00 para la entrada con fallo de caché y $15.00 para la salida. Opus 4.8 lista $5.00 por entrada y $25.00 por salida. Así, K3 es mucho más barato en la entrada en caché, menos de la mitad de precio en un fallo de caché, y aproximadamente un 40% más barato en la salida. Los ahorros reales dependen de cuánto de tu entrada sea cacheable.
¿Existe un benchmark independiente que compare Kimi K3 y Opus 4.8 directamente? Todavía no. Artificial Analysis proporciona puntuaciones independientes del Índice de Inteligencia para modelos individuales, y Moonshot publica sus propios números de benchmark, pero no existe una tabla compartida y comparable de K3 versus Opus 4.8. Trata las victorias reportadas por el proveedor, incluida la cifra de "primero en cuatro de ocho benchmarks de automatización", como autoinformadas hasta que se reproduzcan de forma independiente.
¿Es Kimi K3 un competidor de Opus 4.8 o de Claude Fable 5? K3 compite en todo el campo. La cobertura del lanzamiento lo enmarcó contra Opus 4.8 porque ese es el nivel que un contendiente abierto puede alcanzar plausiblemente. La frontera actual de Anthropic es Claude Fable 5, que Moonshot reconoce que K3 todavía sigue, por lo que K3 se entiende mejor como un modelo que se acerca al campo propietario en lugar de superarlo.