
El precio de Kimi K3.1 Pro en la API es de $2.00 por 1M de tokens de entrada y $10.00 por 1M de tokens de salida, con aciertos de caché a $0.20 por 1M. Kimi K3.1 Pro Highspeed cuesta exactamente el doble: $4.00 de entrada y $20.00 de salida. No hay suscripción ni recargo por contexto largo en la ventana de 1,048,576 tokens, pero el modelo se desbloquea solo tras una recarga de $1.
A continuación: cálculos de caché, ejemplos resueltos, niveles de tarifas, planes de consumo y una comparación de precios de lista. Los números provienen de la página de precios de la API de Moonshot AI, la guía de caché de contexto, la página de límites de velocidad y los precios de membresía, consultados el 24 de octubre de 2026. ¿Eres nuevo en el modelo? Empieza con qué es Kimi K3.1 Pro.
Tabla de precios de la API de Kimi K3.1 Pro
El precio de la API de Kimi K3.1 Pro es de pago por uso, por 1M de tokens, sin impuestos. Cada modelo tiene cinco tarifas: entrada, salida, acierto de caché y una tarifa de escritura de caché para cada uno de los dos tiempos de vida de caché (5 minutos y 1 hora).
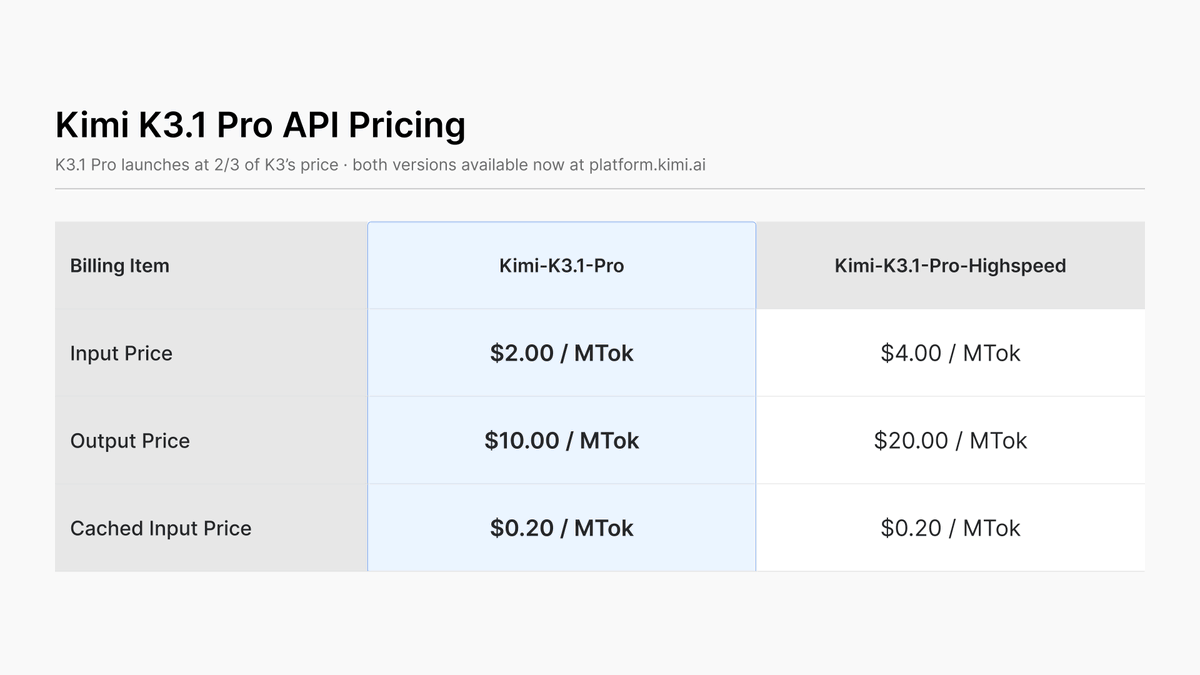
K3.1 Pro cuesta un tercio menos que K3 (consulta nuestra guía de la API de Kimi K3).
Cómo funciona el precio de caché de Kimi K3.1 Pro
El precio de caché de Kimi K3.1 Pro tiene dos partes. La primera vez que se procesa un prefijo, se factura como una escritura de caché. Las solicitudes posteriores que reutilizan ese prefijo exacto dentro del tiempo de vida de la caché lo facturan como un acierto de caché a $0.20 por 1M, una décima parte del precio de entrada.
Qué determina tu factura:
- El almacenamiento en caché es automático, con un TTL predeterminado de 5 minutos.
- Una escritura de 5 minutos cuesta lo mismo que la entrada ($2.00). Moonshot dice que “el costo de escritura ya estaba incluido en el precio de entrada”.
- Una escritura de 1 hora cuesta el doble: $4.00 por 1M.
- Cada acierto renueva el TTL, que se fija en la primera escritura. La caché se comparte solo dentro de tu organización.
Configura el TTL de 1 hora en Chat Completions o la API de Responses:
"prompt_cache_options": {"mode": "implicit", "ttl": "1h"}
En la API de Messages compatible con Anthropic, usa un "cache_control": {"type": "ephemeral", "ttl": "1h"} de nivel superior.
5m vs 1h: el punto de equilibrio
Toma un prefijo de 1M de tokens. La escritura de 1 hora cuesta $2.00 más ($4.00 frente a $2.00). Cada acierto ahorra entonces $1.80 frente a la entrada completa ($2.00 menos $0.20). Dos aciertos ahorran $3.60, lo que cubre los $2.00 extra.
La regla: si las solicitudes pueden estar separadas por más de 5 minutos y vas a reutilizar el prefijo al menos dos veces en la hora, elige 1h. Si las solicitudes llegan cada pocos minutos, la caché gratuita de 5 minutos se renueva sola.
Ejemplos resueltos de precios de Kimi K3.1 Pro
Ambos usan precios de lista; sustituye tus propios recuentos de tokens.
Ejemplo 1: un prompt de base de código de 200K tokens reutilizado 20 veces en una hora
Cargas una instantánea de repositorio de 200K tokens (0.2M de tokens) y haces 20 preguntas durante una hora, algunas con más de 5 minutos de diferencia. Solo el lado de entrada:
| Configuración | Cálculos | Costo de entrada |
|---|---|---|
| Sin aciertos (la caché de 5m sigue expirando) | 20 × 0.2M × $2.00 | $8.00 |
| Caché de 1h | escritura 0.2M × $4.00 = $0.80, más 19 aciertos × 0.2M × $0.20 = $0.76 | $1.56 |
| Caché de 5m, una pregunta cada 3 minutos | escritura 0.2M × $2.00 = $0.40, más $0.76 | $1.16 |
La caché de 1 hora reduce el costo de entrada de $8.00 a $1.56, lo que ahorra $6.44 (aproximadamente 80%). Con 2,000 tokens de salida por respuesta, añade 40,000 × $10.00 por 1M = $0.40 a cada fila.
Ejemplo 2: una app de chat con 1,000 solicitudes al día
Cada solicitud envía 2,000 tokens de entrada y recibe 500 tokens de salida, con reasoning_effort en "low":
- Entrada: 1,000 × 2,000 = 2M × $2.00 = $4.00 al día
- Salida: 1,000 × 500 = 0.5M × $10.00 = $5.00 al día
- Total: $9.00 al día, alrededor de $270 al mes, o $0.009 por solicitud
Ahora convierte 1,500 de esos tokens de entrada en un prompt de sistema fijo. Una solicitud cada 86 segundos en promedio se sitúa bien dentro del TTL de 5 minutos, por lo que casi todas las solicitudes aciertan:
- En caché: 1.5M × $0.20 = $0.30; sin caché: 0.5M × $2.00 = $1.00
- Nuevo total: $1.30 + $5.00 = $6.30 al día, alrededor de $189 al mes
Un detalle: 1,000 × 2,500 = 2.5M de tokens al día supera el límite diario de 1.5M del Tier0, así que necesitarías el Tier1.
Precios de Kimi K3.1 Pro Highspeed
El precio de Kimi K3.1 Pro Highspeed es una prima fija de 2x sobre la entrada, la salida y las escrituras de caché, por lo que Moonshot llama “2-3x la velocidad de K3.1 Pro”. Los aciertos de caché se mantienen en $0.20.
| Ejemplo 2, sin caché | Entrada | Salida | Total diario |
|---|---|---|---|
| K3.1 Pro | 2M × $2 = $4.00 | 0.5M × $10 = $5.00 | $9.00 |
| K3.1 Pro Highspeed | 2M × $4 = $8.00 | 0.5M × $20 = $10.00 | $18.00 |
Costos de esfuerzo de razonamiento, lote y búsqueda web
Tres detalles que la tabla no muestra:
- Los tokens de razonamiento cuentan para tu uso. K3.1 Pro siempre piensa;
reasoning_effortacepta"low","high"o"max"(predeterminado"max"), y bajarlo reduce el uso de tokens. Moonshot no afirma textualmente que el razonamiento se facture a la tarifa de salida [VERIFICAR]; si lo hace, 500 tokens de razonamiento adicionales por solicitud añaden $5.00 al día al Ejemplo 2. - Sin descuento por lote para K3.1 Pro. La API de Batch factura al 60% del estándar, pero solo admite
kimi-k2.7-codeykimi-k2.6. - La búsqueda web se factura por llamada.
/v1/tools/searchy/v1/tools/fetchcuestan $0.002 cada una,/v1/tools/search_pro$0.003, y solo se cobran con HTTP 200 y resultados no vacíos: $2.00 por 1,000 búsquedas básicas. El$web_searchheredado cuesta $0.005 más tokens de resultados y no se recomienda por ahora (precios de búsqueda web).
Las solicitudes interrumpidas por un 429 no se cobran.
El desbloqueo de $1 y los niveles de velocidad de la API
K3.1 Pro “se desbloquea tras una recarga exitosa (mínimo $1)”. Ese $1 compra aproximadamente 500K tokens de entrada o 100K de salida, o unas 111 solicitudes del Ejemplo 2 ($1 ÷ $0.009). La recarga acumulada determina tu nivel:
| Nivel | Recarga acumulada | Concurrencia | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Unlimited |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Unlimited |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Unlimited |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Unlimited |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Unlimited |
Con $5 acumulados obtienes un vale de $5, que no cuenta para tu nivel; no se indica si los vales sirven para pagar K3.1 Pro [VERIFICAR]. Para opciones de $0, consulta cómo usar Kimi K3.1 Pro gratis.
Planes de membresía de Kimi
Los planes de membresía de Kimi cubren las apps de Kimi y Kimi Code, no la API. Precios mensuales:
| Plan | Facturado anualmente | Facturado mensualmente | Ahorro anual | Notas |
|---|---|---|---|---|
| Adagio | $0 | $0 | n/a | Chat de K3.1 Pro, sin Kimi Code |
| Plus | $15 | $19 | $48 | Kimi Code con k3.1-pro |
| Pro | $31 | $39 | $96 | Añade Highspeed, contexto de 1M en Kimi Code |
| Max | $79 | $99 | $240 | Hasta 1M de contexto en el chat |
| Ultra | $159 | $199 | $480 | Hasta 1M de contexto en el chat |
Ahorro = (mensual menos anual) × 12; para Ultra, $40 × 12 = $480. Los saldos y claves de API, Kimi Code y membresía no son intercambiables: una membresía no se convierte en saldo de API, y el saldo de API no puede comprar una membresía.
Precio de Kimi K3.1 Pro vs Claude Opus 5.5
Kimi K3.1 Pro se lista a la mitad del precio de Claude Opus 5.5 en entrada y salida, e iguala a Claude Sonnet 5.5 y GPT-6.1 Sol hasta 272K tokens de entrada. Precios de lista por 1M de tokens, de precios de Claude y precios de OpenAI:
| Modelo | Entrada | Salida | Lectura de caché | Ejemplo 2 por día |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $9.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $18.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $9.00 |
| GPT-6.1 Sol (hasta 272K) | $2.00 | $10.00 | $0.10 | $9.00 |
| GPT-6 Astra (hasta 272K) | $10.00 | $50.00 | $1.00 | $45.00 |
Por encima de 272K tokens de entrada, OpenAI lista GPT-6.1 Sol a $4 / $15 y GPT-6 Astra a $20 / $75; K3.1 Pro se mantiene fijo. Para un prompt de 500K tokens con 5,000 tokens de salida:
- K3.1 Pro: 0.5M × $2 + 0.005M × $10 = $1.00 + $0.05 = $1.05
- GPT-6.1 Sol: 0.5M × $4 + 0.005M × $15 = $2.00 + $0.075 = $2.075 (si el nivel superior cubre toda la solicitud [VERIFICAR])
El precio de lista no es el costo por tarea: los tokenizadores y las longitudes de razonamiento difieren. Los propios benchmarks de Moonshot comparan K3.1 Pro con Opus 5.5 y GPT-6 Astra. Consulta nuestra descripción general de Claude Opus 5.5.
Confirma que el almacenamiento en caché funciona con Apidog CLI
El almacenamiento en caché ahorra dinero solo si acierta. Antes de escalar, haz que tu agente de programación lo pruebe. Apidog CLI proporciona los comandos a Claude Code, Codex, Cursor u OpenCode, y el plan gratuito de Apidog cubre hasta 4 usuarios.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
apidog skill install
Luego dale a tu agente un prompt:
In Apidog project <projectId>, create an environment for https://api.moonshot.ai/v1.
Build a test case for POST /chat/completions with model "kimi-k3.1-pro",
reasoning_effort "low", a long fixed system prompt and a short user message.
Send MOONSHOT_API_KEY as a Bearer token. Assert status 200 and log
usage.prompt_tokens_details.cached_tokens. Validate the payload, run it
3 times and tell me whether cached_tokens rises after the first run.
El agente ejecuta:
apidog environment create kimi-prod --project <projectId> --base-url https://api.moonshot.ai/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -n 3 -r cli,json
La primera iteración escribe la caché; las dos siguientes deberían informar cached_tokens por encima de cero. Moonshot no indica una longitud mínima de prefijo almacenable en caché en las páginas que leímos [VERIFICAR], así que mantén largo el prompt del sistema. Los casos de prueba necesitan un ID de categoría válido (apidog test-case category --projectlos lista). Más en la referencia del comando run y Apidog CLI en Claude Code.
5 reglas para ahorrar costos con Kimi K3.1 Pro
- Pon primero el contenido estable: prompt del sistema, definiciones de herramientas y documentos de referencia. Sin marcas de tiempo ni IDs aleatorios en el prefijo.
- Elige el TTL según el intervalo. Intervalos de más de 5 minutos y dos o más reutilizaciones por hora: usa 1h.
- Configura
reasoning_effortpor tarea. Usa"low"para llamadas simples. - Usa Highspeed solo donde la velocidad lo justifique. Duplica todas las tarifas excepto los aciertos de caché.
- Registra los campos de caché:
cached_tokensycache_write_tokens, constream_options.include_usage=trueal transmitir.
Para la configuración de solicitudes, lee nuestra guía de la API de Kimi K3.1 Pro y cómo usar Kimi K3.1 Pro.
Preguntas frecuentes
¿Cuánto cuesta Kimi K3.1 Pro por 1M de tokens?
$2.00 de entrada, $10.00 de salida y $0.20 por aciertos de caché. Las escrituras de caché cuestan $2.00 (5 minutos) o $4.00 (1 hora).
¿Kimi K3.1 Pro obtiene el descuento de la API de Batch?
No. El precio por lote cubre solo kimi-k2.7-code y kimi-k2.6.
¿Puedo usar mi membresía de Kimi para llamadas a la API?
No. La API de Kimi, Kimi Code y la membresía son productos separados con saldos y claves separados.
¿Cuál es el mínimo para empezar?
Una recarga de $1. Desbloquea el modelo y te coloca en Tier0: 3 solicitudes por minuto y 1.5M de tokens al día.