
El Kimi K2.7 Code de Moonshot aterrizó con puntos de referencia contra los dos modelos por los que la mayoría de los desarrolladores realmente pagan: Claude Opus y GPT-5.5. La versión corta es que la frontera cerrada todavía obtiene puntuaciones más altas en la mayoría de las tareas de codificación, pero no por el margen que sugiere su precio. Kimi es un modelo de peso abierto que puedes descargar y autoalojar, y se sitúa a pocos puntos de modelos que solo puedes alquilar.
Esta comparación pone los números uno al lado del otro, los pondera frente al costo y la apertura, y te dice cuál elegir para cada trabajo.
TL;DR
- Calidad de codificación en bruto: GPT-5.5 y Claude Opus lideran en la mayoría de las suites. Kimi K2.7 Code se queda atrás por unos pocos puntos.
- Costo: Kimi es mucho más barato ($0.95/$4.00 por millón de tokens) y de autoalojamiento gratuito. Los modelos cerrados cuestan más y no se pueden alojar en tu propio hardware.
- Apertura: Kimi se entrega con pesos abiertos bajo una licencia MIT modificada. Opus y GPT-5.5 son cerrados.
- Veredicto: elige el modelo de frontera para la mayor calidad de un solo intento; elige Kimi cuando el costo, el volumen o el control de datos importen más que los últimos puntos.
Los contendientes de un vistazo
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Tipo | Peso abierto (MIT modificado) | Cerrado | Cerrado |
| Arquitectura | MoE, 1T total / 32B activo | No revelado | No revelado |
| Ventana de contexto | 256K tokens | Grande | Grande |
| Autoalojamiento | Sí | No | No |
| Precios (por M tokens) | $0.95 entrada / $4.00 salida | Mayor, solo alquiler | Mayor, solo alquiler |
La diferencia estructural es lo más destacado. Kimi te dice exactamente qué es y te permite ejecutarlo tú mismo. Los otros dos son servicios a los que llamas.
Puntos de referencia de codificación
Estas son las puntuaciones reportadas por Moonshot. Trátalas como el encuadre del proveedor, ya que varias suites son propias de Moonshot, pero el patrón es consistente y vale la pena leerlo.
| Punto de referencia | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 ocupa el primer lugar en los dos primeros; Claude Opus lidera en MLS Bench Lite y se mantiene cerca en todas partes. Kimi se sitúa un escalón por debajo en cada uno. La brecha es real pero pequeña en Kimi Code Bench v2, más amplia en Program Bench. Si tu trabajo se parece a ese segundo punto de referencia, el modelo de frontera justifica su costo.
Puntos de referencia de uso de agentes y herramientas
Los agentes de codificación viven o mueren por las llamadas a herramientas, no solo por la generación de código. Aquí la imagen se vuelve más ajustada.
| Punto de referencia | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
En MCP Mark Verified, Kimi en realidad supera a Claude Opus, aunque GPT-5.5 se adelanta bastante. En MCP Atlas, los tres se sitúan en unos cinco puntos. Para cargas de trabajo con agentes, Kimi está más cerca del grupo de lo que sugieren sus puntuaciones de codificación en bruto, lo que importa porque es exactamente donde se acumulan los costos de los tokens.
El costo es donde Kimi gana
Los puntos de referencia miden la calidad. No miden la factura. Kimi K2.7 Code cuesta $0.95 por millón de tokens de entrada y $4.00 por millón de salida, con aciertos de caché a $0.19 por millón. Los modelos de frontera cerrados cuestan significativamente más por token, y no puedes evitar eso alojándolos; no hay descarga.
Dos factores aumentan el ahorro:
- Los pesos abiertos significan una opción de cero tokens. Autoaloja en tu propio hardware y el costo por token desaparece por completo. Lo intercambias por tiempo de GPU.
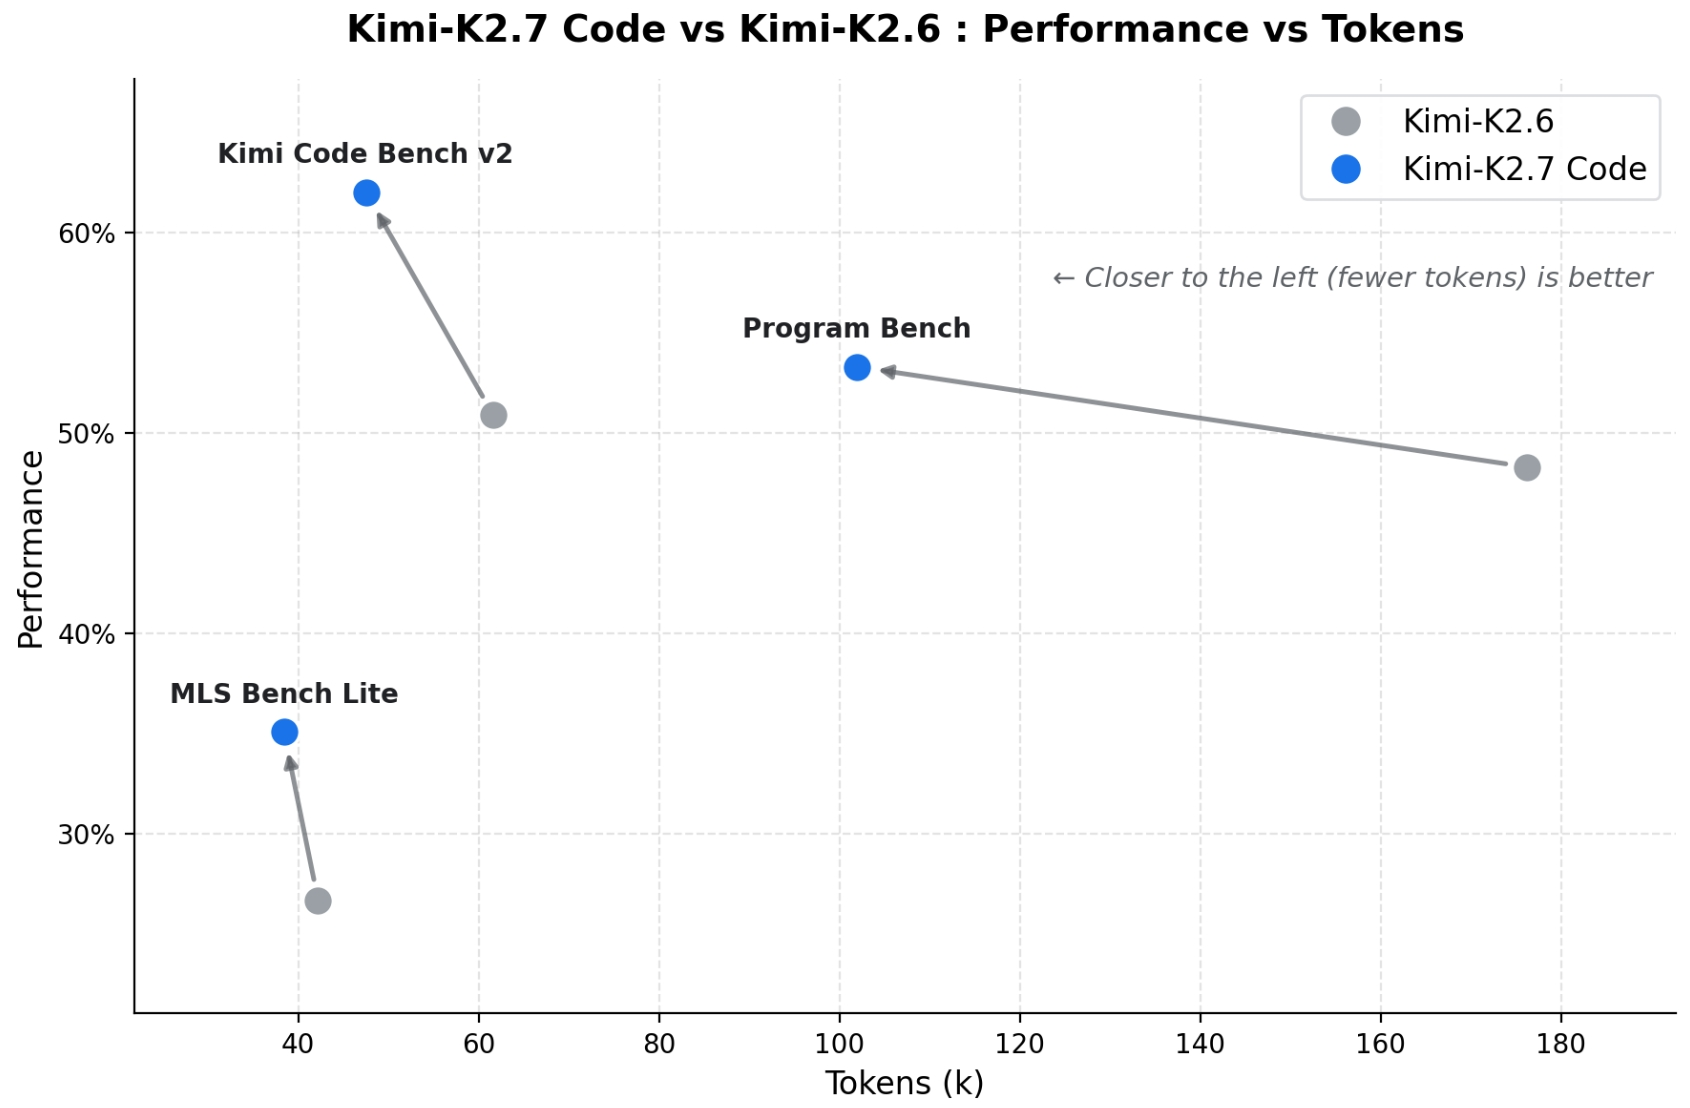
- Razonamiento más eficiente. K2.7 Code utiliza aproximadamente un 30% menos de tokens de "pensamiento" que K2.6 para el mismo trabajo, por lo que cada paso del agente cuesta menos. Nuestra guía sobre cómo reducir los costos de tokens de agente profundiza en por qué eso suma.
Para un agente que realiza cientos de llamadas a herramientas por tarea, un modelo que es 90% tan bueno a una fracción del precio a menudo gana en valor total.
Contexto y apertura
Los tres manejan bien el contexto largo; la ventana de Kimi es de 256K tokens, suficiente para un servicio completo más sus pruebas en un solo prompt. El mayor diferenciador es la licencia. Los pesos MIT modificados de Kimi te permiten ajustar, auditar y ejecutar el modelo de forma aislada. Para equipos con reglas de cumplimiento o residencia de datos, eso no es un "lujo"; es el factor decisivo, y los modelos cerrados simplemente no son una opción.
Cuándo elegir cada uno
Elige GPT-5.5 o Claude Opus si:
- Necesitas la más alta calidad de codificación de un solo intento y unos pocos puntos de referencia justifican el costo.
- Estás bien alquilando un servicio cerrado con un SLA gestionado.
- Tus tareas más difíciles se parecen a Program Bench, donde la brecha es mayor.
Elige Kimi K2.7 Code si:
- Ejecutas cargas de trabajo de agentes de alto volumen donde el costo del token decide la viabilidad.
- Los datos deben permanecer en tu propia infraestructura.
- Quieres ajustar o auditar el modelo.
- Estás optimizando el valor total, no la cima de la clasificación.
Para un campo más amplio, nuestra comparación MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 cubre otros retadores de peso abierto, y DeepSeek V4 vs Claude Opus para codificación profundiza en otro enfrentamiento abierto vs. cerrado. Si estás comparando los agentes en lugar de los modelos, consulta Claude Code vs OpenAI Codex.
Prueba la comparación tú mismo
Los puntos de referencia son un punto de partida, no un veredicto para tu base de código. La prueba honesta es ejecutar los tres en tus propias tareas y leer los resultados. La CLI de Kimi Code te da el agente gratis para empezar, y puedes llamar a la API de cada modelo directamente para comparar las salidas en bruto.
Cuando lo hagas, prueba los endpoints en Apidog: envía el mismo prompt a cada modelo, guarda las llamadas lado a lado y compara la calidad de la respuesta, la latencia y el uso de tokens en un solo lugar. Descarga Apidog para ejecutar la prueba.
Preguntas frecuentes
¿Es Kimi K2.7 Code mejor que Claude Opus o GPT-5.5? En los puntos de referencia de codificación informados por Moonshot, no; los modelos cerrados obtienen puntuaciones más altas en la mayoría de las suites. La ventaja de Kimi son los pesos abiertos y un costo mucho menor, mientras se mantiene a unos pocos puntos.
¿Cuánto más barato es Kimi? Cuesta $0.95 por millón de tokens de entrada y $4.00 por millón de salida, y es gratis autoalojarlo. Los modelos de frontera cerrados cuestan más por token y no se pueden autoalojar.
¿Puedo ejecutar Kimi K2.7 Code yo mismo? Sí. Los pesos son abiertos bajo una licencia MIT modificada; sírvelos con vLLM, SGLang o KTransformers.
¿Cuál es el mejor para agentes de codificación? Para la calidad bruta, GPT-5.5 lidera. Para agentes de alto volumen eficientes en costos, Kimi es la mejor opción, y está cerca en los puntos de referencia de agentes.
¿Son neutrales estos puntos de referencia? Varias suites son propias de Moonshot, así que léelas como el encuadre del proveedor. La brecha consistente con la frontera es la señal útil, no los números exactos.
Resumen
Kimi K2.7 Code no supera a Claude Opus o GPT-5.5 en la mayoría de los puntos de referencia de codificación, y Moonshot no pretende que lo haga. Obtiene unos pocos puntos menos mientras cuesta mucho menos y ofrece pesos abiertos que puedes ejecutar tú mismo. Para la mayor calidad posible, la frontera cerrada sigue ganando. Para agentes de alto volumen, despliegues privados o cualquiera que valore el valor total sobre la cima de la tabla, Kimi es la elección más inteligente. Ejecuta los tres en tu propio código, compara las salidas en Apidog, y deja que tu carga de trabajo decida.