
Alibaba lanzó Qwen 3.8-Max a principios de agosto de 2026, y los resultados de búsqueda ya se están llenando de afirmaciones de "úsalo gratis para siempre" que no resisten el contacto con los términos reales. Aquí está la versión honesta, verificada con las propias páginas de Alibaba a partir del 3 de agosto de 2026.
Hay exactamente cuatro rutas que valen la pena. Dos funcionan hoy. Una es una promesa con fecha adjunta. Una es una alternativa. Si primero desea una imagen completa del modelo (2.4 billones de parámetros totales, 95B activos, contexto de 1M de tokens), comience con nuestra descripción general de Qwen 3.8 y luego regrese.
Mapa rápido antes de los detalles:
| Ruta | ¿Gratis? | ¿Funciona hoy? | Peculiaridad |
|---|---|---|---|
| Qwen Chat | Sí | Sí | Aplicación para consumidores, sin API |
| Cuota de API de Model Studio | 1M de tokens | Sí | Solo región de Singapur, 90 días |
| Pesos abiertos (autoalojamiento) | Pesos gratis | Todavía no | Prometido "la próxima semana", y el hardware no es gratis |
| Modelos Qwen antiguos | Sí | Sí | No es Qwen 3.8 |
Ruta 1: Qwen Chat, la opción sin configuración
El camino gratuito más rápido es el que Alibaba quiere para los consumidores: Qwen Chat. Inicia sesión, elige el modelo y estarás hablando con Qwen 3.8-Max sin tarjeta ni consola en la nube. La publicación oficial de lanzamiento lo señala como la forma predeterminada de probar el modelo.
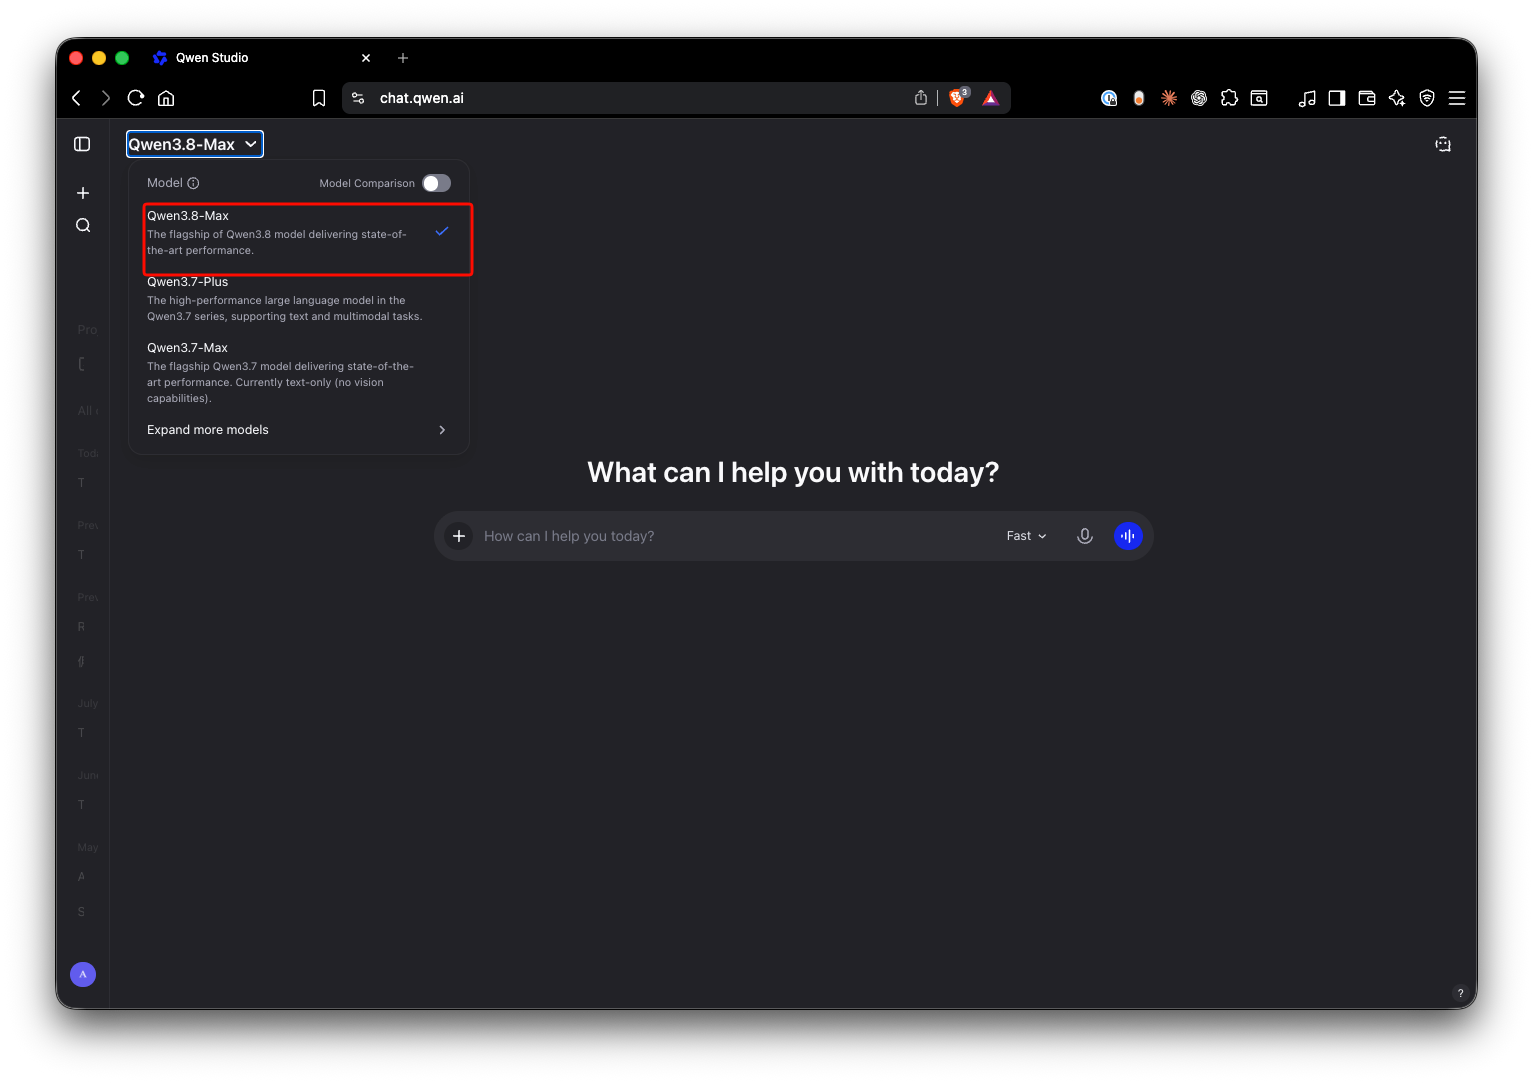
Lo que obtienes: uso gratuito del modelo insignia a través de una interfaz de chat, incluyendo la comprensión de imágenes y documentos en la que se basan las demostraciones de lanzamiento.
Lo que no obtienes: una API. Sin claves, sin automatización, sin forma de conectarlo a tu aplicación o suite de pruebas. Las aplicaciones de chat también aplican sus propios prompts y configuraciones de sistema, por lo que el comportamiento que veas allí no coincidirá exactamente con lo que devuelve la API sin procesar. Si estás evaluando Qwen 3.8 para un producto, trata Qwen Chat como una demostración, no como un benchmark.
Veredicto: real, gratis y bueno para probarlo. No es una ruta para desarrolladores.
Ruta 2: la cuota gratuita de Model Studio (lee la letra pequeña)
Esta es la ruta que importa si escribes código. Alibaba Cloud Model Studio ofrece a las nuevas activaciones una cuota gratuita para qwen3.8-max: 1 millón de tokens. Es una cantidad realmente útil, y también viene envuelta en letra pequeña que la mayoría de los resúmenes pasan por alto.
Esto es lo que dice realmente la página de precios, traducido a decisiones:
1. Solo en la región de Singapur. La cuota gratuita se aplica a la región de Singapur (internacional). Esto significa que tu URL base es:
https://dashscope-intl.aliyuncs.com/compatible-mode/v1
Apuntando a los endpoints de Beijing o US-Virginia, pagarás desde el primer token. Si tu presupuesto de latencia requiere un endpoint de EE. UU., la cuota gratuita no te ayudará.
2. 90 días, luego se acaba. La cuota es válida por 90 días desde la activación. Los tokens no utilizados no se acumulan; caducan. El reloj ya corre desde el lanzamiento del modelo a principios de agosto, así que no actives ahora y planees evaluar en noviembre.
3. Después de la cuota: $2 de entrada / $6 de salida por millón de tokens. Esa es la tarifa plana en todo el contexto de 1M, sin niveles. Es barato para un modelo insignia, pero no es gratis, y la transición es automática una vez que tu cuota se agota o expira. Configura una alerta de facturación antes de empezar. Desglosamos lo que cuestan las cargas de trabajo reales en nuestra guía de precios de Qwen 3.8.
Para reclamar la cuota: crea una cuenta en Model Studio, activa el servicio y genera una clave API (la convención de variable de entorno es DASHSCOPE_API_KEY). El catálogo de modelos lista qwen3.8-max en la parte superior de los modelos recomendados. El endpoint habla el protocolo compatible con OpenAI, y también hay un endpoint compatible con Anthropic. Nuestro tutorial de la API de Qwen 3.8 cubre ambos, con salida de streaming y razonamiento incluidos.
Una trampa que consume cuota: el razonamiento está activado por defecto
Qwen 3.8-Max se envía con reasoning_effort configurado en xhigh, y los tokens de pensamiento se facturan como salida. Un solo prompt complejo puede producir silenciosamente miles de tokens de razonamiento antes de que la respuesta comience siquiera. En una cuenta de pago, eso es un costo; en una cuota gratuita de 1M, es la diferencia entre dos semanas de pruebas y dos días. Reduce reasoning_effort a low o medium para cualquier cosa que no sea una tarea de razonamiento genuina.
Haz que el millón de tokens dure
Un millón de tokens desaparece rápidamente cuando cada iteración de depuración reenvía toda tu cadena de prompts. Unos pocos hábitos lo prolongan:
- Ajusta la solicitud antes de repetirla. Construye la llamada en Apidog, ajusta los parámetros e inspecciona la respuesta transmitida, incluidos los deltas de razonamiento, una solicitud a la vez. La depuración interactiva en un cliente es mejor que quemar cuota en un bucle de reintentos en el código de tu aplicación.
- Simula lo que ya has visto. Una vez que conozcas la forma de la respuesta, guarda un ejemplo y deja que el servidor mock de Apidog lo sirva a tu frontend o agente mientras construyes. Las iteraciones de desarrollo contra un mock cuestan cero tokens; solo accedes al endpoint en vivo para la verificación final.
- Vigila tu uso real. El recuento de tokens vuelve en cada cuerpo de respuesta. Mantenlos bajo control por solicitud, y sabrás tu tasa de consumo real en lugar de darte cuenta cuando la cuota muera a mitad de sprint.
Descarga Apidog gratis si quieres seguir ese flujo de trabajo; también hace que el cambio de región sea indoloro, ya que puedes almacenar las URL base de Singapur, Beijing y EE. UU. como entornos y alternar entre ellas.
Veredicto: real, genuinamente gratuito por 90 días, y la mejor ruta para desarrolladores ahora mismo. Solo respeta el bloqueo regional y la fecha de caducidad.
Ruta 3: pesos abiertos, prometidos pero aún no descargables
El titular más importante del lanzamiento para el público gratuito: Qwen 3.8-Max es el primer modelo de clase Qwen-Max con pesos abiertos. Alibaba dice que los pesos llegarán a Hugging Face y ModelScope "la próxima semana", lo que los sitúa alrededor del 10 de agosto.
A 3 de agosto de 2026, no son descargables. No hay nada que extraer, nada que cuantificar, nada que ejecutar. Si ves un tutorial de "ejecuta Qwen 3.8 localmente hoy" fechado antes de que los pesos existan realmente, cierra la pestaña. Como referencia, Kimi K3 hizo la misma promesa de pesos abiertos en el lanzamiento y la cumplió 11 días después, por lo que el plazo es plausible. Simplemente aún no ha sucedido.
La realidad del autoalojamiento
Incluso cuando los pesos se publiquen, "gratis" necesita un asterisco del tamaño de un rack de servidores. Qwen 3.8-Max tiene 2.4 billones de parámetros totales. El precedente más cercano es Kimi K3: un modelo de 2.8T parámetros que se envió como 594 GB de pesos incluso con una cuantificación MXFP4 agresiva. Reduzca eso ligeramente para los 2.4T de Qwen y todavía estará buscando cientos de gigabytes de pesos y una configuración de servicio multi-GPU, realistamente multi-nodo. Ninguna GPU de consumo soporta esto. Ninguna estación de trabajo individual soporta esto. Detallamos exactamente cómo es esa clase de hardware para ejecutar Kimi K3 localmente, y la economía se aplica aquí sin cambios.
Entonces, ¿qué te ofrecen realmente los pesos abiertos? Principalmente esto: una vez que los pesos son públicos, los hosts de terceros pueden servir el modelo, y la competencia tiende a empujar los precios de hosting por debajo de las tarifas propias. Para la mayoría de los lectores, "pesos abiertos gratis" se traducirá en un acceso API más barato a través de proveedores de hosting, no en un modelo ejecutándose en tu portátil. Eso sigue siendo una victoria. Simplemente es una victoria diferente a lo que sugiere la frase.
Veredicto: todavía no es real. Vuelve a consultar a mediados de agosto y presupuesta para hosting, no para hardware.
Ruta 4: la alternativa, modelos Qwen antiguos realmente gratuitos
Si lo que necesitas es "un modelo Qwen capaz a coste cero" en lugar de "Qwen 3.8-Max específicamente", la generación anterior tiene rutas gratuitas que no caducan en 90 días. Los modelos Qwen de código abierto más pequeños ya se ejecutan en hardware que la gente realmente posee, y la línea anterior tiene sus propias rutas de acceso sin coste. Mantenemos una guía separada sobre cómo usar Qwen 3.7 gratis que se mantiene actualizada sobre esas opciones.
El intercambio honesto: renuncias a las ganancias de rendimiento que hicieron noticia del 3.8-Max. Para un proyecto secundario, un clasificador o para aprender la forma de la API de Qwen antes de gastar dinero, los modelos más antiguos suelen ser suficientes.
Lo que no es real
Para ahorrarte algunas búsquedas, esto es lo que no existe a 3 de agosto de 2026:
- No hay un nivel API gratuito ilimitado. La cuota de 1 millón de tokens es todo, y caduca.
- No hay un nivel gratuito fuera de Singapur. Los endpoints de Beijing y US-Virginia facturan desde el primer token.
- Todavía no hay pesos descargables. "La próxima semana" es una promesa, no un enlace.
- No hay Qwen 3.8 oficial gratuito en agregadores de terceros. Es probable que el acceso de terceros alojado aparezca después de que se envíen los pesos; cualquier cosa anterior que afirme ser Qwen 3.8-Max gratuito merece escepticismo sobre qué modelo hay realmente detrás.
Preguntas frecuentes
¿La API de Qwen 3.8 es realmente gratuita?
Parcialmente. Obtienes 1 millón de tokens gratuitos a través de Alibaba Cloud Model Studio, válidos por 90 días y solo en la región de Singapur. Después de eso, la tarifa es de $2 por millón de tokens de entrada y $6 por millón de tokens de salida, así que planifica tu evaluación dentro de la ventana de 90 días.
¿Puedo descargar y ejecutar Qwen 3.8 localmente ahora mismo?
No. Los pesos están prometidos para Hugging Face y ModelScope alrededor del 10 de agosto de 2026, y aún no se han enviado al momento de escribir este artículo. Cuando lo hagan, prepárate para cientos de gigabytes y un servicio multi-GPU; este es un modelo de 2.4T parámetros, no algo que ejecute una laptop.
¿En qué se diferencia esto de las opciones gratuitas de Kimi K3?
Los pesos de Kimi K3 ya están en vivo y son descargables, por lo que su ruta de autoalojamiento es real hoy, mientras que la de Qwen 3.8 todavía está pendiente. Sin embargo, ambos son demasiado grandes para hardware de consumo. Nuestra guía sobre cómo usar Kimi K3 gratis cubre las rutas de ese modelo si quieres comparar.
¿La cuota gratuita cubre los tokens de pensamiento?
Sí, pero los agota. La salida de razonamiento se factura como salida normal, y el reasoning_effort predeterminado es xhigh. Redúcelo para llamadas rutinarias o tu cuota se desvanecerá en una cadena de pensamiento que nunca lees.
Conclusión
El acceso gratuito a Qwen 3.8 es real, pero es específico: Qwen Chat para uso casual, y 1 millón de tokens en la región de Singapur con una caducidad de 90 días para desarrolladores. La ruta de pesos abiertos está a días de distancia en papel y en la práctica significará principalmente un acceso alojado más barato. Todo lo demás es un modelo más antiguo o un deseo expresado en un blog.
Si eliges la ruta de la API, gasta tu cuota en respuestas, no en depuración. Prototipa las solicitudes en Apidog, simula las respuestas mientras construyes, y guarda los tokens en vivo para las ejecuciones de evaluación que realmente te digan si Qwen 3.8-Max se gana un lugar en tu pila.