
La mayoría de la gente conoce un nuevo modelo abriendo un cuadro de chat y escribiendo en él. Jev castiga ese reflejo. Es el modelo Sistema Uno de TypeSafe AI, y no produce prosa en absoluto: le entregas el estado del programa más un conjunto de preguntas tipificadas, y te devuelve decisiones con probabilidades adjuntas. Ese cambio de rol es toda la técnica. Tu modelo de lenguaje sigue escribiendo; Jev decide qué sucede a continuación, y tu código decide qué hacer con la decisión.
Esta guía cubre la arquitectura alrededor de la llamada, no la llamada en sí. Si necesitas la introducción primero, empieza con qué es Jev, luego lee la publicación de lanzamiento de TypeSafe para el encuadre de la compañía.
En qué es excepcional Jev
Tres primitivas cubren todo lo que hace Jev. noul devuelve la probabilidad de que una afirmación sobre el estado sea verdadera. choice selecciona una opción de un mapa de criterios (hasta 255 opciones) y devuelve la selección, la distribución completa de probabilidades y un valor de confianza. score sitúa el estado en una rúbrica ordenada de 2 a 10 niveles y devuelve el nivel, una leyenda, las probabilidades y la confianza. Los antecedentes sobre la empresa y la familia de modelos se encuentran en nuestro artículo sobre TypeSafe AI.
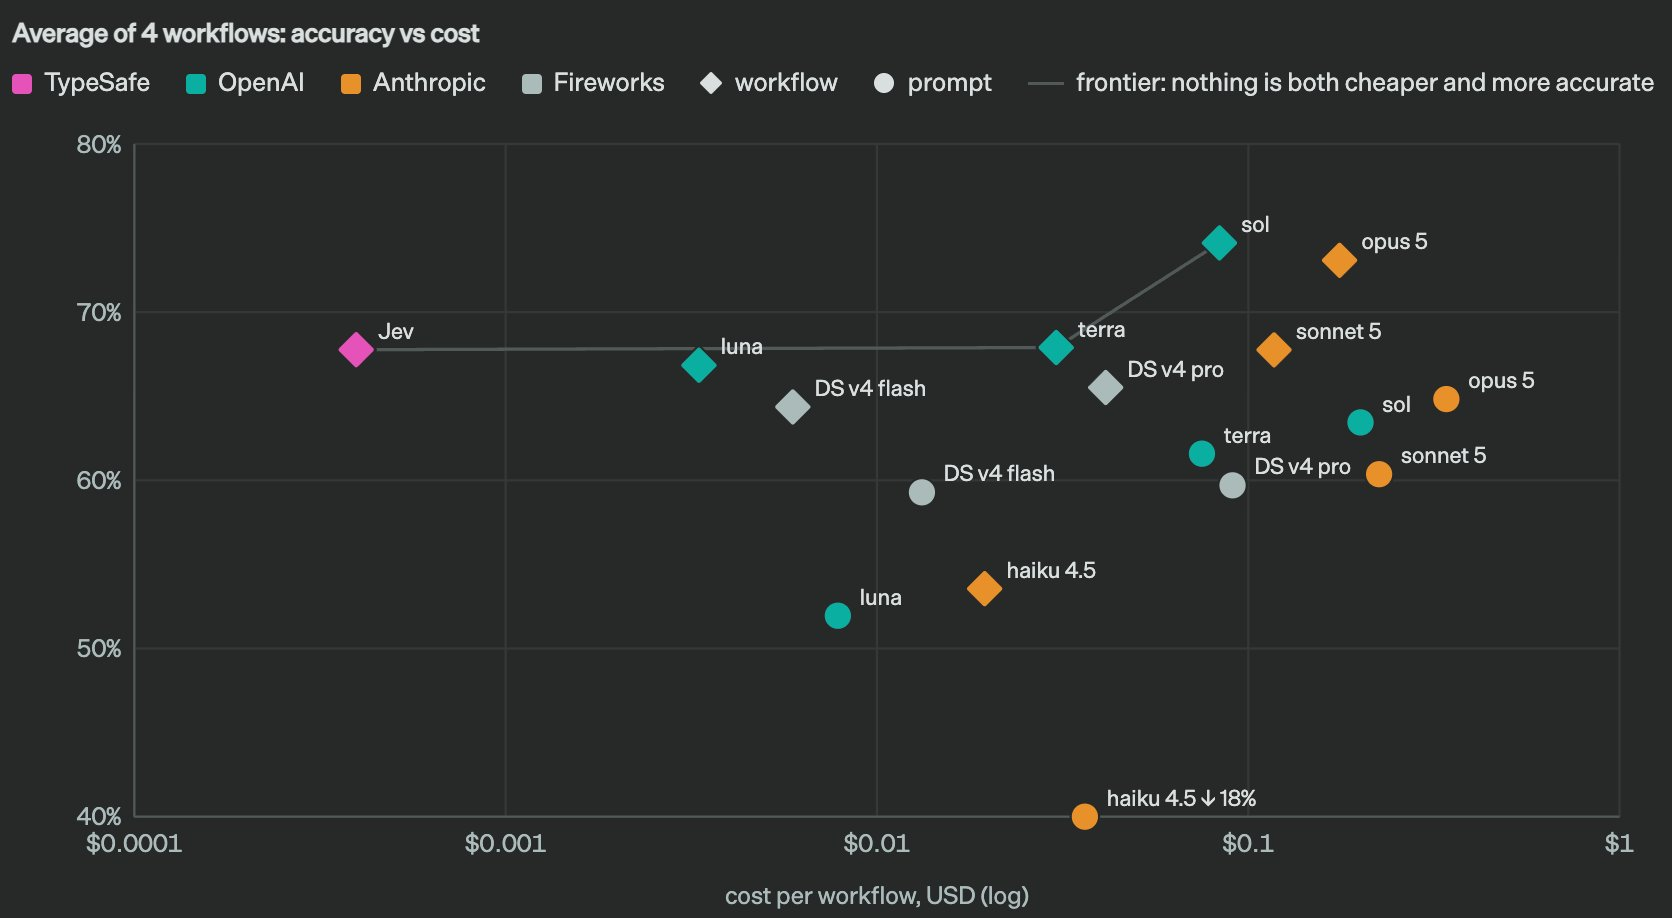
Cuatro propiedades son importantes para la arquitectura. Cada respuesta llega en un tipo que su programa ya entiende. Cada respuesta conlleva su propia incertidumbre, por lo que "no estoy seguro" se convierte en una bifurcación en lugar de una sorpresa. Muchas preguntas sobre un estado se resuelven en una sola pasada. Y a 0.042 $ por millón de tokens de entrada, sin cobrar por los tokens de salida, puede permitirse preguntar en cada evento en lugar de en una muestra.
Ejecuta Jev como el juez, no el escritor
Cuatro roles, claramente separados:
- El LLM genera. Código, un borrador de correo electrónico, un resumen, un plan.
- Jev decide. Clasifica la solicitud, evalúa el riesgo, elige la ruta y verifica el resultado según los criterios que usted estableció de antemano.
- Su código controla. Los umbrales y las reglas deciden si actuar, reintentar, escalar o detenerse.
- Un humano detecta los casos límite. La baja confianza más las altas apuestas van a una persona.
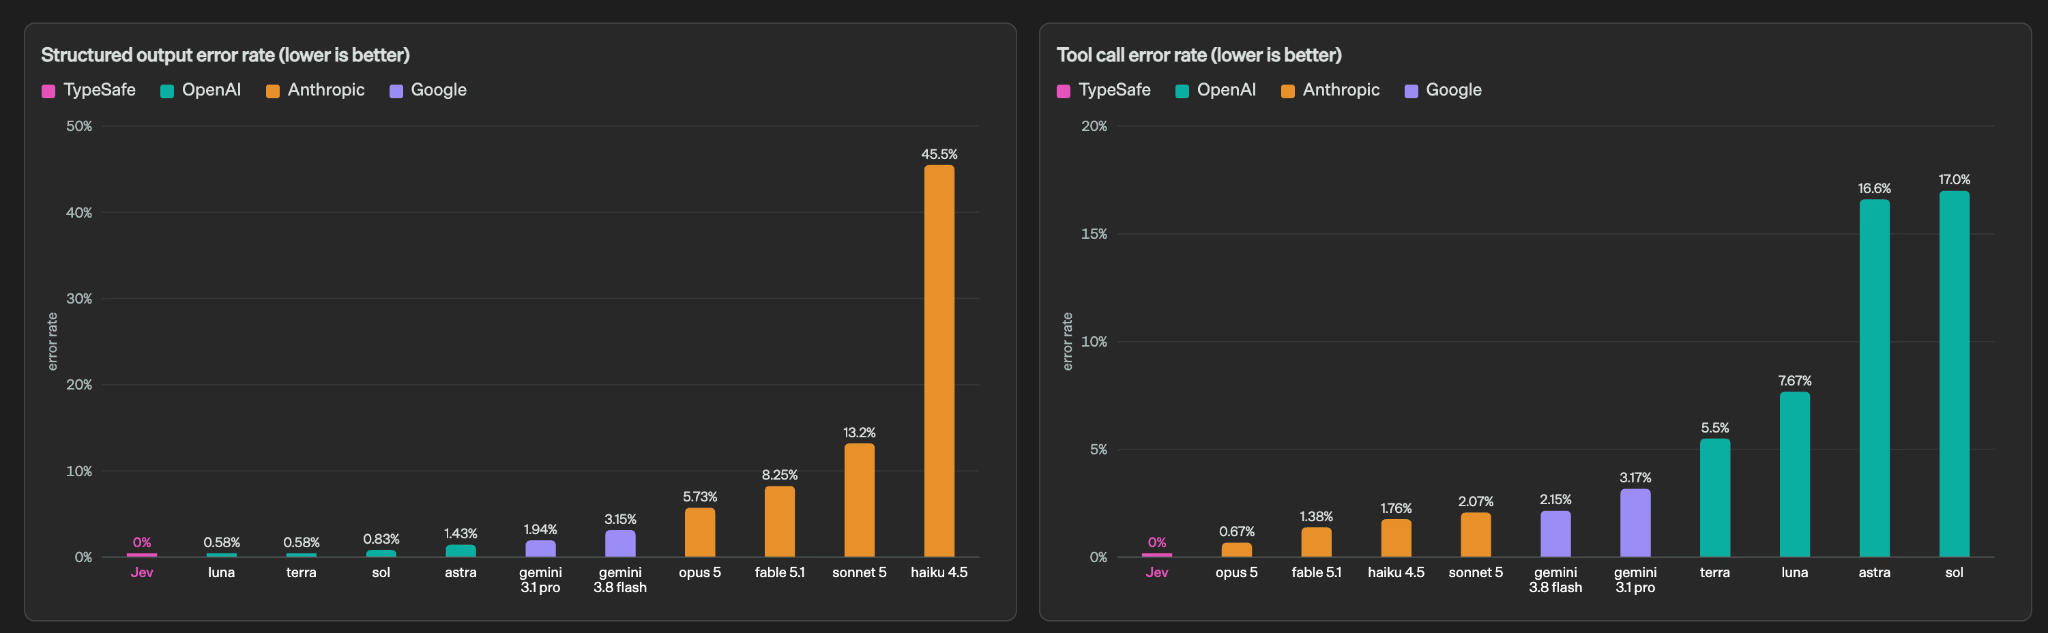
He aquí por qué funciona la división. Un modelo de lenguaje es flexible porque puede emitir cualquier cosa, y esa misma libertad es lo que lo hace incómodo de ocultar dentro de un flujo de trabajo del que usted depende. El enfoque de TypeSafe es que Jev "renuncia a la generación de cadenas" y, a cambio, obtiene un contrato estricto: el conjunto de respuestas posibles se fija antes de que la solicitud salga de su servidor, cada resultado se ajusta a la forma declarada y la incertidumbre es un número que puede comparar con un umbral.
El lado de los costos se deriva del mismo intercambio. TypeSafe informa tiempos de respuesta de extremo a extremo de 70ms a 500ms, y afirma cifras de 193.6 veces más rápido y 444.6 veces más barato en los flujos de trabajo que probó. Trate esos datos como números de proveedor, no como puntos de referencia independientes. El punto estructural sobrevive de cualquier manera: el modelo caro solo se ejecuta cuando algo realmente tiene que ser escrito, y los juicios repetidos a su alrededor se ejecutan en algún lugar barato.
Diseñando preguntas que Jev puede responder
Cada solicitud lleva un state compartido y un conjunto de preguntas independientes. Jev lee el estado una vez y responde a todas ellas. Una llamada de triaje de soporte se ve así:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
Tres hábitos separan las preguntas que funcionan de las que flaquean.
Deja de escribir prompts. Personas, ejemplos prácticos y preámbulos largos dirigen un generador de texto. Jev no está generando texto. Necesita el estado, una pregunta atómica y una descripción exacta de lo que significa cada respuesta. Los criterios descriptivos superan a las etiquetas simples: "Pagos, cargos, facturas, cambios de suscripción" enruta mejor que la palabra "facturación" por sí sola. Tampoco le pidas que se explique, porque la respuesta contiene una decisión, probabilidades y confianza, y nada más.
Una pregunta, un juicio. "¿Es este cliente potencial valioso, urgente y propenso a comprar?" son tres preguntas disfrazadas. Divídelas y combina los resultados en el código, donde puedes ver los pesos y cambiarlos.
Mantén la aritmética fuera del modelo. Jev juzga el significado. Tu programa hace los cálculos, aplica la tabla de descuentos y verifica los términos del contrato. Esa división es lo que hace que todo sea auditable.
TypeSafe también distribuye una habilidad plug-in que enseña estas convenciones a los agentes de codificación, instalable en Claude Code con claude plugin marketplace add typesafe-ai/skills o en otro lugar con npx skills add typesafe-ai/skills. La página de habilidades del agente tiene los detalles.
Mantén el estado limpio
Un estado relevante supera a un estado máximo. Tres secciones suelen cubrirlo: el objeto que se está juzgando, el contexto necesario para leer ese objeto y los hechos que cambiarían la decisión si cambiaran. Todo lo demás es ruido que estás pagando por enviar.
Elimina las líneas de registro duplicadas, el historial anterior al problema actual y cualquier frase que exprese la conclusión que esperas que el modelo alcance. El límite máximo es de 64k tokens por solicitud, con 32k disponibles para el estado más la pregunta más larga, pero la precisión puede cambiar mucho antes de que lo alcances. Cuando el enrutamiento se vuelve confuso, reducir el estado suele ser una solución más rápida que reescribir los criterios.
Preguntas paralelas y puertas de confianza
Dado que Jev lee el estado una vez, la decimotercera pregunta cuesta mucho menos que un segundo viaje de ida y vuelta. Envía cada juicio independiente que podría cambiar una acción: intención, riesgo, urgencia, sentimiento, relevancia, siguiente paso requerido. Luego, elimina cualquier pregunta cuya respuesta nunca cambie lo que hace tu código. Una señal no utilizada es un costo de mantenimiento sin beneficio.
Haz coincidir la primitiva con la forma del juicio. Los gradientes como severidad, calidad y ajuste pertenecen a score, no a un sí/no forzado. Una única afirmación fáctica pertenece a noul. Un conjunto fijo de destinos pertenece a choice.
La puerta es donde reside realmente la arquitectura. Una respuesta tipificada aún puede ser una respuesta incorrecta, por lo que la confianza decide qué sucede a continuación. Un patrón inicial viable: actuar automáticamente por encima de 0.85, pasar de 0.55 a 0.85 a un modelo más potente o a una segunda pasada, y poner en cola cualquier cosa por debajo de 0.55 para una persona. Esos números exactos son ilustrativos. El patrón de enrutamiento por confianza de TypeSafe establece un umbral separado por acción basado en el costo de equivocarse, y su página de confianza te dice que "pruebes con tus propios datos y ajustes a medida que observes los resultados". Una vez que tus umbrales estén ajustados, fija el modelo: jev-latest sigue la versión estable más reciente, mientras que jev-1.13.0 congela el comportamiento que mediste.
Prueba la capa de decisión en Apidog
Una capa de decisión solo es digna de confianza si puedes probar cómo se comporta. Esto significa solicitudes guardadas y aserciones, no un historial de terminal de curls únicos. Apidog te ofrece ambas cosas, y las aserciones se ven diferentes de las pruebas de API normales porque estás verificando números y valores enumerados en lugar de cadenas.
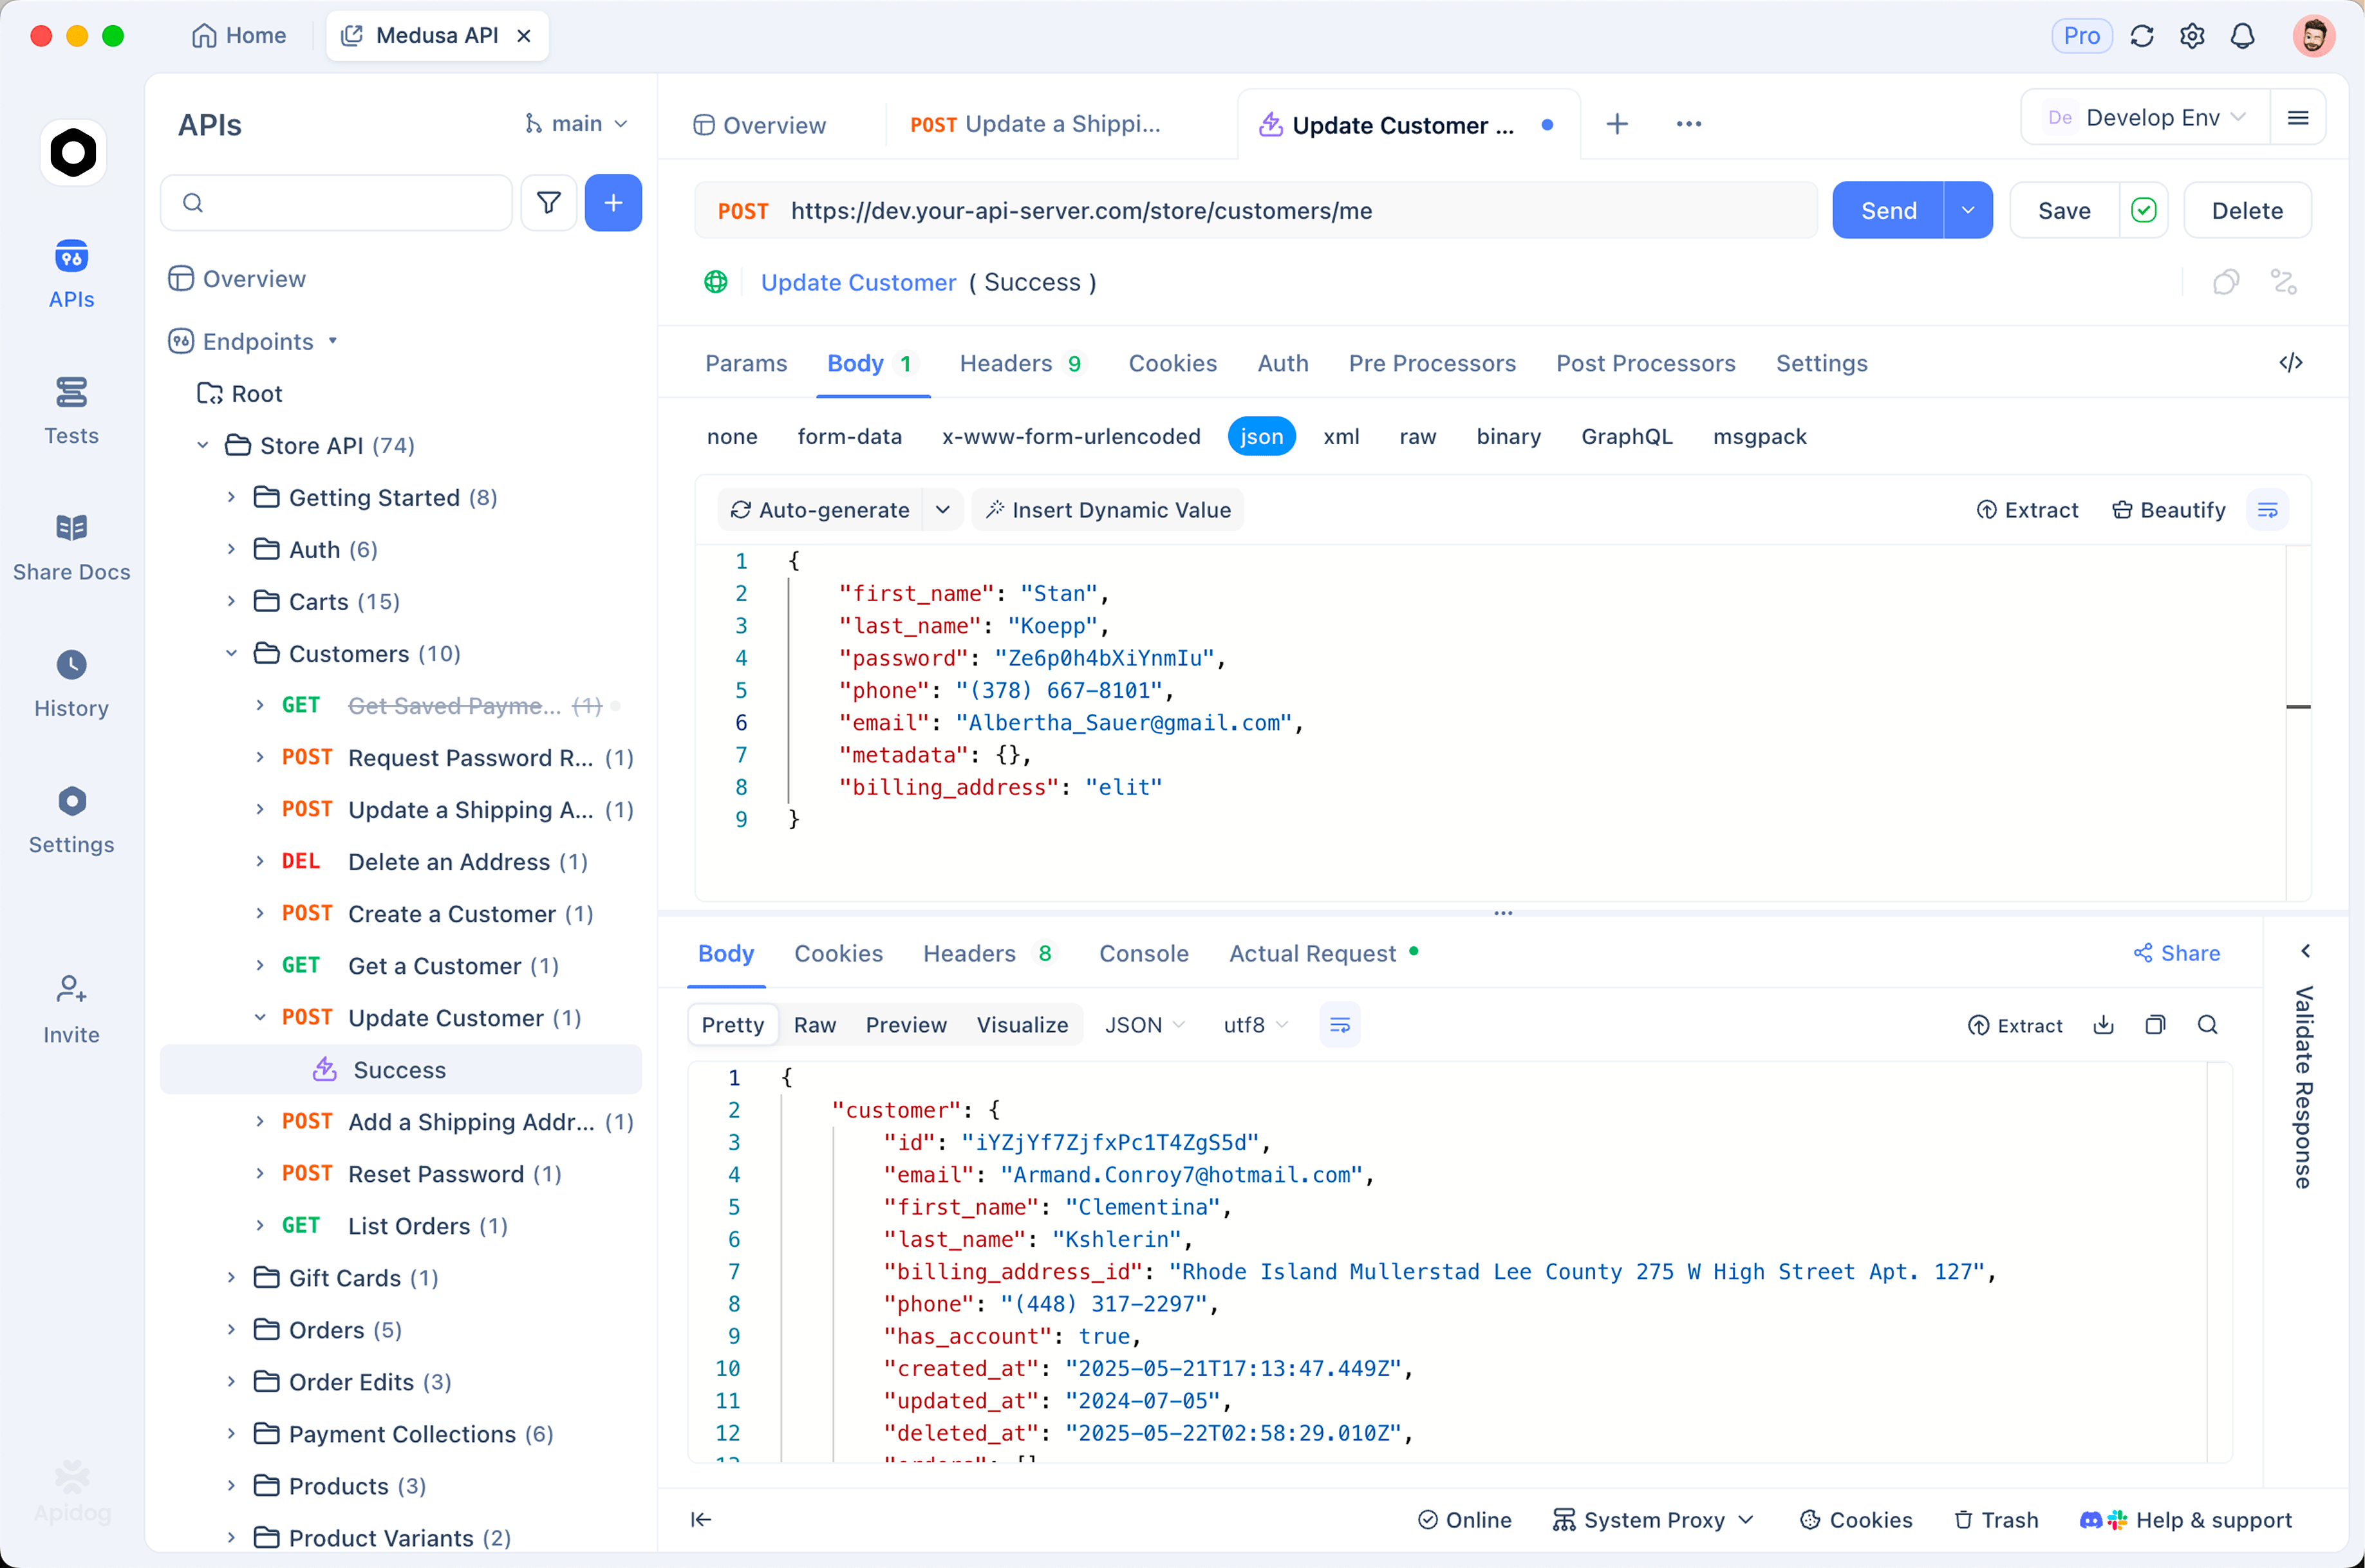
Almacena la clave como una variable de entorno. Crea un entorno llamado TypeSafe, añade TYPESAFE_API_KEY como un valor local para que permanezca en tu máquina, y haz referencia a ella como {{TYPESAFE_API_KEY}} en un token Bearer. Nuestra guía sobre entornos y variables secretas cubre las reglas de alcance.
Envía la llamada real. POST https://api.typesafe.ai/v1/systemone con el cuerpo de estado más preguntas anterior.
Afirma la decisión. Añade aserciones de post-procesador como answers.department.choice igual a billing, answers.urgent.noul mayor que 0.9, y answers.frustration.score mayor que 1.5. Ahora un cambio de comportamiento falla una prueba en lugar de enrutar silenciosamente los tickets de forma incorrecta.
Luego construye el escenario que importa. Guarda un pequeño conjunto de estados etiquetados como un escenario de prueba: una pregunta tranquila, una amenaza de cancelación enojada y un mensaje deliberadamente ambiguo en el que un buen enrutador debería dudar. Afirma una alta confianza en los dos primeros y afirma que la confianza cae por debajo de tu umbral en el tercero. Ese único escenario convierte el ajuste de umbrales en evidencia en lugar de suposiciones, y detecta el fallo que es más difícil de notar a mano: alguien reformula la descripción de un criterio, cada respuesta sigue siendo válida y el enrutamiento cambia silenciosamente. Ejecútalo en CI y la reescritura fallará la compilación.
Simula la forma de la respuesta para que el trabajo de frontend no consuma tokens. Debido a que el objeto answers se declara antes de la solicitud, la simulación y la respuesta en vivo no pueden desviarse. Descarga Apidog para configurarlo; el plan gratuito cubre un equipo de cuatro.
Cinco flujos de trabajo donde una capa de decisión se amortiza sola
- El verificador universal. Envuelve cada llamada costosa de LLM. Comprueba el prompt entrante en busca de inyecciones, la herramienta seleccionada en busca de desajustes obvios, la salida en busca de requisitos faltantes y la respuesta final en busca de afirmaciones que el material fuente no respalda. Controles baratos alrededor de un cerebro caro.
- La torre de control de soporte. Clasifica el ticket, detecta la urgencia, la frustración, la intención de reembolso y el riesgo de cancelación en una sola llamada, luego enruta. La ganancia es menos tickets en la cola incorrecta y menos cuentas valiosas abandonadas.
- Cualificación de leads. Califica el ajuste de la empresa, la madurez técnica, el dolor declarado, la intención de compra y la urgencia como señales separadas, luego combínalas con pesos que poseas y puedas defender en una revisión de pipeline.
- El enrutador de modelos. Decide por solicitud si un código determinista, un modelo pequeño, un modelo de frontera o un humano debe manejarlo. Aquí es donde suelen aparecer primero los ahorros de costes.
- Trabajos con grandes conjuntos de datos. Ejecuta los mismos juicios semánticos en registros de soporte, revisiones, listados, transcripciones o rastros de agentes para extraer características estructuradas y clasificar los registros que merecen una revisión humana. Un análisis que solo se vuelve práctico cuando cada decisión es rápida y casi gratuita.
Preguntas Frecuentes
¿Todavía necesito un modelo de lenguaje? Sí. Jev no puede escribir la respuesta, el resumen o el código. Decide qué sistema debe hacerlo, y puede calificar el borrador después según criterios explícitos como el cumplimiento de políticas o si la respuesta contiene una promesa que usted no hace.
¿En qué se diferencia esto del modo JSON o las salidas estructuradas? Las salidas estructuradas restringen el formato de un modelo de texto; el modelo sigue generando tokens y aún puede afirmar algo falso en una forma válida. Jev devuelve una distribución de probabilidad sobre un conjunto de respuestas que usted definió, por lo que la incertidumbre es un campo de primera clase. Nuestro explicador sobre salidas estructuradas de OpenAI cubre el otro lado de esa comparación.
¿Cómo obtengo acceso? Jev está en acceso anticipado con una lista de espera, por lo que aún no es un servicio de autoservicio. TypeSafe incorpora desarrolladores de la lista en lotes, y usted inicia sesión en console.typesafe.ai una vez que ha pasado. También está disponible a través de Vercel AI Gateway como typesafe-ai/jev mediante experimental_evaluate en AI SDK 7, que es solo SDK y no está expuesto en los puntos finales compatibles con OpenAI. Nuestro tutorial sobre cómo obtener una clave API de Jev tiene los detalles de la solicitud y el SDK.
¿Puedo ejecutar algo así localmente? Varios proyectos reproducen partes de la idea con decodificación restringida sobre pesos abiertos. Los comparamos en OpenJev y las alternativas de código abierto a Jev, incluyendo cuán fiel es cada uno a la confianza calibrada.
Dónde te deja esto
Jev no es el modelo que reemplaza a tus otros modelos. Es la capa que decide cuándo, dónde y si se ejecutan. Constrúyelo de esa manera: un estado limpio, preguntas atómicas con criterios explícitos, evaluación paralela y una puerta de confianza frente a cada acción. Luego, demuestra que la puerta funciona con un escenario guardado en Apidog antes de que enrute un solo ticket real.