
Los agentes de voz solían necesitar tres componentes móviles: voz a texto, un modelo de lenguaje y luego texto a voz. Cada salto añadía latencia y perdía el tono. La API en tiempo real de OpenAI colapsa eso en un solo modelo de voz a voz, y gpt-realtime-2.1-mini es el nivel más económico y rápido de esa familia. Escucha audio, piensa y responde a través de una única conexión de transmisión.
Esta guía le muestra cómo llamarlo de principio a fin: qué ID de modelo usar, cómo conectarse a través de WebSocket y WebRTC, cómo dar forma a una sesión y cómo probar todo con Apidog antes de conectarlo a una aplicación. Todo aquí se corresponde con la guía oficial de OpenAI Realtime.
Primero, asegúrese de usar el nombre de modelo correcto
La nomenclatura confunde a la gente, así que vamos a aclararla antes de cualquier código. Hay dos identificadores para el mismo modelo mini:
gpt-realtime-2.1-mini: el ID versionado. Esto es lo que aparece en la página de precios de OpenAI y lo fija a la generación 2.1.gpt-realtime-mini: el alias de familia. Siempre apunta a la última instantánea, actualmentegpt-realtime-mini-2025-12-15.
Las instantáneas le permiten bloquear el comportamiento en producción:
| Identificador | A qué apunta |
|---|---|
gpt-realtime-mini |
Última instantánea mini (actualización automática) |
gpt-realtime-2.1-mini |
El mini de generación 2.1 |
gpt-realtime-mini-2025-12-15 |
Instantánea fijada (actual) |
gpt-realtime-mini-2025-10-06 |
Instantánea fijada (anterior) |
Utilice el alias mientras construye, luego fije una instantánea con fecha antes de la implementación para que una actualización del modelo nunca cambie el comportamiento de su agente de la noche a la mañana.
Qué hace gpt-realtime-2.1-mini
Es un modelo de voz a voz. Usted transmite audio y este devuelve audio con entonación natural, sin un paso separado de transcripción o TTS. También maneja texto, por lo que puede mezclar entrada escrita y salida hablada en la misma sesión.
Aquí está la hoja de especificaciones de la página del modelo:
| Propiedad | Valor |
|---|---|
| Modalidades de entrada | Texto, imagen, audio |
| Modalidades de salida | Texto, audio |
| Ventana de contexto | 32,000 tokens |
| Salida máxima | 4,096 tokens |
| Conexiones | WebRTC, WebSocket, SIP |
| Voces | alloy, ash, ballad, coral, echo, sage, shimmer, verse, marin, cedar |
marin y cedar son las voces más nuevas y son exclusivas de la API en tiempo real; OpenAI las recomienda para la salida más natural. Las voces más antiguas aún funcionan si desea un timbre específico.
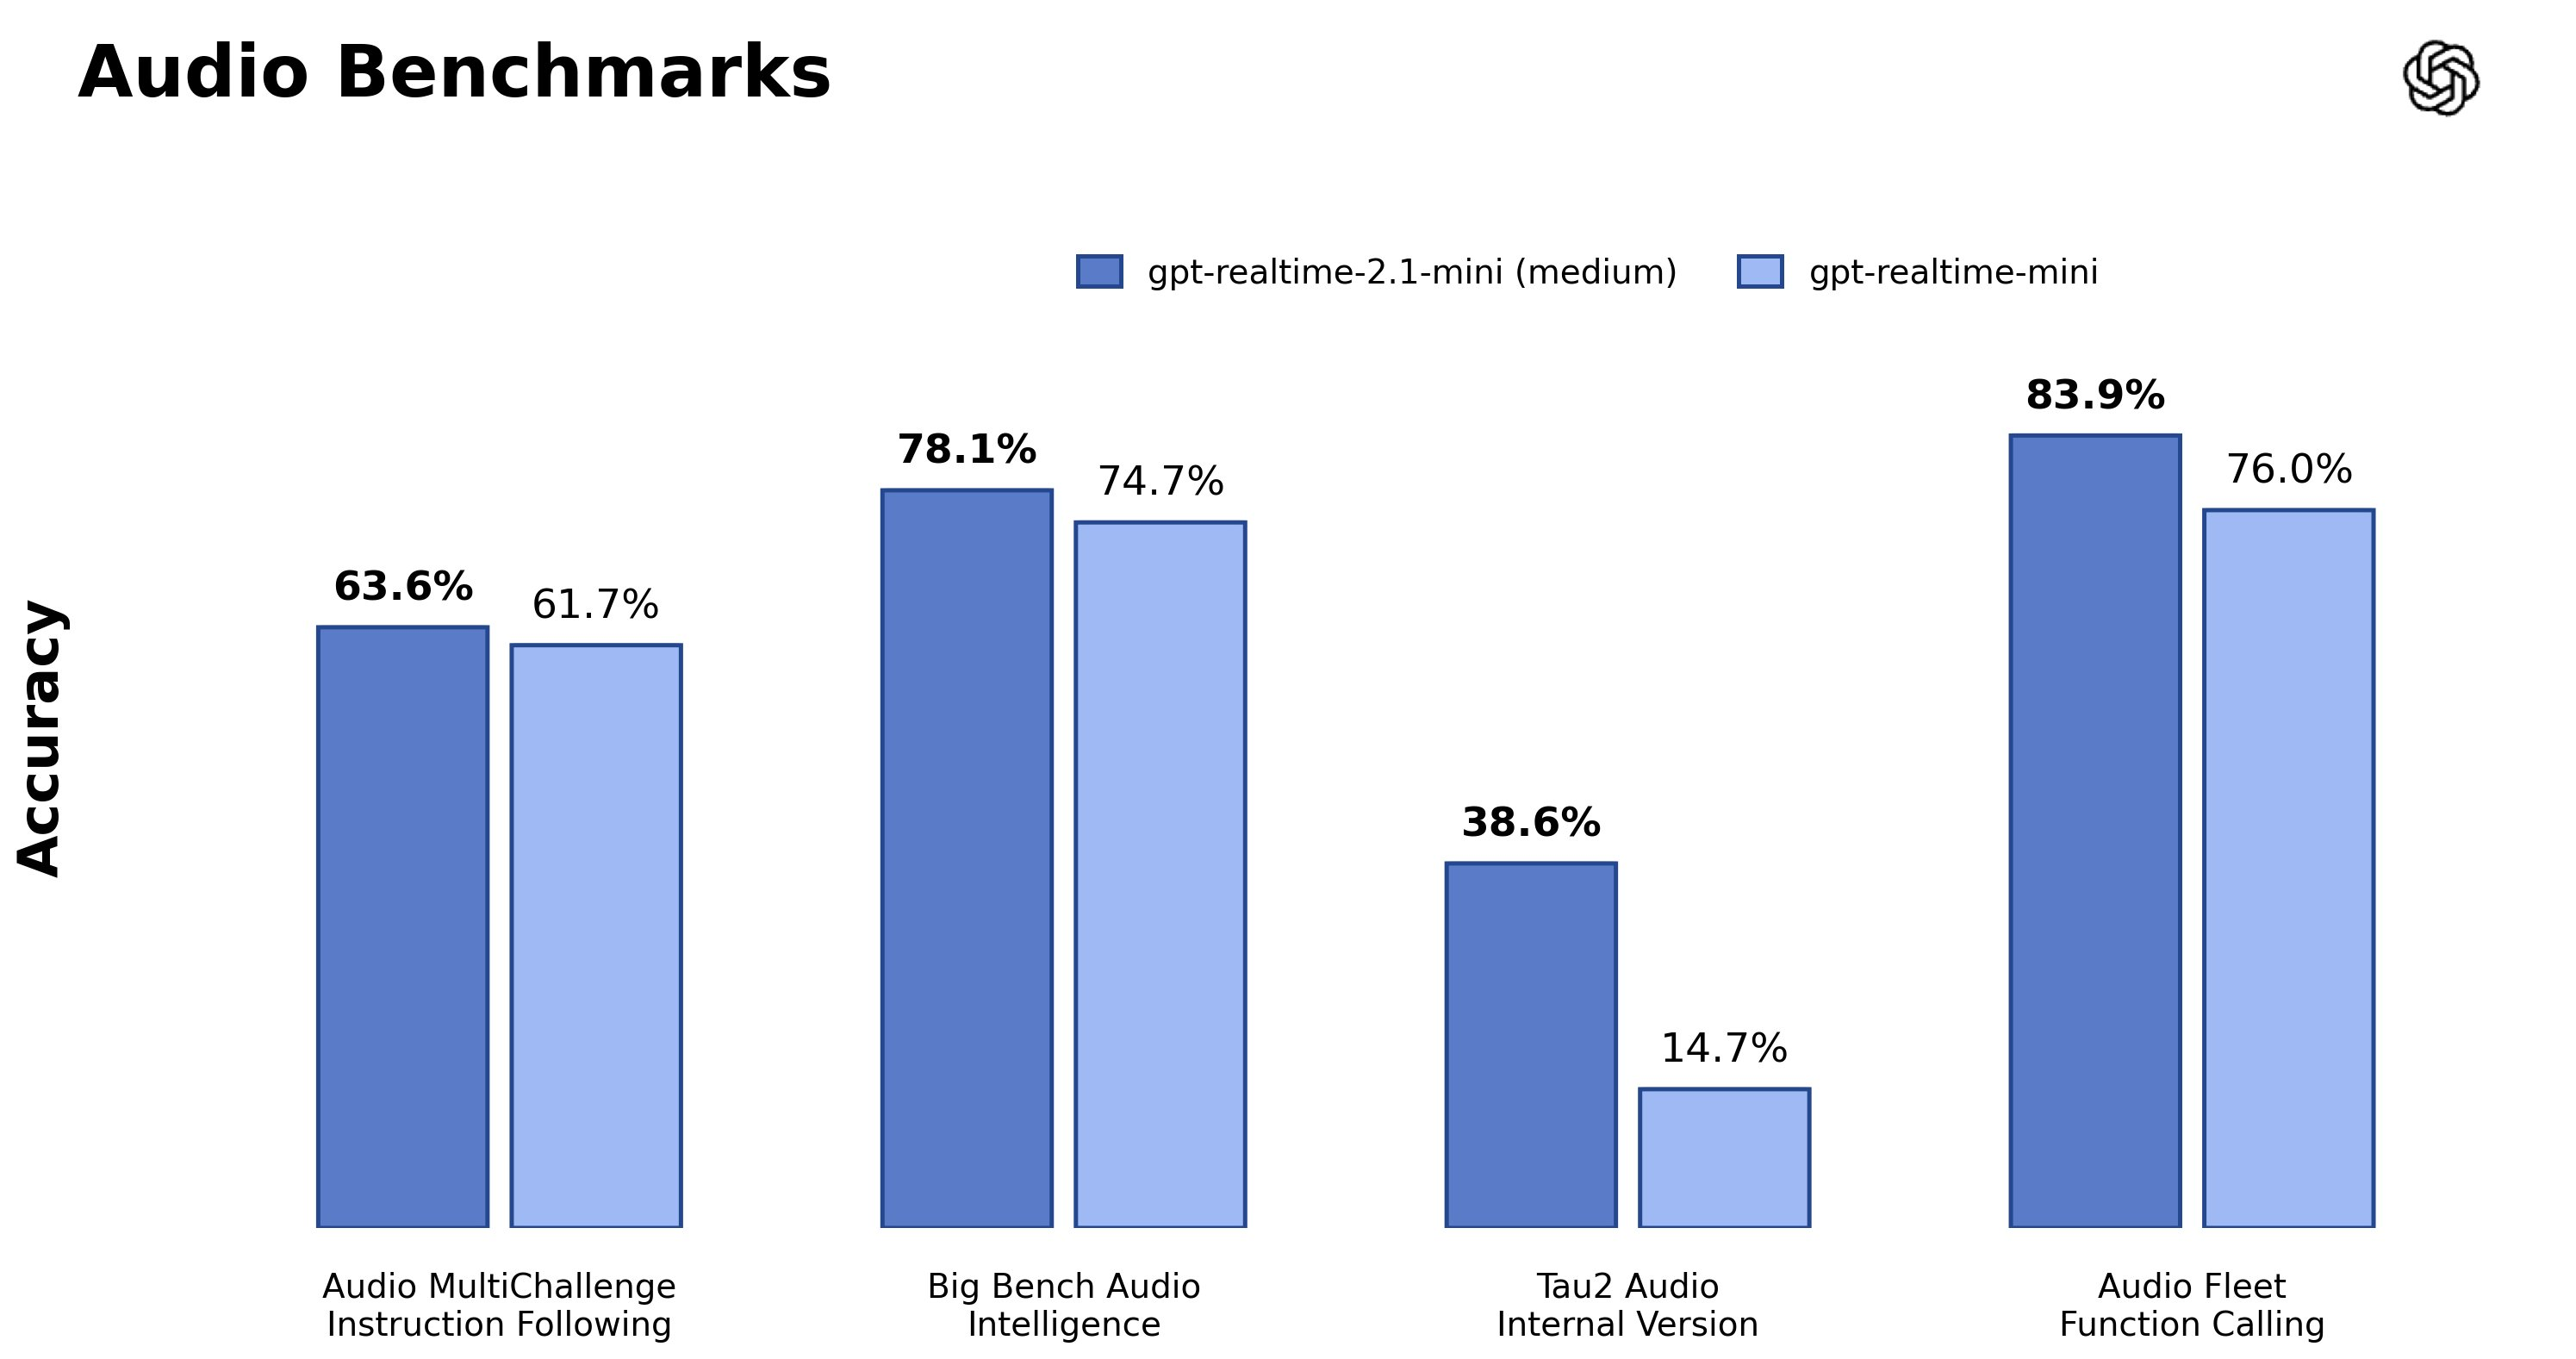
El nivel “mini” sacrifica un poco de profundidad de razonamiento por una menor latencia y una factura mucho más baja. Para la mayoría de los bots de soporte, flujos de toma de pedidos y front-ends de voz, es la opción predeterminada correcta. Recurra al `gpt-realtime-2.1` completo solo cuando la conversación requiera un razonamiento más profundo.
Cuánto cuesta
El modelo mini cuesta aproximadamente un tercio del precio del modelo completo. Tarifas de tokens de la página de precios:
| Modelo | Entrada de texto | Entrada en caché | Entrada de audio | Salida de audio |
|---|---|---|---|---|
gpt-realtime-2.1-mini |
$0.60 / 1M | $0.30 / 1M | $10 / 1M | $20 / 1M |
gpt-realtime-2.1 (completo) |
$4.00 / 1M | $0.40 / 1M | $32 / 1M | $64 / 1M |
El audio domina la factura, y el mayor factor de costo es cuánto habla su agente. Un agente que habla 35 segundos por minuto cuesta aproximadamente el doble que uno que habla 15 segundos por minuto. Los costos reales por minuto para el mini oscilan entre $0.06 y $0.15 dependiendo de la verbosidad, así que indique a su modelo que sea conciso en las instrucciones y reducirá la factura directamente. Las tarifas cambian, así que confirme en la página de precios en vivo antes de hacer su pronóstico.
Requisitos previos
Necesita tres cosas:
- Una clave API de OpenAI con acceso en tiempo real, establecida como
OPENAI_API_KEY. - Node.js 18+ para los ejemplos del servidor (el paquete
wspara WebSocket puro, o el SDK oficial deopenai). - Para audio en el navegador, una página servida a través de HTTPS o
localhostpara quegetUserMediafuncione.
Una regla antes de tocar el navegador: nunca envíe su clave API real al cliente. Las aplicaciones de navegador y móviles usan tokens efímeros de corta duración en su lugar. Más sobre eso a continuación.
Elija un método de conexión
El modelo mini admite tres transportes. Elija según dónde resida su audio.
| Transporte | Usar cuando | Autenticación |
|---|---|---|
| WebRTC | El audio se captura o reproduce en un navegador o aplicación móvil | Secreto de cliente efímero |
| WebSocket | Su servidor ya maneja audio en bruto de un pipeline de medios | Clave API (lado del servidor) |
| SIP | Está conectando un teléfono o sistema de telefonía | Clave API |
La mayoría de la gente comienza con WebSocket para prototipos del lado del servidor, luego se mueve a WebRTC para el cliente real. Hagamos ambos.
Inicio rápido 1: WebSocket desde su servidor
WebSocket es la forma más rápida de ver cómo responde el modelo. El endpoint es una única URL con el modelo en la cadena de consulta:
wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini
Dado que esta es la interfaz GA, se autentica con un encabezado Authorization: Bearer simple y ya no necesita el antiguo encabezado OpenAI-Beta. Aquí hay un "hola mundo" de entrada de texto, salida de texto para que pueda probar sin un micrófono:
import WebSocket from "ws";

const url = "wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini";
const ws = new WebSocket(url, {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  // 1. Configure the session
  ws.send(JSON.stringify({
    type: "session.update",
    session: {
      type: "realtime",
      model: "gpt-realtime-2.1-mini",
      output_modalities: ["text"],
      instructions: "You are a concise API support agent. Keep answers short.",
    },
  }));

  // 2. Add a user message
  ws.send(JSON.stringify({
    type: "conversation.item.create",
    item: {
      type: "message",
      role: "user",
      content: [{ type: "input_text", text: "What is an idempotent request?" }],
    },
  }));

  // 3. Ask for a response
  ws.send(JSON.stringify({ type: "response.create" }));
});

ws.on("message", (raw) => {
  const event = JSON.parse(raw.toString());
  if (event.type === "response.output_text.delta") process.stdout.write(event.delta);
  if (event.type === "response.done") ws.close();
});
El flujo es siempre el mismo: configure, añada entrada, solicite una respuesta, escuche los deltas. Los eventos del servidor se transmiten como JSON. Los que más le interesan son:
session.created/session.updated: su configuración fue aceptadaresponse.output_text.delta: un fragmento de textoresponse.output_audio.delta: un fragmento de audio base64response.output_audio_transcript.delta: la transcripción de lo que dice el modeloresponse.done: el turno ha terminado
Para pasar de texto a voz, cambie output_modalities a ["audio"] y añada una configuración de audio (sección siguiente). El audio llega en eventos response.output_audio.delta como fragmentos PCM base64 que usted decodifica y reproduce.
Inicio rápido 2: WebRTC en el navegador
Para una aplicación de voz real, el navegador captura el micrófono y reproduce la respuesta directamente, lo que mantiene la latencia baja. El problema es la autenticación: no puede exponer su clave API, por lo que su servidor genera un token de corta duración primero.
Paso 1: genere un token efímero en su servidor. Llame al endpoint de secretos de cliente con su clave real:
// server side
const r = await fetch("https://api.openai.com/v1/realtime/client_secrets", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { type: "realtime", model: "gpt-realtime-2.1-mini" },
  }),
});
const { value } = await r.json(); // ephemeral key, starts with "ek_"
Envíe `value` al navegador. Expira rápidamente, por lo que una fuga tiene bajo riesgo.
Paso 2: conéctese desde el navegador con WebRTC. Usted captura el micrófono, abre un canal de datos para eventos e intercambia SDP con el /v1/realtime/calls endpoint:
// browser side: `EPHEMERAL_KEY` came from your server
const pc = new RTCPeerConnection();

// play the model's audio
pc.ontrack = (e) => (document.getElementById("audio").srcObject = e.streams[0]);

// send the mic
const mic = await navigator.mediaDevices.getUserMedia({ audio: true });
pc.addTrack(mic.getTracks()[0]);

// events flow over a data channel
const channel = pc.createDataChannel("oai-events");
channel.onmessage = (e) => console.log(JSON.parse(e.data));

// SDP handshake
const offer = await pc.createOffer();
await pc.setLocalDescription(offer);

const sdpResp = await fetch(
  "https://api.openai.com/v1/realtime/calls?model=gpt-realtime-2.1-mini",
  {
    method: "POST",
    body: offer.sdp,
    headers: {
      Authorization: `Bearer ${EPHEMERAL_KEY}`,
      "Content-Type": "application/sdp",
    },
  }
);
await pc.setRemoteDescription({ type: "answer", sdp: await sdpResp.text() });
Una vez que la conexión está activa, el modelo escucha en la pista del micrófono y habla a través de pc.ontrack. Usted envía la configuración y el texto a través del mismo canal de datos oai-events utilizando los mismos eventos JSON del ejemplo de WebSocket.
Configurando la sesión
El objeto session es donde controla el comportamiento. Esta es la versión de audio completo de lo que vio anteriormente:
{
  type: "session.update",
  session: {
    type: "realtime",
    model: "gpt-realtime-2.1-mini",
    output_modalities: ["audio"],
    instructions: "You are a friendly booking assistant. Confirm details before acting.",
    audio: {
      input: {
        format: { type: "audio/pcm", rate: 24000 },
        turn_detection: { type: "semantic_vad" },
      },
      output: {
        format: { type: "audio/pcm", rate: 24000 },
        voice: "marin",
      },
    },
  },
}
Los campos importantes:
instructions: su `system prompt`. Establezca la persona, las directrices y “sea breve” si le preocupa el costo.output_modalities:["audio"]para un agente que habla,["text"]para un bot solo de transcripción.audio.output.voice: elija entre las diez voces;marinocedarsuenan las más naturales.audio.input.turn_detection: cómo el modelo decide que ha dejado de hablar.semantic_vadespera una pausa natural en el significado;server_vadse activa con el silencio. La detección semántica interrumpe menos y se siente más fluida en la conversación.
Cambie cualquier campo a mitad de la llamada enviando otro session.update. No necesita reconectarse.
Añadiendo herramientas para que el agente pueda actuar
Un agente de voz que solo puede chatear es una demostración. Para reservar una mesa o verificar un pedido, el modelo necesita herramientas. Realtime utiliza el mismo contrato de llamada a funciones que el resto de la plataforma: usted declara funciones en la sesión, el modelo emite una llamada, usted la ejecuta y devuelve el resultado. Si ya ha integrado herramientas en la API de chat, este es el mismo modelo mental; nuestro tutorial sobre la llamada a funciones de OpenAI cubre el esquema en profundidad, y las salidas estructuradas ayudan cuando necesita que los argumentos coincidan con una forma estricta.
Declare las herramientas dentro de la sesión, luego maneje el evento response.function_call_arguments.done, ejecute su código y publique un conversation.item.create con el resultado antes del siguiente response.create. Para cualquier cosa más elaborada que un par de funciones, el AgentKit de OpenAI le ofrece una forma de nivel superior para orquestar agentes de voz de varios pasos.
Pruebe los endpoints con Apidog antes de construir
No querrá depurar una llamada REST y un `handshake` de WebSocket leyendo los registros de la consola en una aplicación a medio construir. Pruebe las piezas de forma aislada primero. Aquí es donde Apidog se gana su lugar en un flujo de trabajo en tiempo real.
Dos cosas que vale la pena validar antes de escribir código cliente:
- El endpoint de token.
POST https://api.openai.com/v1/realtime/client_secretses una llamada REST ordinaria. Cree una solicitud en Apidog, añada su encabezadoAuthorization: Bearer, inserte el cuerpo JSON con su ID de modelo y envíela. Verá el tokenek_y su caducidad inmediatamente, por lo que sabrá que su clave y el acceso a la cuenta son correctos incluso antes de que WebRTC entre en juego. Es el mismo enfoque que usaría para una prueba básica de cualquiera de las superficies REST de OpenAI, como la API de respuestas. - El flujo de mensajes de WebSocket. Apidog tiene un cliente WebSocket, por lo que puede abrir una conexión a
wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini, añadir el encabezado de autenticación y enviar manualmente mensajessession.update,conversation.item.createyresponse.createuno a la vez. Ver cómo los eventos del servidor regresan en un panel legible hace que la secuencia de eventos sea obvia, y puede guardar los mensajes como ejemplos para su equipo. Si ya se apoya en estrategias sólidas de prueba de API, esto encaja perfectamente.
Probar la capa de transporte por sí sola significa que cuando algo falle en la aplicación, ya sabrá que no es el contrato de la API. Descargue Apidog si quiere seguir el tutorial.
Mantenga la factura bajo control
La salida de audio es la parte costosa, por lo que algunos hábitos resultan rentables:
- Indique al modelo que sea breve. "Mantenga las respuestas en una o dos oraciones" en las instrucciones reduce directamente los tokens de salida de audio.
- Fije una instantánea en producción.
gpt-realtime-mini-2025-12-15no se desviará; el aliasgpt-realtime-minisí puede. - Use
semantic_vad. Menos interrupciones falsas significan menos medias respuestas desperdiciadas por las que paga. - Guarde en caché su `system prompt`. La entrada en caché cuesta $0.30 por 1M frente a $0.60 por entrada de texto nueva, por lo que un bloque de instrucciones estable es más económico en cada turno.
- Cierre las sesiones inactivas. Una conexión abierta con un usuario inactivo sigue siendo una sesión por la que se le puede facturar.
Errores comunes y soluciones
- 401 No autorizado: la clave es incorrecta o envió un token efímero caducado. Las claves efímeras son de corta duración por diseño; genere una nueva por sesión.
- Modelo no encontrado: verifique el ID exacto. Es
gpt-realtime-2.1-mini, nogpt-realtime-mini-2.1. - No hay audio en el navegador: probablemente no adjuntó el flujo remoto en
pc.ontrack, o la página no está en HTTPS/localhost, por lo que el micrófono nunca se abrió. - El modelo no deja de hablar sobre el usuario: cambie
turn_detectionasemantic_vady confirme que la pista del micrófono está llegando a la conexión. - Enviando el encabezado beta: el endpoint GA no requiere
OpenAI-Beta: realtime=v1. Elimínelo.
Preguntas frecuentes
¿**Es gpt-realtime-2.1-mini lo mismo que gpt-realtime-mini?** Efectivamente sí. gpt-realtime-2.1-mini es el ID versionado, gpt-realtime-mini es el alias que apunta a la última instantánea (gpt-realtime-mini-2025-12-15). Use el alias para construir, fije la instantánea para la implementación.
¿**Puedo usarlo para transcripción simple en lugar de un agente de voz?** La API en tiempo real está diseñada para la conversación interactiva de voz a voz. Para transcripciones puntuales, los modelos de transcripción dedicados de OpenAI son más adecuados. Use el modelo mini en tiempo real cuando necesite una conversación bidireccional con baja latencia.
¿**Necesito WebRTC, o WebSocket es suficiente?** WebSocket es suficiente para pipelines del lado del servidor y prototipos rápidos. Use WebRTC cuando un navegador o aplicación móvil capture y reproduzca audio directamente, ya que maneja el flujo de medios y la fluctuación (jitter) por usted.
¿**Qué voz debería elegir?** marin y cedar son las más nuevas y naturales, y son exclusivas de la API en tiempo real. Las otras ocho (alloy, ash, ballad, coral, echo, sage, shimmer, verse) siguen funcionando si desea un sonido particular.
¿**Cómo se factura esto?** Por token, dividido por modalidad. Para el mini: $0.60 por 1M de entrada de texto, $10 por 1M de entrada de audio y $20 por 1M de salida de audio. La salida de audio es el costo dominante, por lo que la verbosidad es su principal palanca.
¿**Puede llamar a funciones como los modelos de chat?** Sí. Realtime utiliza el mismo contrato de llamada a funciones, por lo que un agente de voz puede buscar pedidos, verificar el inventario o activar acciones durante la conversación.
A dónde ir ahora
Ahora tiene el ciclo completo: el ID de modelo correcto, un prototipo de WebSocket, un cliente de navegador WebRTC, la configuración de la sesión, las herramientas y una forma de probar cada pieza en Apidog antes de que llegue a producción. Comience con el ejemplo de WebSocket solo de texto para confirmar el acceso, cambie output_modalities a audio, luego pase a WebRTC cuando esté listo para un micrófono real. Fije una instantánea, indique al modelo que sea conciso y tendrá un agente de voz de baja latencia que no le sorprenderá en la factura.