
Para usar Firecrawl Local, instálalo con cargo install firecrawl-local, ejecuta firecrawl-local init para registrarlo como servidor MCP en Claude Code y Cursor, y luego reinicia ambas herramientas. Tu agente ya puede hacer scraping, crawling y mapping de sitios en tu propia máquina. Para usarlo desde código, ejecuta firecrawl-local serve y apunta cualquier SDK de Firecrawl a http://localhost:3002.
Esta guía muestra cómo usar Firecrawl Local paso a paso, con la salida real de nuestra prueba del 19 de noviembre de 2026 (Firecrawl Local 0.1.0 en un Mac arm64), además de los prompts que puedes darle a tu agente y una forma de que ese agente pruebe la API local con Apidog CLI.
Lo que necesitas antes de empezar
Firecrawl Local es un único binario de Rust del repositorio de Firecrawl. Antes de instalarlo, comprueba que tienes:
- Rust y un compilador de C. Consigue Rust en rustup.rs. En macOS ejecuta
xcode-select --install; en Debian o Ubuntu instalabuild-essential. - Node.js 22 o superior si quieres el servidor MCP. Ejecuta el paquete npm
firecrawl-mcpmediantenpx. - Chrome o Chromium (opcional). Firecrawl Local usa el navegador que ya tienes para las páginas que necesitan JavaScript. Las páginas estáticas funcionan sin él.
- Claude Code, Cursor u otro cliente MCP.
inittambién reconoce Claude Desktop, Windsurf, Gemini CLI y Codex.
Si eres nuevo en Firecrawl, empieza por nuestra guía de web scraping con Firecrawl y vuelve después.
Paso 1: Instalar Firecrawl Local
Instala el crate desde crates.io y confirma la versión:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargo lo compila desde el código fuente. En nuestro Mac, la build de release terminó en 6 minutos y 54 segundos, y el binario quedó en ~/.cargo/bin/firecrawl-local. Asegúrate de que esa carpeta esté en tu PATH o anota la ruta completa: la necesitarás para configurar el MCP manualmente.
Paso 2: Haz tu primer scrape desde la terminal
Antes de conectar nada a un agente, comprueba que la descarga funciona:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
Imprimimos el texto principal de la página en markdown en 1,2 segundos. Si quitas --markdown, obtendrás el mismo JSON que devuelve la API de Firecrawl. --format markdown,links selecciona los formatos; las opciones locales son markdown, html, rawHtml y links.
A continuación, un crawl que escribe un archivo markdown por página:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
Esto descargó 20 páginas de la documentación de Firecrawl en 4,4 segundos y guardó archivos con nombres como 0005-docs.firecrawl.dev_advanced-scraping-guide.md. Flags útiles de crawl de firecrawl-local crawl --help:
| Flag | Qué hace |
|---|---|
-l, --limit |
Máximo de páginas (por defecto 100) |
--max-depth |
Cuántos enlaces de profundidad seguir |
--include, --exclude |
Regex de ruta para mantener u omitir, repetible |
--entire-domain |
Seguir enlaces fuera de la ruta inicial |
-c, --concurrency |
Páginas descargadas a la vez |
--ignore-robots |
Omitir robots.txt (por defecto se lee) |
firecrawl-local map https://firecrawl.dev devuelve cada URL que encuentra en los sitemaps y la página inicial, en una sola línea JSON.
Paso 3: Añade Firecrawl Local a Claude Code y Cursor con init
init detecta las herramientas de IA de tu máquina y añade Firecrawl Local a la configuración MCP de cada una. Previsualízalo primero:
firecrawl-local init --dry-run
En nuestro Mac, enumeró cada herramienta que modificaría:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
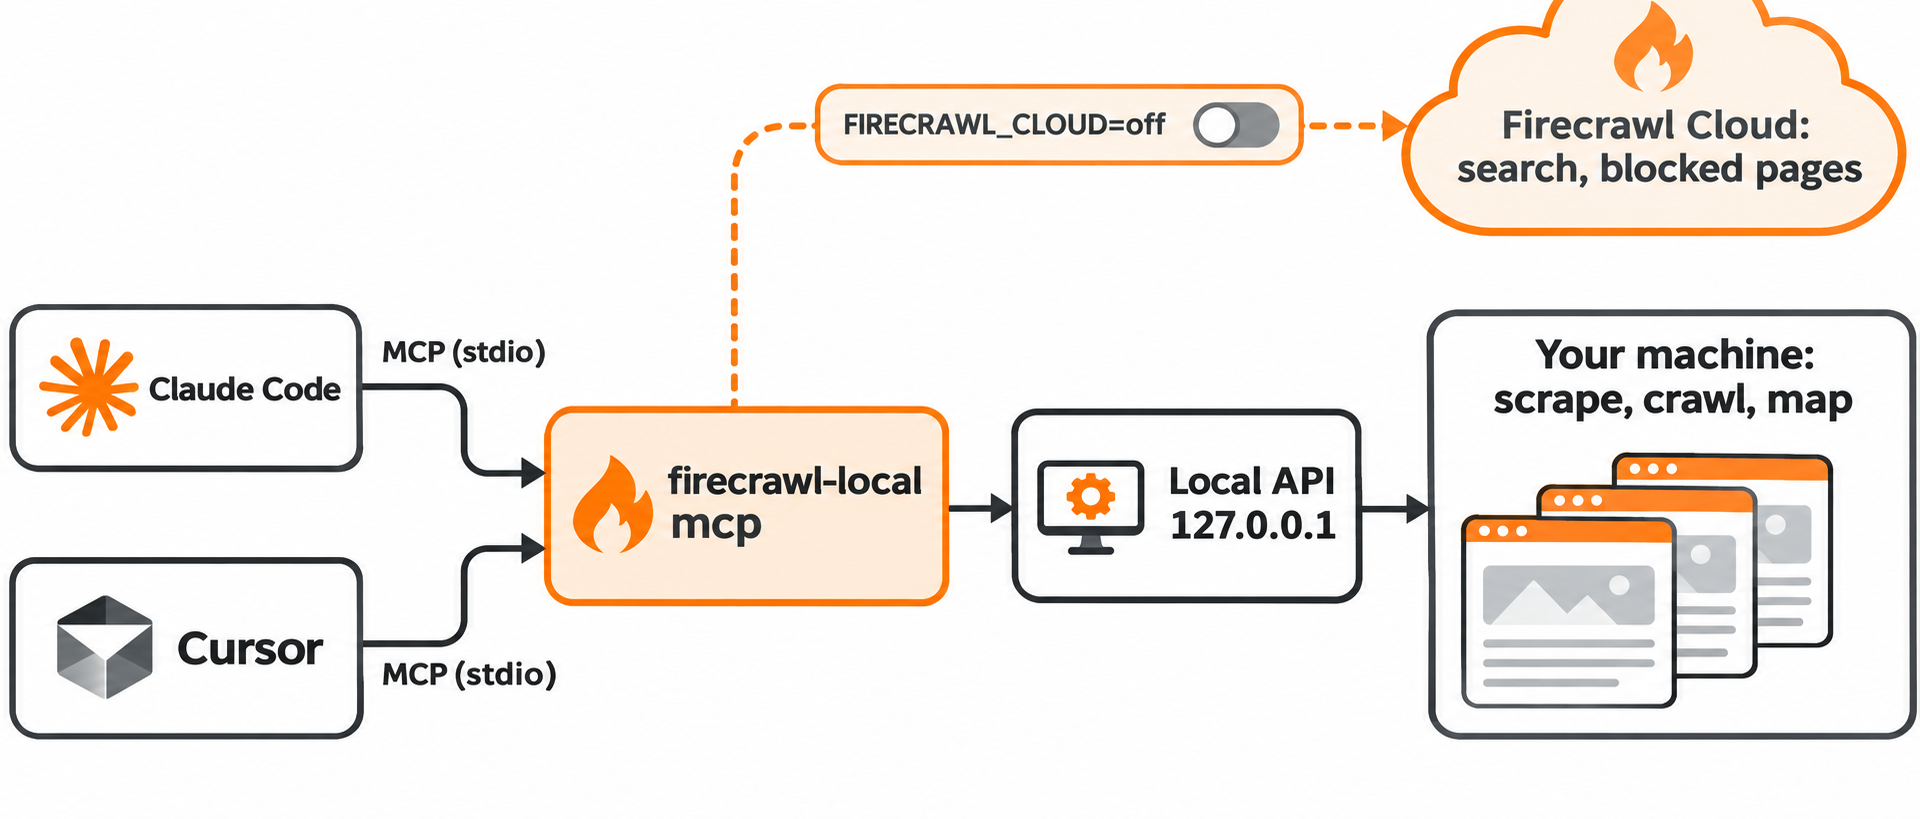
El dry run también muestra qué se envía a Firecrawl Cloud: las consultas de búsqueda, la URL de una página que bloqueó tu máquina, las llamadas a Alexandria cuando inicias sesión, y un ID de instalación aleatorio junto con el nombre de tu herramienta de IA. Las páginas que se cargan bien en local nunca se envían.
Para configurar solo las dos herramientas que cubre esta guía, repite --agent:
firecrawl-local init --agent claude-code --agent cursor
Los nombres válidos son claude-code, claude-desktop, cursor, windsurf, gemini y codex. init hace una copia de seguridad de cada archivo de configuración antes de escribir. Reinicia Claude Code y Cursor después para que carguen el nuevo servidor.
Firecrawl Local en Claude Code manualmente
Si prefieres no dejar que una herramienta edite tu configuración, añade tú mismo el servidor stdio con el comando MCP de Claude Code:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Ejecuta /mcp dentro de Claude Code para confirmar que el servidor está conectado.
Firecrawl Local en Cursor manualmente
Cursor lee los servidores MCP de ~/.cursor/mcp.json (global) o .cursor/mcp.json (un proyecto). Usa la ruta completa al binario:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only hace que el servidor rechace localhost y direcciones de red privada. Mantenlo activo cuando tu agente lea páginas en las que no confías: en caso contrario, las instrucciones ocultas de una página podrían dirigir al agente hacia una URL interna.
Paso 4: Prompts para darle a tu agente
firecrawl-local mcp inicia la API local en un puerto de loopback y ejecuta el paquete firecrawl-mcp contra ella. Tu agente ve las herramientas MCP estándar de Firecrawl; scrape, crawl, map y batch scrape se ejecutan en tu máquina. Si ya has usado el servidor MCP de Firecrawl alojado, los nombres de las herramientas son los mismos.
Prompts que encajan bien con las herramientas locales:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
Evita los prompts que necesiten búsqueda: con FIRECRAWL_CLOUD=off, esa herramienta no llega a ningún sitio. Para una configuración de búsqueda totalmente local, consulta nuestra guía de búsqueda web de código abierto para Claude.
Paso 5: Ejecuta la API local de Firecrawl y apunta tu SDK a ella
Para scripts y pipelines, ejecuta el servidor de la API:
FIRECRAWL_CLOUD=off firecrawl-local serve
Escucha en 127.0.0.1:3002. El health check responde de inmediato:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
Un scrape devuelve la conocida forma v2, con dos marcadores locales dentro: "engine": "local-fetch" y "source": "local", además de creditsUsed: 0.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
Apunta los SDK de Firecrawl a ella sin API key. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
init también sugiere un atajo: define FIRECRAWL_API_URL=http://127.0.0.1:3002 y tu código existente de Firecrawl se ejecutará en local. La CLI de Firecrawl comparte su sesión guardada con Firecrawl Local, así que el login de cualquiera de las dos herramientas sirve para ambas.
Los crawls son asíncronos. POST /v2/crawl devolvió un job ID de inmediato, y GET /v2/crawl/{id} informó de status: completed, total: 10, creditsUsed: 0 y expiresInSeconds: 3587 unos segundos después. Los jobs viven en memoria, caducan una hora después de iniciarse y desaparecen cuando se detiene serve, así que guarda los resultados en cuanto termine un crawl.
El proceso del servidor se mantuvo en unos 10 MB de memoria residente en reposo y 43 MB justo después de ese crawl de 10 páginas, medido con ps. El post de lanzamiento de Firecrawl afirma que es 37 veces más rápido y usa 230 veces menos memoria que Firecrawl autoalojado; el README no publica el método, así que trátalas como cifras de Firecrawl.
Mantén Firecrawl Local completamente local con FIRECRAWL_CLOUD
Por defecto (auto), tres cosas van a Firecrawl Cloud: la búsqueda, las páginas que bloquean tu máquina y los proveedores de datos de Alexandria (que requieren una cuenta gratuita mediante firecrawl-local login). FIRECRAWL_CLOUD controla el traspaso:
| Valor | Efecto |
|---|---|
auto (por defecto) |
Búsqueda, fallback de páginas bloqueadas y Alexandria funcionan |
search |
Solo la búsqueda va a Firecrawl Cloud |
off |
Nada va a Firecrawl Cloud |
Un valor no reconocido cuenta como off. Con la nube desactivada, POST /v2/search responde "code":"CLOUD_ONLY" con un mensaje que te indica que definas FIRECRAWL_API_KEY o FIRECRAWL_CLOUD=auto. Una página que la nube descargó por ti lleva "source": "firecrawl-cloud", así que siempre puedes saber de dónde vino un resultado.
serve rechaza localhost y objetivos privados a menos que pases --allow-private, y para enlazar un --host que no sea loopback se requiere --token. Los metadatos de la nube y las direcciones link-local están bloqueados en todos los modos.
Deja que tu agente de código pruebe la API local de Firecrawl con Apidog CLI
El endpoint de crawl es el que más probablemente rompa un pipeline: es asíncrono, el job expira y si el servidor se detiene, se pierde. En lugar de hacer polling a mano, deja que tu agente de código cree y ejecute una prueba con Apidog CLI.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Después dale un solo prompt a Claude Code o Cursor:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
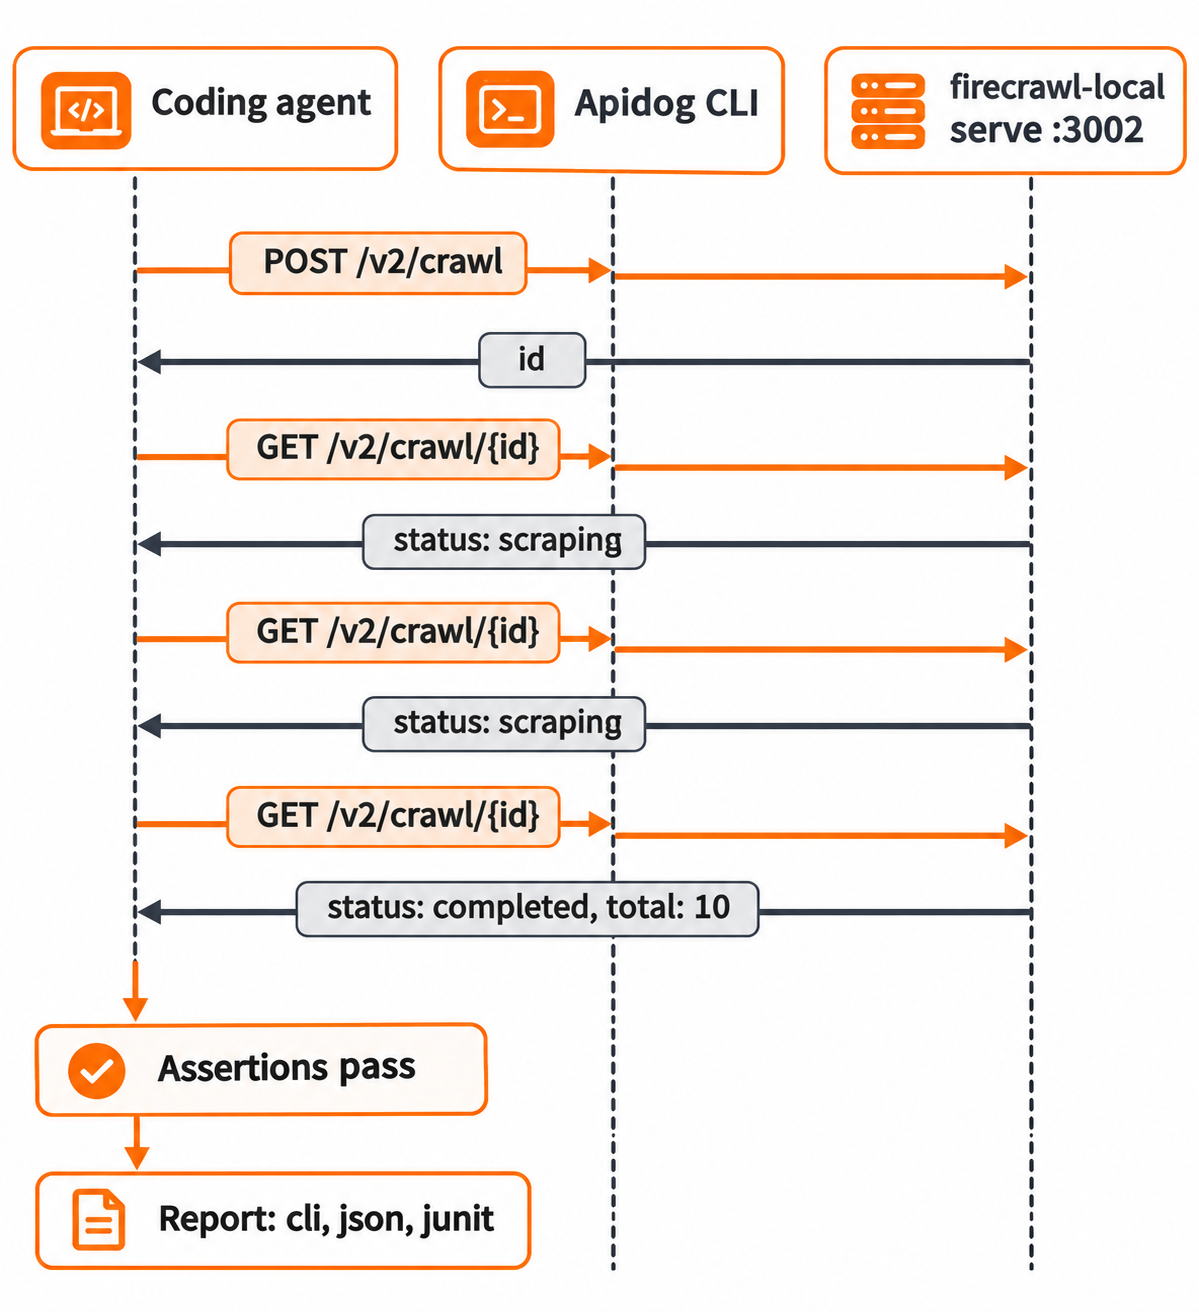
El agente lee el esquema de cada payload, lo valida y ejecuta comandos como estos, todos tomados de apidog <cmd> --help en la CLI 2.2.12:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLI envía solicitudes desde tu máquina, así que localhost:3002 es accesible. Cambia a -r junit para llevar la misma ejecución a CI; nuestras guías de Apidog CLI en Claude Code y Apidog CLI en Cursor cubren el lado del agente. El plan Free de Apidog cubre equipos de hasta 4 usuarios.
Solución de problemas de Firecrawl Local
| Síntoma | Solución |
|---|---|
404 con NOT_FOUND en /v1/scrape |
Solo se sirve v2; cambia tu cliente a /v2/... |
CLOUD_ONLY en /v2/search |
Es lo esperado con FIRECRAWL_CLOUD=off; usa auto o search |
| El agente no muestra las herramientas de Firecrawl | Reinicia la herramienta después de init; comprueba que tienes Node.js 22+ |
| Una página JavaScript devuelve poco contenido | Instala Chrome o define --browser always |
Falta el formato json o summary |
No están soportados en local; en su lugar recibirás un aviso |
| No se encuentra el crawl ID | El job expiró tras una hora o serve se reinició |
Preguntas frecuentes
¿Firecrawl Local es gratis? Las operaciones locales de scraping, crawling y mapping no envían nada a Firecrawl y consumieron 0 créditos en nuestras pruebas. El código es AGPL-3.0; los SDK son MIT. La búsqueda y Alexandria pasan por Firecrawl Cloud.
¿Necesito una API key para usar Firecrawl Local? No, no para las rutas locales. Solo necesitas una key, mediante firecrawl-local login o FIRECRAWL_API_KEY, para los proveedores de datos de Alexandria.
¿Firecrawl Local funciona con Windsurf, Codex y Gemini CLI? Sí. init reconoce windsurf, codex y gemini, además de Claude Code, Claude Desktop y Cursor.
¿Mi código existente de Firecrawl puede ejecutarse contra él sin cambios? Para scrape, map, crawl y batch scrape de v2, sí: cambia la URL de la API a http://localhost:3002. Las rutas v0 y v1 no se sirven, y las actions del navegador se ignoran.
¿Firecrawl Local respeta robots.txt? Sí. Lee robots.txt al hacer crawling y se identifica en su User-Agent, así que los propietarios de sitios pueden dirigirse a él como FirecrawlLocal. --ignore-robots lo desactiva; úsalo solo en sitios que sean tuyos.