
DeepSeek V4 Pro dejó la fase de previsualización el 12 de agosto de 2026. La versión de disponibilidad general (GA), con el sello 0813, ahora sirve el endpoint de la API deepseek-v4-pro, y viene con cifras que parecen errores tipográficos: una ventana de contexto de 1M de tokens, 384K tokens de salida máxima, y un precio de entrada que baja a $0.003625 por millón de tokens en aciertos de caché. Como informó Unite.AI, el modelo que pasó cuatro meses en previsualización es ahora el buque insignia de DeepSeek.
La cobertura del lanzamiento te dice qué se envió, no cómo llamarlo. Esta guía cubre la parte práctica: la primera solicitud con el SDK de OpenAI, los modos de pensamiento y el campo reasoning_content, el streaming, la llamada a herramientas y el cálculo de caché de prompts que decide si ese contexto de 1M es asequible o ruinoso. Si primero quieres la historia de la arquitectura, lee Qué es DeepSeek V4 y luego regresa.
TL;DR
- DeepSeek-V4-Pro-0813 es la instantánea GA detrás del endpoint
deepseek-v4-proa partir del 12 de agosto de 2026, la compilación a la que apuntar en producción. - La API es compatible con OpenAI: apunta el SDK de
openaiahttps://api.deepseek.com, establecemodel="deepseek-v4-pro", listo. El formato de mensajes de Anthropic y la propia API de Respuestas de DeepSeek también funcionan. - Contexto de 1M de tokens, salida máxima de 384K, tres modos de pensamiento (
non-think,think high,think max) que devuelven un camporeasoning_contentjunto con la respuesta. - Precios: $0.435/M de entrada (fallo de caché), $0.003625/M de entrada (acierto de caché, 120 veces más barato), $0.87/M de salida. El almacenamiento en caché es automático en prefijos de prompts repetidos.
- DeepSeek advirtió el 6 de agosto que se avecina un aumento de precio "significativo" en la API. Todavía no hay cifras ni fecha, así que planifica el presupuesto con margen.
- Prueba el endpoint, inspecciona el flujo SSE y mantén los entornos pro/flash uno al lado del otro en Apidog antes de integrarlo en algo real.
Qué cambia la compilación GA 0813 para los desarrolladores
La previsualización se abrió en abril de 2026, el hermano menor V4 Flash se lanzó en julio, y el 12 de agosto el modelo Pro pasó a disponibilidad general como compilación 0813, siguiendo la convención habitual de DeepSeek de fecha (de la misma manera que v3-0324 marcaba una instantánea V3).
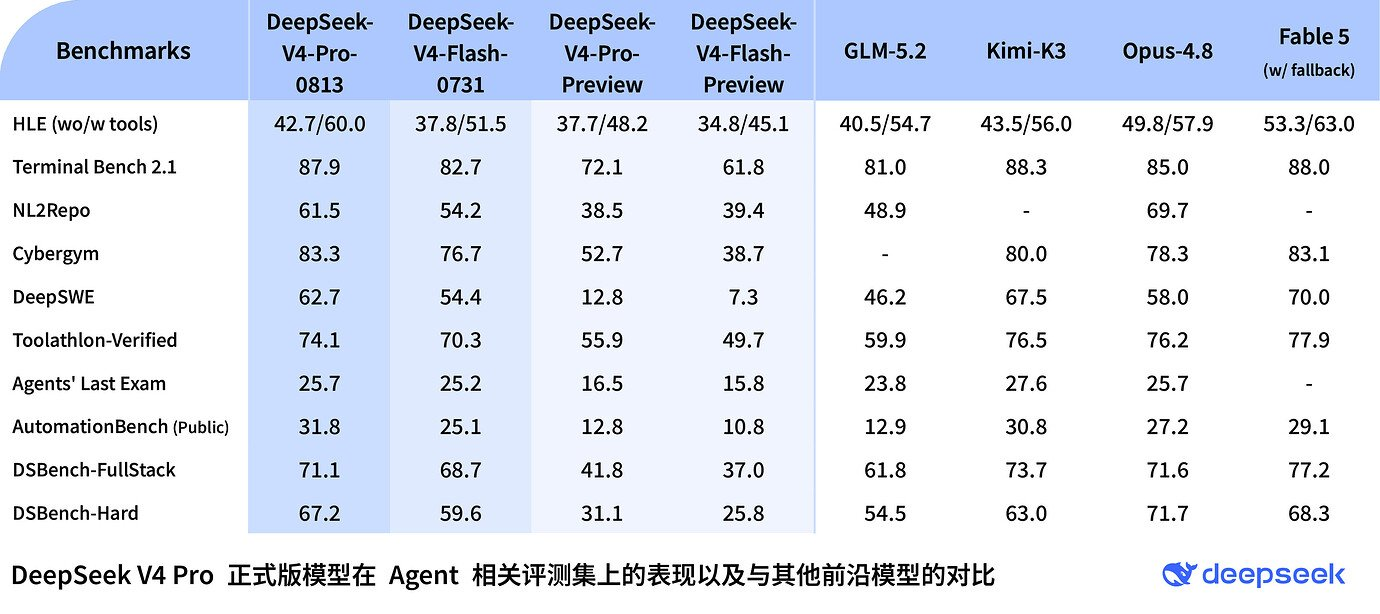
Tres cosas cambian con la disponibilidad general (GA):
- La instantánea es estable. Los modelos de previsualización pueden cambiar sin previo aviso, lo que invalida silenciosamente las evaluaciones y el ajuste de prompts. La compilación 0813 es un objetivo fijo hasta que DeepSeek anuncie una nueva instantánea.
- El endpoint es el alias de producción. En la API oficial, llamas a
deepseek-v4-proy obtienes la compilación 0813; para fijar la instantánea explícitamente, OpenRouter la lista comodeepseek/deepseek-v4-pro-0813. - La superficie completa de características está activa. Los modos de pensamiento, la llamada a funciones, las salidas estructuradas, el almacenamiento en caché de prompts y la API de múltiples formatos (OpenAI, Anthropic, Responses) están todos activos en el endpoint GA.
Bajo el capó, V4 Pro es un modelo de mezcla de expertos con 1.6T de parámetros totales y 49B activos por token. La principal historia de ingeniería es la eficiencia: dos esquemas de atención, Atención Dispersa Comprimida y Atención Fuertemente Comprimida, reducen el cálculo de inferencia de un solo token al 27% del de V3.2 y la caché KV al 10%. Esa reducción de la caché KV es lo que hace que un contexto de 1M de tokens sea utilizable a estos precios en lugar de ser una característica de demostración.
DeepSeek V4 Pro 0813: especificaciones de un vistazo
| Especificación | DeepSeek V4 Pro 0813 |
|---|---|
| Lanzamiento | GA el 12 de agosto de 2026 (instantánea 0813) |
| Arquitectura | Mezcla de expertos, 1.6T parámetros totales, 49B activos por token |
| Atención | Atención Dispersa Comprimida + Atención Fuertemente Comprimida |
| Costo de inferencia vs V3.2 | 27% del cálculo de un solo token, 10% de la caché KV |
| Ventana de contexto | 1.000.000 tokens |
| Salida máxima | 384K tokens |
| Modos de pensamiento | sin pensamiento, pensamiento alto, pensamiento máximo |
| Precio de entrada | $0.435/M tokens (fallo de caché), $0.003625/M (acierto de caché) |
| Precio de salida | $0.87/M tokens |
| Formatos de API | Completions de chat de OpenAI, Mensajes de Anthropic, Respuestas de DeepSeek |
| ID del modelo | deepseek-v4-pro |
| Hermano menor | deepseek-v4-flash (284B total / 13B activos), $0.14/M entrada, $0.28/M salida |
En cuanto a capacidad, la propia ficha del modelo de DeepSeek enumera SWE-bench Verified en 80.6%, Terminal Bench 2.0 en 67.9%, GPQA Diamond en 90.1% y LiveCodeBench en 93.5% para V4-Pro-Max, la configuración de pensamiento máximo. Esos son números del proveedor auto-reportados que ningún tercero ha verificado aún, así que ejecuta tus propias evaluaciones específicas de tarea antes de migrar cualquier cosa importante.
Obtén una clave API y haz tu primera solicitud
La configuración toma unos cinco minutos:
- Crea una cuenta en la plataforma DeepSeek (platform.deepseek.com) y añade crédito, la API es prepago.
- Abre Claves API, genera una clave y cópiala inmediatamente (se muestra una sola vez).
- Exponla como una variable de entorno en lugar de pegarla en el código:
export DEEPSEEK_API_KEY="sk-..."
La API utiliza el protocolo de Completions de chat de OpenAI, por lo que el paquete estándar openai es el cliente. Tanto https://api.deepseek.com como https://api.deepseek.com/v1 funcionan como URLs base; el /v1 es compatibilidad de protocolo, no una versión del modelo.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Imprime response.usage desde el primer día. Con un modelo tan barato en aciertos de caché y tan caro en fallos de caché de 1M de tokens, la contabilidad de tokens es la diferencia entre un error de redondeo y una factura real.
La misma solicitud sobre HTTP puro, útil para pruebas de humo y para importar a herramientas de API:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
La referencia completa de parámetros se encuentra en la documentación oficial de DeepSeek, incluyendo el endpoint compatible con Anthropic (utilizable desde el SDK de Anthropic y Claude Code sin reescribir nada) y la propia API de Respuestas de DeepSeek.
Trabajando con los tres modos de pensamiento
V4 Pro expone el razonamiento como un selector en lugar de un modelo separado. Un endpoint, tres modos:
- sin pensamiento (non-think): el modelo responde directamente. El más rápido y económico, adecuado para extracción, clasificación, formato y resúmenes.
- pensamiento alto (think high): el modelo razona antes de responder y devuelve ese razonamiento en un campo
reasoning_content. El predeterminado para codificación, depuración y análisis de múltiples pasos. - pensamiento máximo (think max): presupuesto de razonamiento máximo, la configuración detrás de los números de referencia de V4-Pro-Max. Guárdalo para problemas verdaderamente difíciles.
Los modos se asignan al parámetro estándar reasoning_effort, por lo que no se necesita ninguna configuración específica del proveedor:
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
Dos notas prácticas. Primero, nunca vuelvas a introducir reasoning_content en el historial de la conversación; envía solo el content de los turnos anteriores. Segundo, los tokens de razonamiento se facturan como tokens de salida a $0.87/M, por lo que el pensamiento máximo cuesta dinero real y latencia real. Ajusta el modo a la tarea en lugar de establecer el máximo por defecto.
Respuestas en streaming
Con una salida máxima de 384K y modos de pensamiento que pueden razonar extensamente, las solicitudes sin streaming resultan en una mala experiencia de usuario. Establece stream=True y maneja ambos tipos de delta, en los modos de pensamiento, los fragmentos de reasoning_content llegan primero, luego la respuesta:
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
Un patrón de interfaz de usuario sensato: renderiza la fase de razonamiento colapsada como un indicador de “pensando”, luego cambia a la renderización normal cuando comienzan los deltas de content. Bajo el capó, esto son eventos enviados por el servidor estándar; nuestra guía sobre streaming de respuestas API con SSE cubre la mecánica.
Llamada a herramientas y salidas estructuradas
V4 Pro soporta la llamada a funciones al estilo OpenAI, lo que significa que los bucles de agente existentes se portan sin modificaciones. Define herramientas, lee tool_calls, ejecuta, añade resultados, repite:
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
Las salidas estructuradas funcionan a través del parámetro estándar response_format cuando necesitas JSON garantizado y parseable. Un recorrido completo por los bucles de herramientas de varios pasos merece su propio artículo; la documentación oficial cubre los detalles de la forma de los mensajes.
Economía de la caché de prompts: el número que cambia tu arquitectura
Aquí está la especificación que merece más atención que los benchmarks. DeepSeek almacena en caché automáticamente los prefijos de los prompts, sin cabeceras de control de caché, sin configuración de TTL, y los prefijos repetidos se facturan a $0.003625/M en lugar de $0.435/M. Eso es un descuento de 120 veces para la entrada que la API ya ha visto.
Calcula los números para una carga de trabajo realista. Digamos que estás construyendo un agente de codificación que mantiene un contexto de repositorio de 200K tokens y realiza 50 llamadas en una sesión:
- Sin caché: 50 llamadas × 200K tokens × $0.435/M ≈ $4.35 en costos de entrada.
- Con caché automática: un fallo de caché ($0.087) + 49 aciertos de caché (≈ $0.0007 cada uno) ≈ $0.12.
La misma sesión, aproximadamente 35 veces más barata, y todo lo que se necesita es la estructura del prompt: contenido estable primero (prompt del sistema, documentación, contexto del repositorio), contenido volátil al final (el último mensaje del usuario, marcas de tiempo, IDs de solicitud). Cualquier cambio temprano en el prompt invalida el prefijo almacenado en caché a partir de ese punto, por lo que una marca de tiempo en tu prompt del sistema convierte silenciosamente cada llamada en un fallo de caché de precio completo.
Esto también replantea la ventana de contexto de 1M: llenarla cuesta $0.435 en un fallo, pero como prefijo de sesión estable, se lee por aproximadamente un tercio de centavo por llamada. Para la teoría general, consulta Qué es el almacenamiento en caché de prompts.
Probando deepseek-v4-pro en Apidog
Antes de que V4 Pro se acerque al código de producción, pon el endpoint bajo un depurador adecuado. Debido a que la API de DeepSeek es compatible con OpenAI, Apidog la detecta sin ninguna manipulación especial:
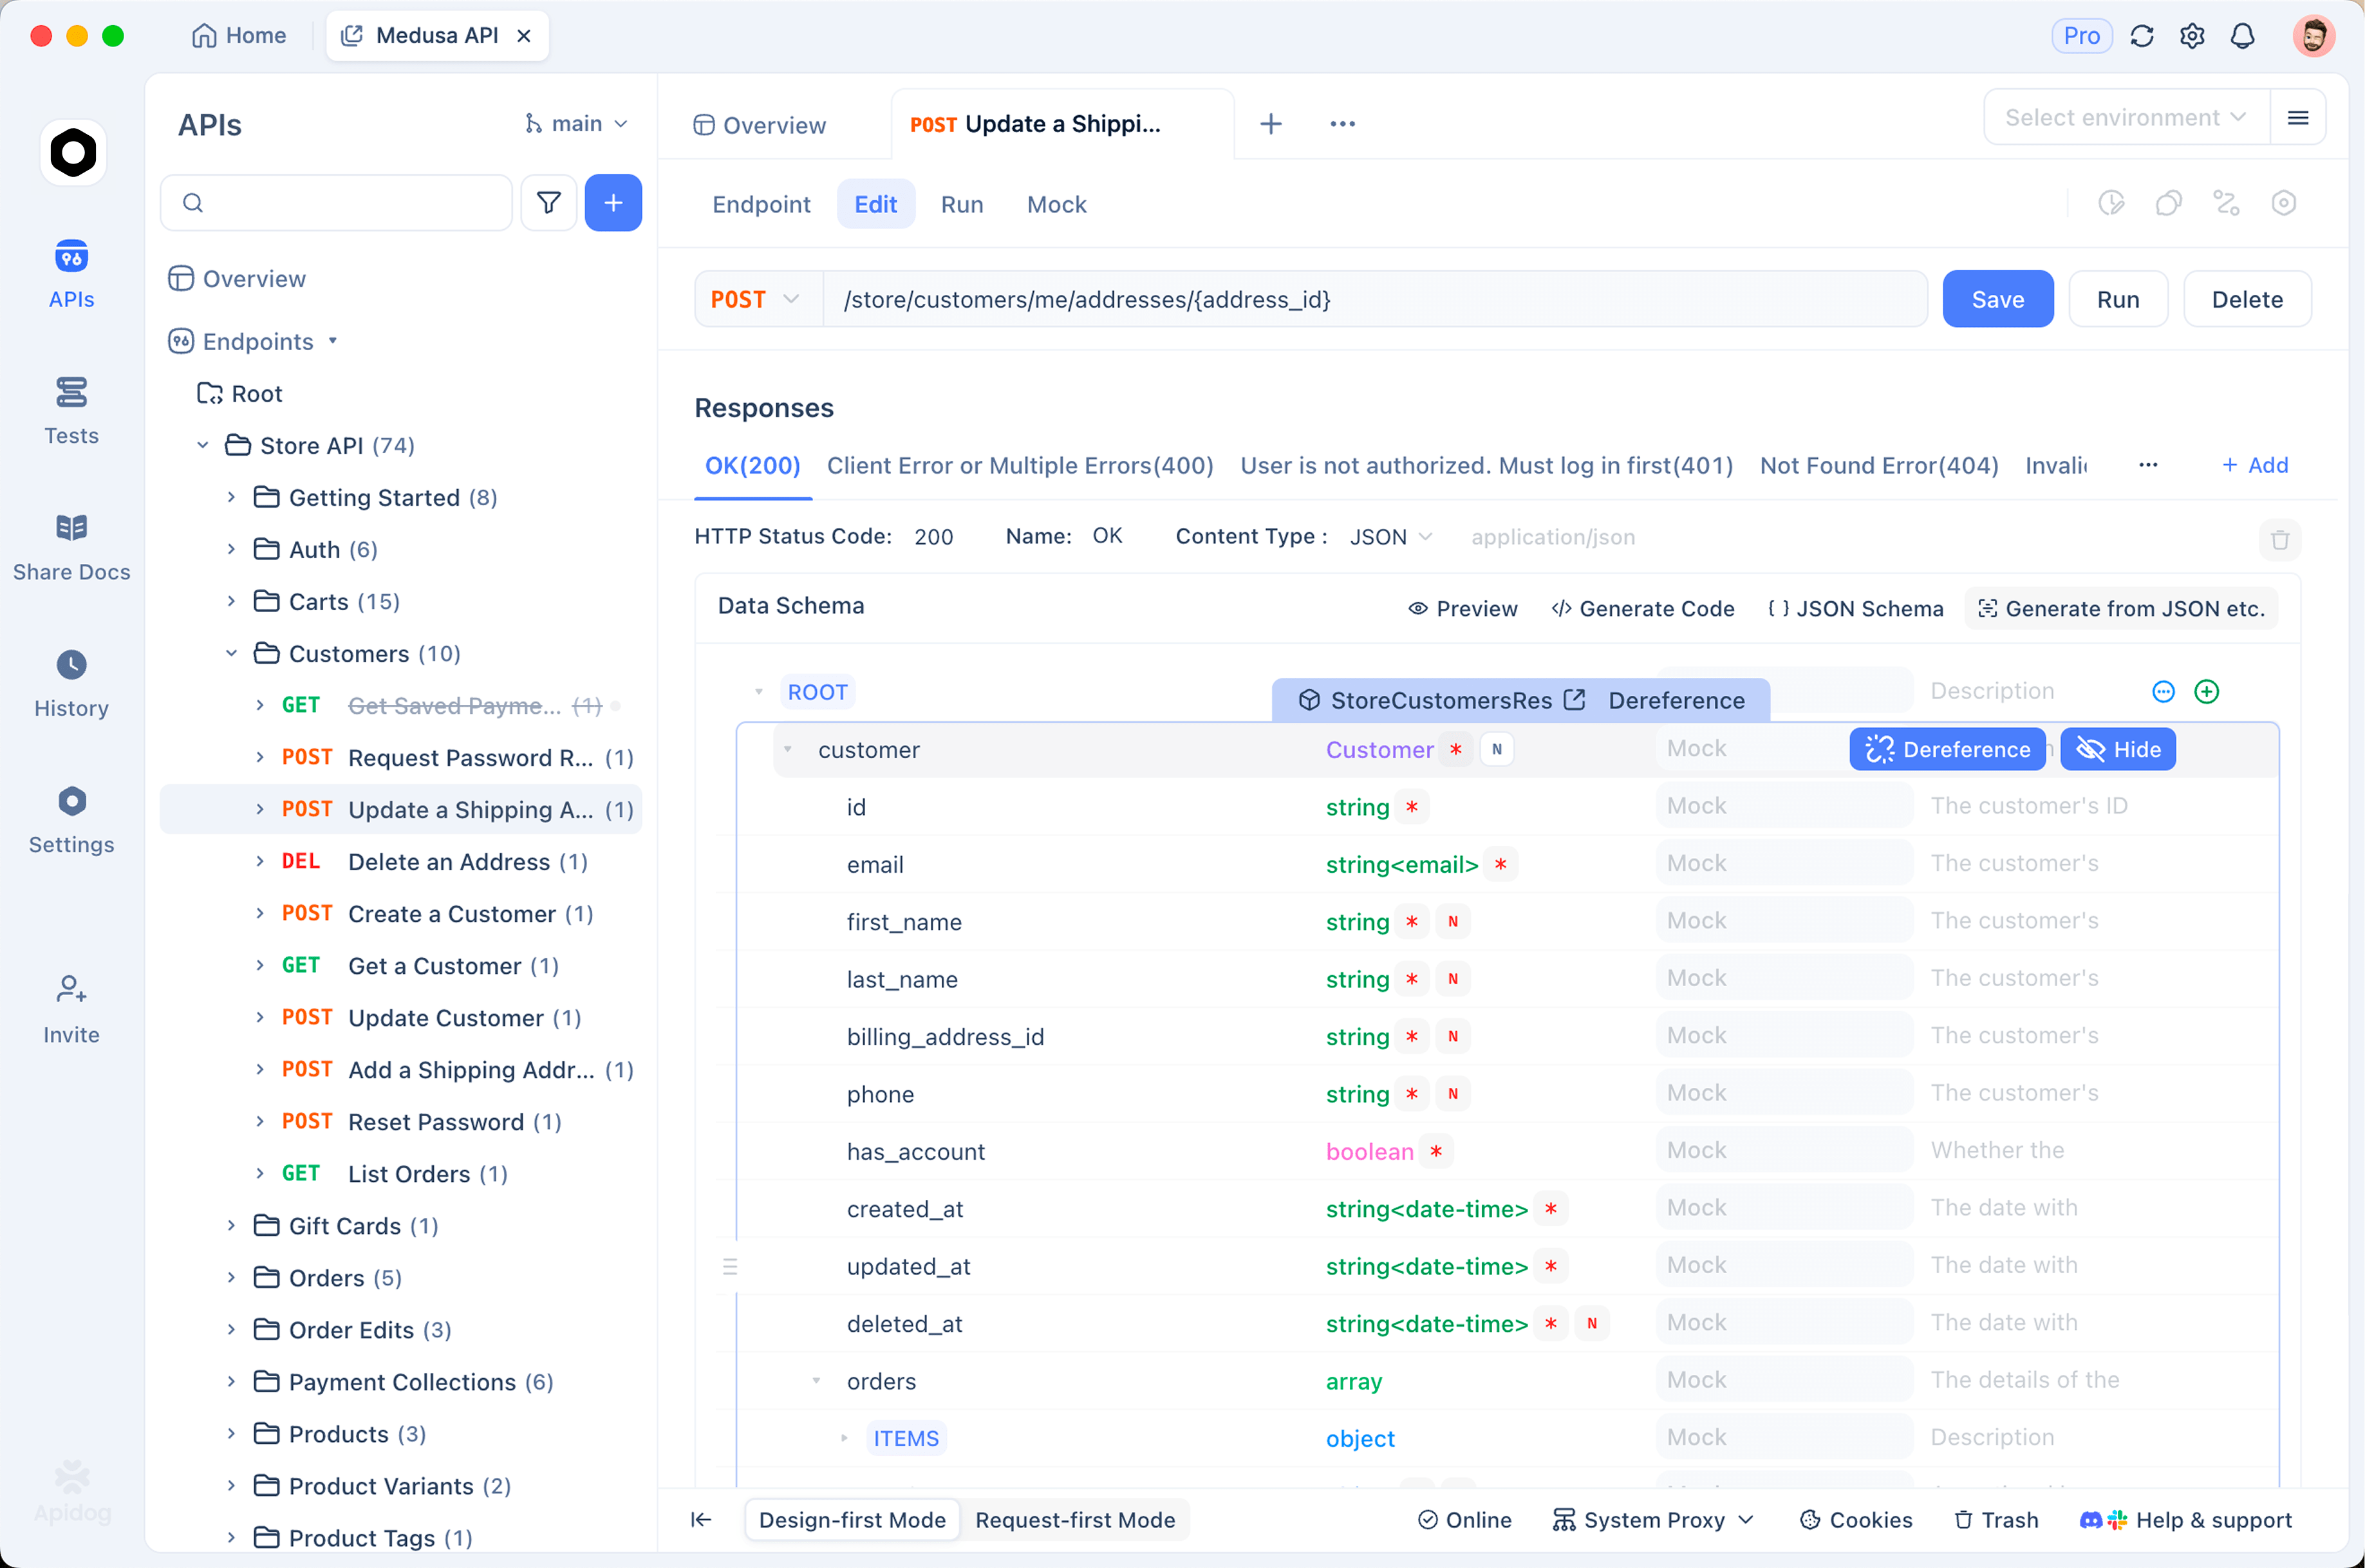
- Importa el endpoint. Pega el comando curl anterior en Apidog y se convierte en una solicitud editable, con encabezados, autenticación y cuerpo analizados automáticamente.
- Configura entornos para Pro y Flash. Almacena
base_urly tu clave API como variables de entorno, y haz que el nombre del modelo también sea una variable. Cambiar entredeepseek-v4-proydeepseek-v4-flashse convierte en un cambio de entorno con un solo clic, lo que convierte la pregunta "¿Vale la pena Pro el triple del precio de Flash en este prompt?" en una cuestión empírica en lugar de un debate. - Inspecciona el flujo SSE. Envía una solicitud con
"stream": truey Apidog renderiza el flujo de eventos como una línea de tiempo en vivo en lugar de una pared de líneasdata:en bruto, fusionando los deltas para que puedas ver cómo llegareasoning_contentantes de la respuesta. Cuando una llamada en modo "pensamiento máximo" se siente lenta, esta vista te muestra exactamente dónde se fue el tiempo. - Guarda la sesión como una colección. Cuando DeepSeek lance la próxima instantánea, vuelve a ejecutar las mismas solicitudes y compara el comportamiento antes de actualizar, el mismo flujo de trabajo que los equipos utilizan para los endpoints compatibles con OpenAI en general.
El visor de respuestas también muestra el bloque usage en cada solicitud, que es la forma más rápida de verificar tu ratio de aciertos de caché mientras ajustas la estructura del prompt.
Precios actuales y el aumento que se avecina
Precios de lista actuales para los dos endpoints V4:
| Modelo | Entrada (fallo) | Entrada (acierto de caché) | Salida |
|---|---|---|---|
deepseek-v4-pro |
$0.435/M | $0.003625/M | $0.87/M |
deepseek-v4-flash |
$0.14/M | $0.28/M |
Incluso a precios Pro, esto supera a los modelos occidentales de vanguardia por un amplio margen. Pero planifica con una advertencia: el 6 de agosto de 2026, seis días antes de la GA, DeepSeek advirtió que se avecina un aumento "significativo" en el precio de la API, sin cifras ni fecha de entrada en vigor.
Estrategias prácticas mientras el número es desconocido:
- Mide tu costo real por tarea ahora, con datos de
usagede cargas de trabajo reales, para que puedas modelar cualquier aumento anunciado en minutos en lugar de adivinar. - Maximiza los aciertos de caché. Si el aumento se aplica proporcionalmente, las arquitecturas con muchos prefijos conservarán la mayor parte de su ventaja.
- Mantén V4 Flash como una alternativa de enrutamiento. Con $0.14/$0.28 y 13B de parámetros activos, maneja tareas simples de gran volumen, por lo que Pro se reserva para las solicitudes que lo necesitan.
Para un desglose más profundo de la estructura de precios de V4 y cómo se compara entre proveedores, consulta nuestra guía de precios de la API DeepSeek V4.
Preguntas frecuentes
¿Funcionará mi código existente del SDK de OpenAI sin cambios?
Casi. Cambia base_url a https://api.deepseek.com, intercambia la clave API y establece model="deepseek-v4-pro". Las Completions de Chat, el streaming, las herramientas y las salidas estructuradas siguen los formatos de OpenAI. Los equipos que utilizan el SDK de Anthropic pueden usar el endpoint de Anthropic Messages de DeepSeek en su lugar.
¿Cuándo debería usar V4 Flash en lugar de V4 Pro?
Flash (284B total, 13B activos) es el modelo de volumen: clasificación, extracción, chat simple, cualquier cosa sensible a la latencia que no necesite un razonamiento profundo. Pro justifica su precio de salida 3 veces mayor en codificación agéntica, análisis de contexto largo y cargas de trabajo en modo de pensamiento. Enruta por tarea, no por lealtad.
¿Puedo usar V4 Pro 0813 en Cursor?
Sí, Cursor acepta endpoints personalizados compatibles con OpenAI, por lo que la compilación GA se integra como un modelo personalizado. Explicamos la configuración exacta en Cómo usar DeepSeek V4 Pro con Cursor.
Para terminar
El primer día con un modelo GA es el momento adecuado para desarrollar la memoria muscular: clave, primera solicitud, modos de pensamiento, streaming y un diseño de prompt consciente del almacenamiento en caché. V4 Pro recompensa este último hábito más que cualquier modelo anterior, el descuento de caché de 120 veces convierte la estructura del prompt en una decisión de arquitectura. Conecta los ejemplos anteriores, observa los números de usage y mantén una colección de Apidog guardada para que puedas volver a verificar el comportamiento cuando llegue la próxima instantánea o el cambio de precio anunciado.