
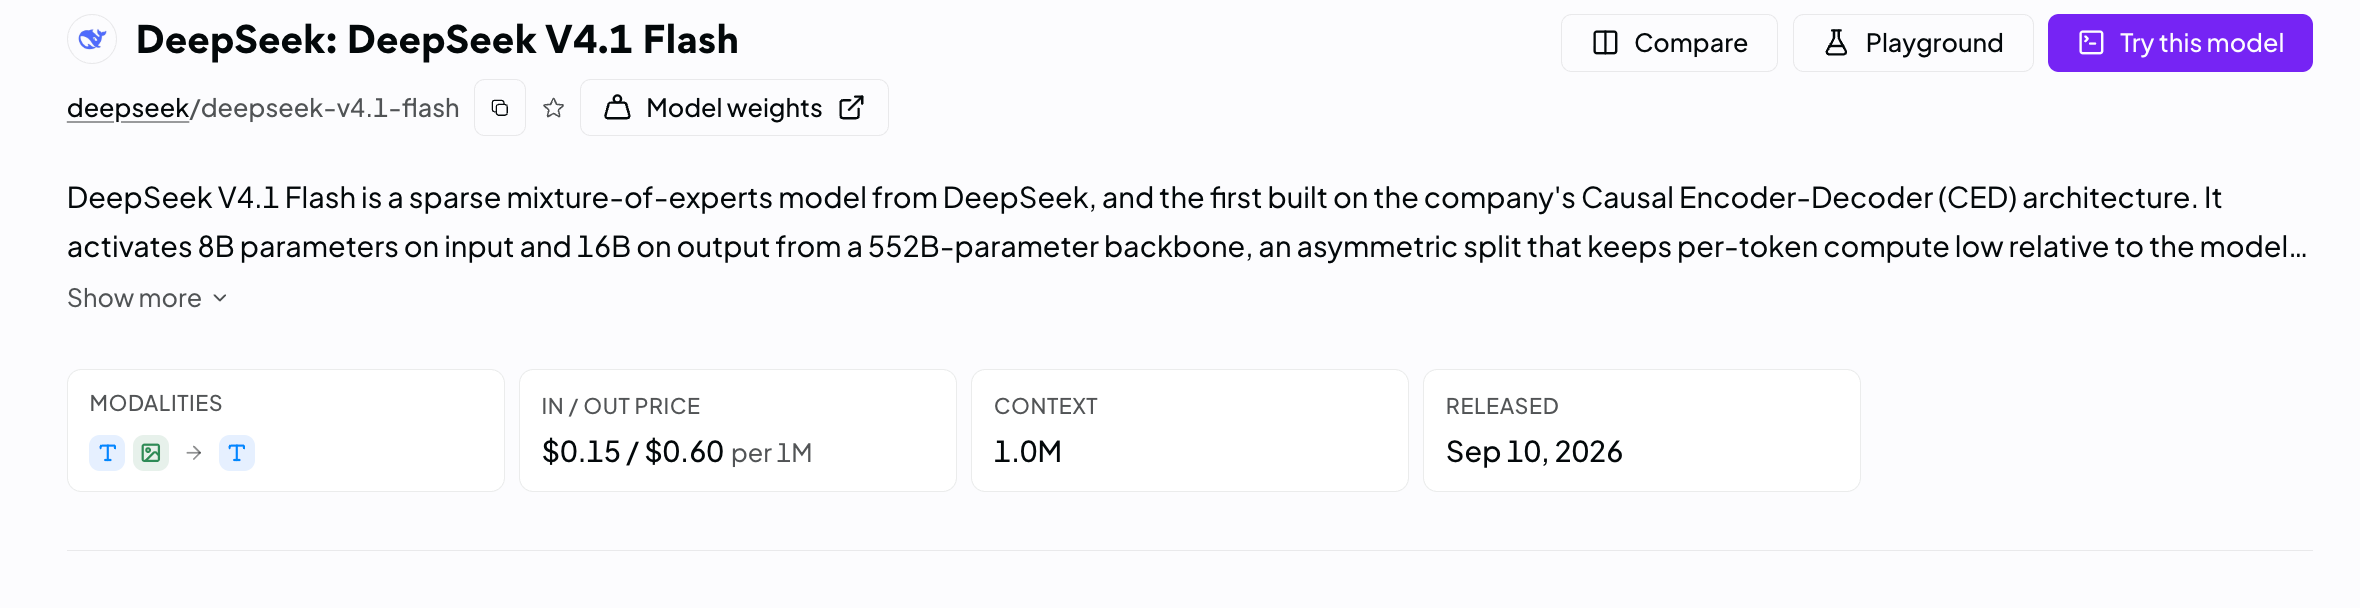
DeepSeek-V4.1-Flash se lanzó al público (GA) en la API el 10 de septiembre de 2026, y llegó con dos hechos que hacen que "gratis" sea una pregunta real en lugar de un gancho de marketing. Los pesos tienen licencia MIT en Hugging Face, por lo que el modelo en sí no cuesta nada. Y la API oficial factura la entrada con acierto de caché a $0.003 por cada 1 millón de tokens fuera de horas pico, lo suficientemente cerca de cero como para que la línea entre gratis y casi gratis deje de importar para la mayoría de los proyectos personales.
Todavía no existe un nivel gratuito permanente en la API de DeepSeek. Cualquiera que te diga lo contrario está describiendo una promoción de enrutador o la aplicación de chat para consumidores. Esta guía clasifica todas las formas honestas de usar V4.1-Flash sin pagar, luego muestra los cálculos del camino de pago para que puedas decidir si "casi gratis" es lo suficientemente cercano. Si primero quieres la historia de la arquitectura, lee qué es DeepSeek-V4.1-Flash y vuelve.
Una nota primero. Varias rutas gratuitas pasan por puntos finales de terceros que te aplican límites de velocidad y a veces cambian los modelos en silencio. Probarlos con Apidog grabando respuestas y afirmando el campo del modelo mantiene tu cuota gratuita alejada de tu propia depuración. Ese flujo de trabajo se encuentra casi al final.
TL;DR
Clasificado de "gratis sin condiciones" a "casi gratis con tarjeta registrada":
- La aplicación de chat DeepSeek en chat.deepseek.com. Gratuita, sin tarjeta. Ideal para evaluar manualmente la calidad de la salida.
- Los pesos abiertos en Hugging Face. Gratuitos bajo licencia MIT, pero 552B parámetros significan que el hardware es el costo.
- Enrutadores de terceros como OpenRouter. Existen niveles gratuitos para algunos modelos en ciertos momentos, con límites de velocidad y compromisos en la política de datos.
- Créditos de prueba incluidos dentro de herramientas de codificación. Solo útiles cuando la herramienta ya envía DeepSeek como backend.
- La API oficial. No es gratuita, pero un proyecto de hobby funciona por aproximadamente $1.35 al mes fuera de las horas pico.
Opción 1: la aplicación de chat DeepSeek
La aplicación para consumidores en chat.deepseek.com es la ruta sin fricciones. Regístrate con un correo electrónico o número de teléfono, sin tarjeta, y comienza a solicitar.
Dos advertencias. Primero, el modelo que la aplicación sirve después del lanzamiento de hoy es [VERIFICAR]. La nota de lanzamiento cubre la API, y la aplicación ha estado previamente rezagada respecto a la API o ha ejecutado una compilación ajustada por separado. Segundo, la aplicación es una interfaz de chat, no una API. No puedes programarla, enviar prompts en lotes ni conectarla a un producto.
Así que la aplicación responde a una pregunta: ¿maneja V4.1-Flash tu dominio lo suficientemente bien como para justificar una integración? Pega la entrada que envían tus usuarios, incluidas las imágenes, ya que el modelo es multimodal de forma nativa. Si las respuestas son satisfactorias, pasa a una de las rutas siguientes.
Opción 2: los pesos abiertos
DeepSeek publicó los pesos y el informe técnico de V4.1-Flash bajo la licencia MIT. Puedes descargarlos, ejecutarlos, ajustarlos y lanzar productos basados en ellos sin pagar a DeepSeek ni pedir permiso.
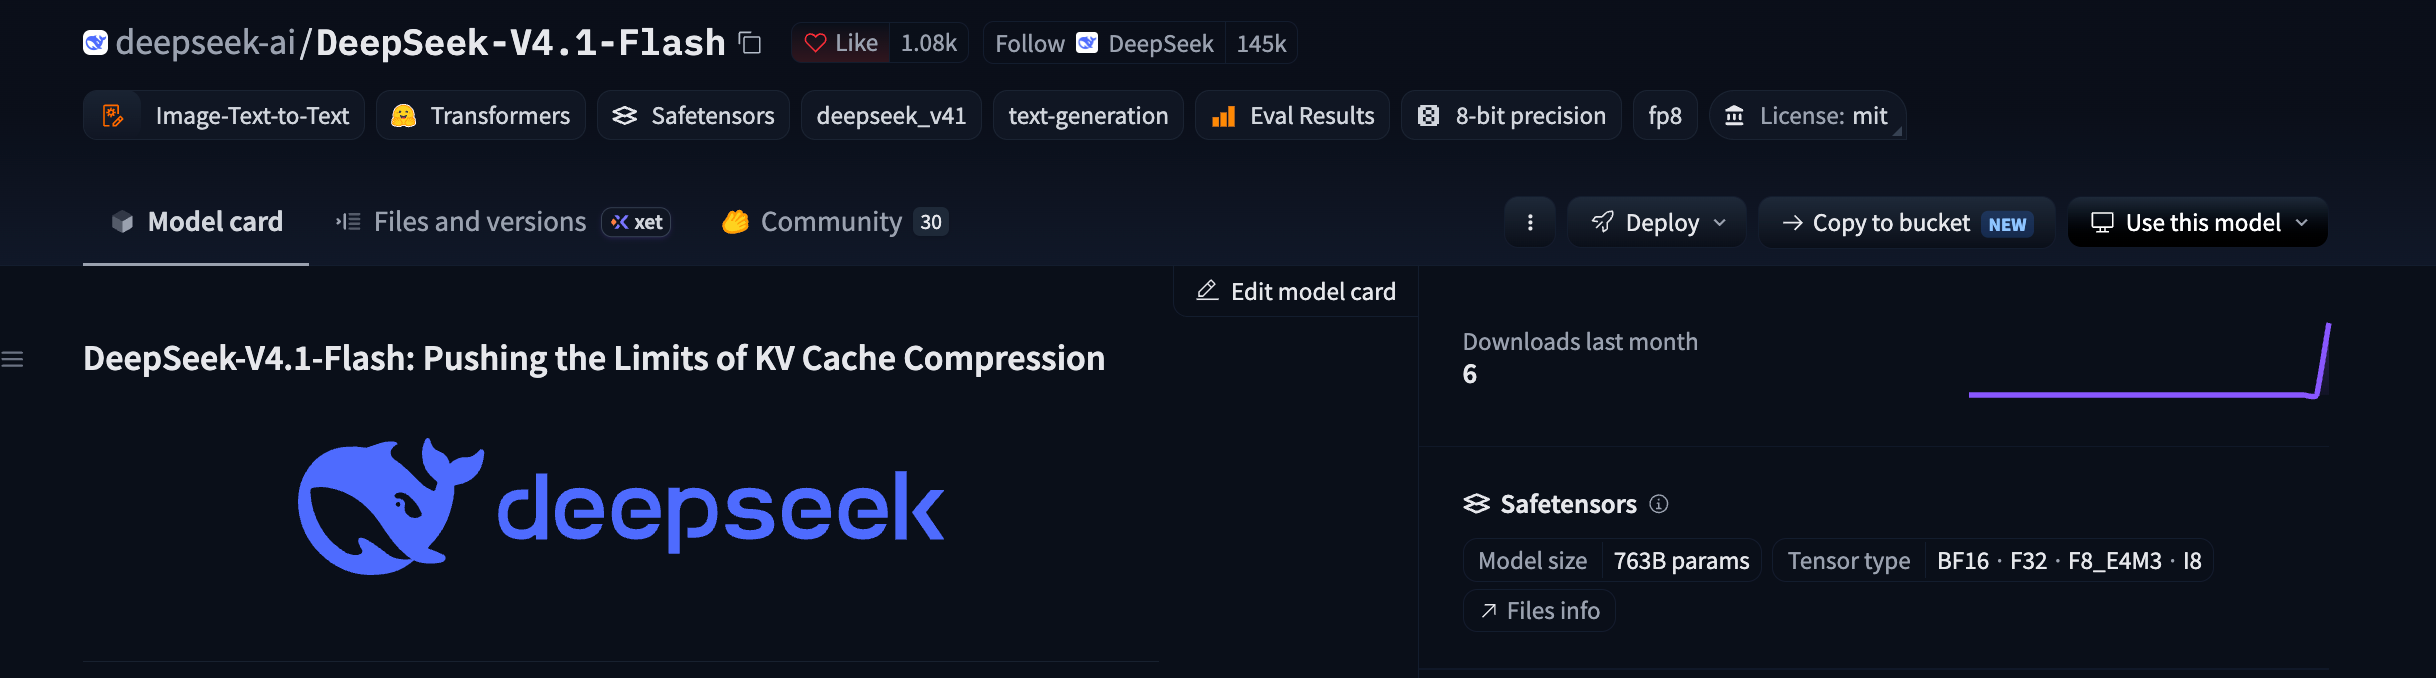
La pega es el tamaño. V4.1-Flash es una red troncal de mezcla de expertos de 552 mil millones de parámetros (763 mil millones con el codificador de visión). Solo 8 mil millones de parámetros están activos durante el prellenado y 16 mil millones durante la decodificación, pero el conjunto completo de parámetros aún debe residir en algún lugar. A 8 bits, eso es aproximadamente 552 GB solo para la red troncal; a 4 bits, unos 280 GB. Una sola GPU de consumidor no se acerca. La buena noticia es la caché KV: a 890 bytes por token con el almacenamiento en caché FP4, un contexto completo de 1 millón de tokens necesita aproximadamente 0.9 GB.
"Gratis" aquí significa de licencia gratuita, no de ejecución gratuita. Lee cómo ejecutar DeepSeek-V4.1-Flash localmente para conocer los niveles de hardware y qué motores de inferencia verificar antes de descargar 280 GB. Si ya tienes el hardware, esta es la opción gratuita más duradera en la página: sin límites de velocidad, sin política de datos, sin intercambios de modelos silenciosos.
Opción 3: la API oficial no es gratuita, pero está cerca
La plataforma DeepSeek es de pago por uso. Recargas un saldo, creas una clave y se te factura por token. No hay un nivel gratuito permanente.
Lo que le otorga un lugar en una página de "gratis" es el precio. Aquí está la tabla completa en USD de la página oficial de precios, efectiva el 10 de septiembre de 2026 a las 04:00 UTC, por cada 1 millón de tokens:
| Tipo de token | deepseek-flash fuera de pico | deepseek-flash pico |
|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 |
| Entrada, fallo de caché | $0.15 | $0.30 |
| Salida | $0.60 | $1.20 |
Las horas pico son de lunes a viernes, de 01:00 a 04:00 y de 06:00 a 10:00 UTC (09:00 a 12:00 y 14:00 a 18:00 Beijing). Todo lo demás, incluidos los fines de semana, es fuera de horas pico a mitad de precio. El almacenamiento en caché de contexto es automático, por lo que las solicitudes de sistema repetidas acceden a la caché sin código adicional.
Ahora las cuentas. Supongamos que un proyecto personal envía 5 millones de tokens de entrada nueva (fallo de caché) y genera 1 millón de tokens de salida en un mes, todo fuera de las horas pico:
- 5M de entrada con fallo de caché a $0.15 por 1M = $0.75
- 1M de salida a $0.60 por 1M = $0.60
- Total: $1.35 por mes
Si parte de esa entrada es una instrucción del sistema repetida, el costo disminuye aún más. 1 millón de tokens con acierto de caché fuera de las horas pico cuestan $0.003, por lo que una instrucción del sistema de 2,000 tokens reutilizada en 10,000 solicitudes (20 millones de tokens en caché) añade seis centavos. La factura se reduce a calderilla, y obtienes el modelo exacto que solicitaste con un límite de concurrencia de 2,500 solicitudes. El explicador de precios de V4.1-Flash cubre cómo las matemáticas cambian con la estructura de la instrucción.
Una llamada mínima, con el bloque de uso impreso para que puedas ver la división de la caché:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Opciones 4 y 5: enrutadores, niveles gratuitos y créditos incluidos
OpenRouter es el lugar habitual para buscar un punto final gratuito para un nuevo modelo de pesos abiertos. Los enrutadores agregan varios hosts detrás de una API compatible con OpenAI, y los hosts a veces ejecutan un nivel gratuito en un modelo para atraer tráfico. Si V4.1-Flash aparece allí hoy, y si algún host ofrece un nivel gratuito para él, es [VERIFICAR]; el modelo tiene horas y las listas se mueven rápido.
Tres advertencias se aplican a cada nivel gratuito de enrutador:
- Los límites de velocidad son estrictos. Los topes por minuto y por día significan que un bucle de prueba puede agotar la cuota de un día en una hora.
- Las políticas de datos difieren por host. El tráfico gratuito es a menudo lo que un host tiene permitido registrar o usar para entrenar. Lee la política antes de enviar cualquier cosa privada.
- Los niveles gratuitos cambian semanalmente. Lo que es gratis el lunes puede ser de pago el viernes, o redirigido a un host diferente. No construyas una dependencia de producción en uno.
El error a tener en cuenta es la sustitución silenciosa de modelos: solicitas V4.1-Flash y un modelo más antiguo responde porque el host gratuito falló. El campo model de la respuesta es tu primera línea de defensa, y el flujo de trabajo a continuación lo afirma.
Algunas herramientas de codificación, entre ellas Cursor y los agentes estilo Codex, incluyen créditos de prueba que puedes gastar en los backends que la herramienta soporte. Si una herramienta que ya utilizas lista DeepSeek como un modelo seleccionable, esos créditos son una ruta gratuita legítima durante la duración de la prueba. No te registres en una herramienta únicamente para acceder a DeepSeek de esta manera; los montos de crédito y los modelos elegibles cambian con demasiada frecuencia como para documentarlos.
¿Qué opción se adapta a tu situación?
| Opción | Costo | ¿Modelo garantizado? | Límites de velocidad | Mejor para |
|---|---|---|---|---|
| Aplicación de chat DeepSeek | Gratis | Depende de la compilación de la aplicación | Límites de uso de la aplicación | Evaluación manual, comprobaciones rápidas |
| Pesos abiertos (MIT) | Licencia gratuita, tu hardware | Sí, tú lo ejecutas | Ninguno | Privacidad, ajuste fino, GPUs propias |
| API oficial | Aproximadamente $1.35/mes a escala de hobby | Sí | 2,500 solicitudes concurrentes | Cualquier cosa que publiques |
| Nivel gratuito de enrutador | Gratis mientras dure | No, los hosts cambian | Límites por minuto y por día | Prototipos, comparaciones |
| Créditos de herramientas incluidos | Gratis durante la prueba | Depende de la herramienta | Definido por la herramienta | Codificación dentro de esa herramienta |
Si planeas lanzar un producto, gasta el dólar en la API oficial. Si estás evaluando, comienza con la aplicación de chat. Si tienes GPUs, los pesos superan a todas las demás opciones.
Prueba puntos finales gratuitos en Apidog sin agotar la cuota
Las rutas gratuitas tienen dos modos de fallo: alcanzas el límite de velocidad mientras depuras tu propio código, y el enrutador te entrega un modelo diferente sin avisar. Ambos son económicos de prevenir con Apidog, que prueba la capa de la API delante de cualquier punto final que elijas.
- Añade el punto final una vez. Crea
POST {{BASE_URL}}/chat/completionsconBearer {{API_KEY}}en el encabezado de autorización. Todas las opciones, excepto la aplicación de chat, utilizan la misma forma compatible con OpenAI, por lo que una solicitud guardada las cubre todas. - Crea un entorno por proveedor. Un entorno
oficialestableceBASE_URLenhttps://api.deepseek.comcon tu clave de DeepSeek; un entornorouterapunta al host gratuito. El cambio se realiza mediante un desplegable. - Registra respuestas reales y luego simúlalas. Envía un puñado de instrucciones representativas a través del punto final gratuito, guarda las respuestas y sírvelas desde el servidor simulado de Apidog. Mientras construyes el análisis, los reintentos y la interfaz de usuario, tu aplicación accede al simulador y la cuota gratuita permanece intacta.
- Afirma el campo del modelo. Guarda la solicitud como un caso de prueba afirmando que
modelen la respuesta contiene la cadena que el host devuelve para V4.1-Flash. Ejecútala al inicio de cada sesión, y un modelo intercambiado fallará la prueba antes de que pases una hora persiguiendo una "regresión" en tus instrucciones. - Afirma el bloque de uso. Verifica que
usage.prompt_tokensyusage.completion_tokenssean superiores a cero, y lee el recuento de aciertos de caché en la API oficial desde el mismo bloque. Después de una semana sabrás cuánto te ahorró un nivel gratuito y si tus instrucciones se almacenan en caché tan bien como suponías.
Descarga Apidog y el proceso tarda menos de diez minutos. Una vez que existen las aserciones, apidog-cli las ejecuta en CI para que un cambio de enrutador rompa una compilación en lugar de una demostración.
Preguntas frecuentes
¿Es DeepSeek-V4.1-Flash de uso gratuito? El modelo es de licencia gratuita bajo MIT y de uso gratuito dentro de la aplicación de chat DeepSeek. La API oficial es de pago por uso sin un nivel gratuito permanente. ¿Es DeepSeek gratis? rastrea cómo se ha mantenido esa división en toda la línea de modelos.
¿La API de DeepSeek tiene una prueba gratuita? No una permanente. La ruta de menor costo es la API oficial fuera de horas pico: 5 millones de tokens de entrada con fallo de caché más 1 millón de tokens de salida cuestan $1.35.
¿Cuál es la forma más barata de llamar a V4.1-Flash a través de la API? Envía fuera de las horas pico y estructura las instrucciones para que los prefijos compartidos acierten en la caché, ya que un acierto cuesta 50 veces menos que un fallo. Qué es el almacenamiento en caché de instrucciones explica cómo ordenar una instrucción para eso.
¿Puedo ejecutar V4.1-Flash en una laptop? No el modelo completo. 552 mil millones de parámetros son aproximadamente 280 GB a 4 bits solo para la red troncal. La guía local enlazada anteriormente cubre lo que es realista en cada nivel de hardware.
¿Una versión gratuita de enrutador es el mismo modelo que la API oficial? Solo si el host lo dice y tus pruebas lo confirman. Afirma el campo model y compara las salidas en un conjunto fijo de instrucciones con el punto final oficial. Las guías DeepSeek V4 gratis y API V4 gratis realizan la misma comprobación para la generación anterior.
Conclusiones
V4.1-Flash es gratuito de las dos formas que más importan: los pesos son MIT y la aplicación de chat no cuesta nada. Todo lo que está entre esos polos es un nivel gratuito que cambiará o una API oficial con un precio lo suficientemente bajo como para que "gratis" deje de valer la pena optimizarlo. Con $1.35 al mes, la ruta más económica suele ser pagar.
Independientemente del punto final que elijas, coloca Apidog delante: simula respuestas mientras construyes, afirma el campo del modelo, registra el uso. La cuota gratuita es un recurso. Gástala en el modelo, no en tus propios errores.