DeepSeek publicó los pesos de DeepSeek-V4.1-Flash en Hugging Face bajo una licencia MIT el 10 de septiembre de 2026, el mismo día en que el modelo se lanzó de forma general (GA) en la API. Esto es un momento inusual. La mayoría de los laboratorios envían primero el endpoint alojado y lanzan los pesos semanas después, si es que lo hacen.
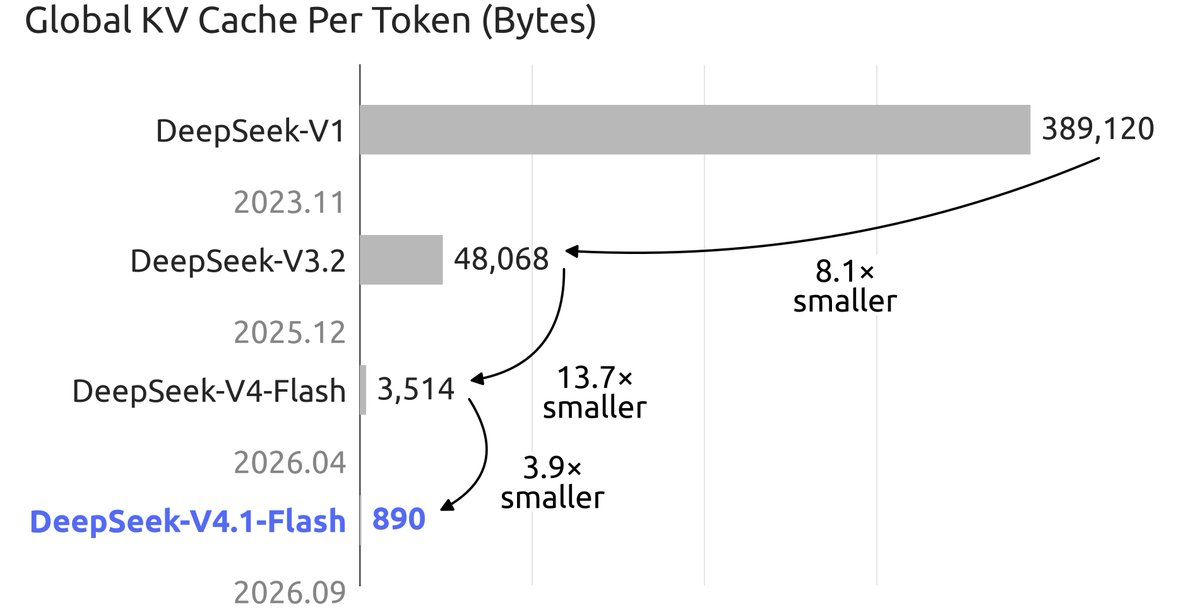
La cifra principal asustará a la mayoría de los lectores: 552 mil millones de parámetros en el núcleo, 763 mil millones con el codificador de visión. Pero el diseño subyacente es más amigable para el autoalojamiento de lo que sugiere el tamaño. Solo 8 mil millones de parámetros están activos durante el prellenado y 16 mil millones durante la decodificación, y la nueva caché KV FP4 cuesta 890 bytes por token, aproximadamente una cuarta parte de lo que necesitaba V4-Flash. El cómputo es barato. La memoria es la barrera.
La gente lo intentará de todos modos. Esta guía le proporciona las matemáticas de la memoria, las rutas realistas para cada nivel de hardware, los comandos de configuración genéricos y una forma de probar un endpoint local compatible con OpenAI contra la API alojada en Apidog. Si desea primero una descripción general del modelo, lea ¿Qué es DeepSeek-V4.1-Flash? y luego regrese.
En resumen
- Pesos: Núcleo MoE de 552B, licencia MIT. Aproximadamente 552 GB en 8 bits, aproximadamente 280 GB en 4 bits, solo el núcleo.
- Caché KV: 890 bytes por token. Un contexto completo de 1M de tokens necesita aproximadamente 0.9 GB. Esa parte está resuelta.
- El servicio realista de 4 bits necesita de 4 a 8 GPUs de la clase de 80 GB. Todo lo que esté por debajo es descarga a CPU o SSD, y lento.
- La API alojada cobra $0.15 por 1M de tokens de entrada con fallo de caché fuera de las horas pico. Para la mayoría de los equipos, eso es más barato que solo la factura de electricidad.
Qué está descargando
La ficha del modelo describe un núcleo Mixture-of-Experts de 552B parámetros con un nuevo diseño Causal Encoder-Decoder: 40 capas, divididas en 20 codificadores y 20 decodificadores. Cada capa enruta a través de 384 expertos más 1 experto compartido. El codificador de visión DeepSeek-ViT eleva el checkpoint completo a 763B parámetros, y usted descarga todo incluso si solo necesita texto.
Tres detalles importan para la inferencia local:
- Los parámetros activos son pequeños. 8B activos durante el prellenado, 16B durante la decodificación. Los FLOPs por token se parecen a los de un modelo denso de tamaño medio. El problema es que cada uno de los 552B parámetros tiene que residir en algún lugar al que pueda llegar el paso hacia adelante.
- La caché KV es FP4. La nota de lanzamiento dice que la caché utiliza 1/4 de la HBM y 1/8 del almacenamiento SSD de la generación anterior. Con 890 bytes por token, el contexto largo ya no es el problema de memoria que solía ser.
- La atención es dispersa por diseño. La Atención Dispersa Comprimida 2 con tres modos estáticos fue entrenada con un contexto de 64K y extendida a 1M al final de la ejecución de 45T tokens. Por eso, los números de KV se mantienen pequeños en 1M.
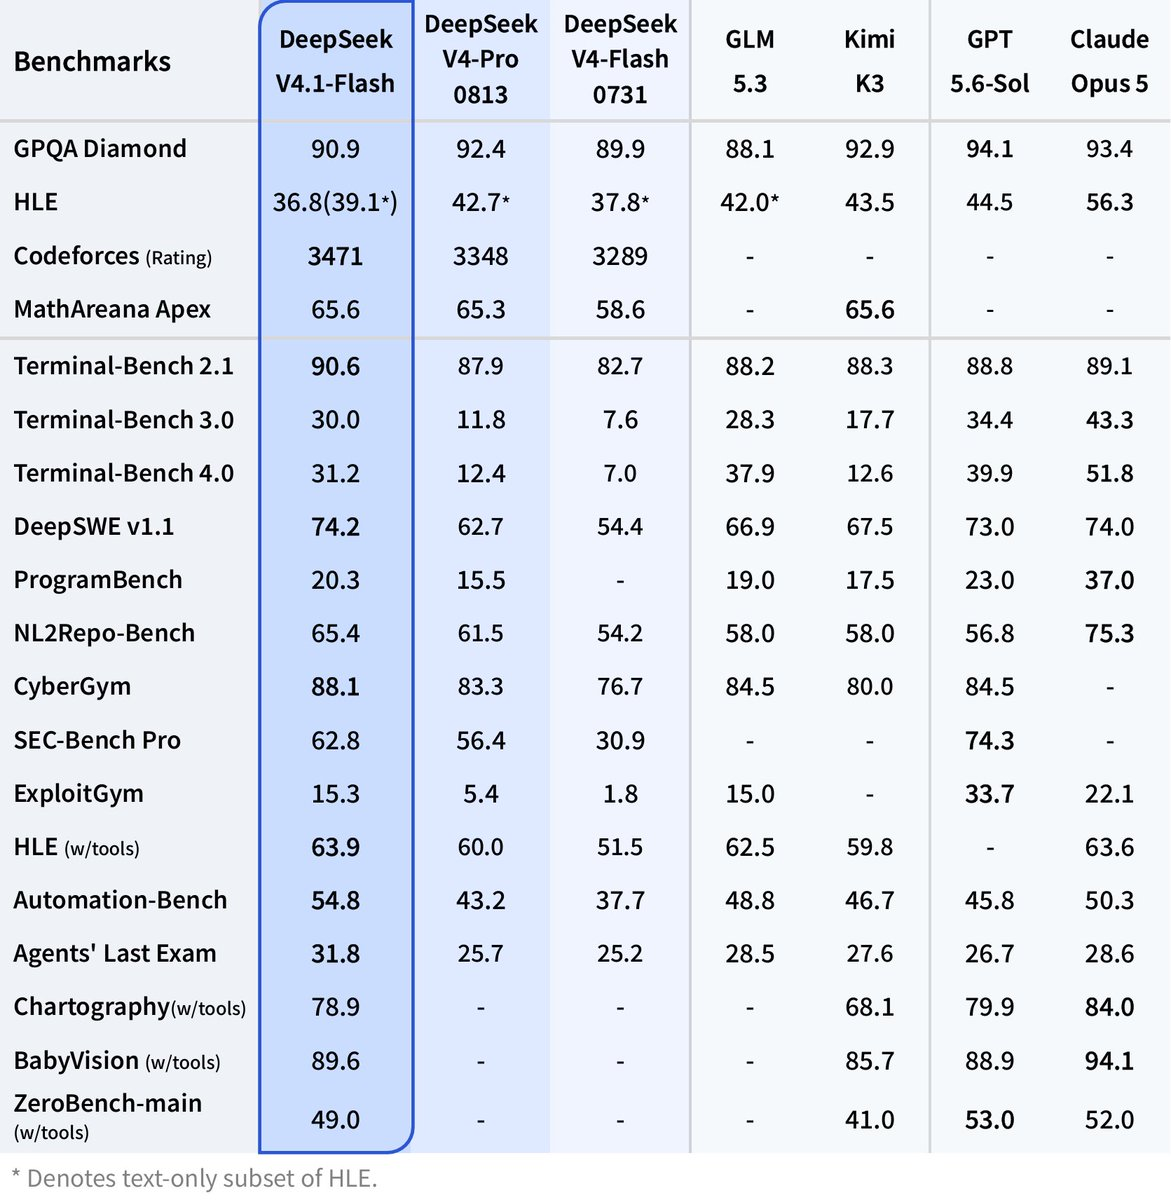
El informe técnico cubre la arquitectura en su totalidad. Cada cifra de benchmark en la ficha es reportada por DeepSeek; trátelas como afirmaciones.
Las matemáticas de la memoria
Los números a continuación son multiplicaciones directas, no mediciones, y excluyen la sobrecarga del motor, las activaciones y el codificador de visión.
| Componente | Tamaño | Cómo se calcula |
|---|---|---|
| Pesos del núcleo, 8 bits | ~552 GB | 552B parámetros x 1 byte |
| Pesos del núcleo, 4 bits | ~280 GB | 552B parámetros x 0.5 byte |
| Caché KV, por token | 890 bytes | De la ficha del modelo |
| Caché KV con contexto de 128K | ~0.11 GB | 890 x 128,000 |
| Caché KV con contexto de 1M | ~0.89 GB | 890 x 1,000,000 |
Dos cosas llaman la atención. Primero, la caché KV es un error de redondeo. Una sesión de 1M de tokens cabe en menos de un gigabyte, por lo que puede mantener docenas de sesiones largas residentes sin afectar el presupuesto de pesos. Segundo, los pesos son todo el problema. Ningún truco de cuantificación hace que 552B parámetros quepan en una sola GPU de consumidor, y el diseño de 8B activos no ayuda, porque el enrutamiento MoE aún necesita que cada experto esté cargado y direccionable.
Por eso también las configuraciones descargadas se sienten desequilibradas. El prellenado procesa lotes de todo el prompt y se mantiene limitado por el cómputo. La decodificación carga 16B parámetros activos desde la RAM o SSD para cada token. El ancho de banda, no los FLOPs, establece sus tokens por segundo.
Niveles de hardware realistas
Aquí no hay cifras de rendimiento. Nadie fuera de DeepSeek ha tenido los pesos el tiempo suficiente para publicar benchmarks fiables.
Nivel 1: servidor multi-GPU, de 4 a 8 tarjetas de la clase de 80 GB. Cuatro tarjetas de 80 GB le dan 320 GB, suficiente para pesos de 4 bits con un pequeño margen para la caché KV y la sobrecarga del motor. Ocho tarjetas le dan 640 GB, suficiente para el checkpoint de 8 bits o un despliegue cómodo de 4 bits con grandes lotes. Este es el único nivel donde "ejecutarlo localmente" significa un servicio de grado de producción con paralelismo de tensor, y es una compra de cinco o seis cifras o un alquiler en la nube de varios dólares por hora.
Nivel 2: estación de trabajo única de alta memoria con descarga a CPU. Una caja con 512 GB o más de RAM del sistema y una o dos GPUs puede mantener los pesos de 4 bits en la RAM y transmitir capas expertas a la GPU bajo demanda. Funciona, y es lento, porque el ancho de banda de decodificación es su bus DDR5 en lugar de HBM. Úselo para trabajos por lotes y evaluaciones nocturnas, no para chat interactivo.
Nivel 3: Apple Silicon con streaming SSD. El camino del aficionado. Un Mac Studio de 512 GB puede mantener los pesos de 4 bits en memoria unificada, lo cual es una opción real si ya posee uno. Por debajo de eso, está en el territorio del hilo Kimi K3 HN: pesos divididos entre SSDs externos, mmap haciendo el trabajo pesado, aproximadamente 1 token por segundo. Esto demuestra que el modelo funciona, no que sea útil en esa máquina. Nuestra guía para ejecutar Kimi K3 localmente cubre las mismas compensaciones en un modelo más grande, y cómo ejecutar DeepSeek V4 localmente cubre la generación anterior.
La ruta de configuración
Con el hardware en su lugar, el flujo es: descargar, servir detrás de un endpoint compatible con OpenAI, probar.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
En una línea de 1 Gbps, cada 100 GB tardan aproximadamente 15 minutos a máxima velocidad. Calcule una hora o más.
El servicio es donde reside la advertencia. El soporte desde el día 0 en vLLM, SGLang, llama.cpp y Ollama para la arquitectura CED y la atención CSA2 es [VERIFICAR]; un nuevo tipo de capa generalmente necesita un parche en el motor antes de que se carguen los pesos, y la nota de lanzamiento no menciona motores específicos. Busque en el registro de cambios de cada proyecto "DeepSeek-V4.1" antes de comprometerse con una descarga. Una vez que exista el soporte, el servicio con vLLM en 8 GPUs se verá así:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Un llama-server de llama.cpp o un modelo de Ollama expone el mismo endpoint estilo http://localhost:8000/v1 una vez que existe una conversión GGUF, por lo que cualquier cliente del SDK de OpenAI funciona cambiando una línea:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
Los valores temperature=1.0 y top_p=0.95 coinciden con la configuración recomendada en la ficha del modelo. Para Ollama, nuestra guía de Ollama cubre el flujo de Modelfile, y la guía de vLLM cubre en profundidad las banderas multi-GPU.
La alternativa pragmática: la API alojada
Fuera de las horas pico, la página de precios lista deepseek-flash a $0.15 por 1M de tokens de entrada con fallo de caché, $0.003 por 1M de tokens de entrada con acierto de caché, y $0.60 por 1M de tokens de salida. Las horas pico duplican esos precios. Así, 1 mil millones de tokens de entrada más 200 millones de tokens de salida al mes cuestan aproximadamente $270 fuera de las horas pico y $540 en horas pico, antes de que los aciertos de caché reduzcan aún más el lado de entrada. Un servidor con 8 GPUs de la clase de 80 GB cuesta más que eso al mes solo en electricidad y refrigeración bajo carga sostenida, antes de amortizar el hardware o pagar a alguien para que lo supervise. A menos que tenga una regla de residencia de datos o hardware ya inactivo, la API gana en costo. El cambio es una modificación de base_url; nuestra guía de la API de DeepSeek-V4.1-Flash lo explica.
La opción local gana cuando la restricción no es el dinero: entornos aislados, datos de prompt que no puede enviar a ningún lugar, o investigación que necesita modificar los pesos.
Pruebe un endpoint local contra la API alojada en Apidog
Cualquiera que sea el camino que elija, demuestre que el servidor local se comporta como la referencia antes de dirigirle tráfico. La deriva de cuantificación, una plantilla de chat incorrecta o un token de parada faltante se manifiestan como sutiles diferencias en la salida. Aquí está el flujo de trabajo en Apidog:
- Cree dos entornos. Uno llamado
localconbase_urlconfigurado enhttp://localhost:8000/v1, y otro llamadohostedconbase_urlconfigurado enhttps://api.deepseek.comy su clave real. Cada solicitud utiliza{{base_url}}/chat/completionsyBearer {{api_key}}. - Guarde un pequeño conjunto de prompts como solicitudes. De cinco a diez prompts que representen su carga de trabajo: una extracción JSON, una corrección de código, un resumen de contexto largo. Configure
modelendeepseek-flashen todos ellos; funciona en ambos servidores. - Agregue aserciones. Para la tarea JSON, afirme que la respuesta se analiza y que existe una clave requerida. Para cada solicitud, afirme que
finish_reasones igual astop, lo que detecta la truncación por una configuración de contexto incorrecta. - Ejecute el conjunto contra ambos entornos. Cambie el desplegable de entorno de
hostedalocaly vuelva a ejecutar el mismo escenario de prueba. Un fallo que aparece solo enlocales su problema de cuantificación o plantilla, aislado con un clic. - Observe el streaming. Configure
stream: truey use la vista SSE para ver los eventos llegar uno por uno. Un servidor local que almacena en búfer toda la respuesta antes de enviarla se ve bien en una llamada no streaming y mal aquí. - Intégrelo en CI. Ejecute el escenario con
apidog-clien cada actualización del motor, para que una plantilla de chat rota falle en una pipeline en lugar de afectar a un usuario.
Descargue Apidog y todo el flujo se ejecutará desde un solo proyecto.
Preguntas frecuentes
¿Puedo ejecutar DeepSeek-V4.1-Flash en un portátil? No de forma útil. El núcleo de 4 bits tiene aproximadamente 280 GB. Un portátil puede transmitirlo desde un SSD como lo hizo el experimento Kimi K3, a aproximadamente 1 token por segundo, lo cual es una demostración, no un flujo de trabajo. Use la API o una de las opciones en cómo usar DeepSeek-V4.1-Flash gratis.
¿8B parámetros activos significa que solo necesito 8 GB de VRAM? No. Los parámetros activos establecen el cómputo por token, no la memoria. El enrutamiento MoE puede elegir cualquiera de los 384 expertos por capa para cualquier token, por lo que los 552B parámetros deben estar cargados y accesibles.
¿Cuánta memoria necesita el contexto de 1M? Aproximadamente 0.89 GB de caché KV a 890 bytes por token. Esa es la parte barata de este modelo. Los pesos son la parte cara.
¿La licencia es segura para uso comercial? Sí. Los pesos son MIT, según la ficha del modelo de Hugging Face.
Conclusiones
DeepSeek-V4.1-Flash es abierto en el sentido que importa legal y técnicamente: pesos MIT, un informe técnico público y un diseño de caché KV que hace que las sesiones de 1M de tokens sean casi gratuitas en memoria. No es abierto en el sentido que le permita ejecutarlo en la máquina debajo de su escritorio. Para la mayoría de los equipos, la decisión correcta es la API alojada a $0.15 por 1M de tokens de entrada fuera de las horas pico, con el despliegue local reservado para datos que no pueden salir del edificio.
De cualquier manera, pruebe antes de confiar. Apunte Apidog a ambos endpoints, ejecute las mismas solicitudes guardadas y deje que las aserciones le digan si su compilación local coincide con la referencia.