
Para hacer ingeniería inversa de cualquier cosa con Opus 5.5, conecta el modelo a un motor de desensamblado a través de REA y luego trabaja por etapas: enruta el objetivo, mapéalo, descompila las funciones con más uso, haz que Opus las nombre y las explique, escribe una especificación solo de comportamiento y reconstruye a partir de esa especificación en un contexto aparte. Ajusta el nivel de esfuerzo a cada etapa y demuestra la reconstrucción con pruebas de paridad.
Esa es la versión corta de una guía que se volvió viral en X. El 12 de octubre de 2026, el desarrollador Movez publicó un curso de 11 pasos sobre ingeniería inversa con Claude Opus 5.5. Superó el millón de visualizaciones y los 2.800 marcadores. Este artículo contrasta sus afirmaciones con las fuentes, corrige dos detalles sobre benchmarks y añade el paso que la mayoría de las guías omite: probar la API con la que habla el objetivo.
Usa esto solo con software que sea tuyo o que estés autorizado a examinar. El README de REA limita la herramienta a "investigación lícita, educación, interoperabilidad, preservación de software y análisis de software que posees o estás autorizado a examinar".
Por qué Opus 5.5 necesita una herramienta para leer un binario
Opus 5.5 lee y escribe texto; no puede cargar por sí mismo un archivo Mach-O o ELF. REA es un servidor MCP que se sitúa entre tu agente y un motor de análisis (Hopper, Ghidra o IDA para código nativo), ejecuta el análisis localmente y devuelve los hallazgos junto con su evidencia: direcciones, pseudocódigo, cadenas y puntos de llamada. El modelo lee esos hallazgos y formula la siguiente pregunta.
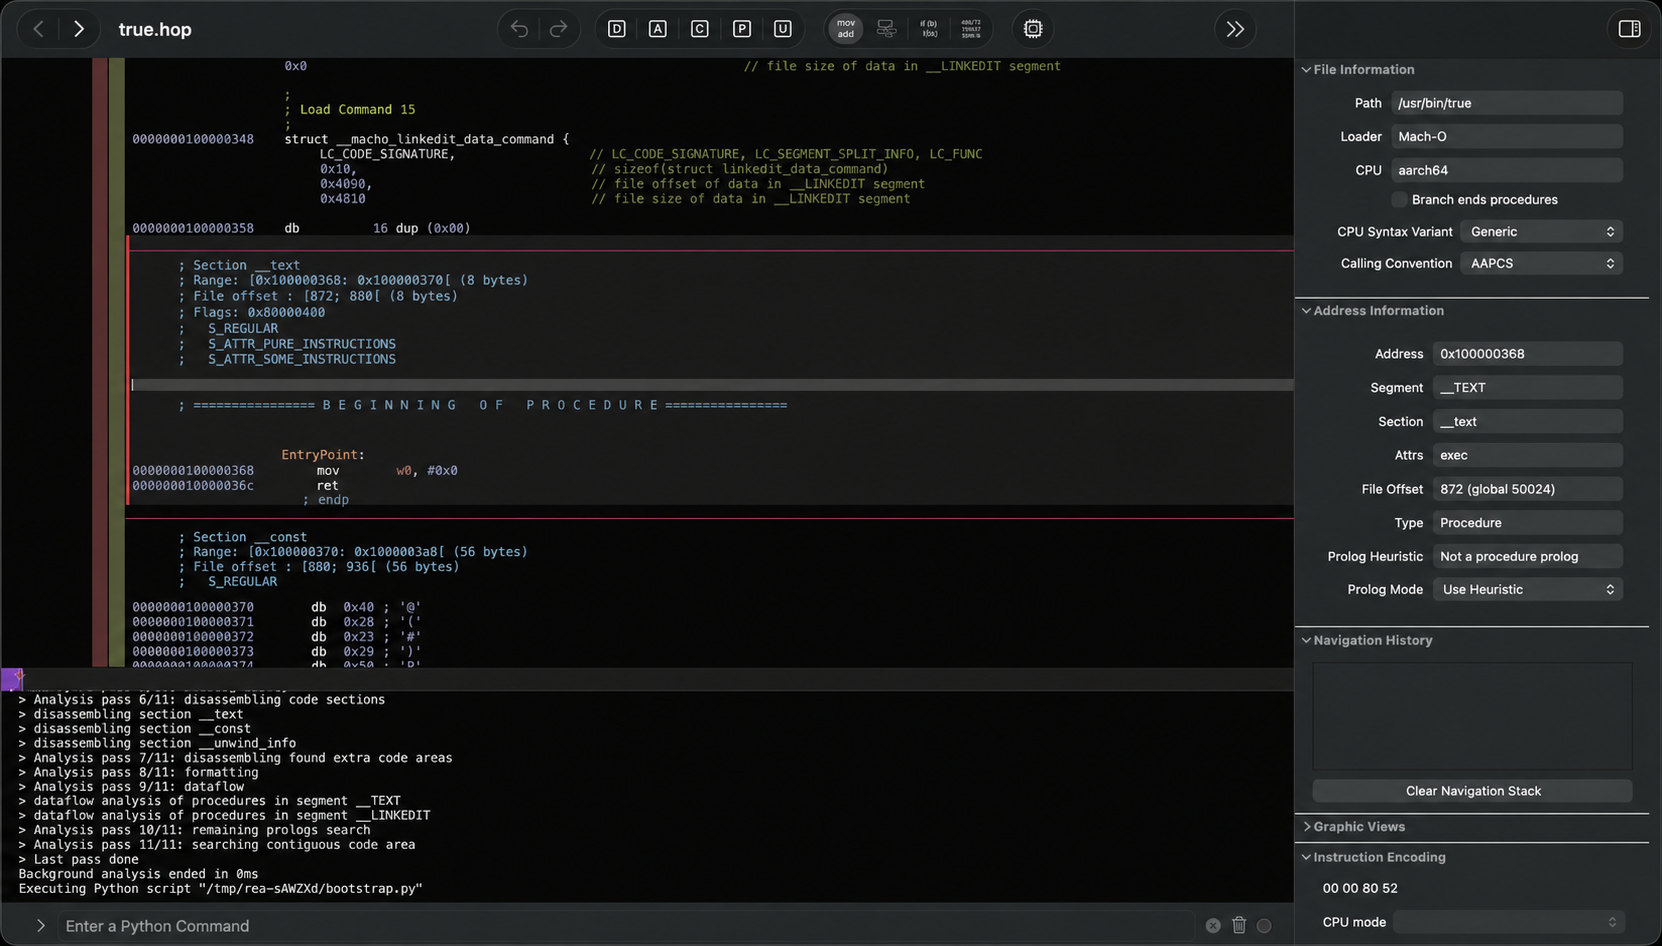
REA superó las 393.000 estrellas en GitHub el 27 de octubre de 2026, frente a unas 115.000 el 12 de octubre. Cubrimos qué es REA y cómo funciona y un bucle de seis pasos para reconstruir una función de una app cuando se hizo tendencia por primera vez. Esta guía se centra en el lado del modelo: los prompts, la configuración de esfuerzo y los límites.
Paso 1: Instala REA y escribe las reglas de la casa
REA necesita Node.js 22.23.4 o posterior en la línea 22 (24.22.1+ o 26.12.1+ también funcionan) además de npm. La versión actual en npm es la 6.8.0. Regístralo con tu agente:
npx rea-agents setup
npm install --global rea-agents
rea --help
La configuración muestra una vista previa de sus cambios de config, hace copia de seguridad de lo que toca y es compatible con Claude Code, Codex, Cursor, Gemini CLI y Grok Build. El análisis nativo necesita Hopper, Ghidra o IDA; la inspección de JavaScript, Electron y .NET no necesita ningún motor.
Después, dale al agente las reglas de la casa. El bloque de CLAUDE.md del curso es la mejor parte del hilo:
# Reverse-engineering house rules
- Only analyze targets I own or am authorized to examine. State the basis once.
- Tag every claim: observation, inference, or unknown.
- Cite the evidence: address, bytes, pseudocode or call site.
- Start with the smallest overview. Expand only on a concrete gap.
- Separate static facts from runtime facts.
- Build from behavior and public specs, never from copied code or assets.
- Every recovered behavior needs a passing test before "done".
Paso 2: Elige un nivel de esfuerzo para cada etapa
Opus 5.5 admite cinco niveles de esfuerzo: low, medium, high, xhigh y max. Según la documentación de esfuerzo de Anthropic, Opus 5.5 usa medium por defecto, mientras que xhigh está pensado para ejecuciones agénticas largas y max elimina todos los límites de gasto de tokens. Lo estableces con output_config.effort en la API, o con el ajuste de esfuerzo de tu agente.
El reparto que propone el curso es un punto de partida razonable, no una regla medida:
| Etapa | Esfuerzo sugerido | Por qué |
|---|---|---|
| Enrutado, reconocimiento, navegación | medium |
Sobre todo llamadas a herramientas y listados |
| Anotar funciones corrientes | high |
Nombrar exige razonar sobre el flujo de datos |
| Sesiones largas con varias funciones | xhigh |
Diseñado para ejecuciones de más de 30 minutos |
| Código ofuscado o con muchos punteros | max |
El razonamiento más profundo, el coste más alto |
Sube el esfuerzo por función, no por sesión.
Paso 3: Enruta el objetivo antes de abrir nada
El error más común de los principiantes es abrir un desensamblador sobre una app Electron cuyo JavaScript está a la vista. REA cubre instalaciones de escritorio, binarios nativos, apps JavaScript y Electron, ensamblados .NET, APK de Android, WASM, sitios web y capturas de red guardadas, cada uno con su propia herramienta de entrada. Tu primer prompt solo debería identificar el objetivo:
I want to understand how [FEATURE] works in [APP] at [ABSOLUTE PATH].
First tell me what kind of target this is (native, Electron/JS, .NET, APK, WASM)
and which REA tool opens it. Don't start deep analysis yet.
Then give me a one-paragraph map and where you'd look first for [FEATURE].
Keep observations, inferences and unknowns separate.
Un objetivo Electron va a analyze-javascript-application (módulos, imports, límites de IPC, sin motor). Un objetivo nativo va a open_binary.
Paso 4: Mapea las cadenas y clasifica las funciones por referencias cruzadas
Todavía no leas código. Para un objetivo nativo, empieza con un inventario:
rea inspect /absolute/path/to/program --provider ghidra --json
rea search /absolute/path/to/program entry --kind procedures --provider ghidra --json
Las cadenas son tu pista más rápida: URL, mensajes de error y nombres de funciones. Una URL base o una cadena Authorization: Bearer también te dicen que el binario habla con una API, algo que importa en el Paso 9.
Después, clasifica las funciones por referencias cruzadas (cuántos sitios las llaman). Una función con 147 llamadores probablemente sea infraestructura central, como un cargador de configuración; una con dos llamadores puede esperar. Lee de arriba abajo.
Paso 5: Descompila una función y deja que Opus la nombre
Descompila una sola función crítica:
rea function /absolute/path/to/program parseConfig --provider ghidra --json
rea decompile /absolute/path/to/program --procedure=parseConfig --provider ghidra --json
La salida es tosca (var_28, conversiones de tipo por todas partes). Pásasela a Opus 5.5 con esfuerzo high y una lista de comprobación fija:
Here is decompiled pseudocode for a function with 147 cross-references.
1. Rename every variable based on how it is used.
2. State the function's purpose in one sentence.
3. List the data structures it reads and writes.
4. Name the pattern (singleton, factory, state machine, observer).
5. Flag missing error handling, validation or security checks.
Mark anything you're unsure of instead of guessing.
Los descompiladores se equivocan en los detalles. En el caso práctico de DX-Ball de REA, el primer pseudocódigo mostraba una función de paneo de sonido que no recibía ninguna entrada. Solo la vista de instrucciones reveló el parámetro. La reconstrucción final en C pasa 3.205 casos de prueba x86 originales y reproduce los 63 bytes de las funciones compiladas, porque el agente contrastó el pseudocódigo con el ensamblado y los llamadores. Pide rea instructions cuando una firma parezca rara.
Paso 6: Presupuesta el código ofuscado, no lo muelas
Aquí es donde el curso viral necesita correcciones. Cita el benchmark de ofuscación de Elastic Security Labs como una prueba de "Claude Opus". El estudio de Elastic, publicado el 21 de abril de 2026, probó Claude Opus 4.6, no Opus 5.5. Los números:
| Fase de Tigress | Resueltos |
|---|---|
| Sin transformaciones | 1 de 1 |
| Transformaciones simples | 4 de 6 |
| Transformaciones emparejadas | 3 de 6 |
| Pesada, multicapa | 0 de 6 |
En total, Opus 4.6 resolvió 8 de 20 objetivos evaluables (40%). Los éxitos costaron una media de 2,39 $ y los fallos, 4,83 $, así que un fallo cuesta aproximadamente el doble que un éxito. Toma estos datos como un suelo, no como una medición de Opus 5.5; no encontramos ningún equivalente publicado para 5.5.
En segundo lugar, el curso dice que una herramienta llamada Caveman "elimina cerca del 75 %" de la basura descompilada. Elastic describe Caveman como un plugin que recorta hasta un 75 % la verbosidad del propio modelo, no como un filtro de código descompilado.
La lección se mantiene: limita el gasto por función ofuscada, pide una puntuación de confianza del 1 al 10 y deja aparcado todo lo que baje de 6 hasta que se resuelvan sus vecinos.
Paso 7: Divide los objetivos grandes en un controlador y trabajadores
Un solo chat no puede sostener 500 funciones; olvida nombres y se contradice. La solución del curso es un controlador que nunca analiza código y unos trabajadores que se encargan cada uno de una función:
Controller: The function map is in functions.json (address, name, size, xrefs).
Cluster functions by call-graph proximity, order clusters by xref count,
send each cluster to a worker, inject already-resolved struct names into every
brief, and queue a second pass for any result with confidence below 6.
Report token spend after each cluster.
Cada trabajador devuelve la dirección, el propósito, una puntuación de confianza del 1 al 10, las estructuras que usó o encontró y el código limpio, reutilizando los nombres de estructuras del controlador. El benchmark de Elastic usó la misma forma de controlador y trabajadores.
Paso 8: Escribe una especificación solo de comportamiento en un contexto limpio
Una reconstrucción de sala limpia copia lo que hace el software, nunca su código. Pídele a Opus una especificación solo de comportamiento: interfaces públicas, el modelo de datos, cada función como un requisito comprobable, formatos de archivo basados en estándares públicos y gestión de errores. Prohíbe direcciones, nombres descompilados y cualquier cosa copiada.
Después implementa a partir de esa especificación en un contexto distinto que nunca vea el análisis. Esa separación es la frontera de la sala limpia. Esto es práctica de ingeniería, no asesoramiento legal.
Paso 9: Recupera el contrato de la API y pruébalo con Apidog CLI
Las cadenas del Paso 4 a menudo revelan una URL base y una cabecera de autenticación, así que parte del comportamiento vive detrás de una API. Tu reconstrucción solo coincidirá si también respeta ese contrato, y el tráfico lo muestra más rápido que el ensamblado.
Graba un HAR en una cuenta de prueba que sea tuya y deja que REA lo resuma:
rea inspect-web-network-capture /absolute/session.har har --json
Luego deja que tu agente convierta esa captura en un contrato probado con Apidog CLI. Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Dale al agente un solo prompt:
Import session.har into Apidog project <id>. List the endpoints it created,
remove anything that isn't part of [FEATURE], and write one test case per
endpoint that asserts status code, required fields and response schema.
Run them against the original-service environment, then against my rebuild's
environment, and report every endpoint where the two disagree.
El agente ejecuta la importación, comprueba las formas de los payloads antes de escribir y ejecuta ambos entornos:
apidog import --project <id> --format har --file ./session.har
apidog endpoint list --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog test-case run --project <id> --endpoint <endpointId> -e <originalEnvId> -r cli,json
apidog test-case run --project <id> --endpoint <endpointId> -e <rebuildEnvId> -r cli,json
Los mismos casos, dos entornos, un diff, reejecutable en cada commit con -r junit (consulta nuestra guía de Apidog CLI para CI/CD). Si prefieres manejarlo desde Claude Code, consulta Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios. Para el enfoque manual, consulta ingeniería inversa de API.
Paso 10: Demuestra la paridad antes de publicar
"Creo que coincide" no es una prueba. Para el comportamiento local, pídele a Opus que construya un arnés que alimente con las mismas entradas al original y a la reconstrucción:
Generate 50 inputs: 30 normal, 10 edge (empty, max size, unicode), 10 error
(malformed, missing fields, corrupt). Run each through both programs. Compare
byte-for-byte where possible, semantically otherwise. Report the match rate and
every divergence as cosmetic, behavioral or critical.
Con la ejecución de API del Paso 9, obtienes dos cifras para mostrar a cualquiera: una tasa de coincidencia local y una tasa de coincidencia de API. Prueba mientras construyes, no al final.
Preguntas frecuentes
¿Es legal la ingeniería inversa con Opus 5.5? Depende de tu jurisdicción, la licencia y tu propósito. REA apoya la investigación lícita, la educación, la interoperabilidad, la preservación y el análisis de software que posees o estás autorizado a examinar. Busca asesoramiento legal antes de publicar comercialmente una reconstrucción.
¿Qué nivel de esfuerzo debería usar para ingeniería inversa? Empieza con medium para el enrutado y el reconocimiento, high para anotar funciones y reserva max para código ofuscado con un presupuesto por función. Opus 5.5 usa medium por defecto.
¿Qué tal se le da a Claude manejar binarios ofuscados? El único benchmark público, de Elastic Security Labs, probó Opus 4.6: resolvió el 40 % de 20 objetivos Tigress y el 0 % de los pesados multicapa. No se ha publicado ninguna prueba equivalente de Opus 5.5.
¿Cómo pruebo la API que usa una app sometida a ingeniería inversa? Captura un HAR en una cuenta de prueba, impórtalo con apidog import --format har, crea casos de prueba con Apidog CLI y ejecútalos tanto contra el servicio original como contra tu reconstrucción.
¿REA sube mi binario? REA ejecuta el análisis localmente. Solo los hallazgos que tu agente pasa al modelo (cadenas, pseudocódigo) llegan a tu proveedor de modelos.