
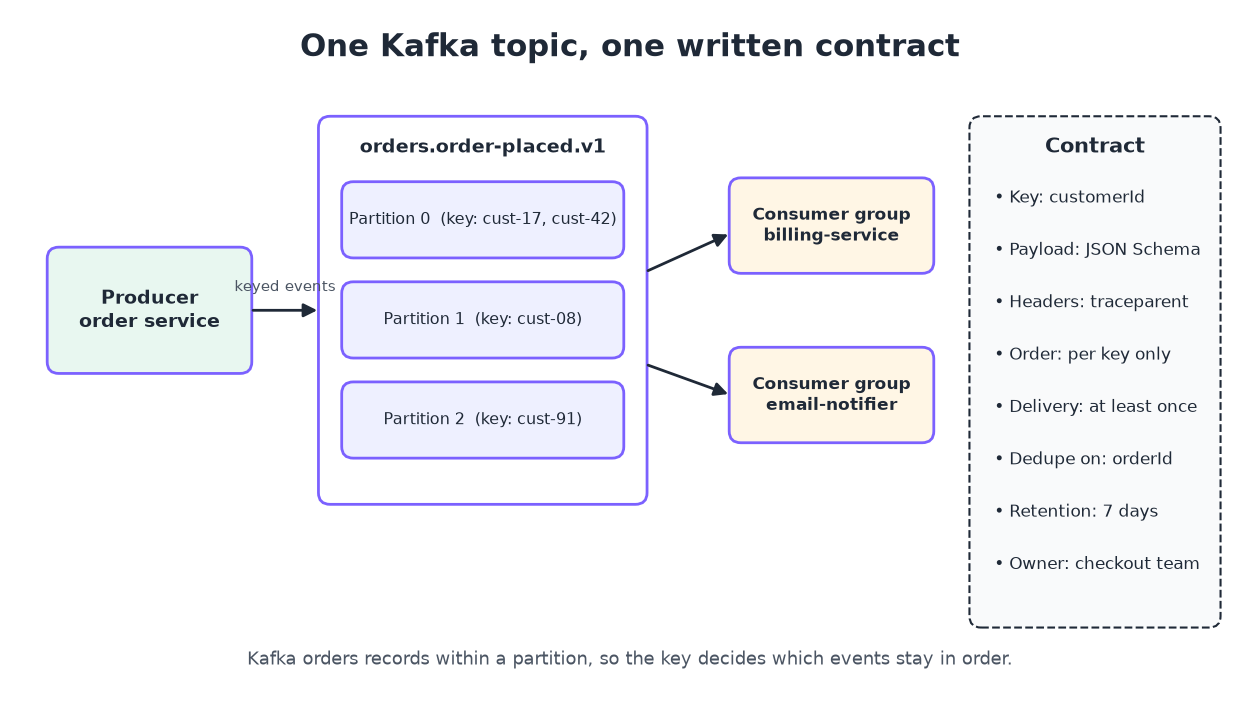
Para documentar APIs de Kafka, escribe un contrato para cada topic. Debe incluir el nombre del topic, la clave del evento, el esquema del payload, los headers, las garantías de orden y entrega, los consumer groups, el periodo de retención y el responsable. Después guarda ese contrato junto a la documentación de tus APIs HTTP, para que productores y consumidores lean una única fuente de verdad en lugar de hacer ingeniería inversa de los mensajes en un clúster en producción.
Esta guía cubre cada parte de ese contrato, cómo escribirlo en AsyncAPI, cómo evolucionar los esquemas de forma segura, y cómo dejar que tu agente de código haga el trabajo con el Apidog CLI.
Si eres nuevo en el diseño dirigido por eventos, empieza con cómo construir APIs dirigidas por eventos y la guía de webhooks y arquitectura dirigida por eventos.
¿Qué es una API de Kafka?
Una API de Kafka es el conjunto de topics, formatos de mensaje y reglas de entrega que los servicios usan para intercambiar eventos a través de un clúster de Apache Kafka. A diferencia de una API REST, nadie llama a un endpoint y espera una respuesta. Los productores escriben registros en los topics, los consumidores los leen según su propio ritmo, y el contrato vive en la forma y el significado de esos registros.
La documentación de Kafka lo dice claramente: “un evento tiene una clave, un valor, una marca de tiempo y headers de metadatos opcionales”. Kafka en sí no comprueba qué hay dentro del valor. Un productor puede escribir JSON un día y una forma de JSON diferente al día siguiente, y el broker aceptará ambos. Por eso las APIs de Kafka necesitan contratos escritos más que las APIs HTTP: nada en la capa de transporte impide un cambio disruptivo.
Los topics sin documentar fallan de formas predecibles: un consumir adivina el tipo de un campo a partir de una muestra y falla con null, o un servicio nuevo no sabe que recibe cada mensaje al menos una vez y cobra dos veces en los reintentos.
Qué documentar para cada topic de Kafka
Cada topic necesita los mismos datos básicos. Usa esta tabla como tu checklist:
| Campo del contrato | Qué anotar | Ejemplo |
|---|---|---|
| Nombre del topic | Nombre completo y convención de nombres | orders.order-placed.v1 |
| Propósito | Una frase sobre lo que significa el evento | “Un pedido pasó el pago y está listo para enviarse” |
| Clave del evento | Qué campo es la clave y por qué | customerId, para que los pedidos de un cliente mantengan su orden |
| Esquema del payload | Cada campo, tipo, obligatoriedad y formato | JSON Schema, Avro o Protobuf |
| Headers | Nombre, tipo y significado de cada header | traceparent, schema-version |
| Particiones y orden | Número de particiones y garantía de orden | 12 particiones, ordenado por customerId |
| Semántica de entrega | At least once, productor idempotente, transacciones | At least once; los consumidores deben deduplicar por orderId |
| Consumer groups | Grupos conocidos y qué hace cada uno | billing-service, email-notifier |
| Retención | Cuánto tiempo siguen siendo legibles los registros | 7 días |
| Propiedad | Equipo responsable, contacto y política de versiones | Equipo de checkout, #checkout-events |
Las filas de orden y entrega son las más importantes: los lectores no pueden deducirlas a partir de un mensaje de ejemplo.
Cómo documentar APIs de Kafka en 6 pasos
- Enumera todos los topics y sus responsables. Extrae la lista de topics de tu clúster y anota quién produce en cada uno.
- Define la clave. Anota qué campo es la clave y qué implica para el orden.
- Escribe el esquema del payload. Describe cada campo con JSON Schema, Avro o Protobuf.
- Describe los headers y los metadatos. Incluye los headers de trazabilidad, versión de esquema y tipo de contenido.
- Declara las garantías. Documenta la semántica de entrega, el alcance del orden, la retención y los consumer groups.
- Publícalo donde la gente lo busque. Coloca el contrato junto a la documentación de tus APIs HTTP y versiona como si fuera código.
Pasos 1 y 2: topics y claves
Un patrón de nombres como <dominio>.<evento>.<versión> le dice a los lectores quién es el responsable del topic y qué versión están leyendo. Después documenta la clave, porque decide la partición. La documentación de Kafka indica que “los eventos con la misma clave de evento (por ejemplo, un ID de cliente o de vehículo) se escriben en la misma partición”, y que los consumidores leen los eventos de una partición “en exactamente el mismo orden en que fueron escritos”.
Así que tu contrato debe decir “ordenado por customerId”, no “ordenado”. Kafka solo garantiza el orden dentro de una partición, nunca en todo un topic.
Paso 3: el esquema del payload
El payload es la parte con la que los consumidores programan, así que descríbelo campo por campo. Aquí tienes un JSON Schema para un evento order-placed:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
La descripción “úsalo para deduplicar” le dice al consumidor qué hacer con el campo, no solo su tipo. ¿Nuevo en el formato? Lee qué es JSON Schema.
Pasos 4 y 5: headers y garantías
Enumera cada header (contexto de trazabilidad, versión de esquema, tipo de contenido) e indica si los consumidores pueden confiar en él. Después anota la garantía de entrega, en los términos propios de Kafka. La documentación de diseño de Kafka establece que “Kafka garantiza por defecto una entrega at-least-once”, lo que significa que los mensajes “nunca se pierden, pero pueden entregarse más de una vez”. Si tu productor usa la opción idempotente o transacciones, dilo. Si no, indica a los consumidores que dedupliquen, y nombra el campo por el que deben deduplicar.
Documenta también los consumer groups. Dentro de cada grupo suscrito, una partición “es consumida exactamente por un consumidor” a la vez. Eso le dice a los lectores hasta dónde puede escalar un grupo: un consumidor activo por partición.
Escribe el contrato en AsyncAPI
Las herramientas necesitan un formato legible por máquina, y para Kafka suele ser AsyncAPI, una especificación “usada para describir APIs basadas en mensajes en un formato legible por máquina”. Desempeña el papel que OpenAPI desempeña para REST.
Un documento AsyncAPI 3.0 tiene info, servers, channels, operations y components. Un canal se corresponde con un topic a través de su address, y cada operación tiene una action de tipo send o receive:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPI también tiene bindings de Kafka a nivel de servidor, canal, operación y mensaje. Es donde van los detalles específicos de Kafka, los que los campos genéricos no pueden expresar. Guarda la especificación en el repositorio del productor, para que el pull request que cambia un evento también cambie su contrato.
Evolución de esquemas en Kafka: documenta la regla de compatibilidad
Tu esquema cambiará. El contrato debe indicar qué cambios son seguros. Si usas un schema registry, documenta su modo de compatibilidad. La documentación de evolución de esquemas de Confluent enumera estos modos, y señala que “el tipo de compatibilidad por defecto del Confluent Schema Registry es BACKWARD”:
| Modo | Quién puede leer qué |
|---|---|
| BACKWARD | Los consumidores con el nuevo esquema pueden leer datos escritos con el esquema anterior |
| BACKWARD_TRANSITIVE | Los consumidores con el nuevo esquema pueden leer datos de todos los esquemas anteriores |
| FORWARD | Los consumidores con el esquema anterior pueden leer datos escritos con el nuevo esquema |
| FORWARD_TRANSITIVE | Los consumidores con cualquier esquema anterior pueden leer datos escritos con el nuevo esquema |
| FULL | Compatible hacia atrás y hacia adelante con el esquema anterior |
| FULL_TRANSITIVE | Compatible hacia atrás y hacia adelante con todos los esquemas anteriores |
| NONE | Las comprobaciones de compatibilidad están desactivadas |
En la práctica, bajo BACKWARD puedes añadir campos opcionales y eliminar campos que tuvieran valores por defecto. Renombrar un campo obligatorio o cambiar su tipo rompe los consumidores. Cuando necesites un cambio disruptivo, publica una nueva versión del topic (orders.order-placed.v2), documenta ambas y fija una fecha de retirada para la antigua.
Deja que tu agente de código documente las APIs de Kafka con Apidog CLI
Los contratos escritos a mano se desincronizan en cuanto alguien cambia un productor. Tu agente de código puede leer el código del productor, escribir los esquemas y mantener la documentación sincronizada mientras tú revisas. El Apidog CLI da a Claude Code, Codex, Cursor o cualquier agente de terminal los comandos para hacerlo en un proyecto de Apidog.
Instala el CLI, inicia sesión y añade la skill de Apidog para que tu agente conozca los comandos:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
También puedes delegar la configuración al agente: dile que lea la guía de instalación del Apidog CLI y que se configure por sí mismo.
Luego dale a tu agente un único prompt:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
El agente comprueba la forma del payload, valida su archivo y después escribe el esquema y la página del contrato:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema create guarda el payload como un esquema de datos reutilizable. Tus endpoints HTTP pueden referenciar el mismo modelo, así que un Order definido una vez cubre tanto la respuesta REST como el evento de Kafka. apidog doc create escribe un documento Markdown en el árbol del proyecto, que contiene el contrato del topic de la tabla anterior. Cuando cambie un productor, vuelve a ejecutar el prompt y el agente usará apidog schema update. Para un recorrido más detallado del trabajo de documentación con agentes, consulta cómo documentar APIs desde el CLI y Apidog CLI en Claude Code.
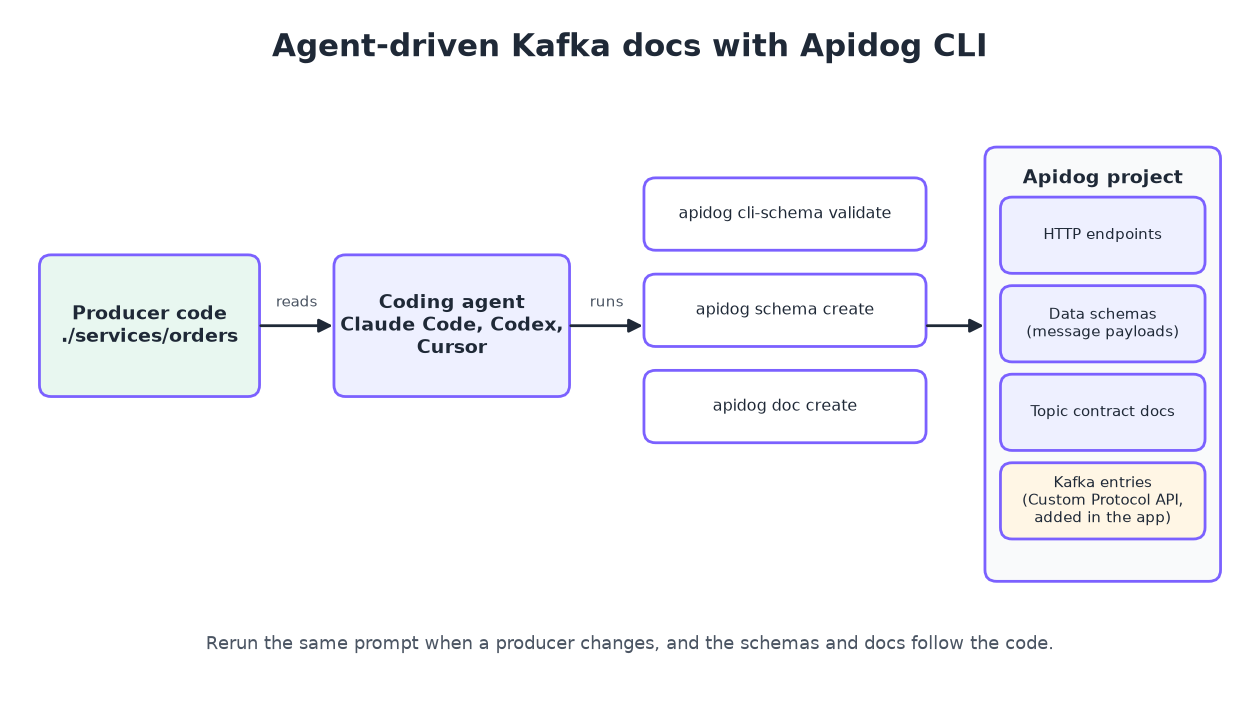
Un paso se queda en la aplicación. La función Custom Protocol API de Apidog documenta los endpoints de Kafka junto a los HTTP: elige Nuevas APIs de otro protocolo, luego API de otro protocolo personalizado, selecciona Kafka como protocolo y completa la URI (el topic), el nombre, el estado, los responsables, las etiquetas y la descripción. Estas entradas comparten el árbol de carpetas, la búsqueda y Quick Share con tu documentación HTTP. El CLI no tiene hoy un comando para endpoints de protocolo personalizado, así que esta es la única parte que creas a mano.
Apidog Free cubre hasta 4 usuarios, así que un equipo pequeño puede mantener su documentación REST y de Kafka en un solo proyecto sin coste alguno.
FAQ
¿Existe un OpenAPI para Kafka?
AsyncAPI cumple ese papel. Describe servidores, canales (topics), operaciones y payloads de mensajes en YAML o JSON, con bindings específicos de Kafka.
¿Necesito un schema registry para documentar APIs de Kafka?
No, pero ayuda. La documentación declara las reglas; un registry las aplica en el momento de escribir. Si usas uno, documenta su modo de compatibilidad.
¿Qué diferencia hay entre documentar un topic de Kafka y un endpoint REST?
La documentación REST describe una petición y una respuesta. La documentación de Kafka describe un mensaje que muchos consumidores leerán más tarde, por lo que también necesita la clave, el alcance del orden, la garantía de entrega, la retención y los consumer groups. Nada de eso aparece en una documentación REST típica.
¿Puede Apidog probar mensajes de Kafka?
Apidog documenta los endpoints de Kafka mediante Custom Protocol API, pero no envía ni consume mensajes de Kafka. Úsalo para guardar el contrato y los esquemas del payload, y prueba el código del productor y del consumidor con tu librería cliente de Kafka.
¿Con qué frecuencia debo actualizar la documentación de Kafka?
Cada vez que un productor cambie un mensaje. Vincúlalo a la revisión de código: el pull request que cambia el evento actualiza el contrato, o tu agente lo regenera con Apidog CLI.