
Para construir un superagente como el que describe DeepSeek Harness, divide tu agente en dos capas: una sesión persistente de Router que interactúa con las personas y distribuye el trabajo, y múltiples sesiones aisladas de Workers, cada una ejecutando una única tarea con acceso total a herramientas. Alimenta ambas capas mediante Triggers de eventos (chat, GitHub, CI), enruta los mensajes de seguimiento por Thread e incorpora un Watchdog independiente que supervise todo.
Esta guía convierte el ensayo de diseño de DeepSeek Harness, «Exploring Super-agent Design», en una hoja de ruta de implementación. Una aclaración: el ensayo describe una arquitectura, no una funcionalidad finalizada. Parte de ella reside en un plugin prototipo llamado dsh-superagent-prototype, que según los propios autores «no es un producto oficial de DeepSeek». Cada fragmento de código que se muestra a continuación es meramente ilustrativo y no pertenece al código de DeepSeek.
¿Qué es un superagente?
Un superagente es un compañero de equipo de IA único y siempre activo que recibe eventos desde múltiples canales (chat, pull requests, CI), ejecuta diversas tareas en paralelo en sesiones aisladas y responde a las personas manteniendo una única identidad coherente.
El problema: las sesiones de los agentes están aisladas y «por lo general, una persona solo puede seguir de 3 a 5 sesiones activas al mismo tiempo». Una sola tarea se ve limitada por el modelo; la multitarea, por la atención humana. El superagente aborda precisamente este segundo límite.
Presenta cuatro características fundamentales:
- Continuo: un único agente en mensajería instantánea y GitHub. Debates el Plan A en el chat, cambias al Plan B en un comentario de una PR y el agente se adapta sin perder el hilo.
- Productivo: ejecuta tareas en paralelo y acepta tu siguiente instrucción antes de que finalice la anterior.
- Proactivo: monitoriza los eventos y permanece en silencio a menos que se requiera su intervención.
- Persistente: está siempre en línea y se recupera por sí solo.
Si aún no estás familiarizado con el harness, comienza descubriendo qué es DeepSeek Harness y cómo se compara con Claude Code.
Arquitectura del superagente: los cinco módulos
El ensayo plantea cinco módulos. A continuación te los mostramos junto con el paso en el que se implementa cada uno:
| Módulo | Qué hace | Paso de implementación |
|---|---|---|
| Arquitectura de dos niveles | El Router distribuye y los Workers ejecutan | 1 |
| Triggers basados en eventos | Transforman eventos de chat, GitHub y CI en entradas para el agente | 2 |
| Full-duplex multicanal | Herramientas asíncronas y respuestas adaptadas al canal | 4 |
| Separación de cómputo, estado y entorno | Bucle sin estado, estado en base de datos y máquinas estables | 5 |
| Watchdog | Sesión independiente que supervisa el progreso y los errores | 6 |
Paso 1: Separar el Router de los Workers
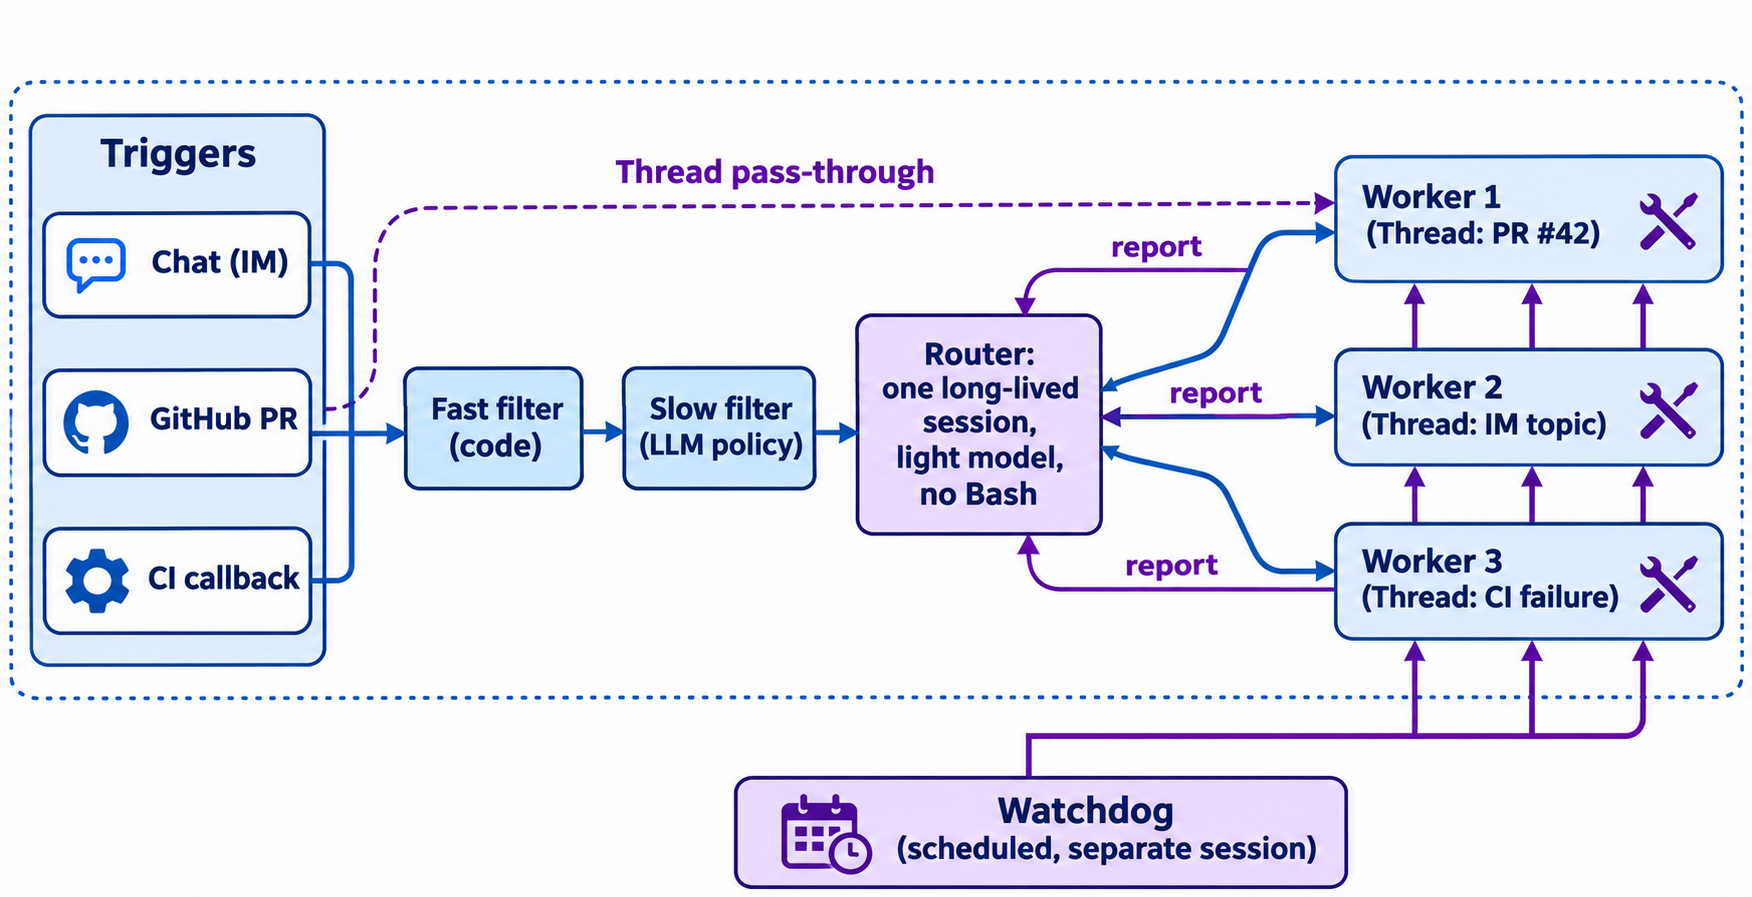
El Router es una sesión de larga duración. Gestiona toda la interacción humana y la distribución de trabajo, y nunca ejecuta tareas por sí mismo. Puede operar sin una herramienta de Bash y basta con un modelo más ligero y económico. Cuando llegan varios Triggers durante un mismo turno del Router, se procesan por lotes en la siguiente llamada: entrada extensa, salida breve, combinadas en la fase de prefill.
Cada Worker es una sesión aislada dedicada a una sola tarea. Cuenta con acceso total a herramientas y con el modelo más potente que te puedas permitir. Nunca interactúa con personas; reporta directamente al Router. Un Worker puede, a su vez, emplear subagentes o constituir un equipo completo de agentes.
No lo confundas con un equipo de agentes. El líder de un equipo descompone una tarea acoplada; el Router solo distribuye tareas independientes. De hecho, se pueden combinar ambos enfoques.
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
Paso 2: Convertir eventos en Triggers
Cualquier entrada para un superagente es un Trigger: un mensaje de chat, un evento de webhook de GitHub, una carga útil de la API de eventos de Slack o un callback de CI. La mayoría de ellos ni siquiera deberían llegar a un modelo, por lo que el ensayo los filtra en dos fases.
- Vía rápida, en código. Filtra por origen, grupo y listas de permitidos de usuarios o bots. A cada fuente se le asigna un modo: «responder solo a peticiones explícitas», «candidato» o «ignorar».
- Vía lenta, con un LLM. Los candidatos pasan a un modelo que aplica políticas redactadas mediante prompts, como «responder cuando alguien reporte un error en este canal».
Tu endpoint de recepción debe confirmar la recepción de inmediato y procesar después. Las buenas prácticas para webhooks de GitHub exigen responder con un código 2XX en menos de 10 segundos, algo que una llamada al modelo no puede garantizar. Devuelve 202 Accepted, encola el Trigger y deja que el Router lo recoja. Nuestra guía sobre cómo diseñar webhooks fiables profundiza en reintentos e idempotencia para esta capa.
Paso 3: Enrutar los seguimientos por Thread
Un Thread es una secuencia de eventos consecutivos dentro de una misma PR, un tema de chat o un hilo de correo. El Worker creado para el primer evento de un Thread se suscribe a él. A partir de ese momento, los eventos de seguimiento pasan directamente a ese Worker, sin necesidad de consultar al Router.
La correspondencia es de muchos a muchos. Si dos Workers intervienen en la misma PR, ambos reciben sus eventos y pueden resolver conflictos a través de la propia PR sin necesidad de comunicarse directamente entre sí.
Omitir este paso pasa factura: en el experimento del ensayo, eliminar esta derivación directa provocó que el Router tomara en torno a un 30% más de decisiones y disparó el consumo de tokens alrededor de un 37%.
Paso 4: Tratar el contexto como una caché y hacer que las herramientas sean asíncronas
El Router no puede retenerlo todo, por lo que el ensayo gestiona el contexto como una memoria caché:
- Mantener en línea lo que probablemente sea necesario: identificadores, resúmenes breves y mensajes adyacentes.
- Desbordar el resto: truncarlo y dejar un puntero que el agente pueda seguir.
Los identificadores estables en Triggers, Threads y Workers forman un grafo de referencias que los autores llaman «Chain of Recall» (cadena de recuperación). El agente salta de un Trigger a su Thread y de ahí al Worker que lo gestionó, lo que le otorga capacidad de recuperación en múltiples saltos sin requerir un prompt gigantesco.
A continuación, adopta un enfoque full-duplex. Sustituye una herramienta bloqueante como run() por versiones asíncronas como start() y stop(). start() responde «Started» de inmediato, y el resultado llega más tarde como un nuevo evento. Eso es lo que permite que el agente acepte tu siguiente instrucción mientras la anterior sigue ejecutándose. El ensayo indica que DeepSeek Harness implementa esto, aunque no lo habilita por defecto.
Por último, haz que las respuestas se adapten al canal. Su regla evaluada limita las respuestas en mensajería instantánea a 100 palabras, mientras que para GitHub, correo y documentación genera informes densos y estructurados.
Esto también hace posible la ejecución especulativa: en su grupo de usuarios, una política de «reproducir y corregir en silencio» entrega únicamente una solución simple ya verificada y, en caso contrario, se mantiene en silencio.
Paso 5: Separar cómputo, estado y entornos
Ejecuta el bucle del agente en contenedores en la nube sin estado y almacena el estado de la sesión en una base de datos. Los entornos permanecen donde están: cada máquina ejecuta un demonio ligero, un modelo que el ensayo denomina BYOM (Bring Your Own Machine). Si un bucle se cae, se reinicia en cualquier lugar y recarga su estado, mientras que los repositorios permanecen intactos en sus máquinas.
El ensayo señala el artículo de Anthropic «Scaling Managed Agents: Decoupling the brain from the hands» como la misma idea, dirigida a entornos aislados (sandboxes) gestionados en lugar de a tus propias máquinas.
Paso 6: Añadir un Watchdog
El Watchdog es una sesión independiente ejecutada de forma programada, externa al sistema principal. Gestiona errores de API y consulta a un modelo si cada Worker está progresando adecuadamente o si se está desviando. Además, los mantenedores pueden preguntarle directamente por qué falló algo. Manténlo fuera del proceso del Router para que un bloqueo en este no derribe también a su supervisor.
Qué revelaron los experimentos
Los autores procesaron unos 300 mensajes de chat y CI que contenían cerca de 20 solicitudes de trabajo, simularon la programación mediante un temporizador y ejecutaron cada configuración 5 veces. Señalan que los resultados son «meramente indicativos».
| Configuración | p50 (min) | p95 (min) | Tokens leídos de caché por ejecución |
|---|---|---|---|
| Superagente | 12.4 | 15.7 | 23.2M |
| Sin derivación directa por Thread | 12.6 | 15.5 | 31.8M |
| Sesión única + herramienta de subagente, prompt neutral | 20.4 | 29.5 | 6.1M |
| Sesión única, prompt centrado en delegación | 13.8 | 29.0 | 10.8M |
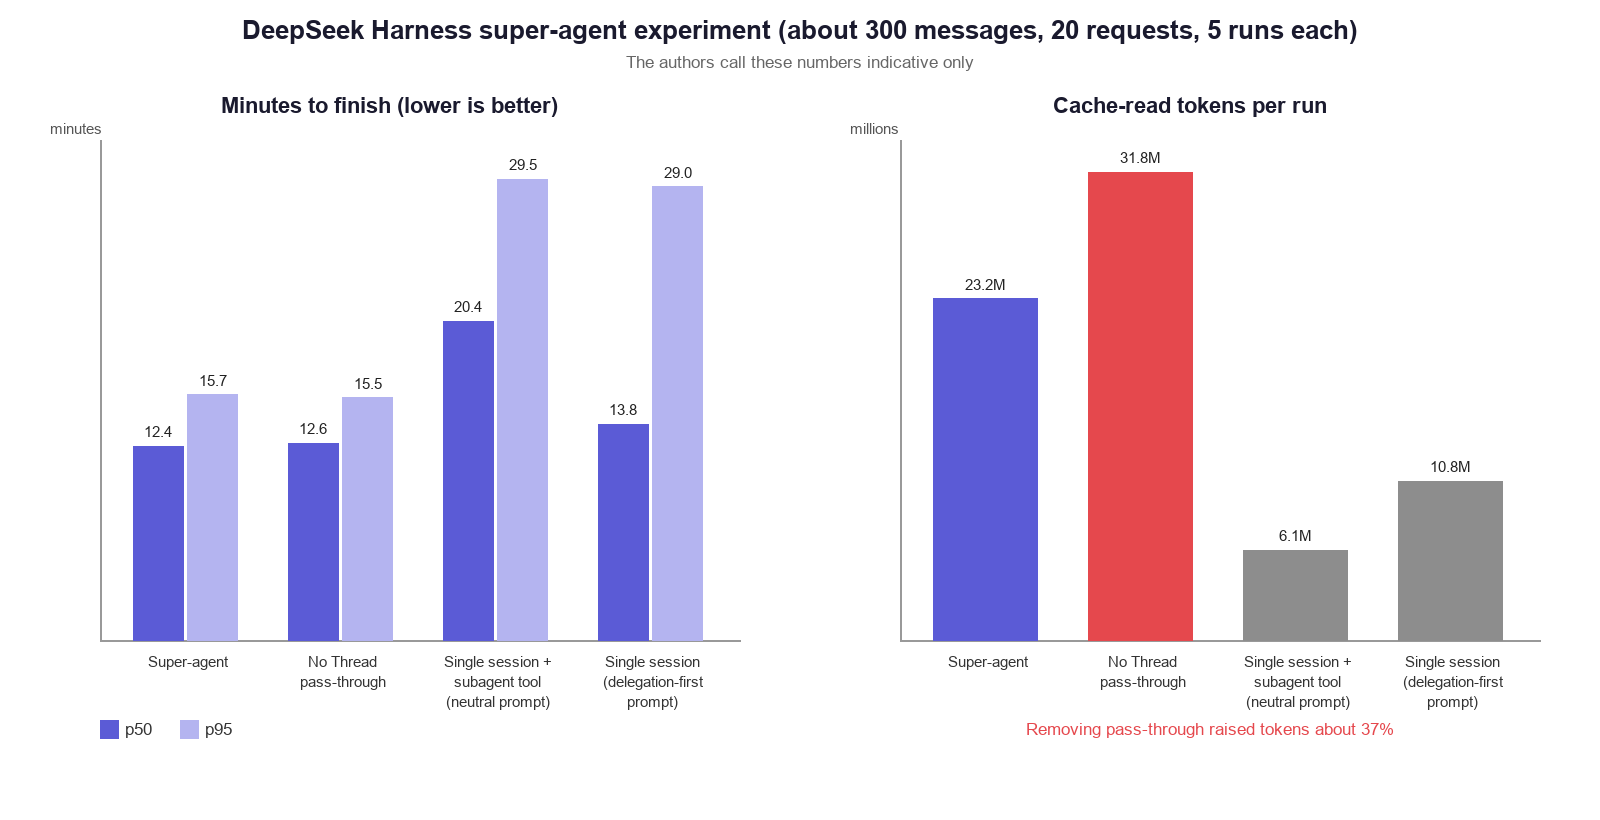
Sobresalen dos conclusiones. Con un prompt neutral, la sesión única nunca llegó a delegar en las 5 ejecuciones, por lo que su p95 prácticamente duplicó al del superagente. Un prompt orientado a la delegación resolvió la mediana, pero no la cola de la distribución. El superagente consume más tokens que una sesión única, de modo que intercambias tokens a cambio de menor latencia y menor carga de atención humana.
Una segunda prueba sometió a carga únicamente al Router. Al pasar los Triggers de 1 a 40 por minuto, el tamaño del lote aumentó de 1,0 a 2,8 y el tiempo por solicitud subió de 2,5 s a 3,9 s, mientras que el tiempo por decisión se redujo de 6,4 s a 1,6 s. El procesamiento por lotes es precisamente lo que evita que un solo Router se convierta prematuramente en el cuello de botella.
Prueba la recepción de Triggers con Apidog CLI
Cada Trigger nace como una petición HTTP contra tu endpoint de recepción, por lo que ese endpoint es lo primero que vale la pena probar. Si pierde el comentario de una PR o asigna un nuevo thread_id a cada evento, el enrutamiento por Thread se rompe y cada seguimiento vuelve a pasar por el Router. Deja que tu agente de programación escriba y ejecute esa prueba con Apidog CLI.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego, dale a tu agente una única instrucción:
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
El agente lee el esquema de cada payload, valida su JSON, crea el endpoint y el caso de prueba, y lo ejecuta:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
La misma llamada a apidog run con -r junit se integra en tu pipeline; consulta Apidog CLI en CI/CD. Si tu agente es el propio DeepSeek Harness, sigue esta guía de configuración; para Claude Code, utiliza esta otra. El plan gratuito de Apidog cubre hasta 4 usuarios.
Problemas abiertos
El ensayo enumera lo que aún no está resuelto:
- Escalar el Router y definir una topología de Workers a medida que la carga aumenta.
- Memoria a largo plazo más allá de la Chain of Recall.
- UX sin sesiones: dirigir a un agente sin disponer de una única ventana de chat.
- Límites de contexto y protocolos entre agentes, donde A2A se perfila como un candidato.
- Seguridad. Una inyección de prompts que alcance el bucle en la nube podría propagarse a cada máquina conectada, y las credenciales en el contexto pueden filtrarse. Los autores buscan que los agentes utilicen credenciales sin llegar a verlas en ningún momento.
Preguntas frecuentes
¿Es el superagente una funcionalidad de DeepSeek Harness que se pueda activar? No. El ensayo describe una arquitectura. Ciertas partes existen en el plugin dsh-superagent-prototype, el cual, según los autores, no es un producto oficial de DeepSeek. Las herramientas full-duplex están implementadas, pero desactivadas por defecto.
¿Por qué el Router utiliza un modelo más ligero? Solo se encarga de despachar tareas e interactuar con personas; nunca ejecuta tareas ni necesita Bash. Los Workers asumen el razonamiento pesado con el modelo más potente.
¿En qué se diferencia un superagente de un equipo de agentes? El líder de un equipo fragmenta una tarea acoplada en partes. El Router distribuye tareas independientes. Un Worker puede ejecutar su propio equipo de agentes dentro del superagente.
¿Qué es la derivación directa por Thread (Thread pass-through)? Los eventos de seguimiento en una PR, tema de mensajería instantánea o hilo de correo electrónico van directamente al Worker responsable de ese Thread, omiti... [truncated 795 chars]