
Groq le da a cada cuenta una clave del Plan Gratuito para su endpoint compatible con OpenAI, y esa clave funciona en el momento en que te registras. La parte que confunde a la gente no es obtener acceso, sino mantenerse dentro de los límites una vez que tu app realmente está llamando al modelo. Groq publica cifras del Plan Gratuito por modelo en su documentación, pero esos números cambian y tu propia cuenta puede diferir. El hábito confiable es revisar la configuración de tu cuenta y luego leer los encabezados de respuesta en cada llamada, ya que los límites pueden cambiar a mitad de sesión.
Esta guía cubre cómo obtener una clave, apuntar un cliente estándar de OpenAI al endpoint de Groq y la parte que la mayoría de las publicaciones sobre “nivel gratuito” omiten: vigilar tus límites en tiempo real en lugar de enterarte de ellos por un 429 en producción. Luego tu agente de codificación convierte esa verificación en una prueba de Apidog CLI, para que sea repetible, no un comando curl único que olvidas.
Resumen
Groq tiene dos niveles: Plan Gratuito y Plan Desarrollador. Los límites de tasa se aplican a nivel de organización (no por usuario), alcanzas el límite que llegue primero entre solicitudes, tokens o totales diarios, y los tokens en caché no cuentan en tu contra. Groq publica cifras del Plan Gratuito por modelo, pero los números que se aplican a tu cuenta están en la página de límites de tu consola, así que lo confiable es leerlos de los encabezados de respuesta x-ratelimit-* en cada llamada en lugar de confiar en una tabla que puede cambiar sin aviso.
Obtener una clave y llamar al endpoint
Crea una cuenta en console.groq.com y genera una clave desde la página de claves. Groq expone esa clave mediante una API compatible con OpenAI, así que si ya has llamado al SDK de OpenAI antes, ya conoces la forma. Apunta la URL base a Groq en lugar de a OpenAI y mantén todo lo demás igual:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
O con el cliente oficial de Python de OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
La documentación de compatibilidad con OpenAI de Groq señala algunas brechas que conviene conocer antes de copiar tu código existente: logprobs, logit_bias, top_logprobs y messages[].name devuelven todos un error 400, n tiene que ser igual a 1 si lo configuras, y una temperatura de 0 se convierte en un pequeño float positivo en lugar de una decodificación verdaderamente greedy.
Plan Gratuito vs Plan Desarrollador
Las propias palabras de Groq son directas: “Actualiza al plan Desarrollador para acceder a límites más altos, procesamiento Batch y Flex, y más.” El Plan Gratuito es con el que empieza cada clave nueva, y es genuinamente usable para pruebas y proyectos secundarios pequeños.
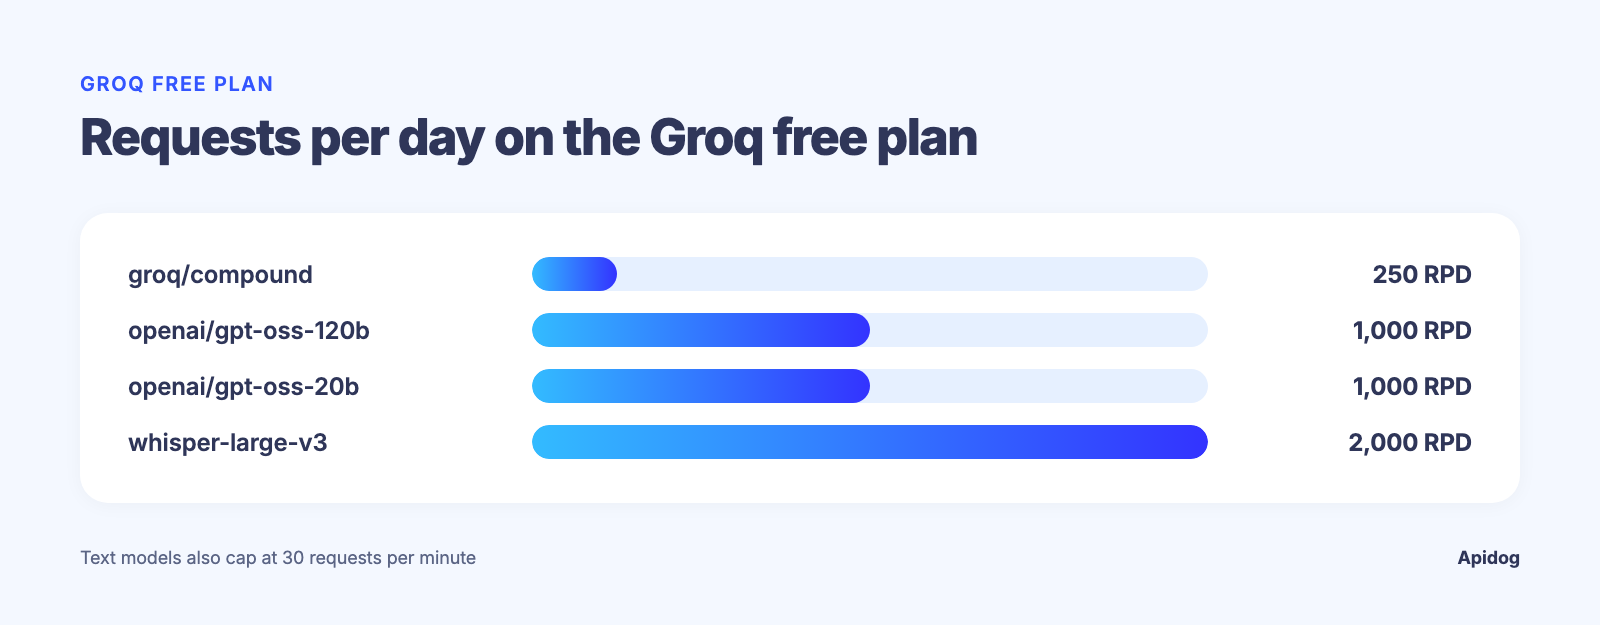
Esto es lo que permite el Plan Gratuito para algunos modelos, según la documentación de límites de tasa de Groq consultada el 2026-09-15:
| Modelo | RPM | RPD | TPM | TPD | Audio |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
Esa misma página tiene una pestaña de Plan Desarrollador con techos más altos para cada modelo, además de procesamiento Batch y Flex. Trata la tabla anterior como una instantánea, ya que Groq puede cambiar estos números sin aviso. Tus propias cifras están en la página de límites de la configuración de tu cuenta: confía en esa página por encima de esta si no coinciden.
Dos detalles de política importan más que los números en bruto. Los límites de tasa se aplican “a nivel de organización, no de usuarios individuales”, así que cinco personas que comparten una organización de Groq comparten un límite, no cinco separados. Y “los tokens en caché no cuentan para tus límites de tasa”, lo que significa que una estructura de prompt bien cacheada te compra más rendimiento real de lo que sugiere el número destacado.
Modelos que conviene conocer antes de alcanzar un límite
El límite que importa depende de qué modelo llames. Los modelos de texto y los sistemas Compound de Groq funcionan con un contexto de 131,072 tokens:
| ID del modelo | Tipo |
|---|---|
llama-3.1-8b-instant |
Texto rápido de propósito general |
llama-3.3-70b-versatile |
Texto más grande de propósito general |
openai/gpt-oss-120b |
Modelo de razonamiento de pesos abiertos |
openai/gpt-oss-20b |
Modelo más pequeño de razonamiento de pesos abiertos |
groq/compound |
Sistema agéntico |
groq/compound-mini |
Sistema agéntico más ligero |
Los modelos Whisper, whisper-large-v3 y whisper-large-v3-turbo, no encajan en esta tabla. Son modelos de transcripción de audio, y Groq mide su rendimiento en segundos de audio por hora y por día (ASH/ASD) junto con sus propios límites de RPM y RPD, no en tokens.
Cada modelo tiene sus propios límites de RPM, RPD y tokens, así que no asumas que los límites de llama-3.1-8b-instant se aplican a openai/gpt-oss-120b.
Lee los encabezados de límite de tasa en lugar de adivinar
Cada respuesta de api.groq.com lleva un conjunto de encabezados que te dicen exactamente en qué punto estás, sin necesidad de visitar la consola:
x-ratelimit-limit-requestsyx-ratelimit-limit-tokens, tu techo para la ventana actualx-ratelimit-remaining-requestsyx-ratelimit-remaining-tokens, lo que queda ahora mismox-ratelimit-reset-requestsyx-ratelimit-reset-tokens, cuándo se renueva la ventanaretry-after, enviado en un 429, que te dice cuánto esperar
Lee x-ratelimit-remaining-tokens después de cada llamada y tienes un indicador en vivo, no un número estático que consultaste una vez y olvidaste volver a revisar. Aquí hay una verificación rápida con cURL, imprimiendo solo los encabezados:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
Ejecuta eso unas cuantas veces en un bucle contra un script de prueba ruidoso y verás cómo x-ratelimit-remaining-tokens va bajando. Si tu app alguna vez necesita lógica de retroceso, consulta nuestra guía sobre cómo implementar límites de tasa de API para patrones que respetan un encabezado retry-after en lugar de adivinar un retraso.
Deja que tu agente de codificación ejecute la verificación con Apidog CLI
Hacer el baile de curl y grep a mano funciona para una sesión de depuración. No escala a un equipo, y nadie vuelve a ejecutar un comando de shell único antes de cada despliegue. Mejor delega la verificación a tu agente de codificación: con Apidog CLI, escribe la prueba una vez y la ejecuta siempre que se lo pidas. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
El token se obtiene de Apidog en Configuración de cuenta, API Access Token. Luego dale al agente un prompt:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
Los comandos que ejecuta, verificados con Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
Un presupuesto que se reduce ahora aparece como una prueba fallida en lugar de un 429 sorpresa durante una demo. Pon esa última línea en tu trabajo de CI previo al despliegue, como en nuestra guía de pipeline CI/CD de Apidog CLI, o pídele al agente un apidog scheduled-task create, que ejecuta la suite en un runner según un cron. Esto importa más dado el agrupamiento a nivel de organización de Groq: un compañero de equipo ejecutando un trabajo por lotes puede consumir el presupuesto compartido que tu endpoint de producción necesita una hora después. Es la misma idea detrás de nuestra publicación sobre probar una API para límites de tasa de GPT.
Qué hacer cuando realmente alcanzas el límite
Cuando recibas un 429, respeta retry-after en lugar de reintentar de inmediato. Un bucle de reintentos ajustado contra un límite a nivel de solicitud solo gasta tu presupuesto restante más rápido y empuja la ventana de reinicio más lejos. Si estás incorporando esto en un servicio de producción en lugar de un script de prueba, nuestra guía completa del error de límite de tasa excedido repasa estrategias de retroceso que funcionan entre proveedores, no solo en Groq.
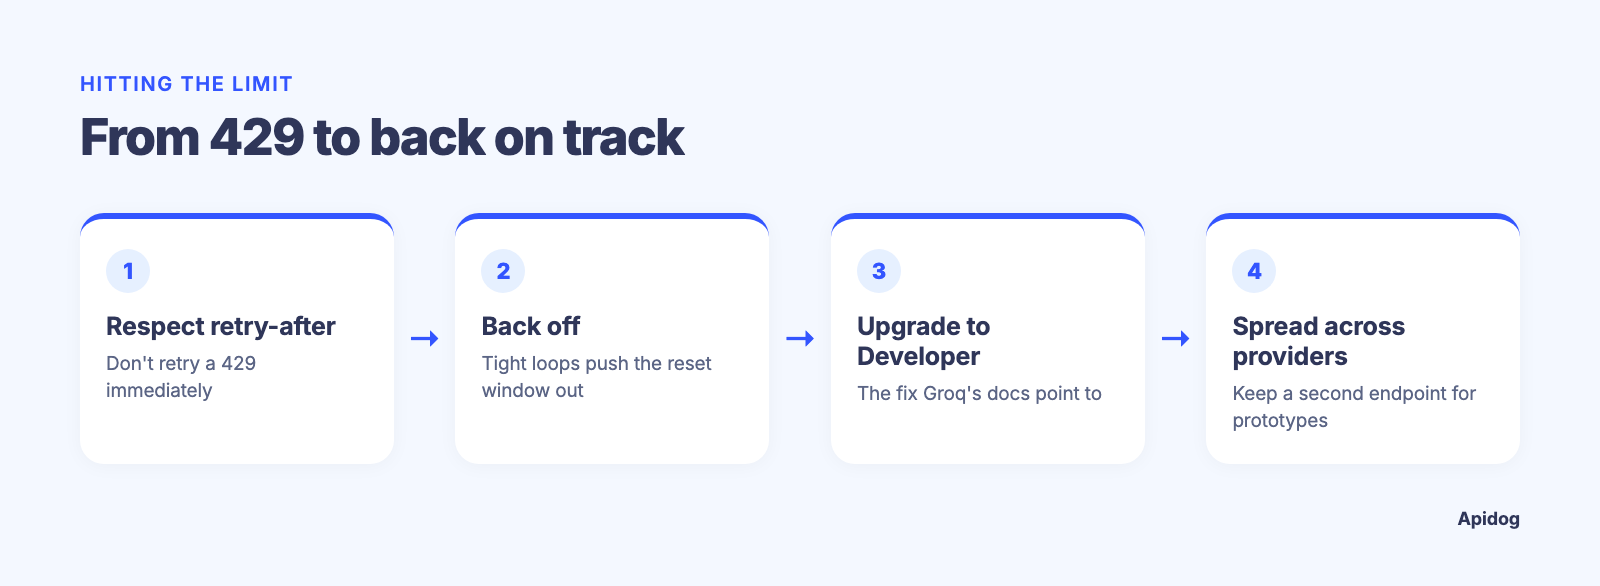
Si te topas consistentemente con el techo del Plan Gratuito, la solución más rápida es la actualización al Plan Desarrollador a la que Groq apunta directamente en su documentación. La segunda solución más rápida, especialmente para un prototipo, es repartir el tráfico entre más de un proveedor. Nuestra recopilación de alternativas a OpenRouter cubre otros endpoints que vale la pena tener a mano para exactamente esta situación.
Preguntas frecuentes
¿Groq tiene un nivel gratuito para su API? Sí. Cada cuenta nueva comienza en el Plan Gratuito con acceso al endpoint compatible con OpenAI. Groq publica límites de ejemplo del Plan Gratuito para varios modelos, pero los límites que realmente se aplican a tu cuenta están en la página de límites de la configuración de tu consola.
¿Cómo reviso mi límite de tasa actual de Groq? Dos formas: abre la página de límites en la configuración de tu cuenta, o lee los encabezados x-ratelimit-limit-requests y x-ratelimit-limit-tokens en cualquier respuesta de la API. Los encabezados reflejan el límite real de tu cuenta en el momento en que llamaste, lo cual es más confiable que un número que viste una vez y recordaste.
¿Qué pasa cuando excedo el límite de tasa de Groq? Recibes una respuesta 429 con un encabezado retry-after que te dice cuántos segundos esperar. Consulta nuestra guía de límite de tasa excedido para manejar esto en código en lugar de adivinar un retraso.
¿Los tokens en caché cuentan para mi límite de tasa de Groq? No. Groq afirma directamente que los tokens en caché no cuentan para tus límites de tasa, así que una estructura de prompt que reutiliza un mensaje de sistema cacheado obtiene más rendimiento real de lo que implica el límite de tokens en bruto.
¿El límite de tasa de Groq es por usuario o por organización? Por organización. Cada clave bajo la misma organización de Groq comparte un único grupo de solicitudes y tokens, así que el script de un compañero de equipo puede consumir el presupuesto que tu app de producción necesita.
¿Qué modelos de Groq tienen la ventana de contexto más alta? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b y los sistemas Compound funcionan todos con 131,072 tokens de contexto. Los modelos Whisper son de transcripción de audio, no de texto, así que Groq mide sus límites en duración de audio. Los límites de tasa difieren de un modelo a otro incluso dentro de la misma ventana de contexto, así que revisa cada uno por separado.
Dónde te deja esto
La forma gratuita de usar la API de Groq no es un número secreto, es un hábito. Obtén una clave, apunta el endpoint compatible con OpenAI hacia ella y lee los encabezados de respuesta en cada llamada en lugar de confiar en una cifra que encontraste en una publicación de blog, incluida esta.
Haz que tu agente de codificación construya esa verificación una vez con Apidog CLI, con una aserción sobre los tokens restantes para cada modelo, y se ejecutará en cada despliegue a partir de entonces. La configuración lleva menos tiempo que leer el resto de la documentación de Groq. Para una cobertura más profunda sobre probar una capa de API de IA bajo carga, nuestra guía de las mejores herramientas de prueba de API para agentes de IA es una buena siguiente parada.