
Grok 4.6 se lanzó el 12 de agosto con una afirmación que redefine la decisión del modelo frontera: una inteligencia que empata con GPT-5.6 Sol en el Índice de Análisis Artificial, a $6 por millón de tokens de salida en lugar de $30. La mayoría de los artículos de comparación que encontrarás todavía comparan Grok 4.5, que estaba tan rezagado con respecto a la frontera que el precio no importaba. Esa ya no es la situación, por lo que esta comparación comienza de nuevo con los números de 4.6.
La respuesta corta: GPT-5.6 Sol sigue siendo la mejor opción para agentes de codificación a escala de repositorio, Claude Fable 5 lidera el trabajo autónomo de largo horizonte por un pequeño margen, y Grok 4.6 es ahora la opción de valor que está lo suficientemente cerca en capacidad como para que los otros dos justifiquen su precio. La elección correcta depende de tu carga de trabajo, por lo que a continuación se presentan los números, las consideraciones de la API y una forma reproducible de probar los tres en tu propio stack. Si quieres ejecutar esa prueba hoy, Apidog te permite acceder a las tres APIs simultáneamente desde un único espacio de trabajo, de forma gratuita.
botón
En resumen
- Índice de inteligencia: Claude Fable 5 lidera con 62; Grok 4.6 y GPT-5.6 Sol empatan con 61.
- Precios (salida, por 1M de tokens): Grok 4.6 a $6, Claude Opus 4.8 a $25, GPT-5.6 Sol a $30, una diferencia de 5x.
- Contexto: GPT-5.6 Sol 1.05M tokens, Claude Fable 5 1M, Grok 4.6 500K.
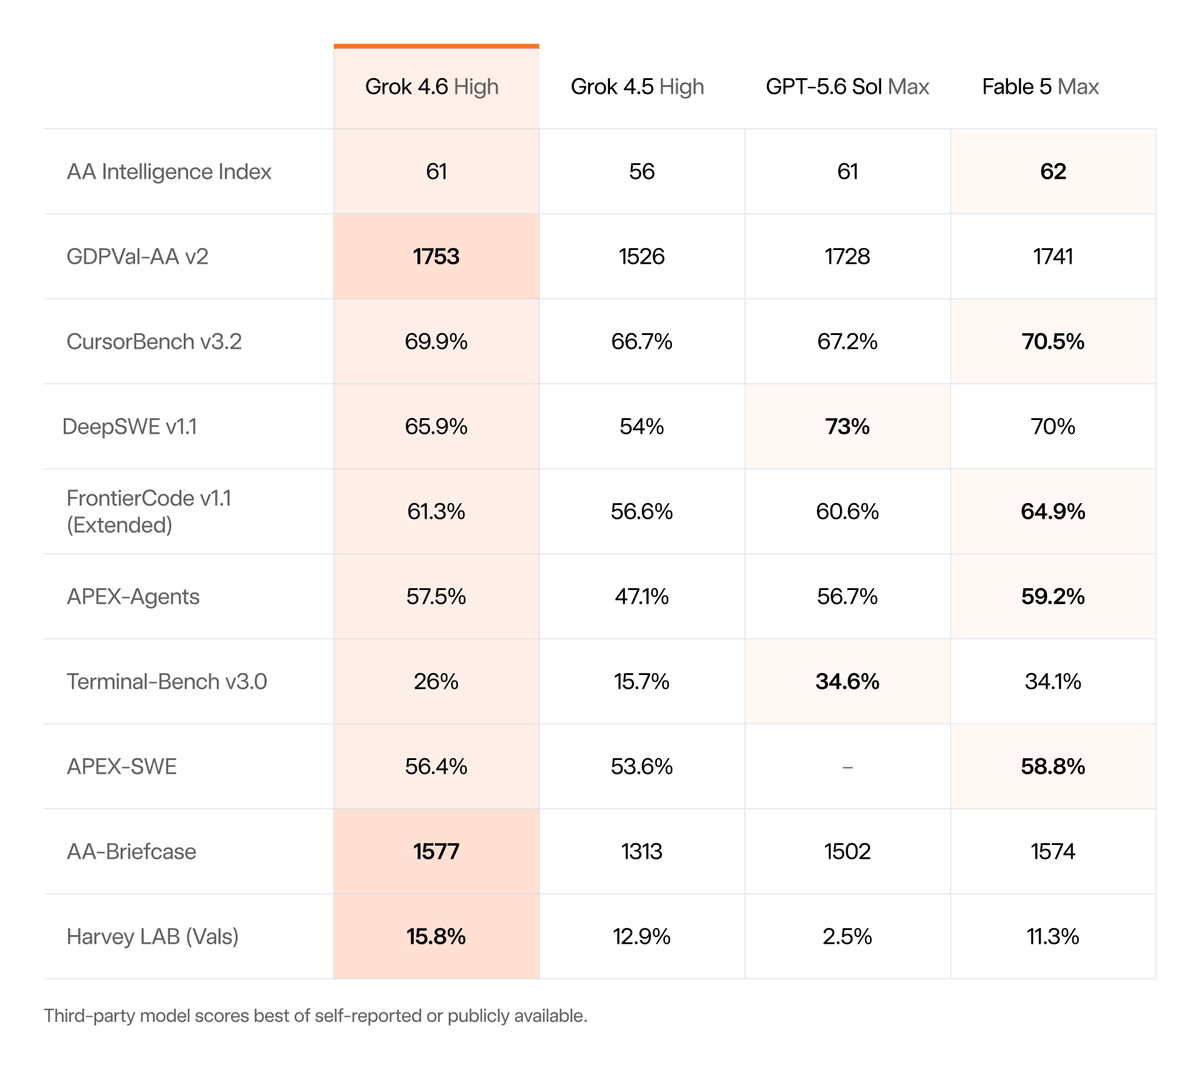
- Codificación: Sol Max lidera DeepSWE (73.0% vs 65.9% de Grok); Fable 5 Max lidera FrontierCode (63.6% vs 61.3%).
- Agentes: Fable 5 Max lidera APEX-Agents con 59.2%; Grok 4.6 (57.5%) supera ligeramente a Sol Max (56.7%).
- Costo por tarea completada: Grok 4.6 medido en $0.84 por Análisis Artificial, el más bajo en la frontera.
- No decidas solo por los benchmarks: ejecuta una prueba de 20 prompts en tu propia carga de trabajo (método a continuación).
Especificaciones y precios uno al lado del otro
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Desarrollador | xAI | OpenAI | Anthropic |
| Índice de Inteligencia | 61 | 61 | 62 |
| Ventana de contexto | 500K | 1.05M | 1M |
| Precio de entrada / 1M | $2 | $12 | $10 |
| Precio de salida / 1M | $6 | $30 | $25* |
| Variante rápida/premium | 2x precio | Nivel Sol Max | Nivel Fable 5 Max |
| Estilo de API | Compatible con OpenAI | Nativa de OpenAI | Anthropic Messages |
| Fecha de corte de conocimiento | Febrero 2026 |
*Precio de Claude mostrado para Opus 4.8; el precio del nivel Fable 5 varía según la configuración de esfuerzo. Consulta nuestra guía de precios de GPT-5.6 y el desglose de reducción de costos de Claude para ver las matrices completas.
La asimetría de precios es la clave. En el extremo de entrada, Grok cobra una sexta parte de lo que cobra OpenAI; en el extremo de salida, una quinta parte. Para cargas de trabajo de chat, eso es bueno; para cargas de trabajo de agentes, donde una sola tarea puede generar docenas de llamadas al modelo y largas transcripciones de uso de herramientas, se convierte en la diferencia entre un agente de $50/día y uno de $250/día.
Benchmarks de codificación: Sol para profundidad, Grok para valor
Según los números de lanzamiento, cada modelo posee su propio territorio:
| Benchmark | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (correcciones a escala de repositorio) | 65.9% | 73.0% | |
| FrontierCode v1.1 Extendido | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Léelo de esta manera:
- La ventaja de 7 puntos de GPT-5.6 Sol Max en DeepSWE es real e importante. La corrección de errores a escala de repositorio es el benchmark de codificación más difícil y económicamente valioso. Si tu agente trabaja en grandes bases de código existentes con una supervisión mínima, Sol sigue siendo la apuesta más segura. Nuestra comparación entre GPT-5.6 Sol y Claude Fable 5 cubre ese enfrentamiento en profundidad.
- Claude Fable 5 gana en consistencia. Lidera el índice compuesto, FrontierCode y APEX-Agents. Nada irregular, simplemente rara vez es peor que el segundo. Ese perfil se adapta al trabajo autónomo de largo horizonte donde un paso en falso descarrila una hora de progreso.
- Grok 4.6 nunca está muy atrás, y a veces por delante. Liderar CursorBench y Terminal-Bench mientras se mantiene a poca distancia en otros lugares, a una fracción del costo, es exactamente el perfil de un modelo al que se le dirige la mayor parte del tráfico, escalando solo los casos difíciles.
Una nota de honestidad: estos son números de la semana de lanzamiento, en gran parte reportados por el proveedor. Los benchmarks de lanzamiento de Grok 4.5 requerían una lectura cuidadosa, y la misma precaución se aplica a todos los proveedores aquí.
Costo por tarea, no costo por token
Los precios por token pueden ser engañosos cuando los modelos difieren en verbosidad y tasas de reintento. Un modelo barato que falla en una ejecución terminal crea trabajo de revisión y reparación que cuesta más que los tokens ahorrados. La mejor métrica es el costo por tarea completada, y aquí la medición independiente de Artificial Analysis es sorprendente: Grok 4.6 promedió $0.84 por tarea en sus evaluaciones de agentes, el más bajo entre los modelos frontera, ayudado por un uso de tokens relativamente disciplinado en lugar de solo precios bajos.
Un ejemplo práctico. Digamos que tu agente de codificación promedia 500K tokens de entrada y 100K tokens de salida por tarea completada:
| Modelo | Costo de entrada | Costo de salida | Por tarea |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
Con 1,000 tareas al mes, Grok ahorra aproximadamente $6,000–7,400 en comparación con las alternativas, si su tasa de éxito en tu carga de trabajo se mantiene. Esa condición es todo el juego, por eso debes probar antes de comprometerte.
Ergonomía de la API: lo que realmente te cuesta la integración
- Grok 4.6 es compatible con OpenAI. Si tienes cualquier cliente estilo OpenAI, apuntas `base_url` a `https://api.x.ai/v1` y estás funcionando. También está en OpenRouter, Vercel y Cloudflare para usuarios de pasarelas.
- GPT-5.6 Sol tiene el ecosistema más profundo: la API de Respuestas, la llamada programática de herramientas y los SDK de primera parte en todas partes. Consulta cómo usar la API de GPT-5.6 para la estructura de niveles.
- Claude Fable 5 utiliza la API de Mensajes de Anthropic, una forma de solicitud diferente, una excelente fiabilidad en el uso de herramientas y un parámetro de esfuerzo que intercambia costo por capacidad dentro de un mismo modelo.
La fricción de migración es menor entre Grok y OpenAI (formato compartido), y mayor al moverse hacia o desde Anthropic. Si anticipas cambiar o enrutar entre modelos, esa asimetría debe considerarse en tu decisión de arquitectura.
Ventanas de contexto: cuando 500K es suficiente
Sobre el papel, la ventana de 1.05M tokens de GPT-5.6 Sol duplica la de 500K de Grok 4.6, con la de 1M de Claude Fable 5 pisándole los talones. En la práctica, la pregunta es qué contiene realmente tu carga de trabajo en contexto.
Una ventana de 500K cabe aproximadamente 350,000 palabras: la base de código completa de un servicio de tamaño mediano, un año de transcripciones de soporte o varios cientos de páginas de documentos legales. La mayoría de las tareas de los agentes nunca se acercan a eso. Las cargas de trabajo que realmente necesitan el nivel de un millón de tokens son estrechas: análisis de monorepositorios completos, transcripciones muy largas de agentes multisecuencia que te niegas a resumir y procesamiento de conjuntos de documentos masivos en una sola pasada.
Dos notas prácticas van en contra de elegir basándose únicamente en el tamaño de la ventana. Primero, cada modelo se degrada a medida que se llena el contexto; la calidad de recuperación al 80% de capacidad es peor que al 20% en los tres, por lo que las arquitecturas que rellenan la ventana rara vez superan a las arquitecturas que recuperan selectivamente. Segundo, los tokens de entrada son donde mueren los presupuestos: llenar la ventana completa de Sol cuesta alrededor de $12.60 por solicitud al precio de lista, mientras que llenar la de Grok cuesta $1. Si tus prompts superan rutinariamente los 400K tokens, no solo necesitas una ventana más grande, necesitas una estrategia de almacenamiento en caché y recuperación, sea cual sea el proveedor que elijas.
Fechas de corte de conocimiento y madurez del ecosistema
Grok 4.6 se lanza con una fecha de corte de conocimiento del 1 de febrero de 2026, la más reciente de las tres, lo cual es importante para los agentes de codificación que hacen referencia a frameworks de rápido movimiento. Es una ventaja real pero menor: cualquier pila de agentes seria se basa en herramientas de recuperación y documentación en lugar de confiar en el conocimiento paramétrico.
El ecosistema es la historia inversa. OpenAI tiene la superficie de integración de terceros más profunda, Anthropic tiene la mayor cuota de mercado en frameworks de agentes, y xAI es el recién llegado que se apoya en la compatibilidad con OpenAI para tomar prestadas ambas. Esa apuesta funciona en su mayor parte: cualquier cosa que hable el formato de completado de chat funciona con Grok hoy, y la disponibilidad a través de OpenRouter, Vercel y Cloudflare significa que puedes adoptarlo sin tocar tu infraestructura. Lo que sacrificas es un pulido de primera parte, las API por lotes, los niveles de caché y los controles de uso detallados son menos maduros que los de los operadores tradicionales.
Qué modelo para qué trabajo
- Agente de codificación autónomo a escala de repositorio, priorizando la calidad: GPT-5.6 Sol. La ventaja de DeepSWE se traduce en menos ejecuciones fallidas en grandes bases de código.
- Trabajo de conocimiento de largo horizonte y sesiones de agente de varias horas: Claude Fable 5. La mejor puntuación compuesta, el mejor benchmark de agente, el historial más sólido de mantenerse en el buen camino.
- Tráfico de agentes de alto volumen, productos sensibles al costo o modelo predeterminado de un enrutador: Grok 4.6. Salida de nivel frontera a precios de nivel de producto; escalar el 10% más difícil de las tareas a Sol o Fable.
- Codificación interactiva en un IDE: la ventaja de Grok 4.6 en CursorBench más su variante rápida 2x lo convierten en un serio contendiente; fue construido eficazmente para esto después de entrenar con sesiones reales de Cursor.
Prueba los tres en tu stack en una tarde
Los benchmarks predicen promedios, no tu carga de trabajo. Aquí tienes una prueba reproducible usando Apidog:
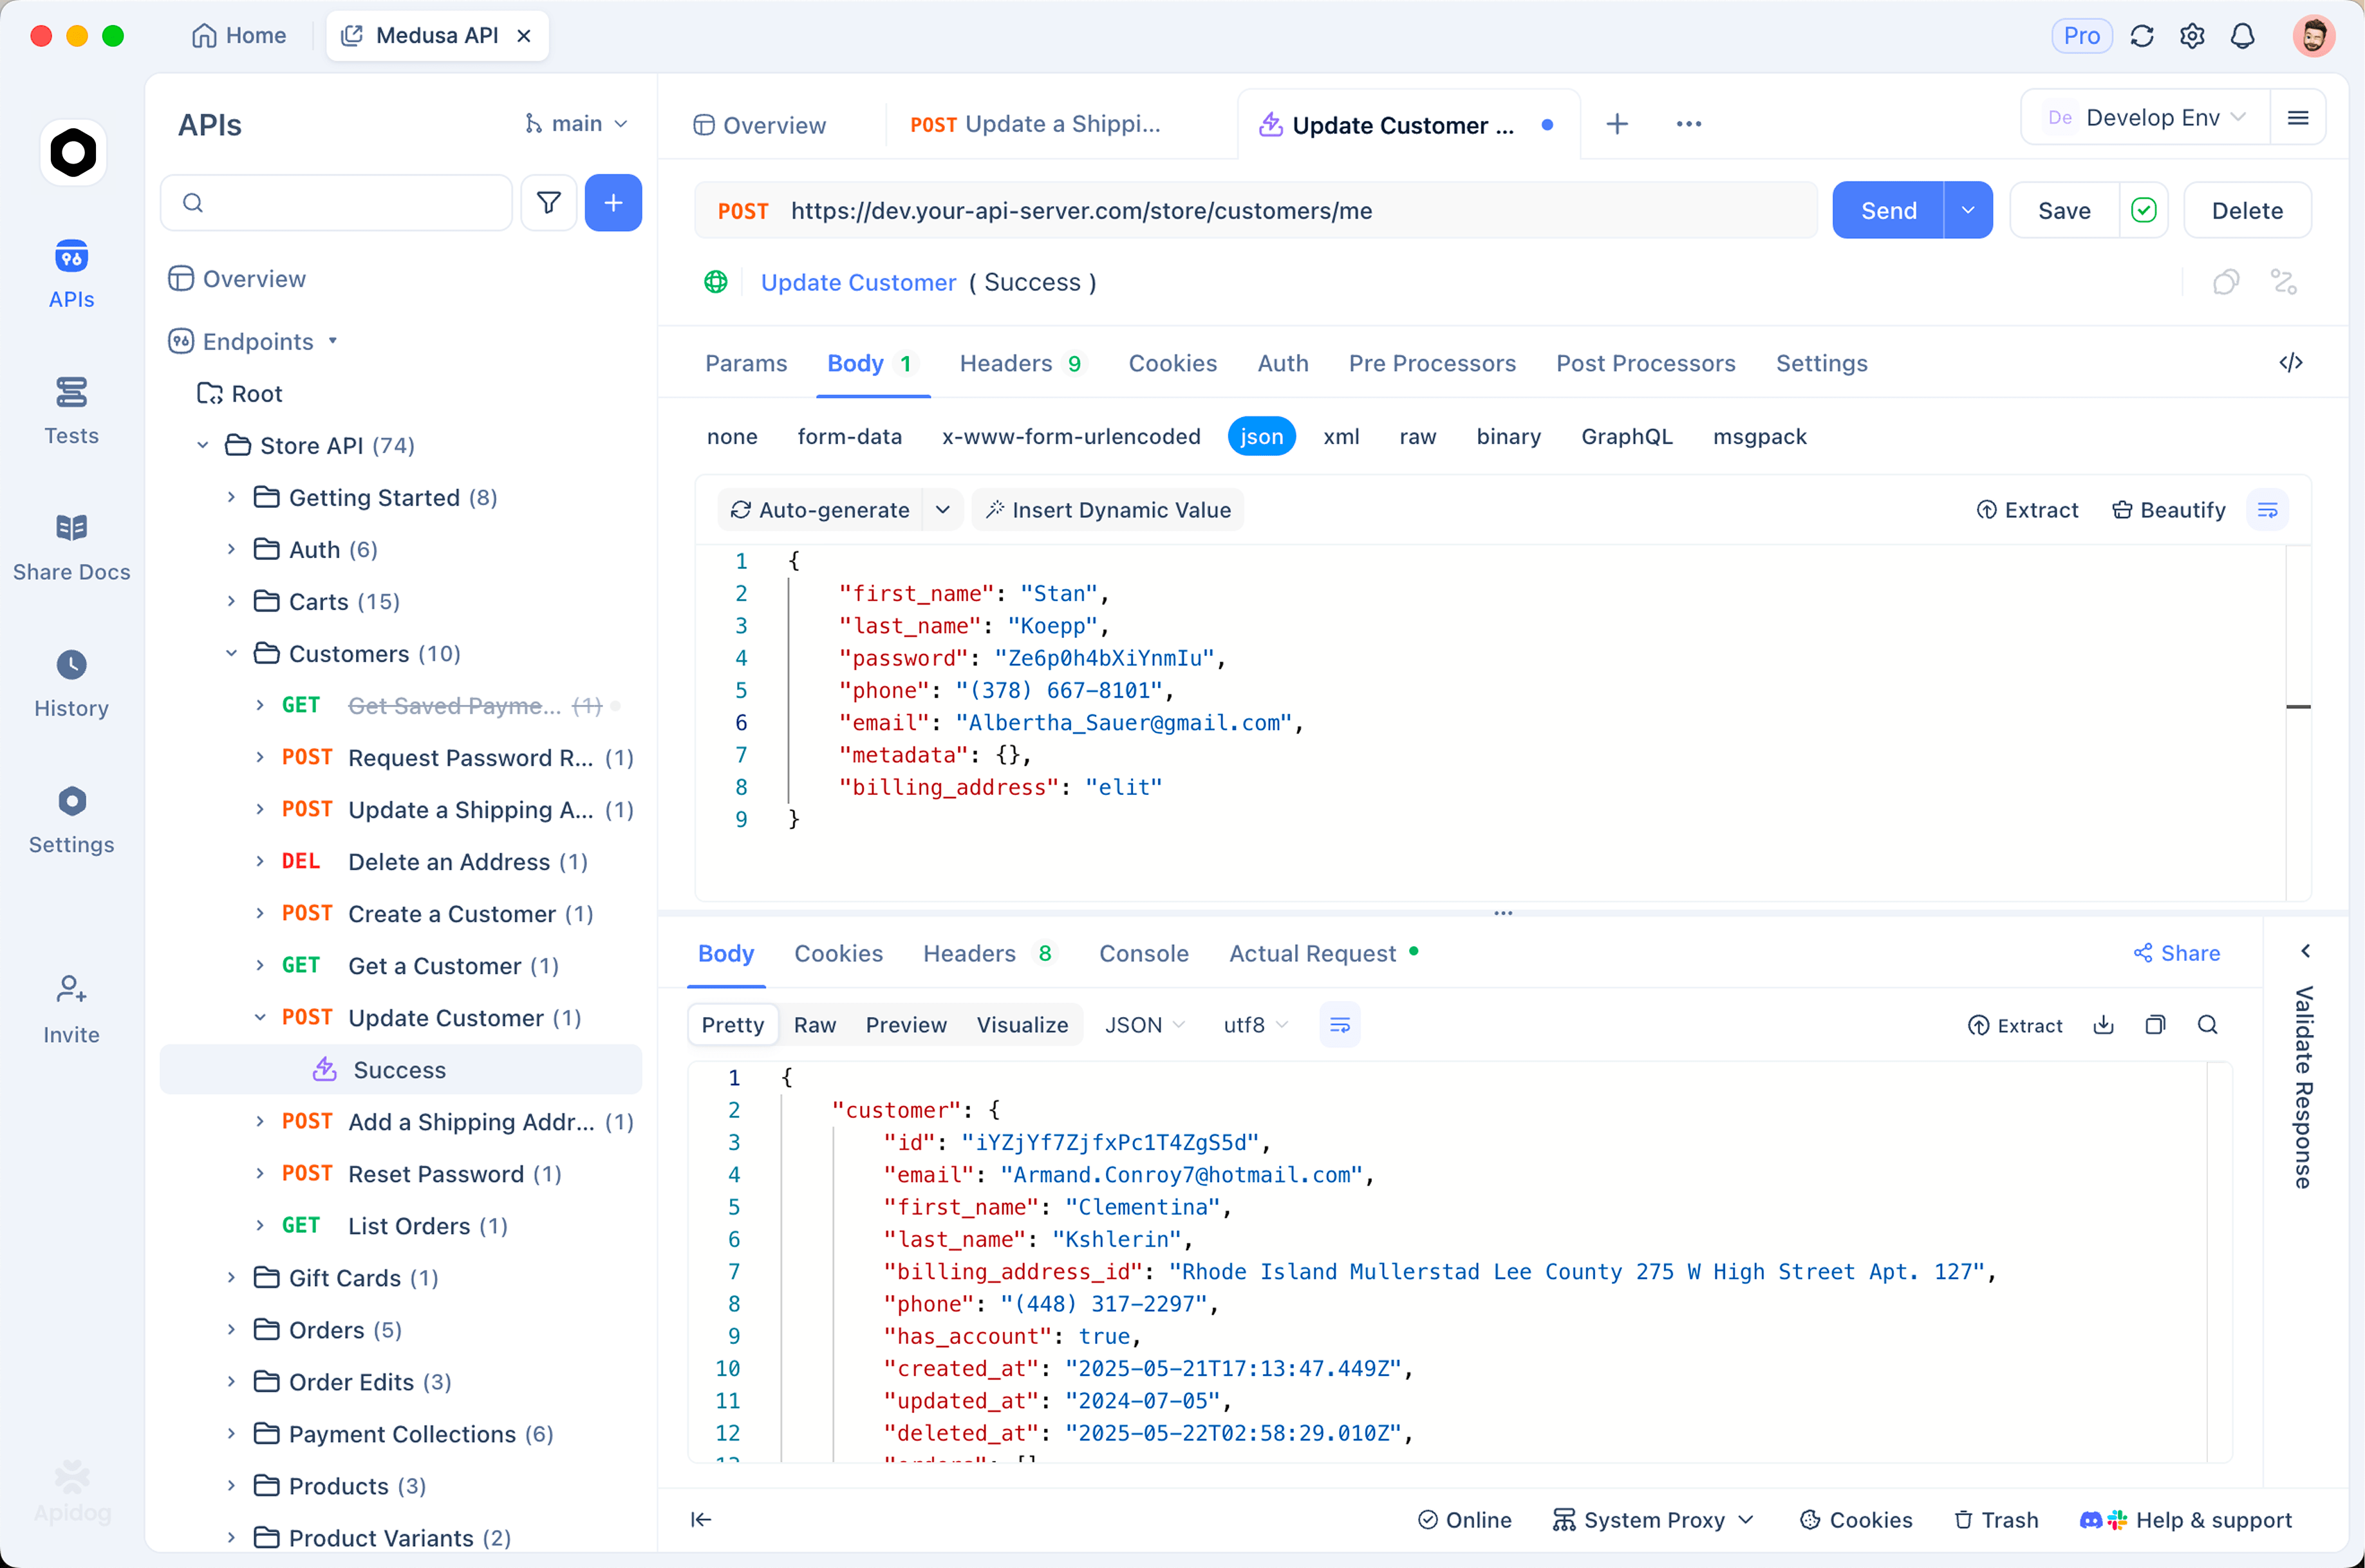
- Un proyecto, tres entornos. Crea entornos para xAI (`api.x.ai/v1`), OpenAI y Anthropic, cada uno con su propia autenticación. La misma solicitud cambia de proveedor con un solo menú desplegable.
- Recopila 20 prompts reales. Extrae tareas reales de tu producto, no preguntas de juguete. Incluye tu prompt de sistema, tus definiciones de herramientas si usas llamadas a funciones, y al menos cinco casos conocidos como difíciles.
- Afirma lo que te importa. Añade aserciones de Apidog para la validez de la respuesta, el uso de tokens del objeto `usage` y los umbrales de latencia. Para cargas de trabajo de llamadas a herramientas, asegura que el JSON de la llamada a la herramienta se analice y coincida con tu esquema; los modelos fallan aquí mucho más a menudo que en la prosa.
- Ejecuta como un escenario de prueba, tres veces por modelo. Las salidas de los LLM varían; tres ejecuciones exponen la varianza que una sola demostración oculta. Exporta los resultados y compara la tasa de éxito y el costo por éxito, no el costo por token.
- Mantén la suite. Cuando se lance la próxima versión del modelo (con la cadencia actual, en meses), vuelve a ejecutarla. La elección del modelo es ahora una decisión trimestral, y los equipos con un arnés de evaluación permanente cambian semanas más rápido que los equipos que vuelven a decidir por anécdotas.
Preguntas frecuentes
¿Es Grok 4.6 mejor que GPT-5.6 Sol? Empatan en el índice compuesto con 61. Sol lidera claramente la codificación a escala de repositorio (DeepSWE 73.0% vs 65.9%); Grok lidera CursorBench y Terminal-Bench y cuesta 5 veces menos en el extremo de salida. "Mejor" depende de si tu carga de trabajo se parece más a DeepSWE o a una sesión de IDE.
¿Es Grok 4.6 mejor que Claude Fable 5? Fable 5 lidera en el índice (62 vs 61), FrontierCode y APEX-Agents, todo por poco margen. La ventaja de Grok es el precio. Para trabajo autónomo crítico en precisión, Fable 5; para volumen sensible al costo, Grok.
¿Qué modelo de IA es el más barato en la frontera en 2026? Grok 4.6, a $2/$6 por millón de tokens y un costo medido independientemente de $0.84 por tarea de agente. Los tokens de salida del competidor fronterizo más cercano cuestan aproximadamente 4 veces más.
¿Debería cambiar mi agente de producción a Grok 4.6? No solo por los benchmarks. Primero, ejecuta la prueba de comparación anterior con tu carga de trabajo real; la brecha de precio de 5x solo vale la pena si la tasa de éxito se mantiene en tus tareas.
¿Puedo usar los tres modelos detrás de un único formato de API? En su mayoría sí. Grok 4.6 habla el formato de completado de chat de OpenAI de forma nativa, por lo que comparte código de cliente con GPT-5.6. Claude requiere la API de Mensajes de Anthropic, o una pasarela como OpenRouter que normaliza los tres detrás de una interfaz con un pequeño recargo.
¿Importa la ventana de contexto más pequeña de Grok 4.6? Para la mayoría de las cargas de trabajo de agentes y chat, no; 500K tokens está muy por encima del uso típico, y los tres modelos se degradan cerca de sus límites de todos modos. Importa si procesas rutinariamente monorepositorios enteros o conjuntos de documentos masivos en una sola llamada, donde la ventana de 1.05M de Sol ofrece un margen real.
botón