
El precio de GPT-Live-1.1 se basa en el tiempo, no en tokens. OpenAI factura la sesión de voz a $0.05 por minuto activo y $0.02 por minuto en espera, con cobro por segundo y sin redondeo al minuto siguiente. El modelo de backend y las llamadas a herramientas se facturan por separado a sus tarifas habituales. Una hora de conversación ininterrumpida cuesta $3.00 en cargos de voz; una hora en modo de espera cuesta $1.20.
La lista de tarifas es breve. Lo que importa es cómo se comporta en una aplicación real, donde los usuarios hacen pausas, los backends tardan en responder y las sesiones permanecen abiertas demasiado tiempo. A continuación encontrarás tres ejemplos prácticos y los ajustes que mantienen la factura bajo control.
Precios de GPT-Live-1.1 de un vistazo
GPT-Live-1.1 tiene dos tarifas de voz y una factura aparte para el backend. Esto es lo que indican la página del modelo GPT-Live-1.1 y la página de precios de OpenAI a fecha del 20 de noviembre de 2026:
>Búsqueda web, búsqueda de archivos, Code Interpreter y otras| Cargo | Tarifa | Por hora | Notas |
|---|---|---|---|
| Tiempo de sesión activo | $0.05 por minuto | $3.00 | Habla, silencio antes del tiempo de espera por inactividad, espera del trabajo del backend |
| Tiempo de sesión en espera | $0.02 por minuto | $1.20 | Solo WebRTC, mientras la inferencia está pausada |
| Modelo de backend Responses | Tarifas normales de tokens | Variable | El modelo que elijas para la delegación |
| Herramientas alojadas | Tarifas normales de herramientas | Variable |
Tres detalles importan más que las tarifas principales:
- Facturación por segundo. Una llamada de 90 segundos cuesta $0.075, no $0.10; la duración no se redondea al minuto completo.
- Mismo precio que GPT-Live-1. Ambos modelos comparten tarifas idénticas, así que actualizar no cambia la factura de voz.
- Un cargo inicial de 15 segundos. Crear una sesión WebRTC factura 15 segundos durante la inicialización, que se acreditan una vez que la sesión está en marcha. Solo cuesta más en las sesiones que creas y abandonas.
Para más contexto sobre las arquitecturas de voz, consulta GPT-Live vs GPT-Realtime.
Qué cuenta como minutos activos y qué como minutos en espera
Los minutos activos son todo el tiempo en que la inferencia está en ejecución. Los minutos en espera son el tiempo que una sesión WebRTC permanece conectada con la inferencia pausada, a la espera de voz. La diferencia de $0.03 por minuto entre ambos decide la mayor parte de tu factura de voz.
La guía de costes de OpenAI detalla qué entra en el apartado de tiempo activo:
- El tiempo en que el usuario o el modelo está hablando.
- El silencio antes de que expire tu tiempo de espera por inactividad.
- El tiempo de espera del trabajo del backend mientras la inferencia está en marcha.
Silenciar el micrófono no activa el modo de espera; la sesión sigue facturando a $0.05 por minuto.
El modo de espera requiere dos ajustes al crear la sesión, documentados en la guía de conversaciones en vivo:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" indica a la sesión que espere a detectar voz antes de iniciar la inferencia. idle_timeout_s acepta un número entero entre 5 y 60 y devuelve la sesión al modo de espera tras esa cantidad de segundos sin transcripciones de entrada o salida. Si omites el tiempo de espera, la inferencia permanece activa hasta que termine la sesión, por lo que nunca aplicará la tarifa de espera.
Dos advertencias: el modo de espera solo funciona con WebRTC, por lo que las sesiones WebSocket y SIP facturan cada segundo conectado a la tarifa activa, y la primera respuesta tras el modo de espera puede tardar más.
Ejemplos prácticos de costes
Las tarifas de voz son las publicadas; los recuentos de tokens del backend son suposiciones ilustrativas. Los precios del backend provienen de la página de precios de OpenAI: gpt-6-luna a $0.10 de entrada y $0.50 de salida por 1M de tokens, y gpt-6-sol a $2.00 de entrada y $10.00 de salida por 1M de tokens (nivel estándar, contexto corto). La guía de delegación de OpenAI sugiere empezar con gpt-6-luna y probar gpt-6-sol para tareas de backend más complejas.
Ejemplo 1: una línea de atención al cliente
Una llamada de soporte por teléfono o WebSocket dura 6 minutos. El modo de espera no aplica, por lo que los 6 minutos se facturan como activos. GPT-Live delega 4 consultas a gpt-6-luna, cada una con unos 6,000 tokens de entrada y 400 de salida.
| Concepto | Cálculo | Coste |
|---|---|---|
| Voz | 6 min x $0.05 | $0.30 |
| Entrada del backend | 24,000 tokens x $0.10 / 1M | $0.0024 |
| Salida del backend | 1,600 tokens x $0.50 / 1M | $0.0008 |
| Por llamada | $0.3032 |
Con 10,000 llamadas al mes, son unos $3,032, de los cuales $3,000 corresponden a tiempo de voz. Recortar 30 segundos de la llamada promedio ahorra más que toda la factura del backend.
Ejemplo 2: un tutor de idiomas en el navegador
Una sesión de tutoría WebRTC de 30 minutos con idle_timeout_s configurado en 15. El estudiante pasa largos ratos leyendo y pensando, así que la sesión funciona 18 minutos activos y 12 minutos en espera. El tutor delega 10 explicaciones a gpt-6-sol, con unos 8,000 tokens de entrada y 600 de salida cada una.
| Concepto | Cálculo | Coste |
|---|---|---|
| Voz activa | 18 min x $0.05 | $0.90 |
| Voz en espera | 12 min x $0.02 | $0.24 |
| Entrada del backend | 80,000 tokens x $2.00 / 1M | $0.16 |
| Salida del backend | 6,000 tokens x $10.00 / 1M | $0.06 |
| Por sesión | $1.36 |
Sin el modo de espera, los mismos 30 minutos de voz costarían $1.50 en lugar de $1.14, así que el modo de espera reduce la factura de voz un 24%.
Ejemplo 3: un asistente de escritorio siempre activo
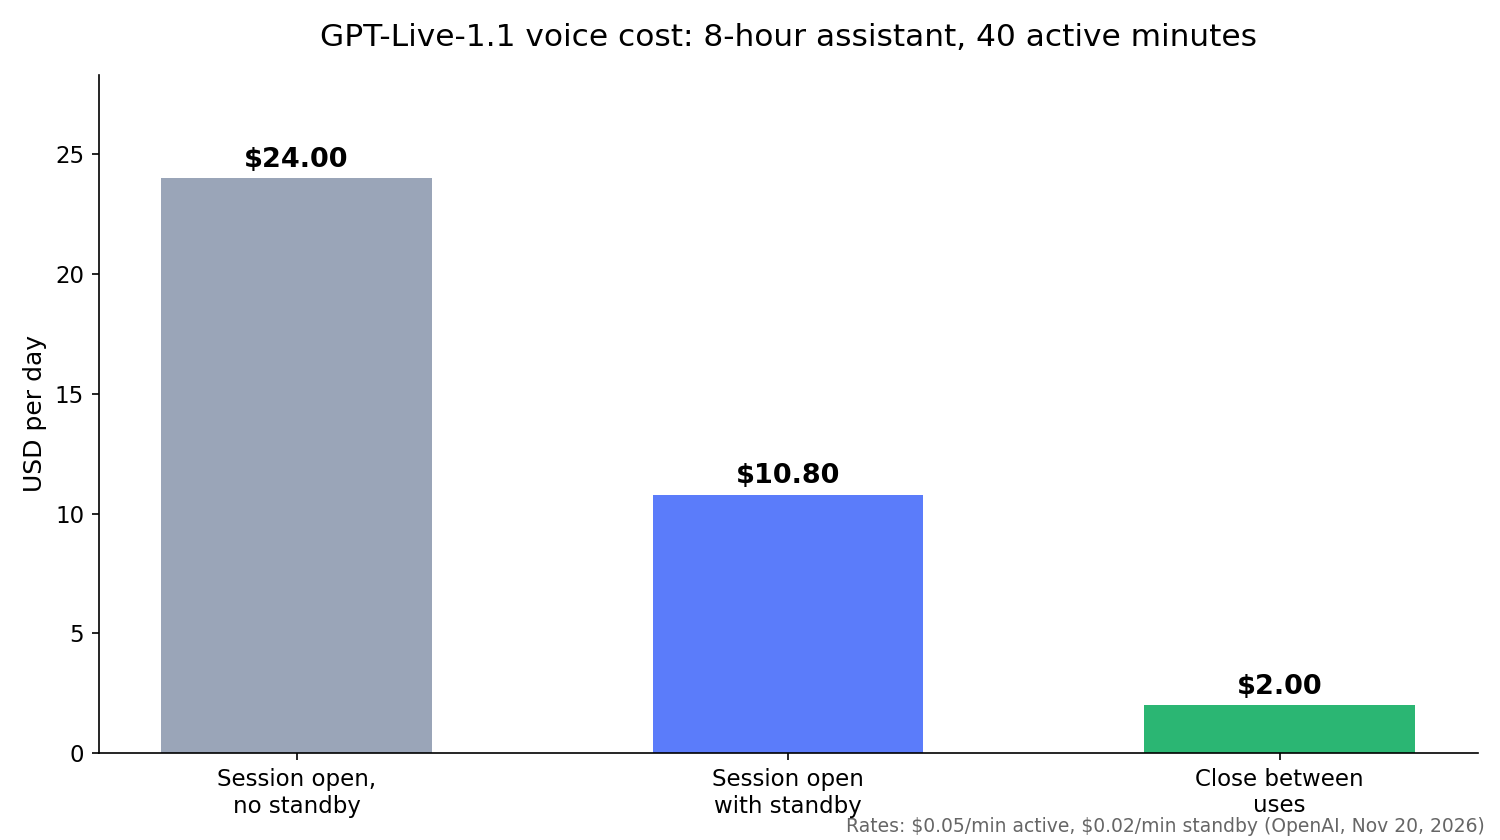
Un asistente permanece abierto durante una jornada laboral de 8 horas, pero el usuario solo le habla 40 minutos en ráfagas cortas. Aquí, la estrategia que elijas cambia la factura en más de 10 veces:
| Estrategia | Cálculo | Por día | Por mes de 22 días |
|---|---|---|---|
| Sesión abierta, sin modo de espera | 480 min x $0.05 | $24.00 | $528.00 |
| Sesión abierta con modo de espera | 40 x $0.05 + 440 x $0.02 | $10.80 | $237.60 |
| Cerrar entre usos | 40 min x $0.05 | $2.00 | $44.00 |
El modo de espera sigue costando $1.20 por hora inactiva. La guía de OpenAI recomienda cerrar la sesión durante los intervalos largos e iniciar una nueva, precargada con el historial guardado, cuando el usuario regrese. El cargo inicial de 15 segundos se acredita una vez que la nueva sesión está en marcha, así que solo en cargos de voz, cerrar sale ganando. La contrapartida es perder el despertar instantáneo: una sesión cerrada no puede escuchar al usuario, por lo que necesitas push-to-talk o tu propio mecanismo de activación.
Cómo afecta el tiempo de espera por inactividad a tu factura
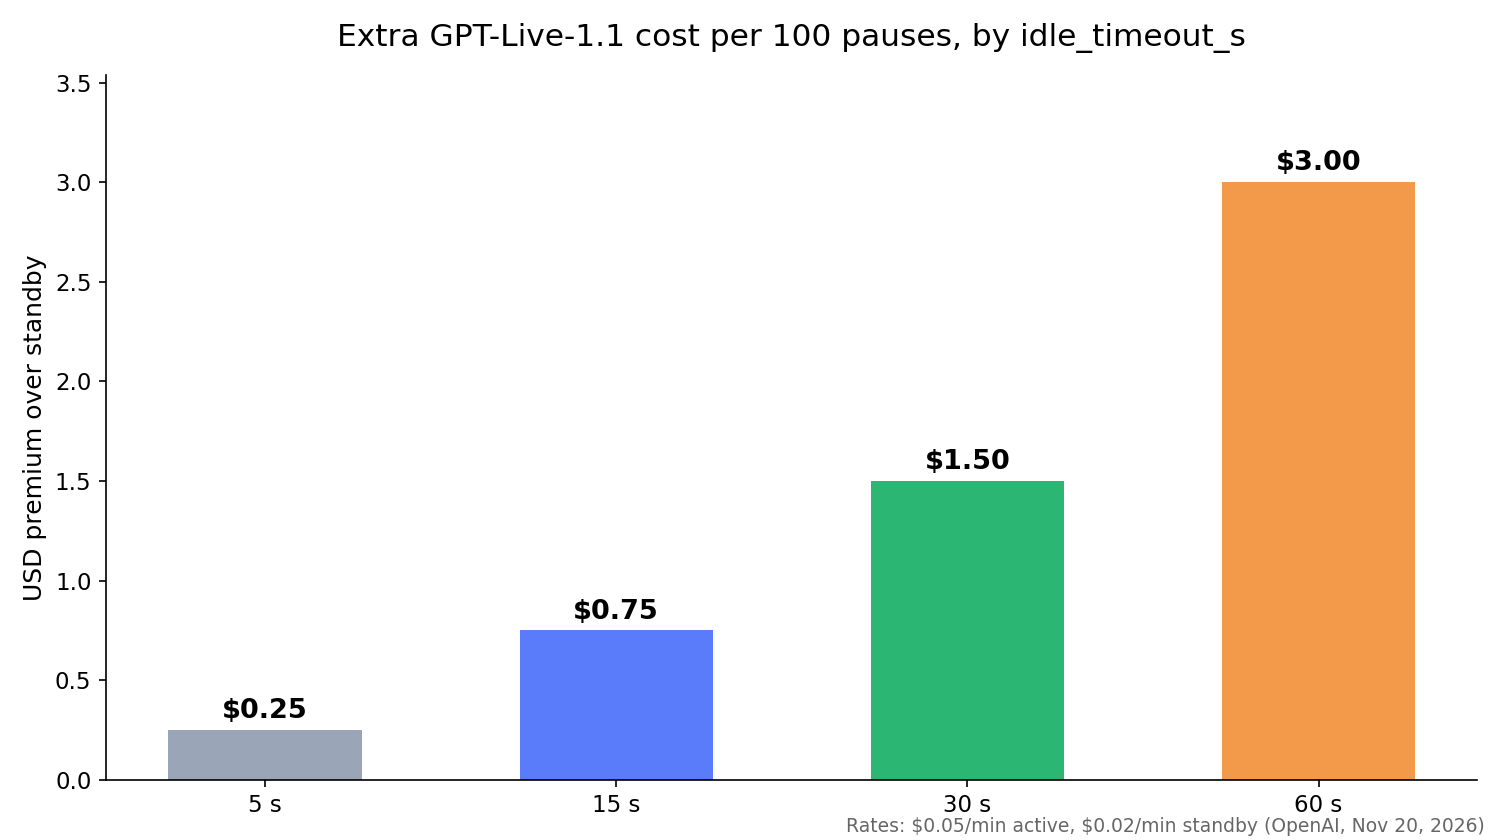
Cada pausa genera tiempo facturado como activo hasta que se activa el tiempo de espera por inactividad. Un tiempo de espera más corto llega antes a la tarifa más barata de modo de espera, a cambio de más ciclos de pausa y reanudación y una primera respuesta más lenta tras cada ciclo.
La prima por pausa es la duración del tiempo de espera facturada según la diferencia de $0.03 entre ambas tarifas. A lo largo de 100 pausas en una sesión o un día:
idle_timeout_s |
Segundos activos por pausa | Prima sobre el modo de espera, por 100 pausas |
|---|---|---|
| 5 | 5 | $0.25 |
| 15 | 15 | $0.75 |
| 30 | 30 | $1.50 |
| 60 | 60 | $3.00 |
Son cifras pequeñas, y ese es el punto: el tiempo de espera es principalmente un ajuste de experiencia de usuario. Elige un valor que no interrumpa a los usuarios a mitad de una idea, y deja que el modo de espera cubra las pausas largas y el cierre de sesión las muy largas.
Cómo se compara el precio de GPT-Live-1.1 con GPT-Realtime
GPT-Live-1.1 factura por minuto; los modelos GPT-Realtime facturan por token. La página de precios de OpenAI indica audio de gpt-realtime-2.1 a $32.00 por 1M de tokens de entrada y $64.00 por 1M de tokens de salida, y audio de gpt-realtime-2.1-mini a $10.00 y $20.00.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Unidad de facturación | Segundos de sesión | Tokens de entrada y salida |
| Tarifa de voz | $0.05/min activo, $0.02/min en espera | $32 / $64 por 1M de tokens de audio |
| Razonamiento y herramientas | Modelo de backend aparte | Dentro del mismo modelo |
| Curva de costes | Plana por minuto | Aumenta por turno a medida que crece el contexto |
La guía de costes de OpenAI señala que una sesión de Realtime envía toda la conversación al modelo en cada respuesta, por lo que los turnos posteriores cuestan más. Un minuto de GPT-Live cuesta lo mismo en el minuto 2 que en el 40, lo que simplifica las previsiones. Nuestra guía de la API de GPT-Realtime-2 cubre el funcionamiento basado en tokens.
Controla el consumo y evita facturas sorpresa
GPT-Live informa del consumo acumulado de voz en segundos mediante eventos session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Cada actualización reemplaza el total anterior, así que nunca los sumes. Envía session.close, espera a session.closed y registra el usage.seconds final. Para separar el tiempo activo del tiempo en espera, mide los intervalos entre los eventos session.paused y session.resumed.
Hábitos que mantienen los costes estables:
- Cierra las sesiones terminadas. Una sesión abierta y abandonada sigue facturando.
- Acelera el backend. Esperar una tarea delegada es tiempo activo; terminar un minuto antes ahorra $0.05.
- Cierra durante trabajos largos. Cierra la voz mientras el backend trabaja y reábrela cuando el resultado esté listo.
- Planifica la concurrencia. Los límites cuentan sesiones concurrentes, y GPT-Live-1.1 tiene un límite independiente del de GPT-Live-1, cuyos límites publicados son 50 (Build), 300 (Launch) y 500 (Grow). El nivel gratuito no es compatible.
Deja que Codex ponga a prueba tu registro de costes con Apidog CLI
Tu registro de consumo es código tuyo, y un error ahí calcula mal el precio de cada llamada. Ponlo a prueba en cada commit sin abrir una sesión de voz, con $0 en tiempo de voz, y deja que tu agente de programación ejecute las pruebas con Apidog CLI.
Instala la CLI, inicia sesión y añade la skill de Apidog a tu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a Codex un solo prompt:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
El agente lee el esquema, valida su payload, crea los casos y los ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Cambia -r cli,json por -r junit y la misma ejecución se integra en CI; consulta cómo ejecutar Apidog CLI en un pipeline de CI/CD. La guía de Apidog CLI en Codex cubre la configuración del agente. El plan gratuito de Apidog cubre equipos de hasta 4 usuarios.
FAQ
¿Cuánto cuesta GPT-Live-1.1 por minuto? $0.05 por minuto activo y $0.02 por minuto en espera, facturado por segundo. El uso del backend se cobra aparte.
¿GPT-Live-1.1 es más caro que GPT-Live-1? No. OpenAI ofrece ambos con las mismas tarifas activas y de espera.
¿El modo de espera funciona en llamadas telefónicas? No. La tarifa reducida de espera solo aplica a sesiones WebRTC mientras la inferencia está pausada. Las sesiones WebSocket y SIP facturan el tiempo conectado a la tarifa activa.
¿Las llamadas al modelo de backend están incluidas en el precio por minuto? No. Las llamadas delegadas a Responses se facturan según las tarifas de tokens del modelo elegido, más los cargos por herramientas.
¿Qué pasó con la cuestión de la API de GPT-Live de julio? En aquel entonces, GPT-Live era una función de voz de ChatGPT sin API, como señalaba en su momento nuestro artículo sobre la API de GPT-Live. GPT-Live-1.1 es el modelo con API, servido en v1/live/sessions.