
Usa GPT-Image-2.6 Flare para borradores, trabajos de gran volumen, pósteres e imágenes de producto. Usa Sunburst para los recursos finales y para ediciones repetidas con calidad medium o high. En la decisión entre GPT-Image-2.6 Flare y Sunburst, ambos modelos cuestan lo mismo por token, así que estás cambiando segundos por detalle, no dólares.
OpenAI lanzó ambos modelos el 4 de noviembre de 2026. Este artículo los compara en velocidad, calidad, consistencia de edición y costo, y luego te da una recomendación para cada caso de uso. No hemos ejecutado los dos modelos frente a frente con una clave activa, así que cada cifra a continuación indica su fuente, y la última sección muestra cómo medirlos con tus propios prompts.
Para conocer el lanzamiento completo, lee nuestra explicación de ChatGPT Images 2.6. Para el par anterior, consulta nuestra comparación de Flare vs Sunburst para la 2.5.
GPT-Image-2.6 Flare vs Sunburst de un vistazo
| Elemento | Flare | Sunburst |
|---|---|---|
| ID del modelo en la API | gpt-image-2.6-flare |
gpt-image-2.6-sunburst |
| El eslogan de OpenAI | Iteración rápida | Trabajo visual detallado |
| Velocidad publicada | Tan solo seis segundos con low |
Sin cifra |
| Fortaleza según OpenAI | Composición para pósteres e imágenes de producto | Calidad y consistencia de edición con medium o high |
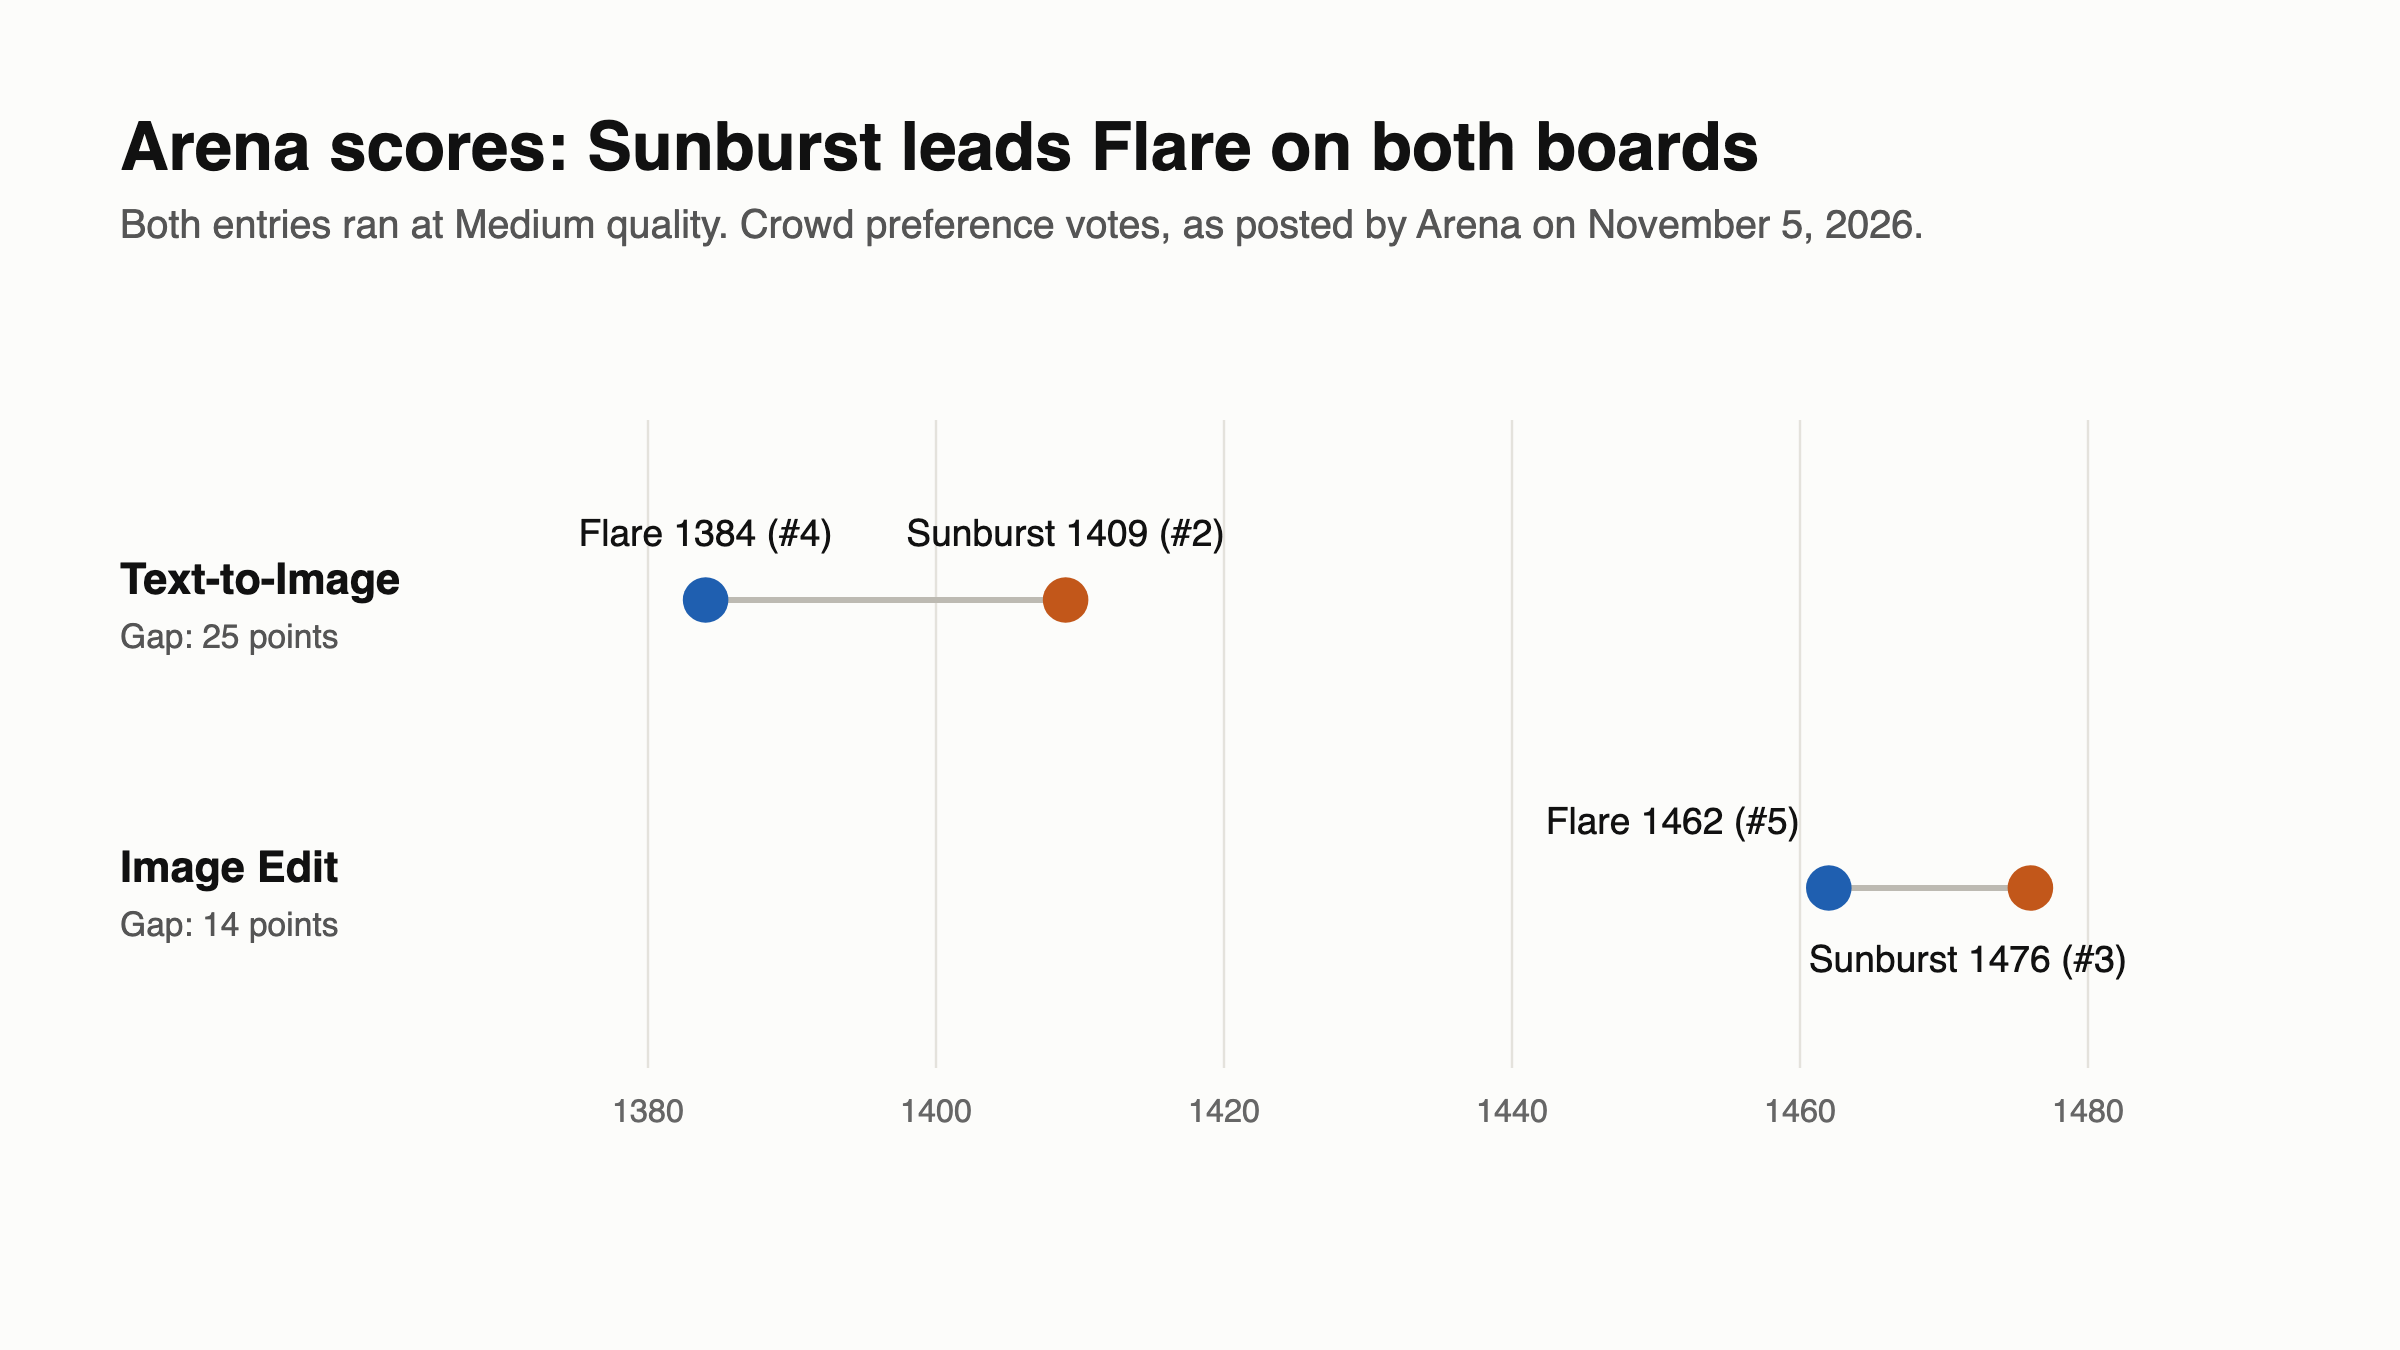
| Text-to-Image Arena (Medium) | #4, 1384 puntos | #2, 1409 puntos |
| Image Edit Arena (Medium) | #5, 1462 puntos | #3, 1476 puntos |
| Tarifa de salida de imagen | $30 por 1M de tokens | $30 por 1M de tokens |
complexity, markup, SVG, GIF |
Sí | Sí |
Las filas de características coinciden. La guía de generación de imágenes de OpenAI indica que ambos modelos admiten control de complejidad, ediciones guiadas por markup, salida SVG y salida GIF animado. No renuncias a ninguna capacidad con ninguno de los dos.
Velocidad: gana Flare, pero la diferencia no está publicada
Flare es el modelo más rápido. La publicación de lanzamiento de OpenAI dice que puede generar una imagen en tan solo seis segundos con calidad low, y que Images 2.6 se ejecuta un 50 % más rápido que antes. No da ningún tiempo para Sunburst, y las páginas de modelo de Flare y Sunburst indican la velocidad como «Not specified» (no especificada).
Lee esa cifra de seis segundos con cuidado:
- Es un caso óptimo («tan solo»), no un promedio.
- Solo aplica a la calidad
low. - OpenAI no dice qué ajuste de
complexityla produjo, y la API usahighpor defecto.
Aún no encontramos ningún tiempo independiente para la 2.6. La evidencia más cercana proviene del par 2.5, así que tómala como una guía aproximada:
| Prueba (modelos 2.5) | Flare | Sunburst | Sunburst tarda |
|---|---|---|---|
| Pixmax, render de 2048x1152 emparejado | 19,7 s | 27,7 s | 1,4 veces más |
| PoYo, mediana de un benchmark de 12 solicitudes | 30,89 s | 35,06 s | 1,1 veces más |
Ambas pruebas sitúan a Flare por delante, pero no coinciden en cuánto. La diferencia depende de tu prompt y tus ajustes, así que un solo benchmark no lo resolverá para tu carga de trabajo. La guía de OpenAI también advierte que los prompts complejos pueden tardar hasta dos minutos en los modelos GPT Image, así que configura un timeout de cliente generoso con cualquiera de los dos.
Calidad: Sunburst lidera, por poco
Sunburst obtiene mejores puntuaciones en las dos clasificaciones de Arena que Arena publicó el 5 de noviembre, y se llevó el primer puesto en la categoría de Cartoon, Anime y Fantasy. Flare sigue estando entre los cinco primeros en ambas tablas.
Ten en cuenta tres límites al leer esas puntuaciones:
- Son votos de preferencia del público, no un benchmark de OpenAI.
- Ambas entradas se ejecutaron en Medium, así que no dicen nada sobre
lowomax. - Las puntuaciones de Arena cambian a medida que llegan votos. Las leímos de la publicación de Arena, no del tablero en vivo.
Una ventaja de 25 puntos en Text-to-Image significa que los votantes tendieron a preferir la salida de Sunburst. No significa que las imágenes de Flare sean malas. En un póster o una foto de producto, la promesa de composición que OpenAI hace para Flare puede importarte más que una puntuación de preferencia general, así que prueba esa categoría tú mismo.
Consistencia de edición: la principal promesa de Sunburst
La consistencia de edición es la razón por la que pagarías la espera extra de Sunburst. OpenAI dice que aporta «una consistencia de imagen aún mayor entre ediciones» con calidad medium o high, lo que ayuda cuando un personaje, producto o logotipo tiene que sobrevivir a varias rondas de cambios.
Aquí hay menos pruebas públicas de las que cabría esperar:
- OpenAI no publica ninguna métrica de consistencia.
- La tarjeta del sistema dice que ambos modelos actualizados mejoran la consistencia de edición y la preservación del detalle, así que Flare también gana.
- La diferencia de Arena en Image Edit es de 14 puntos, menor que los 25 puntos de Text-to-Image. Esa tabla puntúa qué edición prefirieron los votantes, no si un sujeto se mantuvo estable a lo largo de cinco rondas.
Así que Sunburst es la opción predeterminada más segura para ediciones de varias rondas, pero solo tu propia cadena de ediciones puede confirmar que vale la pena el tiempo. Para un cambio único y concreto, como cambiar un fondo o corregir un cartel, prueba Flare primero.
Elijas el modelo que elijas, configura complexity tú mismo. Si lo omites, ambos modelos usan high, mientras que OpenAI recomienda low para la mayoría de las ediciones. Su guía advierte que una mayor complejidad puede añadir latencia e introducir cambios no deseados, justo lo contrario de lo que necesita un flujo de trabajo de edición.
Costo: el mismo precio, así que la calidad es la verdadera palanca
Flare y Sunburst cuestan lo mismo. La página de precios lista ambos a $8 por 1M de tokens de entrada de imagen, $2 en caché y $30 de salida. La calculadora de OpenAI también los trata como una sola entrada, «GPT Image 2.6 (Sunburst and Flare)», así que la estimación de salida a continuación aplica a cualquiera de los dos modelos.
quality (1024x1024) |
Tokens de salida | Costo por imagen | Costo por 1.000 |
|---|---|---|---|
low |
823 | $0,02469 | $24,69 |
medium |
1.449 | $0,04347 | $43,47 |
high |
1.756 | $0,05268 | $52,68 |
xhigh |
3.122 | $0,09366 | $93,66 |
max |
7.024 | $0,21072 | $210,72 |
Estas cifras excluyen los tokens de entrada de texto e imagen, y una edición factura su imagen de referencia aparte. La calculadora señala que el uso de tokens puede variar, así que lee usage.output_tokens de las respuestas reales.
De esa tabla se derivan dos cosas:
- Pasar de Flare a Sunburst cambia tu tiempo, no tu tarifa. Elegir
highen lugar delowduplica aproximadamente tu costo de salida con cualquiera de los dos modelos. - De
mediumahighcuesta alrededor de un centavo más por imagen cuadrada. Como OpenAI vincula las mejoras de Sunburst a ambos niveles, compáralos antes de decidirte pormedium.
Batch es el único punto a tener en cuenta en el costo. El 5 de noviembre, la pestaña Batch de la página de precios listaba la 2.5 a mitad de precio, pero no listaba ninguno de los modelos 2.6. Si ejecutas trabajos nocturnos con el par 2.5, revisa esa pestaña antes de cambiar.
¿Qué modelo deberías usar?
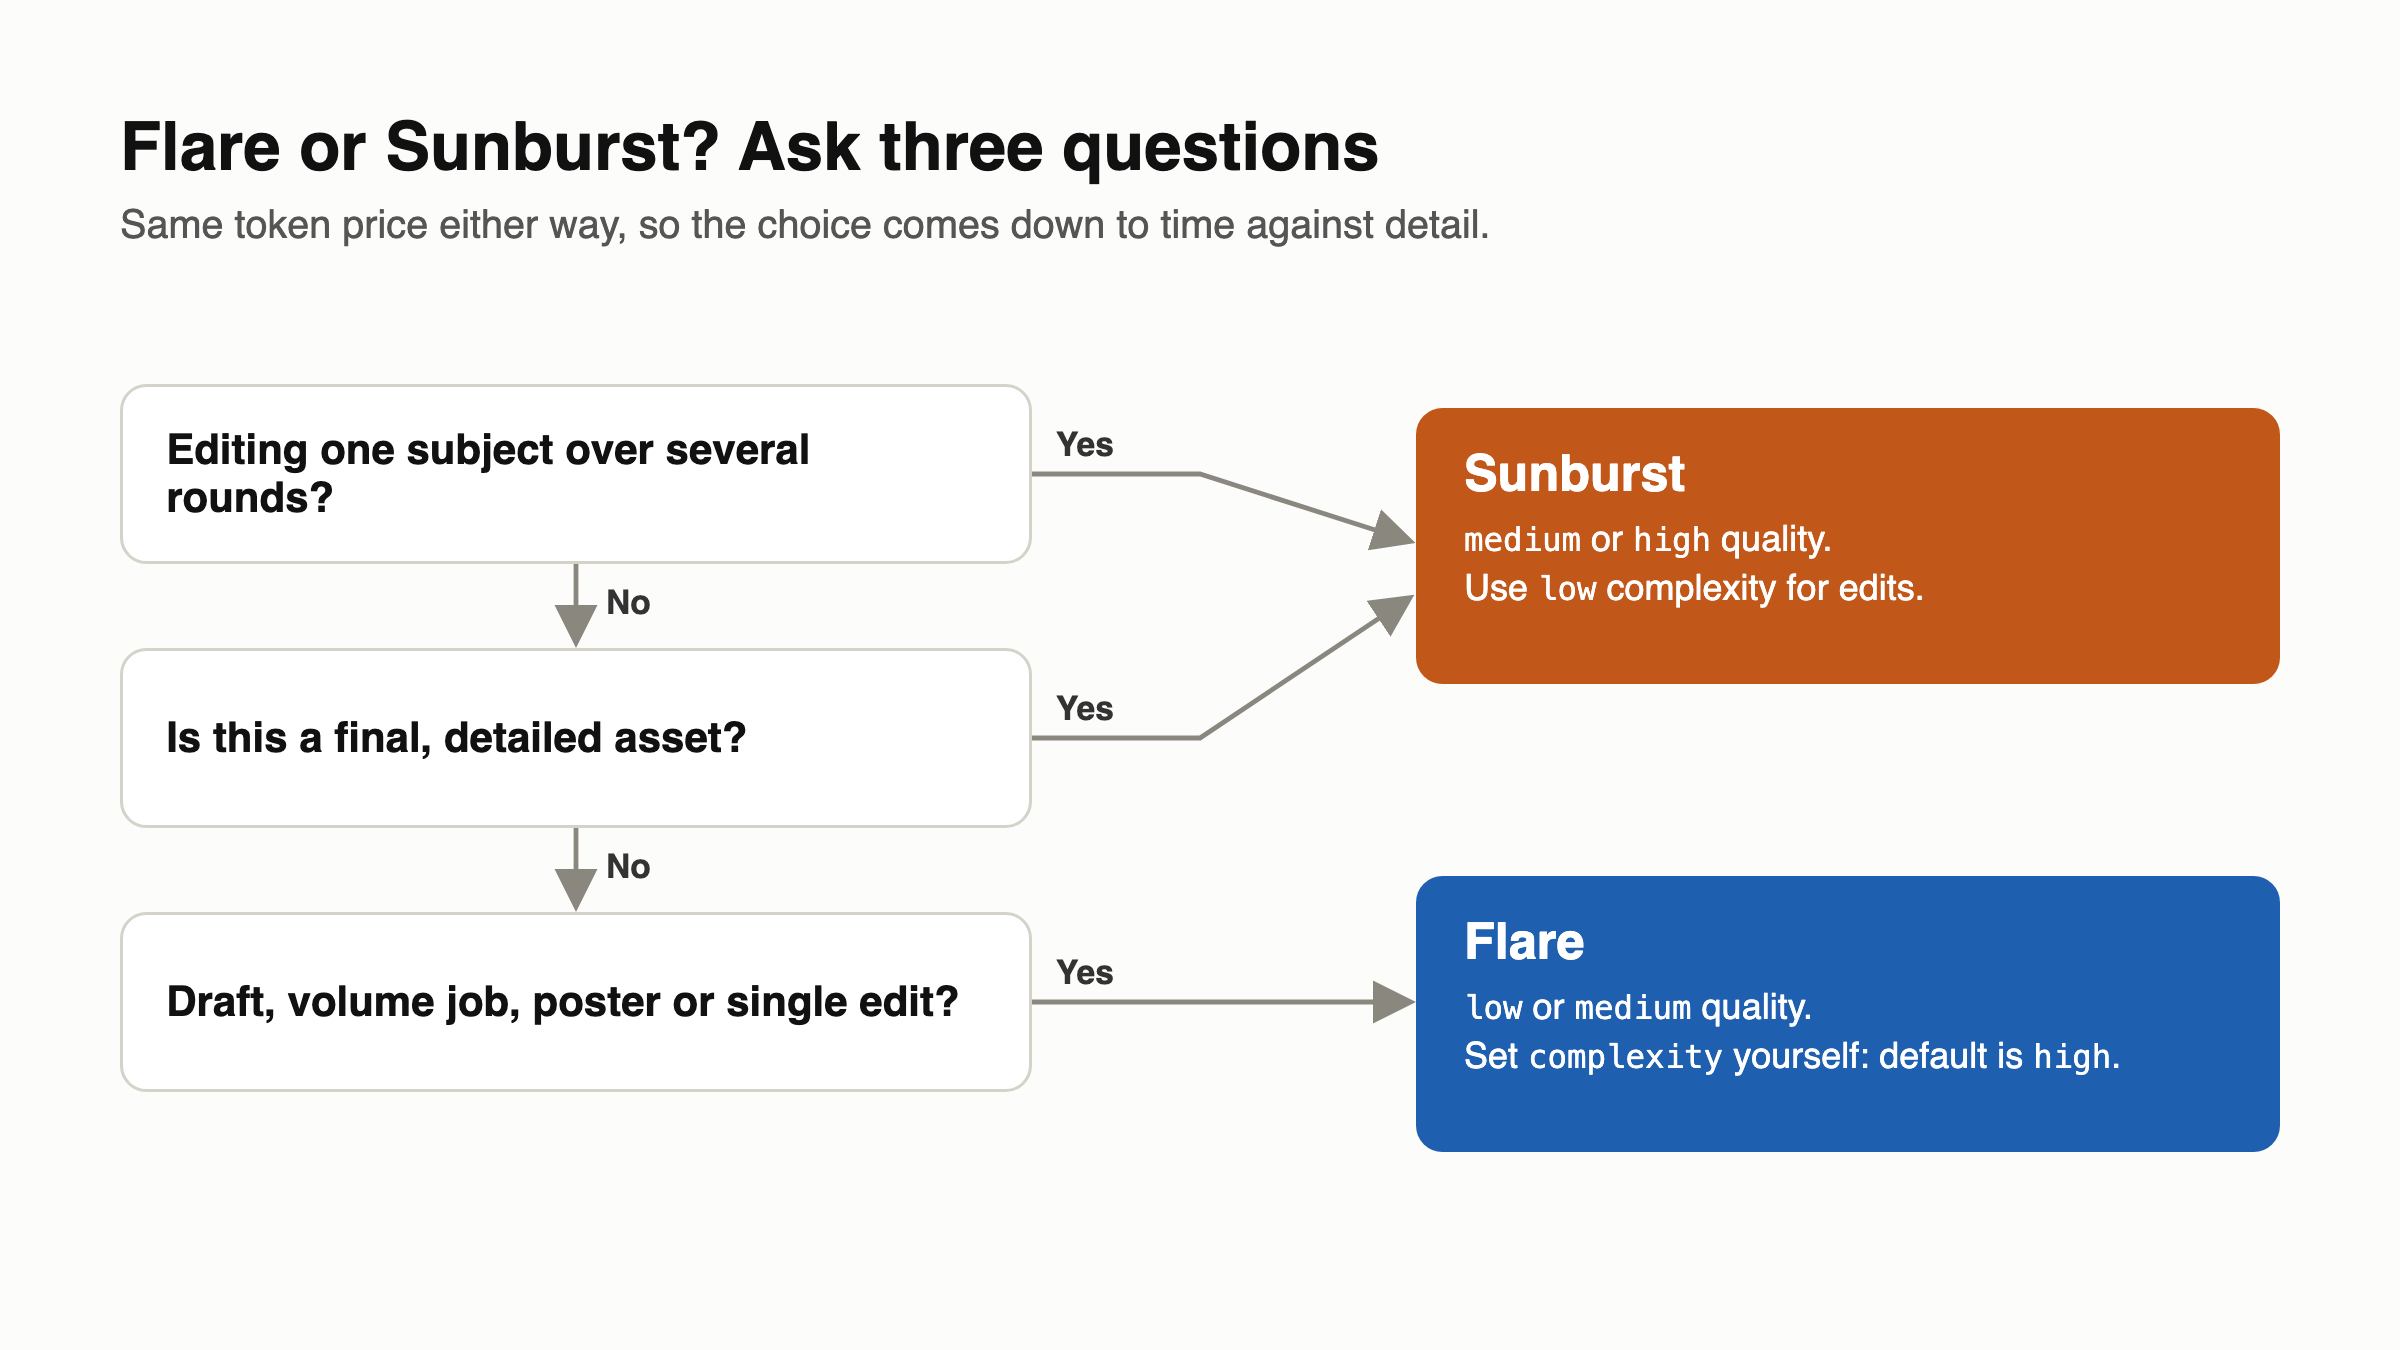
Usa Flare por defecto y luego pasa un trabajo a Sunburst cuando puedas ver la diferencia. Estos ajustes iniciales son nuestras sugerencias, no las de OpenAI, así que ajústalos después de tus primeras pruebas.
| Caso de uso | Elección | quality |
complexity |
|---|---|---|---|
| Borradores conceptuales e iteración rápida | Flare | low |
low |
| Trabajos de imágenes de gran volumen | Flare | low o medium |
low |
| Pósteres e imágenes de producto | Flare | medium |
medium |
| Una edición concreta | Flare | medium |
low |
| Ediciones repetidas sobre un mismo sujeto | Sunburst | medium o high |
low |
| Imágenes finales destacadas y de campaña | Sunburst | high |
medium |
| Arte de cartoon, anime y fantasía | Sunburst | medium |
medium |
| Texto denso, muchos elementos con restricciones | Sunburst | high |
high |
Para GIF y SVG, OpenAI no publica ninguna diferencia de calidad o velocidad entre los modelos. Haz el borrador con Flare y luego vuelve a ejecutar tu mejor prompt con Sunburst y compara. Revisa primero dos detalles de los GIF: la guía de OpenAI permite de 2 a 64 fotogramas, mientras que su referencia de la API dice de 2 a 16, y la referencia indica que la salida GIF requiere acceso de vista previa para el modelo seleccionado.
Si fijas modelos en producción, ten en cuenta que ambas páginas de modelo muestran solo el alias el 5 de noviembre, sin una instantánea con fecha. Vuelve a comprobar tus prompts aprobados cuando OpenAI actualice un modelo.
Compara ambos modelos con Apidog CLI
Las puntuaciones públicas no pueden decirte cómo maneja cada modelo tus prompts. Tu agente de programación puede ejecutar el mismo conjunto de prompts con ambos modelos usando Apidog CLI y comparar los tiempos de respuesta. Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Guarda cinco prompts de tu carga de trabajo real en prompts.csv, con prompt como encabezado. Luego dale a Claude Code, Codex o Cursor un prompt:
In Apidog project <id>, add POST https://api.openai.com/v1/images/generations
with a bearer token from ah-96595b54133dd71b741cc9d4907506e2b3a06f289e0016f9de2d7fb43e327968. Create a test case that sends
model {{MODEL}}, prompt {{prompt}}, quality medium, complexity low and size
1024x1024. Assert status 200 and that data[0].b64_json exists.
Run it with prompts.csv once per model, gpt-image-2.6-flare and
gpt-image-2.6-sunburst, then compare the timings in the two JSON reports.
El agente lee cada esquema, valida su payload, crea el caso y luego lo ejecuta dos veces:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv \
  --env-var "MODEL=gpt-image-2.6-flare" \
  --env-var "OPENAI_API_KEY=$OPENAI_API_KEY" \
  --timeout-request 180000 --on-error continue -r cli,json --out-file flare
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv \
  --env-var "MODEL=gpt-image-2.6-sunburst" \
  --env-var "OPENAI_API_KEY=$OPENAI_API_KEY" \
  --timeout-request 180000 --on-error continue -r cli,json --out-file sunburst
Cada informe JSON almacena milisegundos bajo result.timings, en responseAverage, responseMin, responseMax y responseSd. Tu agente puede ponerlos uno al lado del otro y decirte la diferencia real con tus prompts. Diez imágenes en medium cuestan unos $0,43 en tokens de salida, más la entrada.
Construimos este flujo a partir de apidog --help y los esquemas de la CLI, y no lo hemos ejecutado contra OpenAI, así que revisa el primer informe antes de confiar en él. Apidog mide la velocidad y la corrección de la respuesta, no la calidad de la imagen, así que los píxeles los sigues juzgando tú. Para seguir midiendo el par después de cada actualización de modelo, mueve la ejecución a un pipeline de CI, y consulta la guía de configuración en Claude Code para más detalles sobre el agente.
Preguntas frecuentes
¿Es mejor Flare o Sunburst? Ninguno gana en todo. Sunburst se clasifica más alto en las tablas de Text-to-Image e Image Edit de Arena, y OpenAI lo orienta al trabajo detallado. Flare está hecho para la velocidad. Empieza con Flare y pasa a Sunburst cuando puedas ver una mejora.
¿Cuesta más Sunburst que Flare? No. Ambos listan $8 de entrada de imagen, $2 en caché y $30 de salida por 1M de tokens, y comparten una sola entrada en la calculadora. Tu ajuste de calidad cambia la factura, no tu elección de modelo.
¿Cuánto más rápido es Flare que Sunburst? OpenAI no lo ha dicho. Solo da el caso óptimo de Flare, seis segundos con low. Dos pruebas independientes del par 2.5 mostraron que Sunburst tardaba entre 1,1 y 1,4 veces más, pero esos resultados pueden no trasladarse a la 2.6.
¿Qué modelo es mejor para editar? Usa Sunburst para ediciones repetidas sobre un mismo sujeto, con calidad medium o high. Prueba Flare para un cambio único y concreto. Configura complexity en low en ambos, ya que el valor por defecto es high.
¿Pueden ambos modelos crear GIF y SVG? Sí. La guía de OpenAI lista la salida GIF y SVG para ambos modelos en POST /v1/images/generations. El endpoint de ediciones no puede devolver ninguno de los dos formatos.
¿Debería seguir usando GPT-Image-2.5? Revisa primero Batch. La pestaña Batch listaba la 2.5 a mitad de precio el 5 de noviembre, pero no listaba la 2.6. La calculadora de OpenAI también muestra que la 2.6 usa más tokens con low y medium, así que los trabajos de gran volumen en low pueden costar menos con la 2.5.