
OpenAI lanzó ChatGPT Images 2.5 el 8 de septiembre de 2026, con dos modelos de API: gpt-image-2.5-flare y gpt-image-2.5-sunburst. Ambos se facturan a las mismas tarifas por token que gpt-image-2, y ambos comparten una única entrada en la calculadora de precios de OpenAI. Por lo tanto, la tabla por token no te ayudará a elegir. Lo que cambió es la escala de calidad subyacente, y el nuevo etiquetado mueve el precio de una imagen con quality: "high" en aproximadamente 4x.
Esta es la página de decisión: tarifas por token, estimaciones por imagen para los cinco niveles de calidad 2.5 junto a los números de gpt-image-2, la reasignación de etiquetas, un presupuesto mensual de 10.000 imágenes, el rumor de "precio 2x" y una lista de verificación de migración. Si deseas la sintaxis de la solicitud primero, lee cómo usar la API de gpt-image-2.5. La página de precios de OpenAI es la fuente de cada tarifa a continuación. Cada cifra por imagen es una estimación de la calculadora, ya que OpenAI advierte que el consumo de tokens "puede diferir según el modelo y la configuración de calidad"; tu factura proviene de usage.output_tokens en la respuesta.
Tarifas por token: idénticas en los tres
La página de precios de OpenAI enumera las mismas tarifas de nivel estándar para ambos modelos 2.5, y la página de cada modelo indica que sus "tarifas de tokens coinciden con GPT Image 2". Aquí está la tabla completa, incluida la fila Batch que causó confusión en el lanzamiento.
| Modelo | Entrada de imagen | Entrada de imagen en caché | Salida de imagen | Entrada de texto | Entrada de texto en caché |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-flare |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Standard) |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Batch, 50% off) |
$4.00 | $1.00 | $15.00 | $2.50 | $0.625 |
Todas las cifras son por 1 millón de tokens. La salida es solo de imagen en todos los modelos aquí, por lo que la salida de texto nunca aparece en una factura.
Sobre la afirmación de "precios 2x" en algunas coberturas tempranas: provino de comparar la fila 2.5 Estándar con la fila gpt-image-2 Batch, que es un descuento del 50%. Compara Estándar con Estándar en la página de precios y cada tarifa no ha cambiado.
Lo que cuesta cada imagen en cada nivel de calidad
La paridad por token es donde termina la similitud. La calculadora de OpenAI (consultada el 09-09-2026) informa estos recuentos de tokens de salida de imagen bajo una entrada compartida, "GPT Image 2.5 (Sunburst and Flare)". El costo es tokens multiplicados por $30 por 1 millón, solo tokens de salida.
| Calidad | Tokens 1024x1024 | Costo 1024x1024 | Tokens 1536x1024 | Costo 1536x1024 |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Aquí está la tabla de gpt-image-2 de la misma página de documentación, para los mismos tamaños.
| Calidad | 1024x1024 | 1536x1024 (y 1024x1536) |
|---|---|---|
| low | $0.006 | $0.005 |
| medium | $0.053 | $0.041 |
| high | $0.211 | $0.165 |
Dos cosas destacan. El tamaño horizontal es más barato que el cuadrado en cada fila, un patrón que la documentación de OpenAI destaca. Y la fila high de 2.5 no se acerca a la fila high de gpt-image-2. Esa es la reetiquetación.
El texto del prompt y las imágenes de referencia se facturan adicionalmente. Una imagen de referencia enviada a images/edits cuesta tokens de entrada de imagen a $8 por 1 millón; OpenAI no publica el recuento de tokens de entrada por imagen, así que léelo de usage.input_tokens.
La escala de calidad fue reetiquetada
Compara los presupuestos de tokens y el mapeo es claro. En 2.5, high son 1.756 tokens de salida, el presupuesto que gpt-image-2 gastaba en medium. En 2.5, max son 7.024 tokens, el presupuesto que gpt-image-2 gastaba en high. low no ha cambiado con 196 tokens.
| Etiqueta 2.5 | Tokens (1024x1024) | Costo 2.5 | Mismo presupuesto en gpt-image-2 | Costo gpt-image-2 |
|---|---|---|---|---|
| low | 196 | $0.00588 | low | $0.006 |
| medium | 439 | $0.01317 | ninguno (por debajo del antiguo medium) | n/d |
| high | 1,756 | $0.05268 | medium | $0.053 |
| xhigh | 3,122 | $0.09366 | ninguno (entre el antiguo medium y el antiguo high) | n/d |
| max | 7,024 | $0.21072 | high | $0.211 |
Así, una migración que mantiene quality: "high" se vuelve aproximadamente 4 veces más barata por imagen y se renderiza con el presupuesto del antiguo medium. Una que quiera el presupuesto del antiguo high debe pasar a max, con un precio efectivamente igual al anterior. xhigh es un nuevo escalón intermedio sin equivalente en gpt-image-2.
El cálculo mensual, derivado de las estimaciones de la calculadora de OpenAI en 1024x1024:
- 10.000 imágenes con 2.5
high: 10.000 x $0.05268 = $526.80 - 10.000 imágenes con gpt-image-2
high: 10.000 x $0.211 = $2.110 - 10.000 imágenes con 2.5
max: 10.000 x $0.21072 = $2.107.20, efectivamente lo mismo que el antiguohigh - La transmisión con
partial_images: 3añade 300 tokens, o $0.009 por imagen, ya que cada parcial cuesta 100 tokens de salida de imagen
Flare vs Sunburst: qué ofrece el premium
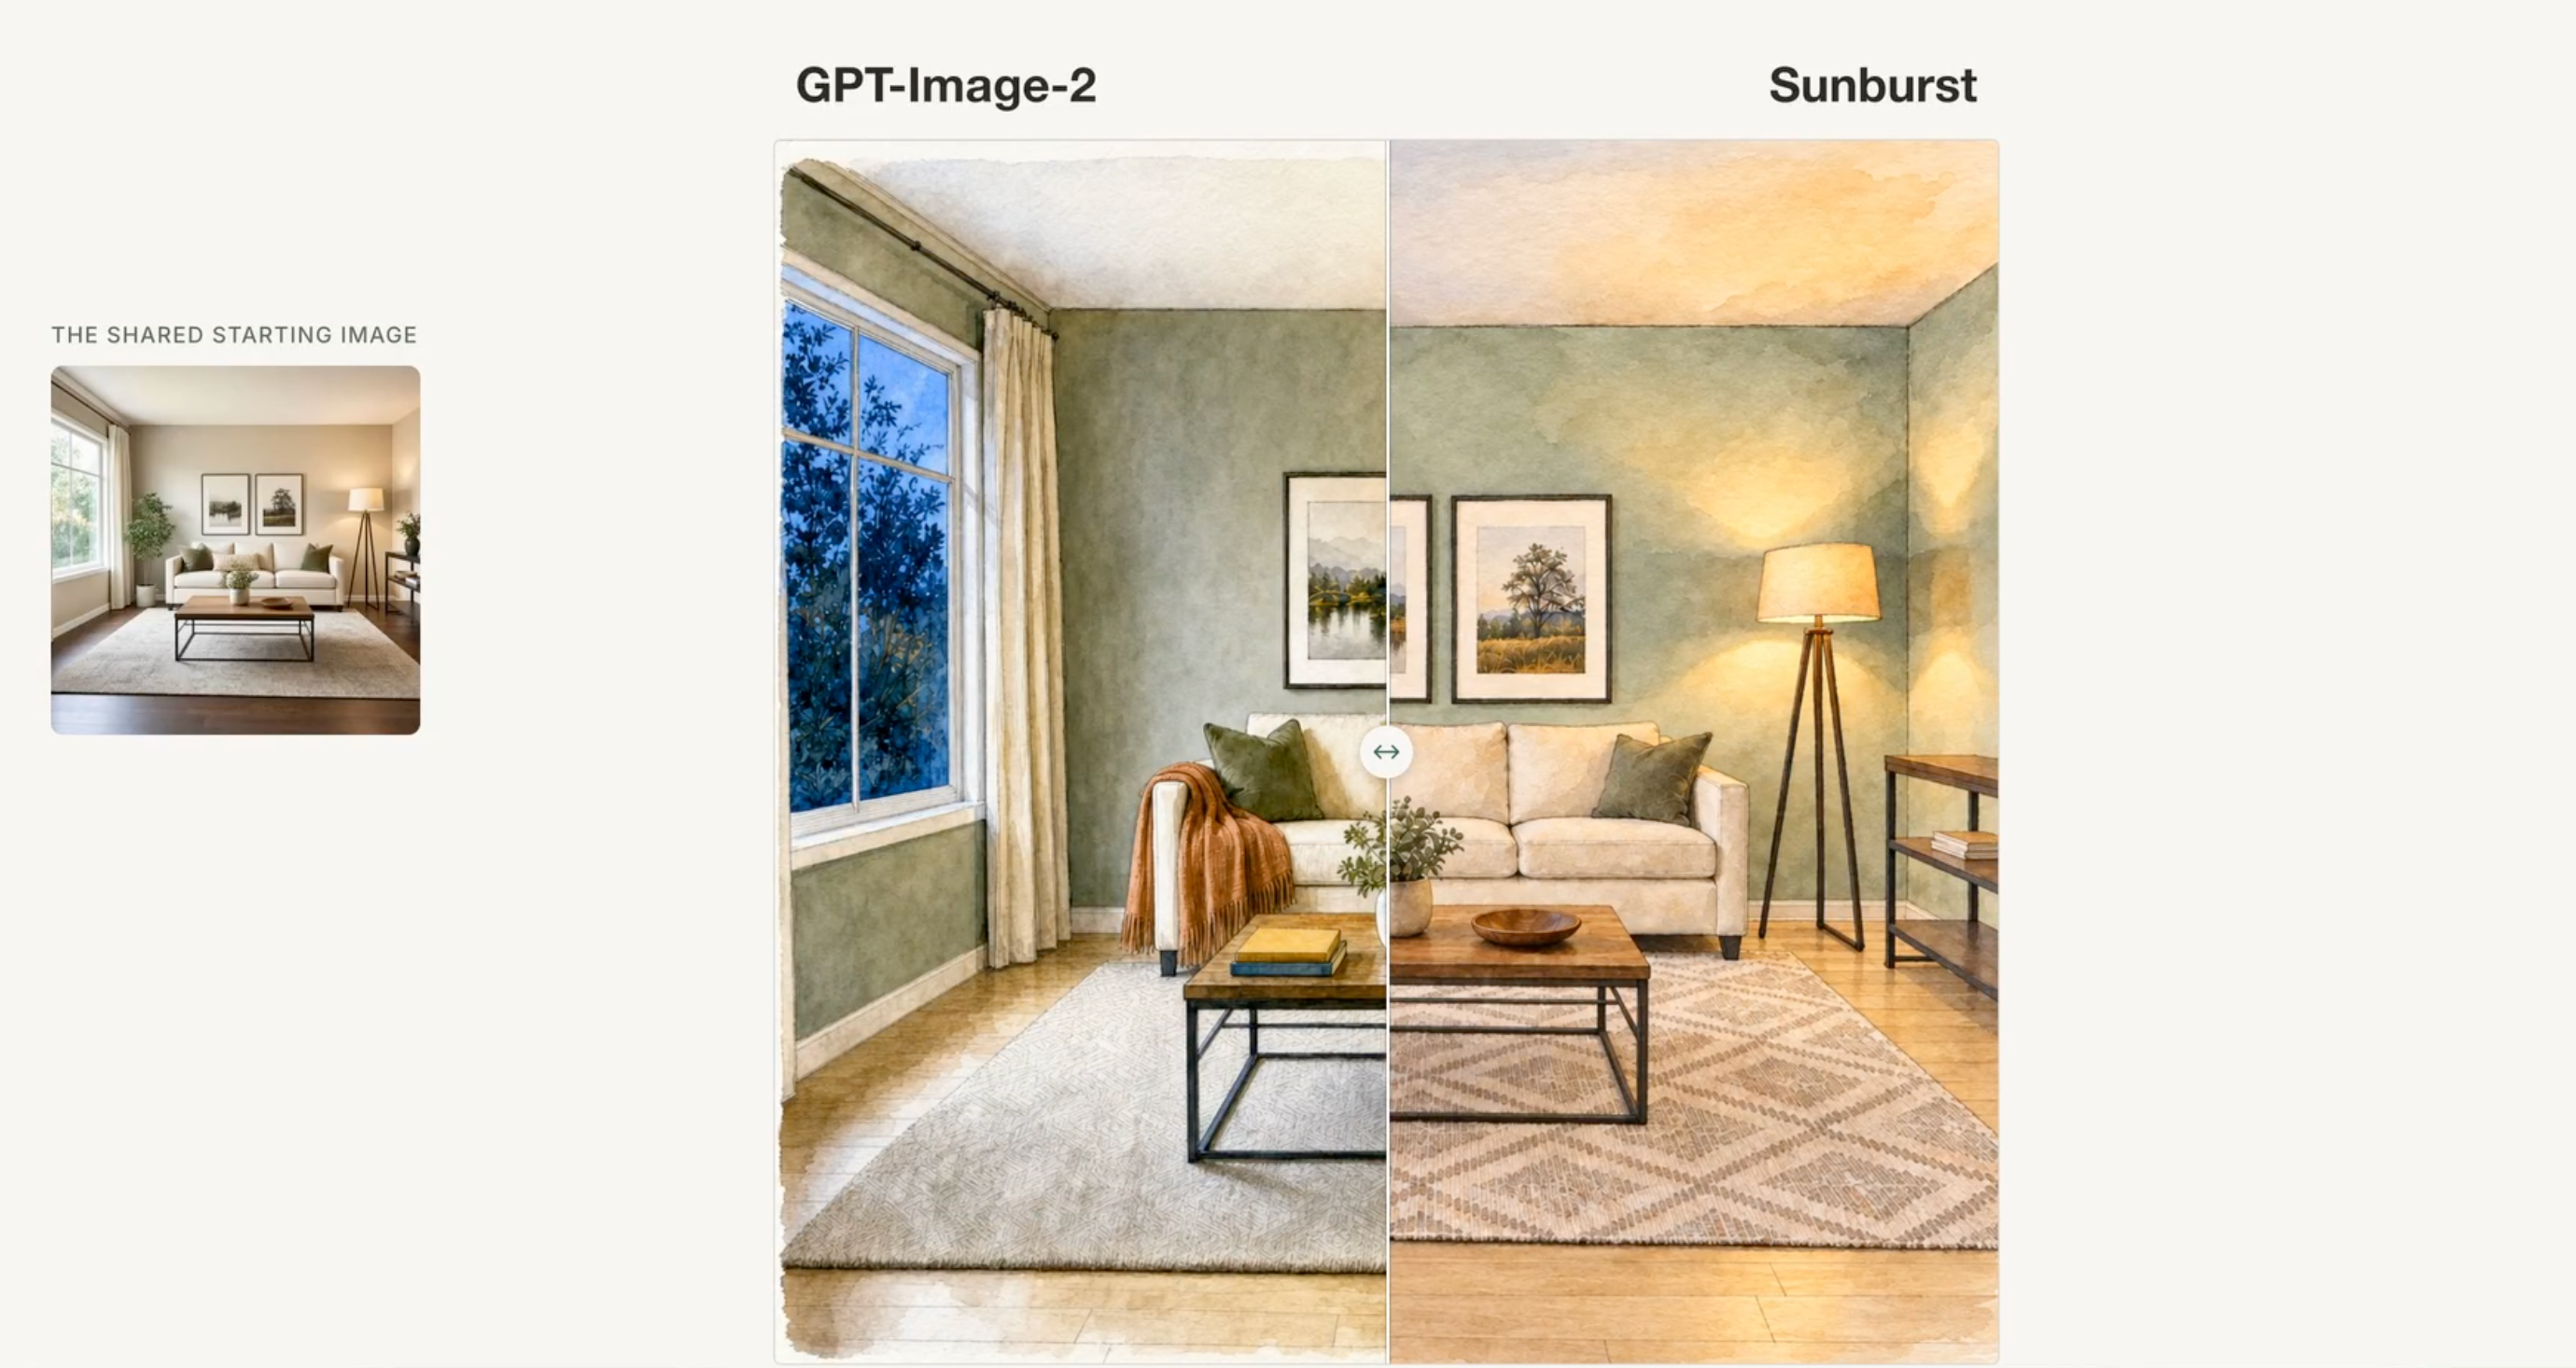
Ambos modelos comparten la entrada de la calculadora, por lo que los recuentos de tokens documentados son idénticos. Sunburst no cuesta más por imagen; el premium es el tiempo. La publicación de lanzamiento de OpenAI orienta Flare a la "generación de alto volumen" y Sunburst a los "flujos de trabajo visuales premium que se benefician de un control más estricto en las ediciones". La documentación lo resume en una línea: "Elige Sunburst para flujos de trabajo donde la precisión de edición es lo más importante, y Flare para la generación de imágenes rápida y de alta calidad para el día a día".
Señal de la comunidad, etiquetada como tal:
- En el hilo de HN, el usuario jjcm, quien informó aproximadamente 50.000 imágenes a través de gpt-image-2 para una herramienta de diseño de UI de IA, dijo que la latencia promedio "se mantuvo alrededor de 104s" en gpt-image-2 y las imágenes 2.5 "llegan alrededor de 35-40s". Un punto de datos, una carga de trabajo; la propia afirmación de OpenAI es una latencia "hasta un 50%" menor.
- La clasificación de texto a imagen de Arena (votos de la comunidad, actualizada el 7 de septiembre de 2026) sitúa a Sunburst en primer lugar con 1421, Flare en segundo con 1399, gpt-image-2 en medium en tercer lugar con 1381, luego mai-image-2.6 de Microsoft con 1331; Nano Banana 2 se sitúa en 1261. En la clasificación de edición de imágenes la brecha se amplía: Sunburst 1520, Flare 1491, gpt-image-2 1461. Son puntuaciones de preferencia del público, no puntos de referencia de OpenAI.
La regla de decisión: por defecto, Flare. Cambia a Sunburst para flujos de trabajo de edición de múltiples turnos donde un sujeto de referencia debe sobrevivir varias rondas de instrucciones. La brecha de Arena es de 22 puntos en texto a imagen y 29 en ediciones, lo que apoya la afirmación de OpenAI de que las ediciones son donde Sunburst vale la espera. Si esa brecha no aparece en tus propios prompts, estás pagando latencia por nada.
Cuando gpt-image-2 todavía tiene sentido
Descuentos por lotes. La pestaña Batch de la página de precios solo lista gpt-image-2, a $15 por 1M de tokens de salida; si /v1/batch acepta los IDs 2.5 no está documentado al momento de escribir esto. Si tu carga de trabajo tolera el tiempo de respuesta de la API por lotes, gpt-image-2 en Batch medium (la mitad de $0.053) es más barato que 2.5 high a tarifas estándar para el mismo presupuesto de tokens.
Instantáneas fijas. gpt-image-2-2026-04-21 se ha enviado desde abril sin aviso de obsolescencia a fecha de 09-09-2026. Si tu pipeline depende de una salida que alguien ha revisado visualmente, una instantánea que no cambia es una característica; nuestra guía de la API de gpt-image-2 cubre sus parámetros. Para un punto de referencia entre proveedores, compara los precios de la API de Nano Banana 2 y la API de FLUX.2 con el mismo tamaño de salida; 2.5 high a aproximadamente cinco centavos por imagen cuadrada es el precio a superar.
Lista de verificación de migración de gpt-image-2 a 2.5
- Intercambia el ID del modelo.
gpt-image-2se convierte engpt-image-2.5-flare(o-sunburst); fijagpt-image-2.5-flare-2026-09-08para una salida estable. - Reasigna las etiquetas de calidad. El antiguo
mediumse convierte en el nuevohigh, el antiguohighse convierte en el nuevomax,lowpermanecelow. Hazlo en la configuración, no por cada sitio de llamada. - Considera
xhighymax. Ambos son nuevos en 2.5;xhighcon 3.122 tokens se sitúa entre los presupuestos de medium y high antiguos. - Elimina las suposiciones de "thinking". La documentación de 2.5 no describe un parámetro
thinking; elimínalo de las plantillas en lugar de asumir que es aceptado o ignorado. - Vuelve a medir el
usage. Registrausage.output_tokensyusage.input_tokensdurante una semana de prompts reales; los números de la calculadora son estimaciones. - Verifica la elegibilidad de Batch. Si dependes del descuento del 50% de Batch, confirma que
/v1/batchacepta los IDs 2.5 antes de realizar el cambio.
Compara los tres modelos en Apidog con una solicitud guardada
Apidog es un cliente API y una plataforma de prueba. Envía la solicitud images/generations y verifica la respuesta; no genera imágenes ni ejecuta el modelo. Eso lo convierte en el lugar para decidir entre Flare, Sunburst y gpt-image-2 con tus propios prompts.
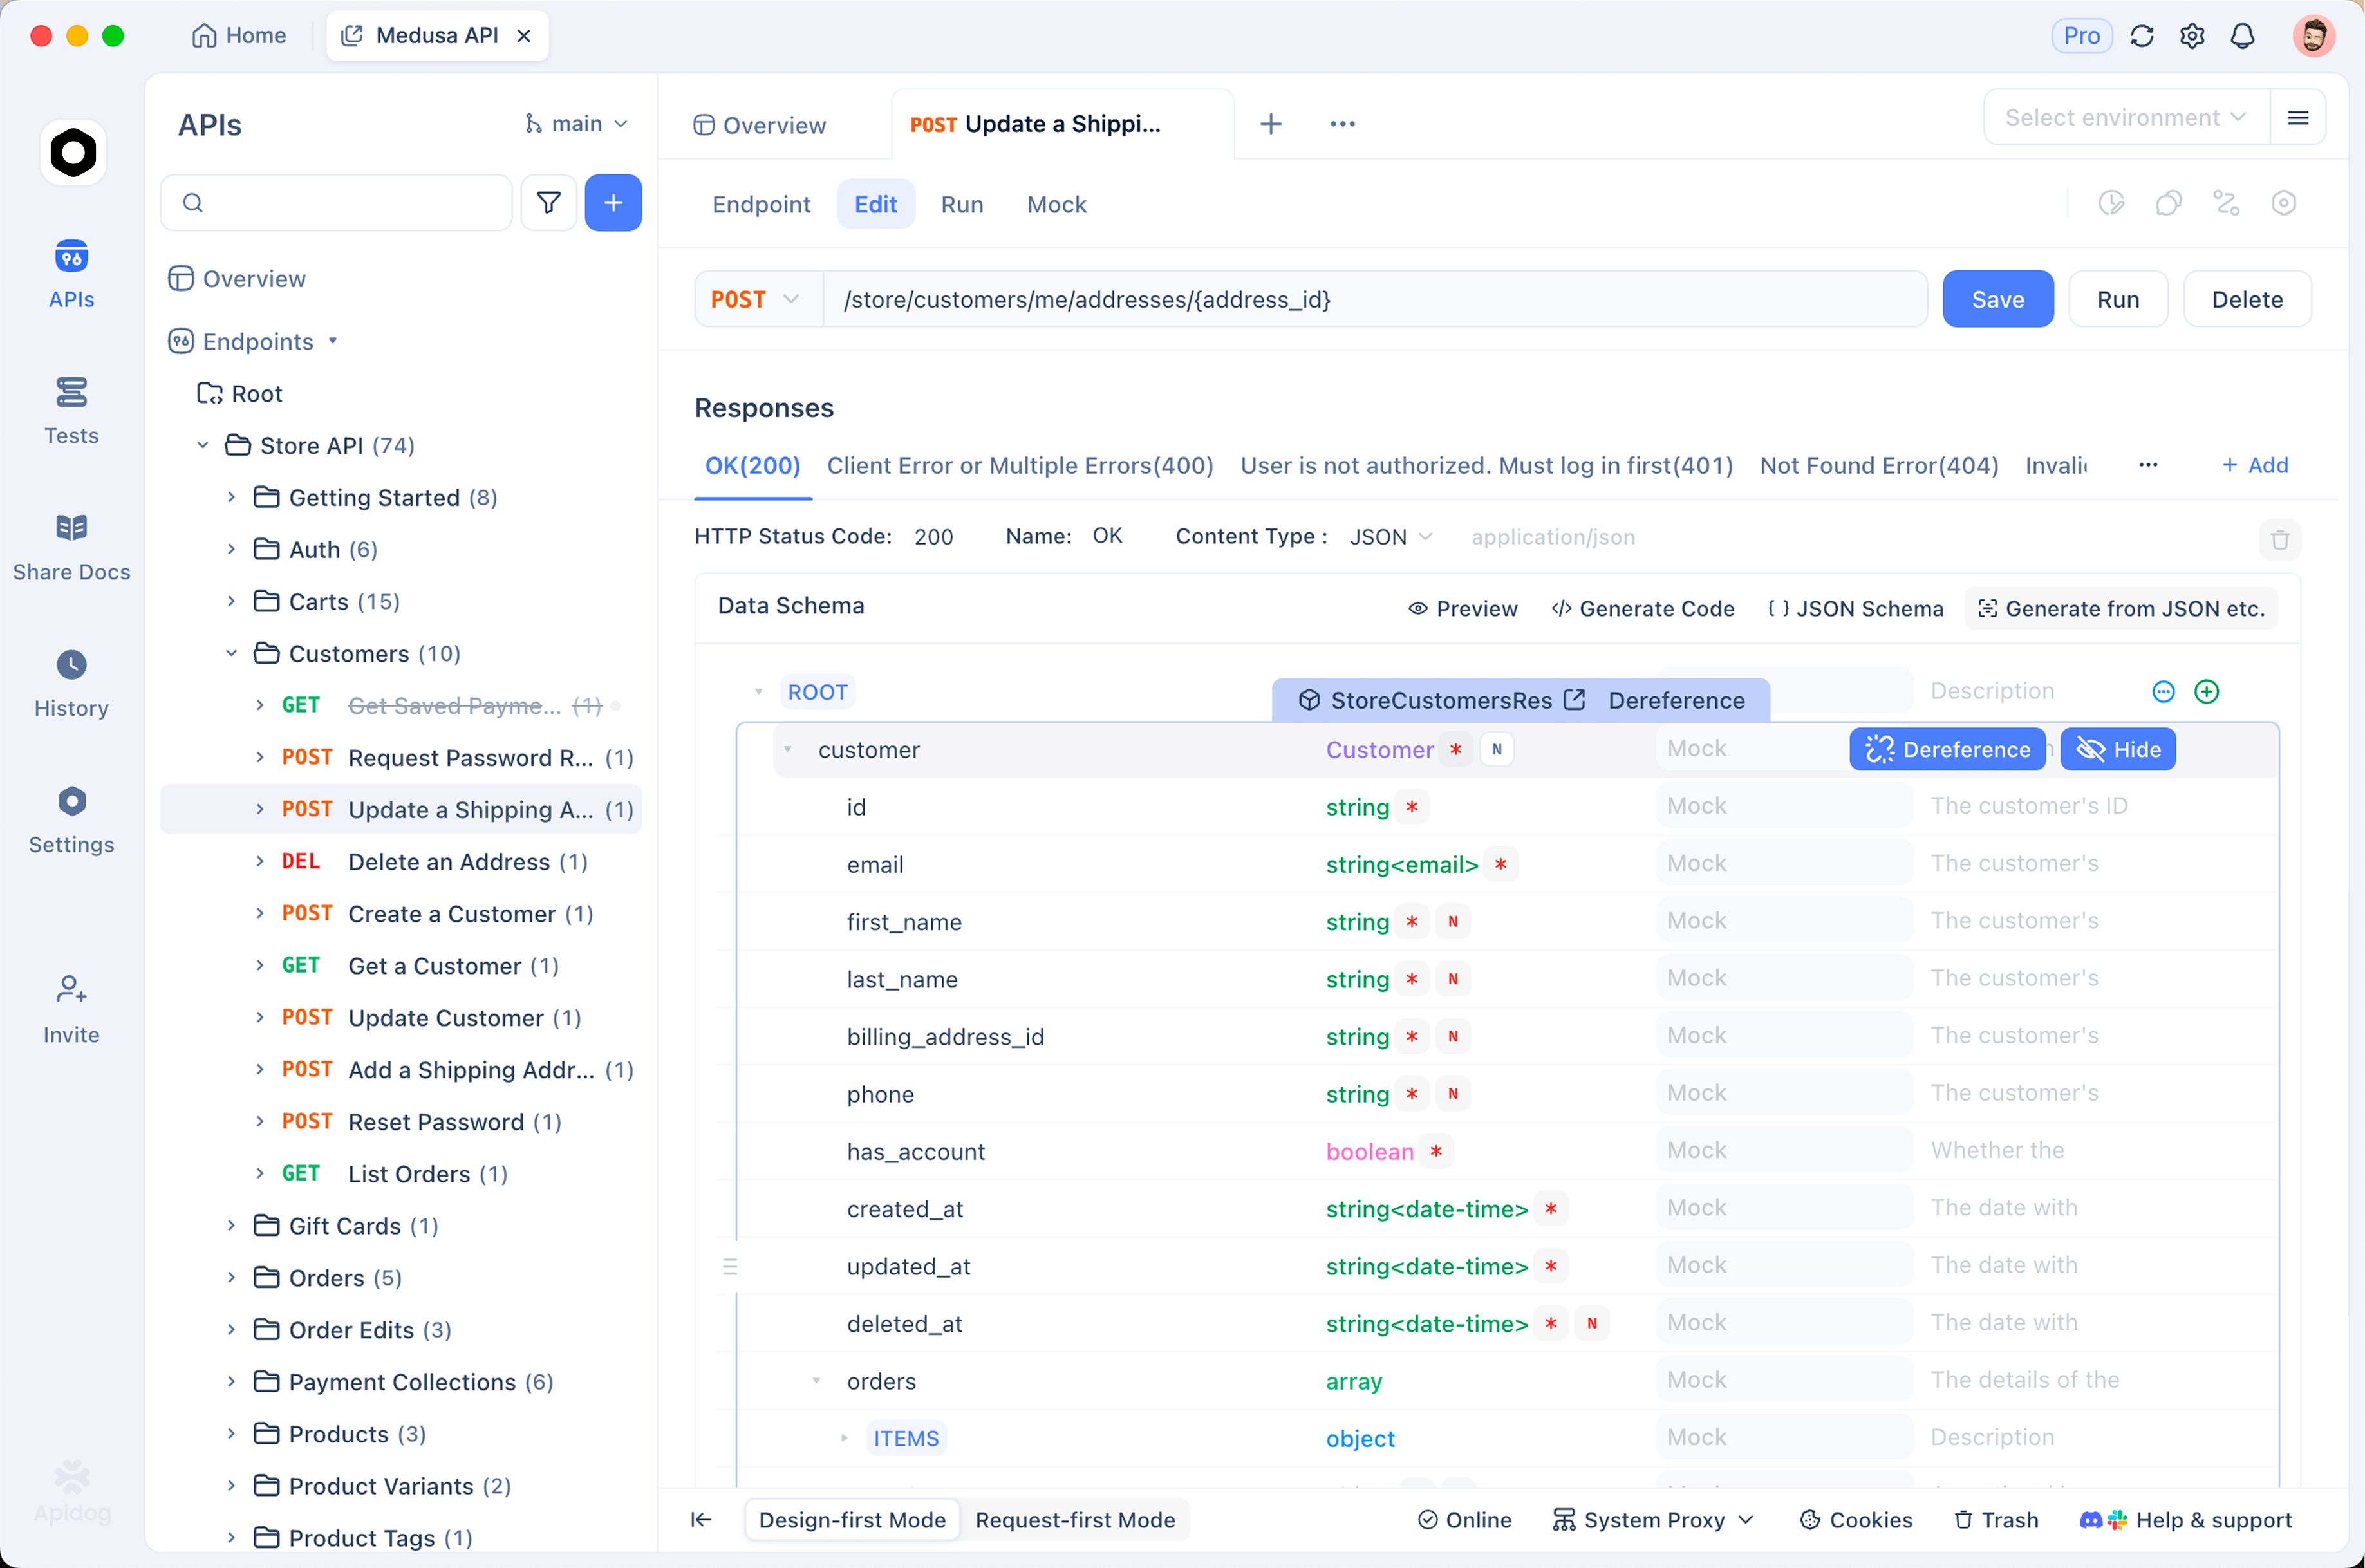
Crea una solicitud para POST https://api.openai.com/v1/images/generations con el modelo como variable, luego crea tres entornos llamados flare, sunburst y gpt-image-2. Cada uno establece {{model}} y almacena OPENAI_API_KEY como una variable de entorno, para que la clave nunca aparezca en el cuerpo de la solicitud.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Añade un script de post-procesamiento que registre los números y falle la ejecución si el presupuesto de tokens se excede:
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Ejecuta la solicitud en cada entorno. El tiempo de respuesta de Apidog es tu número de tiempo real, last_output_tokens es el recuento medido para comparar con los 1.756 de la calculadora, y la diferencia entre las ejecuciones de Flare y Sunburst es el premium de Sunburst para tu prompt. El mismo cambio de entorno funciona para la llamada multiparte images/edits; verifica usage.input_tokens allí para saber cuánto cuesta una foto de referencia. Descarga Apidog para ejecutar la comparación antes de cambiar el código de producción.
Preguntas frecuentes
¿Es gpt-image-2.5 más caro que gpt-image-2? Por token, no. Tanto los modelos 2.5 como gpt-image-2 Estándar facturan $30 por 1 millón de tokens de salida de imagen, $8 por 1 millón de entrada de imagen y $5 por 1 millón de entrada de texto. Por imagen, una solicitud 2.5 high cuesta aproximadamente $0.053 en 1024x1024, frente a $0.211 para gpt-image-2 high.
¿Cuesta Sunburst más que Flare? No. Ambos modelos comparten una entrada de calculadora, por lo que los recuentos de tokens documentados son idénticos en cada nivel de calidad y tamaño. El premium de Sunburst es un tiempo de generación más largo, lo que OpenAI llama un "nivel extra de precisión" para trabajos con muchas ediciones.
¿Qué configuración de calidad reemplaza mi antiguo high de gpt-image-2? max. Utiliza 7.024 tokens en 1024x1024, el mismo presupuesto que gpt-image-2 high, y cuesta $0.21072 según la calculadora. Mantén high y obtendrás el presupuesto del antiguo medium a aproximadamente una cuarta parte del precio. La publicación principal sobre ChatGPT Images 2.5 cubre lo demás que cambió.
¿Existe una forma gratuita de probar Images 2.5 antes de pagar por la API? Sí. El modelo está disponible en todos los niveles de ChatGPT con límites de generación por plan, cubierto en cómo usar ChatGPT Images 2.5 gratis. La API no tiene un nivel gratuito para los endpoints de imagen; la calidad low a aproximadamente $0.006 por imagen cuadrada es la ruta real más barata.
Qué modelo elegir
Flare para cualquier cosa de alto volumen o sensible a la latencia, en high para la mayoría del trabajo y en max cuando el aspecto antiguo de high de gpt-image-2 es un requisito. Sunburst para ediciones de múltiples turnos donde un sujeto de referencia debe sobrevivir, después de una comparación lado a lado con tus prompts; gpt-image-2 para trabajos por lotes y pipelines fijos que no estás listo para revisar de nuevo. Sea lo que sea que elijas, lee usage.output_tokens de las respuestas reales; tres entornos en Apidog y una solicitud guardada te darán ese número en una tarde.