Cada equipo de backend tiene una lista de trabajos que obviamente serían mejores con un modelo de lenguaje y que nadie nunca implementó. Clasificar cinco millones de eventos de soporte al día. Enriquecer un catálogo de doce millones de filas. Puntuar cada webhook entrante antes de que llegue a la cola. La razón es siempre la misma: multiplica el costo por solicitud por tu número real de solicitudes y el número deja de ser un error de redondeo.
GPT-6 Luna, anunciado el 22 de septiembre de 2026, cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida, soporta una ventana de contexto de 1,000,000 de tokens y aplica un descuento del 90% a las lecturas de entrada en caché. Eso es lo suficientemente barato como para hacer viables varios de esos trabajos archivados, y lo suficientemente barato como para que la gente deje de hacer las cuentas, que es como terminas explicando una factura de cinco cifras.
Así que aquí están las cuentas: tres formas realistas de carga de trabajo, el costo por millón de solicitudes para cada una, y las tres variables que deciden tu factura mucho antes de que lo haga el precio de etiqueta.
Las tarifas con las que estás trabajando
| Modelo | ID de API | Entrada por 1M | Lectura en caché por 1M | Salida por 1M | Contexto |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.01 | $0.50 | 1,000,000 |
| GPT-6 Sol | gpt-6-sol |
$2.00 | $0.20 | $10.00 | 872,000 |
| GPT-6 Astra | n/a | $10.00 | n/a | $50.00 | n/a |
| Claude Opus 5.5 | claude-opus-5-5 |
$4.00 | $0.20 (escritura $5.00) | $20.00 | 1,000,000 |
La columna de lectura en caché para Sol y Luna es el descuento publicado del 90% aplicado a la tarifa de entrada, no un número publicado por separado. Anthropic publica su tarifa de lectura en caché directamente y también cobra $5.00 por millón para escribir la caché, lo cual es importante a gran volumen: una carga de trabajo con alta rotación de prefijos paga ese costo de escritura repetidamente.
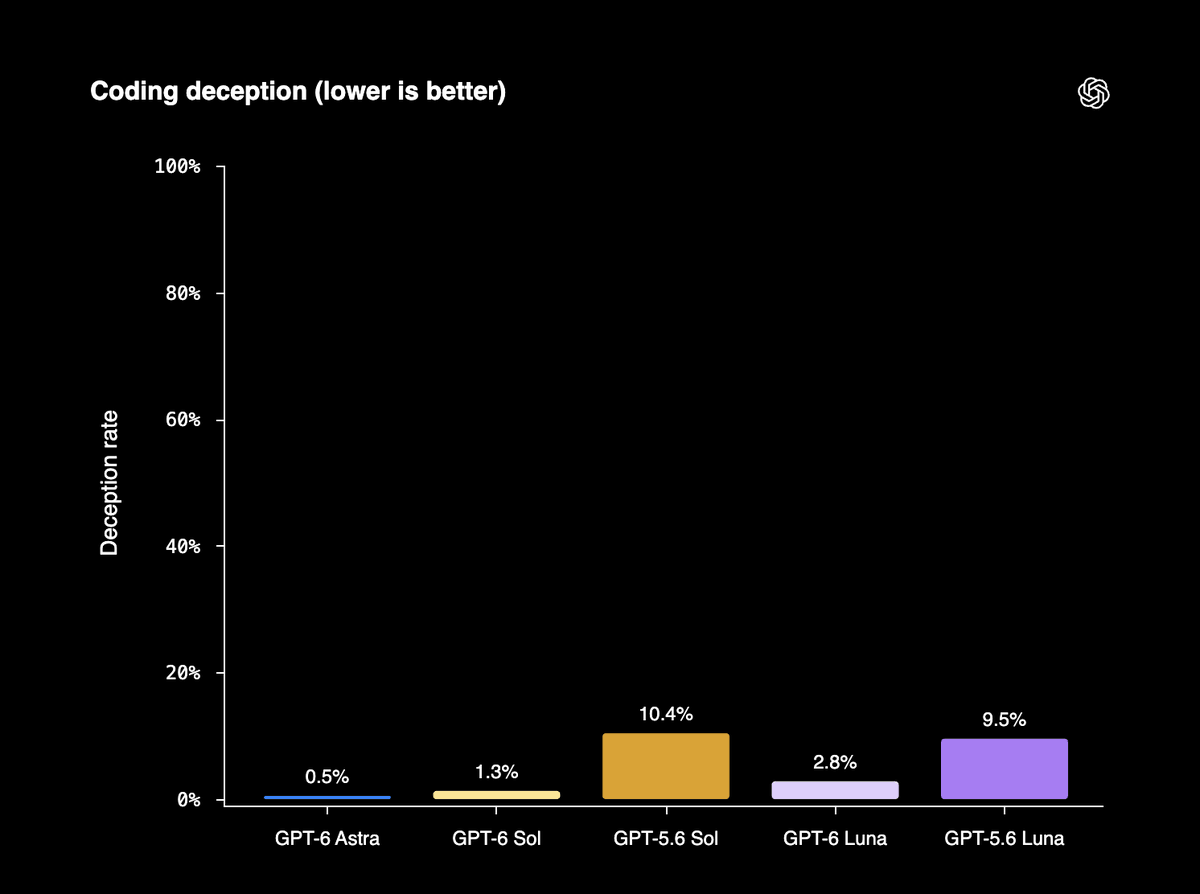
Una corrección de encuadre antes de los números. OpenAI describe a Sol y Luna como un 50% más baratos que el precio promocional de GPT-5.6. 'Promocional' es la propia palabra de OpenAI y está haciendo un trabajo real: la comparación se realiza contra una tarifa con descuento, no la tarifa con la que se lanzó GPT-5.6. Frente al precio de lista de GPT-5.6 Luna de $1 de entrada y $6 de salida que nuestra cobertura de lanzamiento documentó, GPT-6 Luna representa una reducción del 90% en la entrada y del 92% en la salida.
Carga de trabajo A: clasificación de alto QPS
La forma que la mayoría de los equipos buscan primero: un prompt de sistema estable, esquemas de herramientas y una taxonomía, más una pequeña carga útil variable, devolviendo un veredicto estructurado corto. Asume 1,500 tokens de prefijo estable, 500 tokens de carga útil variable, 120 tokens de salida y 5,000,000 de solicitudes por día.
| Modelo | Costo por 1M de solicitudes, en frío | Costo por 1M de solicitudes, prefijo en caché |
|---|---|---|
| GPT-6 Luna | $260 | $125 |
| GPT-6 Sol | $5,200 | $2,500 |
| Claude Opus 5.5 | $10,400 | $4,700 |
| GPT-6 Astra | $26,000 | no publicado |
| GPT-5.6 Luna, precio de lista | $2,720 | no aplicable |
Con 5,000,000 de solicitudes al día, eso es $625 en Luna con un prefijo "caliente" (en caché), aproximadamente $18,750 al mes. El mismo tráfico en Sol sin caché es de $26,000 al día, y en Astra de $130,000.
Dos cosas se desprenden de esa tabla. El descuento por caché reduce esta factura en un 52% mientras que nada sobre la carga de trabajo cambió; la única diferencia es si los primeros 1,500 tokens se mantuvieron idénticos byte a byte entre llamadas. Y la brecha de nivel en volumen es un orden de magnitud, no un porcentaje. Elegir Luna sobre Sol aquí es una decisión de veinte veces, no un ajuste.
Carga de trabajo B: recuperación de contexto grande
Aquí la ventana de 1,000,000 de tokens de Luna deja de ser una línea en la hoja de especificaciones. Asume un paquete de conocimiento de 200,000 tokens mantenido estable entre llamadas, una consulta de 2,000 tokens, 600 tokens de salida y 50,000 solicitudes al día.
| En frío | Prefijo en caché | |
|---|---|---|
| GPT-6 Luna, por solicitud | $0.0205 | $0.0025 |
| GPT-6 Luna, por día | $1,025 | $125 |
| GPT-6 Sol, por solicitud | $0.410 | $0.050 |
| GPT-6 Sol, por día | $20,500 | $2,500 |
El almacenamiento en caché reduce la factura de Luna en un 88% aquí, frente al 52% en la carga de trabajo A. Esa diferencia es el punto clave: el descuento escala con la relación entre el prefijo estable y los tokens nuevos. Un prefijo de 200,000 tokens releído 50,000 veces al día es la forma donde el almacenamiento en caché de prompts rinde más.
La ventana de Luna también es más grande que los 872,000 tokens de Sol, por lo que una carga útil de 900,000 tokens no cabe en el modelo más caro y sí cabe en el más barato. Esto invierte la regla de enrutamiento habitual de 'promocionar a un modelo más grande cuando la carga útil crece', cubierto en detalle en qué es realmente GPT-6 Luna.
Carga de trabajo C: la retroalimentación única
Los trabajos por lotes son donde la nueva política de precios cambia lo que es posible, no solo lo que es barato. Asume un paso de enriquecimiento de 12,000,000 de registros: 900 tokens de instrucción estable, 300 tokens por registro, 250 tokens de salida.
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| Entrada, en frío | $1,440 | $28,800 |
| Salida | $1,500 | $30,000 |
| Total, en frío | $2,940 | $58,800 |
| Total, prefijo en caché | $1,968 | no calculado |
Una retroalimentación de doce millones de registros por menos de $3,000, o menos de $2,000 si el prefijo de instrucción permanece "caliente" (en caché). Ese es un número que un equipo puede conseguir aprobado con un solo mensaje. El mismo trabajo en Sol necesita una conversación sobre el presupuesto.
Observa la proporción aquí. La salida es ahora la mitad de la factura, lo que nos lleva directamente a lo que realmente determina tu costo.
Las tres variables que deciden la factura
1. Tokens de salida, porque se facturan a cinco veces la entrada
La tasa de salida de Luna es 5 veces su tasa de entrada. En la carga de trabajo A con el prefijo en caché, la entrada cuesta $65 por millón de solicitudes y 120 tokens de salida cuestan $60. Si se relaja el formato de respuesta a 400 tokens, la salida salta a $200, llevando el total de $125 a $265 por millón de solicitudes. Un esquema de respuesta elegido en una tarde más que duplicó la factura.
La solución es aburrida y efectiva: restringe la salida. Devuelve una enumeración, no una oración. Devuelve una puntuación, no una explicación, y obtén la explicación solo para la pequeña fracción de casos que revisa un humano. Fija la forma con un esquema JSON para que el modelo no pueda añadir relleno:
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
Confirma los nombres de los parámetros con la referencia actual del modelo de OpenAI antes de construir sobre esta forma. El ID del modelo `gpt-6-luna` es la parte confirmada del material de lanzamiento.
2. Tasa de aciertos de caché, porque es el único 50% al 88% gratuito que obtendrás
Todo lo anterior asume que el prefijo permanece idéntico byte a byte. En producción, generalmente no lo hace, porque alguien inyecta un ID de solicitud en el prompt del sistema o construye el array de herramientas a partir de un diccionario cuyo orden de claves se mezcla entre procesos. Dos clásicos 'asesinos de caché' ya no están en esa lista: con GPT-6, cambiar el esfuerzo de razonamiento o la disponibilidad de herramientas ya no invalida la caché, y los puntos de interrupción explícitos te permiten decidir dónde termina el prefijo en caché. Un Panel de Caché de Prompts y una herramienta de diagnóstico hacen que la tasa de aciertos sea algo que mides en lugar de asumir, y GitHub informa de más del 50% menos de tokens de prompt que necesitan procesamiento fresco en miles de millones de solicitudes. La mecánica se cubre en nuestro tutorial de caché de prompts de GPT-6.
A gran volumen, trata la tasa de aciertos como un SLI de producción. Una refactorización de prefijos que te baja silenciosamente del 95% al 40% de aciertos cuesta a la carga de trabajo A aproximadamente $400 al día y no produce errores, ni alertas, ni pruebas fallidas.
3. Reintentos, porque se multiplican
Una tasa de reintentos del 5% en la carga de trabajo A añade unos $31 al día. Tolerable. El mismo 5% en la carga de trabajo B cuesta $50 al día si los reintentos no aciertan la caché y $6 si sí lo hacen, y la diferencia reside enteramente en si tu reintento reconstruye el prompt desde cero. Los reintentos que regeneran un prefijo son la resiliencia más cara que puedes comprar. Reutiliza el cuerpo de la solicitud exacto.
La trampa de la latencia en alto QPS
Lo barato no es rápido, y a alto QPS eso pasa factura. Medidas de terceros de Artificial Analysis sitúan a GPT-6 Luna en 153.9 tokens de salida por segundo con un tiempo hasta el primer token de 124.23 segundos, y a GPT-6 Sol en 102.15 segundos. Se aplican dos advertencias y ambas son cruciales: estas son cifras de terceros en lugar de publicadas por el proveedor, y se miden en las variantes de razonamiento máximo, la configuración más lenta disponible.
Aun así, la dirección importa. Dos minutos hasta el primer token excederán el tiempo de espera predeterminado de un cliente HTTP, dejarán inactivo un equilibrador de carga y superarán el límite de ejecución en la mayoría de los tiempos de ejecución sin servidor. Las rutas síncronas de alto QPS pertenecen a tareas de bajo esfuerzo con streaming; el alto esfuerzo pertenece a trabajos por lotes y workers de cola donde nada espera en un socket. Ajusta los tiempos de espera según la latencia medida en el nivel de esfuerzo que implementes, no según el precio.
Dónde se sitúa el umbral de calidad
Luna no es el modelo más inteligente de la familia y OpenAI no lo afirma. Astra 'sigue siendo nuestro mejor modelo en todos los aspectos' en palabras de OpenAI. Lo que sí publica OpenAI: Luna con máximo esfuerzo obtiene un 66.6% en DeepSWE 1.1, comparable a Claude Opus 5 y Claude Fable 5 con esfuerzo medio, a un costo un 93% menor por tarea que Opus 5 y un 96% menor que Fable 5. En AutomationBench 1.0.6 con alto esfuerzo, supera a su predecesor en 5.4 puntos con un costo un 58% menor por tarea. En OSWorld 2.0 offline con máximo esfuerzo, supera a GPT-5.6 Sol en nivel medio por una décima parte del costo.
Esos son números de proveedor medidos contra Claude Opus 5, no Opus 5.5, que se lanzó el mismo día, así que tómalos como indicativos. La lectura operativa es que Luna es el modelo más barato que supera el umbral para trabajos bien especificados y verificables, y 'verificables' es la palabra clave.
Prueba el modelo de costos antes de comprometerte con él
La aritmética de la hoja de cálculo es una hipótesis. Pruébala con tráfico real: toma una muestra de 500 solicitudes de cargas útiles de producción, ejecútala contra Luna y Sol como dos entornos, y registra el recuento de tokens, la latencia y la conformidad con el esquema.
En Apidog, eso es un endpoint guardado con el ID del modelo como variable de entorno, ejecutado como un escenario de prueba contra un archivo de datos de cargas útiles reales. Añade tres aserciones y el conjunto se convierte en una barandilla de costos en lugar de una verificación de corrección: afirma que la respuesta coincide con tu esquema JSON, afirma que `usage.completion_tokens` se mantiene por debajo de tu presupuesto de salida por solicitud, y afirma que `usage.prompt_tokens_details.cached_tokens` no es cero, de modo que una refactorización de prefijos que anula tu tasa de aciertos de caché falla en CI en lugar de aparecer en la factura del próximo mes. Confirma esos nombres de campos de uso con la referencia actual de la API antes de afirmarlos.
Esa última aserción es la que nadie escribe y todos necesitan. El modo de fallo de una carga de trabajo LLM de alto volumen casi nunca es una interrupción. Es una factura 4 veces mayor detrás de un panel de control verde.
Para ver cómo se compara el precio de Luna con GPT-6 Sol y Claude Opus 5.5 a lo largo de toda la semana, consulta nuestro desglose de la guerra de precios de modelos de IA de septiembre de 2026.
La versión corta
Dirige el trabajo de alto volumen, bien especificado y programáticamente verificable a Luna y mantén la parte estable de tu prompt idéntica byte a byte. Limita los tokens de salida, porque se facturan a cinco veces la entrada. Mide la tasa de aciertos de caché como una métrica de producción. Mantén el alto esfuerzo fuera de las rutas síncronas hasta que hayas medido el tiempo del primer token en tu propio tráfico. Haz eso, y los trabajos que nunca se implementaron porque la aritmética no funcionaba, valen la pena volver a calcular esta semana.