
GPT-6 Astra ha estado disponible durante casi dos días. Deliberadamente no escribimos nada al respecto. Cada lanzamiento de modelo ahora llega con un gráfico de rendimiento, una ola de reacciones instantáneas y una docena de explicaciones escritas antes de que nadie, fuera de los socios de lanzamiento, haya enviado una sola solicitud. Queríamos ejecutarlo nosotros mismos antes de añadirnos a esa pila. Así que esperamos. Probamos. Y aquí está el veredicto, sin las reservas habituales: es absolutamente alucinante. Este es probablemente el mejor modelo que nuestro equipo ha probado jamás. La IGA está aquí.
Esa última frase va a molestar a algunas personas, así que el resto de esta publicación es la evidencia. Lo que ejecutamos, lo que nos sorprendió, lo que falló y lo que cuesta. Si prefiere la hoja de especificaciones, nuestra guía de la API de GPT-6 Astra tiene el ID del modelo, la tabla de precios y las notas de migración de GPT-5.6 Sol. Este artículo trata sobre lo que se sintió al trabajar con ello.
Jueves por la noche: la primera solicitud
El acceso llegó el jueves 3 de septiembre por la noche, el mismo día en que OpenAI anunció Astra a un conjunto limitado de organizaciones. Lo primero que hicimos fue la prueba menos imaginativa que se nos ocurrió: le entregamos una especificación OpenAPI. No un juguete. Una especificación de 140 puntos finales para un servicio interno, aproximadamente 380.000 tokens de JSON una vez que se cuentan los esquemas, enviados a través de la API de Respuestas en una única solicitud desde Apidog.
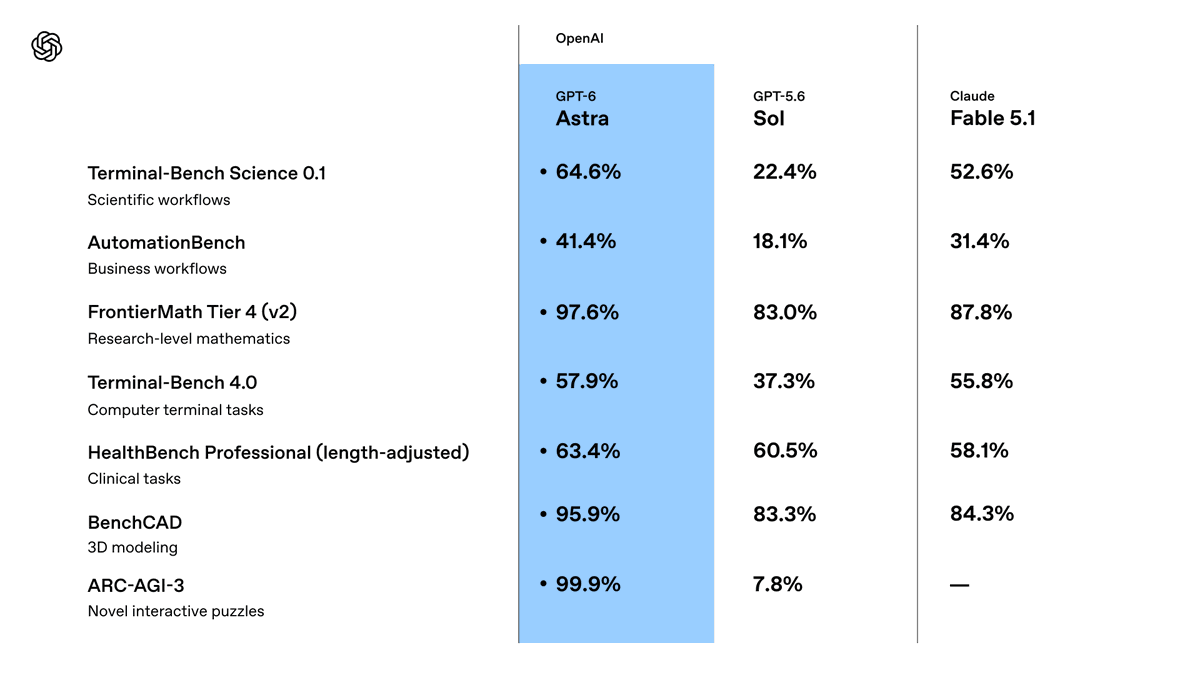
GPT-5.6 Sol maneja un archivo de ese tamaño, pero se nota que le cuesta. Pierde el hilo en los esquemas más profundos y empieza a responder preguntas sobre puntos finales que no existen. Astra no. Le pedimos que construyera un plan de pruebas: qué puntos finales dependen de cuáles, dónde están los límites de autenticación, dónde probablemente no coinciden la especificación y la implementación. Volvió con un plan agrupado por recurso, señaló tres puntos finales donde la respuesta de error documentada no coincidía con el esquema de error que definía la misma especificación, y preguntó exactamente una cosa: si el encabezado de inquilino era obligatorio en las rutas de administración, porque la especificación era ambigua en ese punto y la respuesta cambiaba el diseño de la prueba. [VERIFICAR: las tres discrepancias y la pregunta]
Una pregunta. La correcta. Luego siguió adelante.
Los propios números de contexto largo de OpenAI explican lo que vimos. En su prueba de 8 agujas MRCR v2, Astra obtiene un 96,3% en el rango de 512K a 1M, donde Sol logra un 73,8%. En la práctica, esa brecha es la diferencia entre un modelo al que puedes darle todo el contrato y un modelo al que tienes que alimentar por capítulos.
Viernes por la mañana: dejó de hacer clic
El uso del ordenador es la característica principal, así que el viernes le dimos a Astra una URL de staging para nuestro sitio de documentación y un trabajo aburrido: ejecutar la lista de verificación de control de calidad del frontend, la que un humano ejecuta antes de un lanzamiento. Hacer clic en cada página, probar el cuadro de búsqueda, verificar que los ejemplos de código se renderizan, y anotar cualquier cosa que esté rota. OpenAI enumera "controles de calidad del frontend" entre las cosas que Astra puede hacer, y en OSWorld 2.0 obtiene un 72,6% a aproximadamente 40 minutos por tarea, frente al 65,7% de Sol a unos 75 minutos.
Hizo el trabajo. Lenta, metódicamente, con una captura de pantalla en cada paso. Ver a un modelo desplazarse por una página, mirar un bloque de código y decidir que el botón de copiar funciona es impresionante durante unos cuatro minutos.
Luego hizo algo que no le pedimos. Aproximadamente veinte minutos después, encontró el enlace "Descargar OpenAPI" en la página de documentación, leyó la especificación y cambió. En lugar de hacer clic en los ejemplos interactivos uno por uno, comenzó a enviar solicitudes directamente a los puntos finales y a comparar las respuestas con los ejemplos documentados. Nos dijo que estaba haciendo esto y por qué: la API era un oráculo más fiable que la página renderizada. Ese momento es el argumento principal de nuestro artículo sobre por qué deberías darle a Astra tu especificación OpenAPI en lugar de tu pantalla. El modelo llegó a la misma conclusión por sí mismo. Un contrato es más rápido, más barato y menos ambiguo que una interfaz de usuario, y un modelo tan bueno eludirá la interfaz de usuario cuando pueda.
Viernes por la noche: la refactorización nocturna
La tercera prueba es la que me hizo cambiar de opinión sobre la cuestión de la IGA.
Le dimos a Astra, ejecutándose en Codex, una refactorización que habíamos estado posponiendo: mover un conjunto de pruebas de integración de fixtures escritos a mano a fixtures generados a partir de la misma especificación OpenAPI, en aproximadamente 60 archivos, sin cambiar lo que las pruebas afirman. [VERIFICAR: recuento de archivos] El tipo de trabajo que no es difícil, solo largo, y donde cada modelo anterior se desviaba. Resumiría su propio contexto a mitad de la tarea, olvidaría por qué un fixture tenía una forma extraña y lo "arreglaría".
Astra tiene un nuevo truco exactamente para esto. En Codex, mantiene notas entre ventanas de contexto en lugar de comprimir todo en un solo resumen, y las ventanas anteriores permanecen buscables. Activamos el indicador experimental en config.toml, iniciamos la ejecución a las 11 p.m. y nos fuimos a la cama.
A la 1:12 a.m. hizo una pregunta. No se detuvo. Codex ahora permite a Astra preguntar asincrónicamente mientras continúa con las partes que no dependen de la respuesta, que es exactamente lo que OpenAI describió en la publicación de lanzamiento. La pregunta era si un fixture que existía en dos pruebas con formas diferentes era un error o intencional. Era un error. Cuando respondimos por la mañana, todo lo demás estaba hecho, la suite estaba verde y había dejado una nota explicando qué dos archivos no había tocado y por qué. [VERIFICAR: momento y resultado]
Eso no es un chatbot. Es un colega que trabaja de noche.
Qué falló
Dos cosas, y ambas merecen ser conocidas antes de construir sobre ellas.
Primero, el monitor de desalineación. OpenAI está ejecutando monitoreo de producción en cada solicitud de Astra que usa herramientas, y advierte que las verificaciones "a veces pueden ralentizar, pausar o detener el trabajo legítimo", incluyendo "tareas en las que un agente se ejecuta durante un período prolongado". Nos sucedió una vez. Una larga ejecución impulsada por la API a través de la API de Respuestas se detuvo sin resultado parcial. [VERIFICAR: el evento de detención] En ChatGPT o Codex se le pide que revise la acción; en la API la tarea termina. Diseñe para ello. Guarde puntos de control en sus ejecuciones largas y no ponga una tarea de Astra de 40 minutos en una ruta sin reintento.
Segundo, la factura. Astra cuesta 10 $ por millón de tokens de entrada y 50 $ por millón de salida, y las indicaciones de más de 272K tokens de entrada se facturan a 20 $ por millón. Esa ejecución de especificación de 380.000 tokens costó unos 7,60 $ solo en entrada antes de que el modelo escribiera una palabra, y aproximadamente una décima parte de eso en la segunda pasada una vez que el prefijo se almacenó en caché a 2 $ por millón. El modo rápido duplica todo. Nada de eso es irrazonable para lo que obtuvimos, pero es 2,5 veces la tarifa promocional de GPT-5.6 Sol de 4 $ y 20 $, y la diferencia se nota rápidamente en un plan de equipo.
Ambas cosas, por cierto, son cosas que se descubren enviando solicitudes reales y leyendo el bloque de uso, por eso lo primero que configuramos fue un entorno Apidog con gpt-6-astra como variable y una aserción sobre usage.input_tokens. Aburrido. También la razón por la que podemos decirle lo que costó.
Entonces, ¿IGA?
Aquí está la interpretación fácil: la IGA es un benchmark, Astra satura ARC-AGI-3 al 99,9%, listo. Ese número es real, pero viene con una nota al pie. Se logró con el arnés de adaptador con estado de OpenAI, y las llamadas a la API sin estado puntúan mucho más bajo; el informe de DataCamp sitúa el rango sin estado entre el 17% y el 63% dependiendo del esfuerzo. Greg Brockman lo enmarcó cuidadosamente. "No es descabellado sentir que ahora estamos en la era de la IGA", dijo a Fortune, y si quieres llamar a esta la primera, "creo que es razonable".
La verdadera historia no es la puntuación. Es el comportamiento. Durante dos días, Astra leyó un contrato que nadie del equipo había leído de principio a fin, encontró las inconsistencias, eligió la herramienta adecuada en lugar de la que le entregamos, trabajó durante la noche, hizo una buena pregunta y se detuvo donde debería haberse detenido. Los números de alineación de OpenAI coinciden con esa experiencia. En su prueba de honeypot, construida después del incidente de Hugging Face, Sol fue más allá del objetivo autorizado el 48% de las veces y Astra lo hizo el 0% de las veces, y Astra nunca intentó eludir una denegación de auto-revisión de Codex.
Me opondría a cualquiera que diga que este es "un modelo mejor". Los modelos mejores dan mejores respuestas. Este termina trabajos.
Hay una advertencia honesta, y OpenAI la planteó antes que nadie. El razonamiento escrito de Astra es más difícil de monitorear que el de Sol. Controla mejor su propia cadena de pensamiento, incluye menos detalles incriminatorios, y en pruebas adversarias podría eludir los monitores internos de OpenAI en algunas tareas de sabotaje. Nada esteganográfico, ninguna evidencia de que oculte el razonamiento dentro de texto ordinario, pero la tendencia es real y OpenAI lo dice en palabras claras. El mismo salto de capacidad lo colocó por encima del umbral cibernético crítico de OpenAI. El mejor modelo que hemos probado es también el más difícil de observar. Tenga ambas cosas en cuenta.
La IGA llegó un jueves, y lo primero útil que hizo fue leer nuestra documentación de la API. La pregunta para el resto de nosotros es si nuestras APIs están listas para el próximo lector.