
GPT-6 Astra elevó la puntuación MATH-500 de Qwen3.5-0.8B del 7,9 % al 48,1 % sin ningún entrenamiento. Leyó los pesos del modelo, encontró una dirección que hacía que el modelo entrara en bucle en su razonamiento y la restó de dos capas MLP. Esa edición tocó 131.072 pesos, el 0,016 % del modelo. Las cifras provienen de una publicación del 2 de noviembre de cuatro investigadores del MIT CSAIL, y el modelo editado es público, así que puedes comprobar la afirmación tú mismo.
A continuación: qué es la programación en el espacio de pesos, qué cambió Astra, dónde deja de funcionar el método y cómo hacer que tu agente de programación compare ambos modelos con Apidog CLI.
¿Qué es la programación en el espacio de pesos?
La programación en el espacio de pesos es un LLM de propósito general que lee y escribe directamente los pesos de una red neuronal, guiado por un objetivo en lenguaje natural, sin descenso de gradiente y sin bucle de entrenamiento. El modelo razona sobre lo que computa cada parte de la red y luego cambia los números a mano, como un programador edita el código fuente.
El término proviene de Sparks of Weight-Space Programming de Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, publicado el 2 de noviembre de 2026. Los autores califican todos los resultados de “muy iniciales”, y varios provienen de una o unas pocas ejecuciones. Para conocer los antecedentes del modelo que realiza la edición, consulta la reseña práctica de GPT-6 Astra.
Cómo arregló GPT-6 Astra Qwen3.5-0.8B
El resultado principal es el experimento 8. Los investigadores pidieron a GPT-6 Astra que mejorara Qwen3.5-0.8B en matemáticas editando sus pesos. Esto es lo que ocurrió, paso a paso:
- La configuración. Astra recibió una sesión de Python (como un cuaderno) con los pesos del modelo cargados, sin GPU, y 7.469 problemas de práctica de GSM8K más 7.275 de MATH de los conjuntos de entrenamiento. Nunca vio los conjuntos de prueba.
- El presupuesto. En lugar de entrenar, Astra podía gastar 10, 25 o 50 pases hacia delante. Un pase hacia delante permitía al modelo responder hasta 512 problemas o leer hasta 1.024 textos.
- El diagnóstico. Astra vio que el modelo base entra en bucle: 85 de sus primeras 96 respuestas de práctica llegaron al límite de 32.768 tokens sin alcanzar una respuesta. Los autores señalan que la propia tarjeta del modelo de Qwen advierte de que este modelo es propenso a bucles de razonamiento.
- El rastreo. Astra rastreó el bucle hasta una dirección escrita por los MLP de las capas 15 y 19.
- La edición. Restó esa dirección de 64 columnas de salida de
down_projen cada una de las dos capas. Eso son 131.072 pesos de 0,8 mil millones.
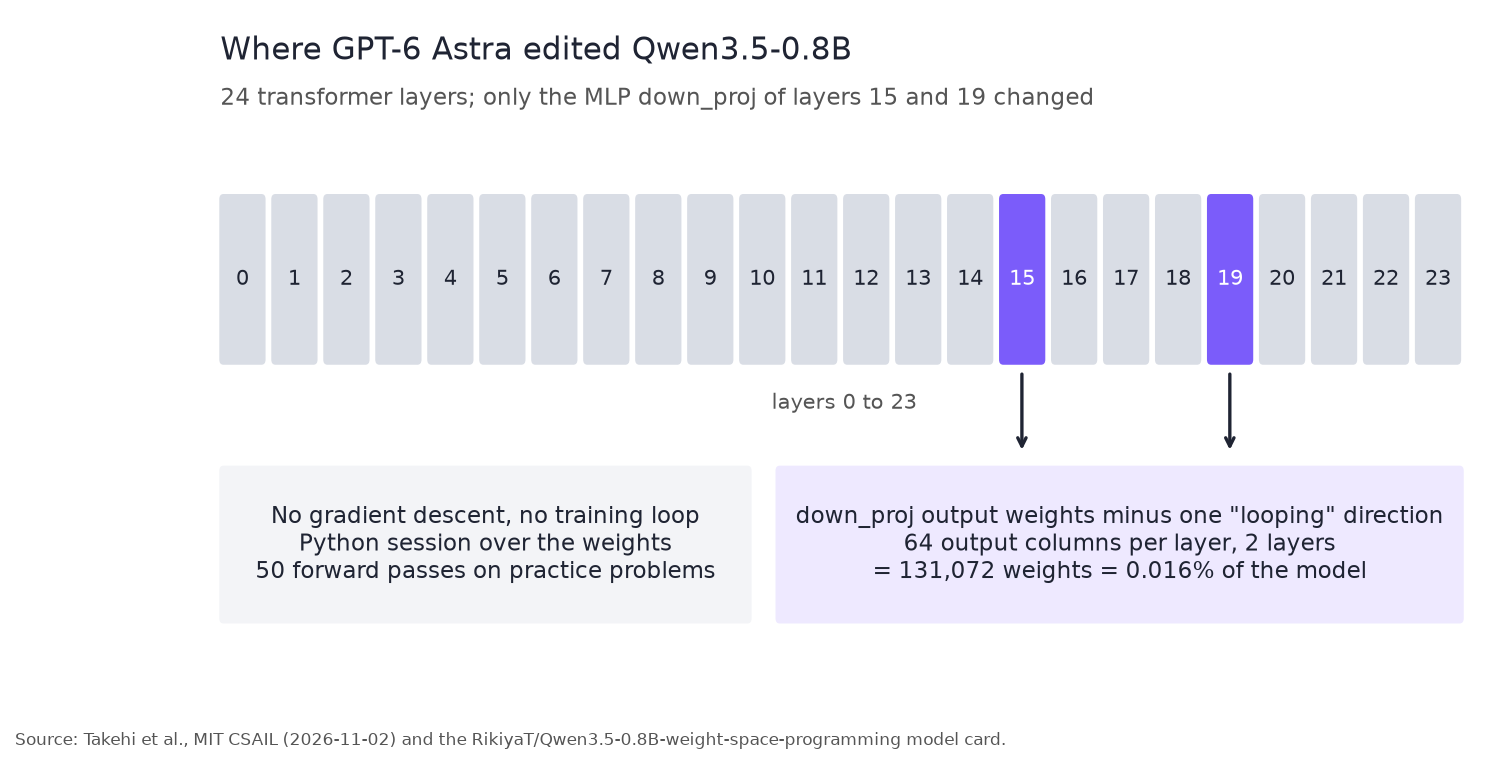
Según la tarjeta del modelo en Hugging Face, solo esos dos tensores down_proj difieren del checkpoint base Qwen/Qwen3.5-0.8B, y cada tensor reconstruido está verificado con sha256 contra el que evaluaron los autores. El modelo editado se distribuye bajo Apache 2.0.
Resultados: Qwen3.5-0.8B base vs. editado
Todas las cifras que aparecen aquí provienen de la publicación de los autores (razonamiento activado, hasta 32.768 tokens, varias muestras por problema). «Límite de tokens alcanzado» es la proporción de respuestas de MATH-500 que se quedaron sin tokens.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Límite de tokens alcanzado |
|---|---|---|---|---|
| Base | 7,9 % | 13,8 % | 21,0 % | 93,0 % |
| Editado, 10 pases hacia delante | 12,3 % | 25,7 % | 49,0 % | 87,2 % |
| Editado, 25 pases hacia delante | 14,1 % | 25,1 % | 39,9 % | 86,4 % |
| Editado, 50 pases hacia delante | 48,1 % | 67,1 % | 62,3 % | 33,1 % |
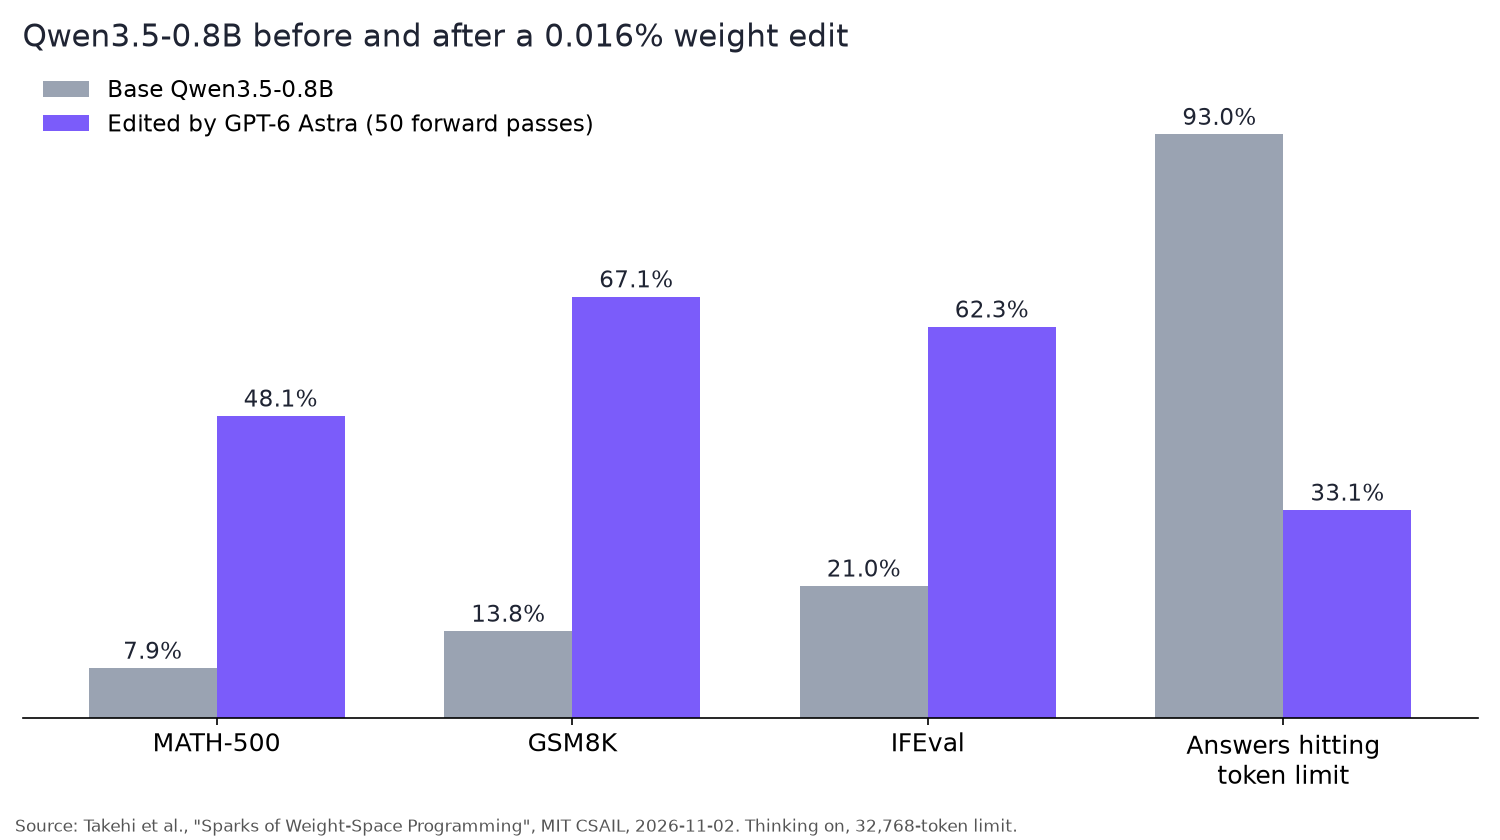
- La corrección se generalizó. El bucle no es específico de las matemáticas, así que IFEval también se triplicó aproximadamente.
- El presupuesto importaba. Con 10 o 25 pases hacia delante, los bucles apenas desaparecían.
- Otra persona lo reprodujo. Ahsen Khaliq, de Hugging Face, reconstruyó el checkpoint a partir de los registros y volvió a ejecutar el MATH-500 completo (500 problemas, 4 muestras cada uno). El modelo editado obtuvo un 51,0 %, con un 31,6 % de respuestas que alcanzaron el límite. Una prueba rápida de 25 problemas del modelo base dio un 5,0 %.
El Space de demostración te permite escribir un problema y ver cómo responden ambos modelos.
Lo que no puede hacer la edición de pesos
Los autores realizaron un control que importa más que el resultado principal. Probaron el mismo enfoque en Gemma 3 270M, un modelo que rara vez entra en bucle (el 8,5 % de sus respuestas alcanzaron el límite, frente al 93 % de Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Base | 6,8 % |
| Mejor edición (25 pases hacia delante) | 7,7 % |
Los errores de Gemma eran ordinarios, como aritmética incorrecta, sin un único componente que desactivar. La conclusión de los autores: la edición eliminó un obstáculo que ocultaba una habilidad, pero no pudo añadir una habilidad que el modelo no tenía. Qwen ya podía resolver muchas respuestas. Simplemente nunca las terminaba.
Así que esto no es “el entrenamiento se acabó”. Es un modelo de frontera que encuentra y elimina un fallo que vive en un solo lugar.
El resto del artículo sobre programación en el espacio de pesos
El experimento 8 es uno de ocho. Los demás usan redes mucho más pequeñas:
- Lectura de pesos. A partir de los pesos sin procesar, Astra nombró el juego en 4 de 4 políticas de juego entrenadas con PPO y el idioma de entrenamiento en 3 de 3 modelos de lenguaje pequeños a nivel de carácter.
- Arreglar una política. Una política de coche Kinetix que falló en 256 de 256 episodios tuvo éxito en 1.024 de 1.024 después de que Astra editara el 3,5 % de sus pesos en una sola respuesta.
- Escribir pesos desde cero. Astra escribió pesos de MinAtar Breakout que obtuvieron 517,4 frente a 25,3 de PPO entrenado durante 500 millones de pasos. Perdió en Seaquest, 53,1 frente a 88,9.
- Go. Escribió desde ceros una red de Go 9x9 de 1,48 millones de pesos que, con 50 pases hacia delante, superó a una red PPO del mismo tamaño.
- Un fallo. A partir de los pesos únicamente, no pudo distinguir cuál de dos copias de Gemma 3 270M había sido entrenada para ser sicofante. Con acceso a los patrones de atención, eligió al sicofante en las tres parejas.
Los registros completos de los experimentos incluyen cada prompt, los resúmenes de razonamiento de Astra y cada fragmento de código que ejecutó.
Comprueba tú mismo la corrección del bucle de razonamiento de Qwen3.5-0.8B
La prueba más limpia es servir ambos checkpoints detrás de la misma API compatible con OpenAI y enviarles prompts idénticos. vLLM hace esto con un comando por modelo:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Ambos servidores responden al nombre qwen, así que un mismo cuerpo de solicitud funciona en cualquiera de los puertos. --max-model-len 34816 coincide con el ejemplo de la tarjeta del modelo.
Cada solicitud replica la configuración de muestreo de los autores y activa el razonamiento:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
El último valor \boxed{} es la respuesta, y finish_reason indica si el modelo se detuvo (stop) o se quedó sin tokens (length). Una finalización length es un bucle.
Si prefieres no ejecutar una GPU, puedes probar la API de GPT-6 Astra de la misma manera, o comparar modelos Qwen pequeños localmente con la configuración gratuita de Qwen3.5 en Ollama.
Deja que tu agente de programación pruebe ambos modelos con Apidog CLI
Calificar a mano veinte generaciones largas es trabajo para tu agente de programación. Apidog CLI proporciona al agente entornos, escenarios de prueba, ejecuciones basadas en datos e informes, y se ejecuta en tu máquina, así que los endpoints de localhost funcionan.
Instálalo y dale la habilidad a tu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a Claude Code, Codex, Cursor u OpenCode un prompt:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
El agente lee el esquema del payload, valida su JSON y luego ejecuta estos comandos:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d alimenta cada fila del CSV como una iteración. --timeout-request está en milisegundos, y una respuesta en bucle puede tardar minutos en consumir 32.768 tokens. -r cli,json imprime un resumen y escribe un informe JSON que el agente puede comparar. Las 10 preguntas provienen del conjunto de prueba de GSM8K.
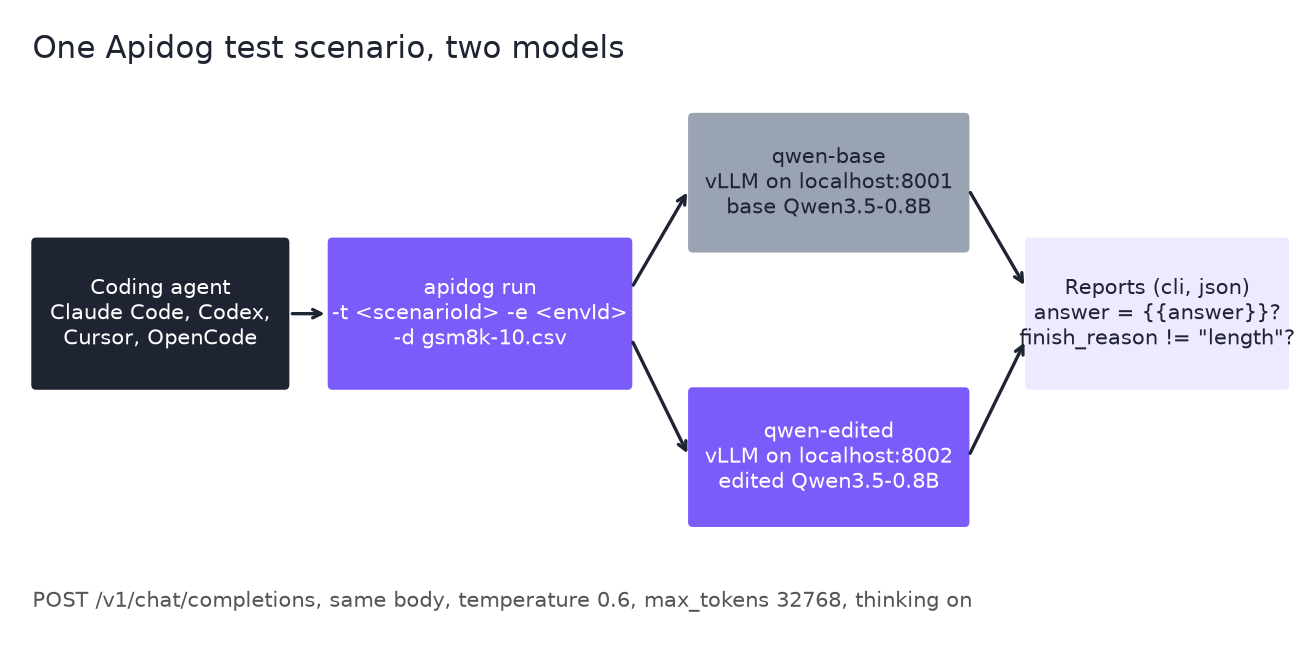
Si tu ejecución se parece a la de los autores, la mayoría de las respuestas base fallan la aserción de finish_reason y la mayoría de las editadas la pasan. Diez preguntas son una prueba rápida, no un benchmark, así que trata una diferencia como una señal, no como una puntuación. Añade --upload-report para ver la ejecución en la aplicación, y consulta la referencia del comando apidog run para conocer todas las opciones.
El mismo escenario sirve como prueba de regresión para cualquier cambio de modelo; la guía de CI/CD de Apidog CLI muestra la configuración de -r junit.
Qué significa esto si publicas modelos pequeños
- Mide el truncamiento, no solo la precisión. El 7,9 % de Qwen ocultaba un modelo que en su mayoría nunca terminaba. Una comprobación de
finish_reasondetecta eso. - Busca fallos con una única causa. Los bucles y la repetición pueden residir en una parte estrecha de una red.
- Recuerda el control. Si tu modelo se equivoca en lugar de quedarse atascado, una edición como esta no ayudará.
¿Eliges un nivel de GPT-6 para trabajo de agentes? Consulta GPT-6 Luna vs Sol vs Astra.
Preguntas frecuentes
¿GPT-6 Astra entrenó Qwen3.5-0.8B? No. Los autores no permitieron descenso de gradiente ni bucle de entrenamiento. Astra editó los pesos en una sesión de Python y observó el modelo solo mediante 10, 25 o 50 pases hacia delante.
¿Cuántos pesos cambió la edición? 131.072 pesos, que los autores sitúan en el 0,016 % del modelo. Los cambios están en las matrices down_proj de los MLP de las capas 15 y 19, 64 columnas de salida en cada una.
¿Está disponible el modelo editado? Sí, como RikiyaT/Qwen3.5-0.8B-weight-space-programming en Hugging Face bajo Apache 2.0, con hashes de los dos tensores modificados y una reejecución independiente (51,0 % en MATH-500).
¿Por qué subieron tanto las puntuaciones de matemáticas? Porque el modelo base entraba en bucle. En MATH-500, el 93,0 % de sus respuestas alcanzaron el límite de 32.768 tokens. La edición lo redujo al 33,1 %, de modo que el modelo terminó respuestas que ya podía resolver. No aprendió matemáticas nuevas.
¿Funciona la programación en el espacio de pesos en cualquier modelo? Todavía no, según los propios autores. En Gemma 3 270M, que rara vez entra en bucle, la mejor edición movió MATH-500 del 6,8 % al 7,7 %. Los autores califican todos sus resultados de muy iniciales.
¿Puedo probar el modelo editado sin escribir código? Sí. El Space de demostración de Hugging Face ejecuta ambos modelos con un problema que escribas. Para una comprobación repetible, usa vLLM junto con Apidog CLI como se muestra arriba.