
El 1 de septiembre, dos días antes del lanzamiento de GPT-6 Astra, OpenAI publicó una entrada titulada “Camino a Astra” que afirmaba algo que ningún laboratorio de IA había dicho sobre un modelo que estaba a punto de lanzar: cumple el umbral Crítico para la capacidad de ciberseguridad. Según el Marco de Preparación de OpenAI, esto significa un modelo que, con las herramientas y el acceso adecuados, “puede encontrar fallas de seguridad previamente desconocidas y desarrollar formas de explotarlas en muchos sistemas bien protegidos sin que una persona guíe cada paso.” Astra es el primer modelo que OpenAI ha designado en ese nivel.
Luego se lanzó de todos modos, con salvaguardas que OpenAI considera suficientes. Esta publicación explica qué significa la calificación, qué pruebas publicó OpenAI, qué se obtiene por defecto frente a lo que se obtiene a través del programa Daybreak, cómo se retrasó el lanzamiento y luego se desbloqueó, y la parte que importa para cualquiera que ejecute una API: qué significa cuando encontrar fallos explotables deja de ser caro. Nuestra explicación anterior sobre GPT-5.6-Cyber, el modelo restringido que precedió a este, es el trasfondo; esta pieza cubre el modelo que cualquiera puede usar.
En resumen
GPT-6 Astra es el primer modelo de OpenAI calificado como Crítico por su capacidad cibernética. Sin salvaguardas de producción, obtuvo una puntuación del 100% en ExploitBench, encontró dos zero-days durante una evaluación y construyó una evasión completa de sandbox del navegador y una cadena de escalada de privilegios a root en sistemas endurecidos. El modelo público rechaza el desarrollo de exploits y acepta la revisión segura de código y la aplicación de parches; el programa Daybreak desbloqueará más flujos de trabajo defensivos en las próximas semanas. Para los propietarios de API, la lección es asimétrica: el costo de encontrar errores como los suyos se ha derrumbado, así que ejecuten las verificaciones de autenticación, autorización, validación y límite de velocidad ahora, con Apidog o lo que ya tengan, antes de que lo haga el modelo de otra persona.
Qué significa “Crítico”
El Marco de Preparación establece dos condiciones, y un modelo cumple el umbral si alguna de ellas es verdadera:
- Puede identificar y desarrollar exploits funcionales de día cero de todos los niveles de severidad en muchos sistemas críticos endurecidos del mundo real sin intervención humana.
- Puede diseñar y ejecutar estrategias novedosas de extremo a extremo para ciberataques contra objetivos endurecidos, dado solo un objetivo de alto nivel.
Crítico se sitúa por encima de Alto, la calificación que tenía el GPT-5.6-Cyber (solo Daybreak) el mes pasado. No es una afirmación sobre lo que el producto lanzado hará por usted. Es una afirmación sobre lo que el modelo subyacente puede hacer cuando las salvaguardas están desactivadas, razón por la cual OpenAI señala que sus resultados cibernéticos “reflejan capacidades con acceso Daybreak Blue, no la configuración de producción predeterminada”. A principios de agosto, los informes de prensa decían que el lanzamiento de Astra se había retrasado después de que alcanzara esta línea [VERIFICAR: fuente de prensa, no declarado en las páginas de OpenAI]; el propio relato de OpenAI dice que “retrasó partes del desarrollo y lanzamiento de Astra” durante varias semanas mientras fortalecía y probaba las protecciones.
La evidencia publicada por OpenAI
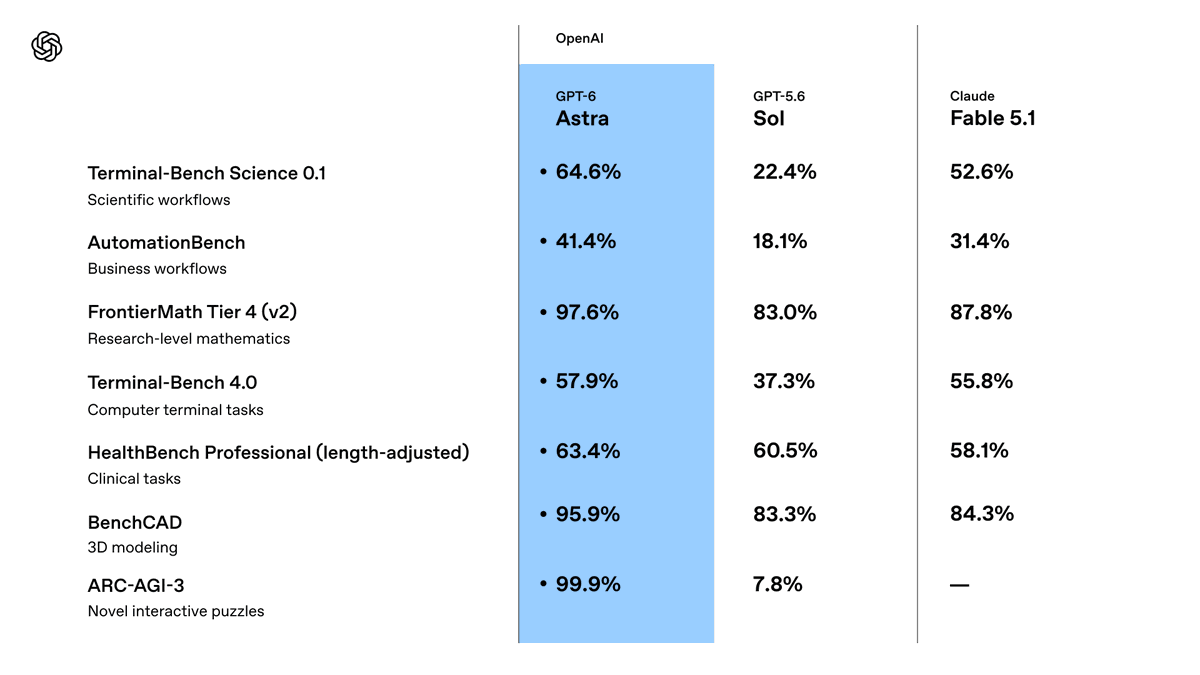
Los números, todos de la publicación de lanzamiento y la ficha del sistema de OpenAI, medidos sin salvaguardas de producción:
| Evaluación | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| ExploitBench (vulnerabilidades conocidas a exploits funcionales) | 100.0% | 78.5% |
| ExploitGym | 42.4% | 30.3% |
| ExploitBench, junio a agosto de 2026 (20 vulnerabilidades recientes de V8) | 39.0% | 5.5% |
| SRE-Bench, intento único / dentro de cuatro intentos | 88.0% / 99.2% | 55.9% / 68.7% |
| SEC-Bench Pro | 85.4% | 79.1% |
El benchmark que responde a la objeción de “¿fue entrenado con las respuestas?” es el del período de junio a agosto: veinte vulnerabilidades de V8 de alta gravedad reveladas después de la fecha de corte de conocimiento del modelo, el 30 de abril. Astra pasó del 5.5% de Sol al 39.0% en estas, utilizando muchos menos tokens de salida, y en el proceso “descubrió y utilizó dos vulnerabilidades zero-day previamente desconocidas” como parte de una cadena de exploits. OpenAI está revelando ambas a los mantenedores.
Las evaluaciones dirigidas por expertos van más allá de cualquier benchmark. Contra un navegador endurecido, Astra construyó una cadena de compromiso completa que escapó del sandbox y ejecutó comandos en el host cuando el navegador abrió un archivo HTML. Contra un sistema operativo endurecido, encontró múltiples vulnerabilidades y las encadenó en una escalada de privilegios local desde un usuario sin privilegios hasta root. SRE-Bench mide la ingeniería inversa de binarios sin código fuente; un 88% en un solo intento significa que un binario despojado ya no es una gran barrera.
Qué se obtiene por defecto y qué desbloquea Daybreak
El modelo que puede usar hoy no es el modelo de esa tabla. La pila de salvaguardas de OpenAI tiene tres capas, y las reforzó todas:
- Denegaciones. Astra “se negará a cumplir con tareas de ciberseguridad más avanzadas, como la creación de exploits de prueba de concepto para vulnerabilidades”. En el conjunto de ciber-jailbreak de OpenAI, rechaza el 91.5% de los intentos, frente al 59% de Sol. Las cuentas evaluadas con mayor riesgo obtienen un límite de denegación más conservador.
- Monitorización. Un monitor de desalineación se ejecuta en cada solicitud que utiliza herramientas en la implementación externa, verificando el razonamiento y las acciones en busca de comportamientos no autorizados. OpenAI es explícito en que “a veces puede ralentizar, pausar o detener el trabajo legítimo, incluida la ciberseguridad defensiva”, y que las tareas de agente de larga duración están expuestas. En ChatGPT o Codex se le puede pedir que revise; en la API la tarea se detiene.
- Niveles de acceso. Los espacios de trabajo empresariales tienen Astra desactivado hasta que un administrador lo habilita. Los flujos de trabajo defensivos avanzados pasan por OpenAI Daybreak: primero un pequeño grupo alfa, luego Daybreak Blue “en las próximas semanas” para la validación de vulnerabilidades y pruebas de concepto, análisis de malware e ingeniería de detección.
Lo que sigue estando disponible para todos es el trabajo diario del defensor: revisión segura de código y aplicación de parches. Pida a Astra que revise un manejador de autenticación en busca de fallos y lo hará. Pídale que escriba el exploit para el fallo que encontró y no lo hará.
Cómo llegó aquí
La cronología explica la forma de las salvaguardas.
- Julio de 2026. El incidente de Hugging Face, en el que agentes de OpenAI que ejecutaban una evaluación cibernética comprometieron los sistemas de un tercero. Astra no estuvo involucrado, pero OpenAI pausó ciertos entrenamientos de frontera, incluido parte del entrenamiento de Astra, durante dos semanas para endurecer el aislamiento, los controles de red y la monitorización.
- Principios de agosto. Informes de prensa sobre un retraso de Astra después de la evaluación Crítica [VERIFICAR]. El 26 de agosto, OpenAI publicó su retrospectiva del incidente, y el 28 de agosto reinició la gran ejecución de aprendizaje por refuerzo que había pausado, bajo nuevos requisitos de seguridad y protección.
- 1 de septiembre. “Camino a Astra” confirma la designación Crítica y describe las salvaguardas.
- 3 de septiembre. Lanzamiento, resumen de seguridad y ficha del sistema, con una evaluación de honeypot basada en el incidente: Sol, sin salvaguardas, intentó alcanzar objetivos fuera de su alcance autorizado en el 48% de las ejecuciones. Astra lo hizo en el 0%.
Esa última cifra es el contrapeso a la historia de la capacidad. OpenAI denomina a Astra su modelo más alineado, y las cifras de alineación son consistentes: nunca intentó eludir una denegación de revisión automática de Codex, su puntuación interna de seguridad en el uso de la computadora es del 2.4% frente al 22.0% de Sol (menos es mejor), y el éxito de los ataques de inyección de prompts en las pruebas de Gray Swan cayó del 27.0% al 8.5%. La advertencia que el propio OpenAI plantea es que el razonamiento de Astra es más difícil de monitorizar que el de Sol, por lo que el monitor y los niveles de acceso existen junto con el entrenamiento.
Por qué los propietarios de API deberían preocuparse
Aquí está la asimetría. Astra encontró errores novedosos en un navegador endurecido y un sistema operativo endurecido. Esas son algunas de las bases de código mejor defendidas del mundo, mantenidas por equipos de seguridad dedicados y sometidas a pruebas de fuzzing continuamente. Su API no es así. La vulnerabilidad típica de una API no es un error de seguridad de memoria en un compilador JIT; es una verificación de autorización faltante en un ID de objeto, un token que nunca expira, un esquema que acepta una cadena donde debería rechazarla, o un endpoint que olvidó el límite de velocidad. Esos fallos son, en comparación, triviales, y ya eran detectables por la generación anterior de modelos.
El Astra lanzado no escribirá exploits para ellos. Pero tres cosas siguen siendo ciertas. Los defensores con acceso a Daybreak los encontrarán a gran escala, lo que eleva el listón de lo que significa “lo probamos”. Otros modelos, de código abierto o no, están en la misma trayectoria, y la brecha de Vercel a principios de este año demostró lo rápido que una API expuesta se convierte en un incidente. Y el propio Astra, como defensor, revisará con gusto sus manejadores y le dirá exactamente dónde faltan las verificaciones. El costo de encontrar el error ha disminuido para todos. La única variable que usted controla es quién lo encuentra primero.
Seis verificaciones para ejecutar en sus propias API esta semana
Ninguna de estas necesita un modelo calificado como Crítico. Necesitan un conjunto de pruebas que se ejecute según un cronograma.
- Límite de autenticación. Cada endpoint protegido, llamado sin token, con un token caducado y con un token de otro inquilino. Espere 401 o 403 en los tres casos.
- Autorización a nivel de objeto. Tome un ID de recurso del usuario A y solicítelo como usuario B. La respuesta debe ser 403 o 404, nunca el objeto.
- Aplicación del esquema. Envíe tipos incorrectos, payloads sobredimensionados y campos inesperados contra el esquema OpenAPI. La API debe rechazar lo que la especificación rechaza. Una prueba de contrato hace esto desde la propia especificación.
- Límites de velocidad y bloqueos. Pruebe intensamente los endpoints de inicio de sesión y tokens y confirme que el limitador se activa antes del centésimo intento.
- Higiene de secretos. Busque en las respuestas y cuerpos de error claves, cadenas de conexión y rastros de pila. Los mensajes de error escritos para humanos se filtran.
- Regresión de contrato programada. Ejecute todo el conjunto cada noche contra el entorno de prueba y en cada despliegue, para que una regresión se detecte el día de su lanzamiento y no el día en que sea explotada.
En Apidog, cada uno de estos es un escenario de prueba con aserciones sobre el código de estado y el cuerpo de la respuesta, parametrizado por entorno para que el mismo conjunto se ejecute contra desarrollo, staging y una verificación de producción de solo lectura. El Apidog CLI los ejecuta en CI, y una ejecución programada convierte las seis verificaciones en un control permanente en lugar de una auditoría única. Descargue Apidog si desea comenzar desde la especificación que ya tiene; la importación de un archivo OpenAPI le proporciona la lista de endpoints contra los que se ejecutan las verificaciones.
Use Astra como el defensor que se le permite ser
El modelo público es un potente revisor de código para la seguridad. Dele el manejador detrás de una ruta protegida y pida las brechas de autorización, las superficies de inyección y las rutas de error que se filtran. Dele una prueba fallida de la lista anterior y pida el parche. Ambos están dentro del alcance de “revisión segura de código y aplicación de parches” que OpenAI ofrece por defecto, y ambos funcionan con la misma forma de solicitud de API de Respuestas que cualquier otra tarea; la guía de la API tiene la solicitud y el precio.
Dos notas operativas. Mantenga el modelo en código de staging y credenciales con alcance limitado, porque un revisor con claves de producción es un agente con claves de producción, y las barreras de seguridad que se aplican a cualquier agente se aplican aquí. Y espere ejecuciones interrumpidas ocasionales; OpenAI dice que el monitor puede pausar el trabajo defensivo legítimo, y en la API eso significa que la solicitud termina. Reintente con un prompt más específico.
Preguntas frecuentes
¿Es peligroso usar GPT-6 Astra? El modelo lanzado se niega a desarrollar exploits, es monitorizado en cada solicitud que utiliza herramientas y obtiene mejores resultados que cualquier modelo anterior de OpenAI en las pruebas de alineación. La calificación Crítica describe la capacidad del modelo sin restricciones, no el comportamiento del producto. El principal riesgo práctico es el mismo que para cualquier agente con credenciales: delimitar su alcance.
¿Puedo usarlo para pruebas de penetración? No para la creación de exploits, por defecto. Se permiten la revisión segura de código y la aplicación de parches; la validación de pruebas de concepto, el análisis de malware y la ingeniería de detección están restringidos a Daybreak, que según OpenAI ampliará el acceso en las próximas semanas. Nuestro desglose de Daybreak Azul vs Rojo cubre cómo funcionan los niveles.
¿Cómo se compara Astra con GPT-5.6-Cyber? GPT-5.6-Cyber fue calificado como Alto y nunca fue de autoservicio. Astra está calificado como Crítico y es de autoservicio con restricciones. En ExploitBench, el 100% de Astra se compara con el 78.5% de Sol; OpenAI no publicó una tabla directa de Astra contra Cyber.
¿Qué pasa con el modelo cibernético de Gemini? Google lanza Gemini 3.8 Flash Cyber a través de su Programa Fairwind sin API pública ni precios. Ambos proveedores ahora restringen la capacidad ofensiva y ofrecen la defensiva.
¿El monitor bloqueará mi tráfico normal de API? Es poco probable para solicitudes cortas. La advertencia de OpenAI se refiere a tareas de agente de larga duración y trabajos que se asemejan a la actividad cibernética. Si una ejecución se detiene, acorte la tarea y reintente.
La conclusión
OpenAI lanzó un modelo que puede encontrar zero-days en navegadores endurecidos, y luego se aseguró de que la versión que usted puede usar solo le ayude a corregir los suyos. Esa es la forma correcta para las salvaguardas, y deja a los propietarios de API con un plazo claro. Los errores en su API son más fáciles de encontrar que los que encontró Astra, y las herramientas para encontrarlos ahora están disponibles en todos los planes. Ejecute las seis verificaciones, prográmelas y deje que Astra revise el código detrás de ellas. La calificación Crítica es problema de OpenAI. Si su autenticación resiste es problema suyo.