
GPT-6.2 Astra vs Claude Fable 5.2 se reduce a esto: ambos cuestan $8 por millón de tokens de entrada y $40 por millón de tokens de salida, ambos ofrecen alrededor de un millón de tokens de contexto y 128K de salida, y ambos apuntan a trabajo de codificación agéntica de larga duración. Las diferencias que deciden tu elección son el precio de la caché, la facturación de contextos largos, las peculiaridades de la API que tu harness de agente debe manejar, y cómo se comporta cada modelo en tus propias tareas.
OpenAI lanzó GPT-6.2 Astra el 17 de noviembre de 2026, ocho días después de que Anthropic publicara Claude Fable 5.2. Esta guía cubre las especificaciones, el costo de una sesión real de agente, los errores de petición que rompen un harness construido para el otro modelo, y cómo probar ambos con Apidog CLI.
GPT-6.2 Astra vs Claude Fable 5.2: el veredicto rápido
Elige Claude Fable 5.2 si tu agente envía prompts largos y relee un gran contexto en caché, porque sus lecturas de caché cuestan la mitad y su ventana completa de 1M se factura a la tarifa estándar. Elige GPT-6.2 Astra si tu stack ya vive en la API de Responses de OpenAI y quieres sus herramientas alojadas, como apply_patch, shell alojado y subagentes multiagente. Para cualquier otro caso, ejecuta ambos en tus propias tareas antes de decidirte.
Las primeras reseñas se inclinan hacia Fable en capacidad pura. Simon Willison escribió el día del lanzamiento que Astra "no puntúa tan alto como Fable 5.2 en varios benchmarks" y que algunos testers encuentran su estilo de comunicación confuso. Tómalo como una señal para probar, no como un veredicto.
¿Cómo se comparan GPT-6.2 Astra y Claude Fable 5.2 en especificaciones y precio?
Ambos modelos listan el mismo precio base, así que la comparación está en los detalles. Cada número a continuación proviene de la página del modelo GPT-6.2 Astra y la descripción general de Claude Fable 5.2, verificados el 18 de noviembre de 2026.
| Especificación | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| ID del modelo en la API | gpt-6.2-astra |
claude-fable-5-2 |
| Lanzamiento | 17 nov 2026 | 9 nov 2026 |
| Entrada / salida por 1M de tokens | $8 / $40 | $8 / $40 |
| Entrada en caché (lectura de caché) | $0.40 | $0.20 |
| Escritura de caché | $10 (30 min), $20 (12 h) | $10 (5 min), $16 (1 h) |
| Ventana de contexto | 1,050,000 (922,000 de entrada máxima) | 1M |
| Salida máxima | 128,000 | 128K |
| Prompts largos | Más de 272K de entrada: entrada 2x, salida 1.5x | 1M completo a precio estándar |
| Batch | 50% de descuento | 50% de descuento |
| Corte de conocimiento | 18 mayo 2026 | junio 2026 |
| Control de razonamiento | reasoning.effort (none rechazado) |
effort, por defecto high, thinking siempre activo |
Ambos precios bajaron un 20% respecto a la generación anterior. GPT-6 Astra y Claude Fable 5 costaban ambos $10 / $50, como señala Willison. Si todavía usas el modelo anterior, la guía de la API de GPT-6 Astra y el desglose de precios de Claude Fable 5.2 cubren qué cambió.
¿Cuánto cuesta realmente una sesión de agente de codificación?
Un agente de codificación rara vez envía un solo prompt corto. Recarga el contexto del repositorio, las definiciones de herramientas y el historial de conversación en cada turno, por lo que las lecturas de caché y las reglas de prompts largos importan más que el precio destacado.
Aquí tienes dos cargas de trabajo de ejemplo con precios de las tarifas oficiales, con procesamiento Standard.
| Carga de trabajo | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Sesión de agente: 150K tokens escritos en caché, 1.35M lecturas de caché, 150K de salida (cada petición por debajo de 272K) | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| Una petición larga: 400K de entrada, 8K de salida, sin caché | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
El costo de la sesión es similar porque la salida lo domina: 150K tokens de salida cuestan $6.00 en ambos modelos. La diferencia en lecturas de caché ahorra 27 centavos aquí y crece con sesiones más largas.
La petición larga única es donde las facturas se separan. Una vez que una petición de Astra supera los 272K tokens de entrada, OpenAI duplica la tarifa de entrada a $16 y sube la salida a $60 para toda la petición. Fable 5.2 factura un prompt de 400K a la misma tarifa de $8 que un prompt de 4K.
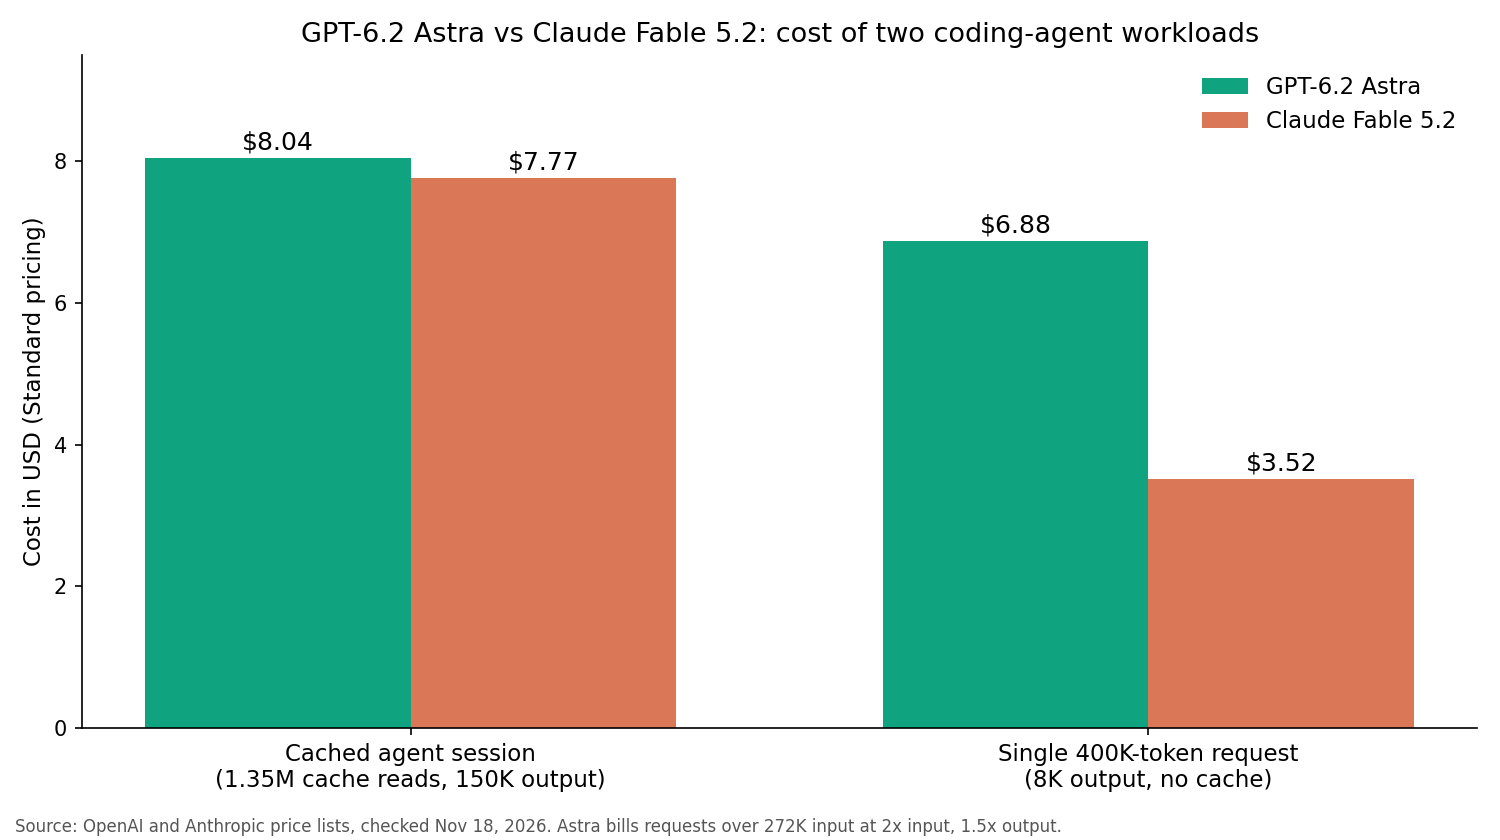
Si tu agente mete un monorepo grande o logs extensos en una sola petición, mantenla por debajo de 272K en Astra o espera pagar casi el doble.
¿Qué peculiaridades de la API romperán un harness construido para el otro modelo?
Cambiar de modelo es más que modificar la cadena del modelo. Cada API rechaza ajustes que la otra acepta, y ambos fallos regresan como errores HTTP 400.
Claude Fable 5.2 rechaza:
- Uso forzado de herramientas. Establecer
tool_choiceenanyotooldevuelve un 400, según las notas de Fable 5.2 de Anthropic. - Parámetros de muestreo. Omite
temperature,top_pytop_k; los valores que Anthropic lista devuelven un 400. - Desactivar el thinking. El thinking adaptativo está siempre activo, así que el parámetro effort es tu única palanca para profundidad, latencia y costo.
GPT-6.2 Astra rechaza:
reasoning.effortestablecido ennone(API de Responses) oreasoning_effort: "none"(Chat Completions), según la guía de razonamiento de OpenAI.- Los endpoints de Realtime, Assistants y fine-tuning, que la página del modelo lista como no compatibles.
Si tu harness fuerza una llamada a herramienta para obtener salida estructurada, eso funciona en Astra y falla en Fable; mueve la estructura al prompt o al esquema de la herramienta. Si establece temperature: 0, elimínalo para Fable.
El manejo de datos también difiere. Anthropic indica que Fable 5.2 requiere una retención de datos de 30 días y no está disponible con retención cero de datos a menos que Anthropic lo autorice expresamente. Verifica eso contra tu política de seguridad antes de enrutar código de producción a través de él.
¿Dónde gana GPT-6.2 Astra?
La fortaleza de Astra es la caja de herramientas que lo rodea. En la API de Responses, OpenAI lista apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills y tool_search como herramientas compatibles. Una beta multiagente permite que Astra delegue trabajo a subagentes.
Eso importa si prefieres no construir tu propio aplicador de parches y ejecutor de shell.
El feedback previo al lanzamiento de Theo Browne, citado por Willison, dice que Astra "puede incorporar muchos subagentes y gestionarlos bastante bien" en tareas largas, pero a veces se detiene a preguntar sobre detalles internos que un usuario no podría responder. Dale condiciones de parada claras.
Astra también ofrece más niveles de costo: Batch con 50% de descuento, modo Fast a 2x de Standard, y ventanas en segundo plano un 30% por debajo de Standard para finalización en 2 horas y un 40% por debajo para finalización en 8 horas. La generación de pruebas durante la noche puede ejecutarse en ellas por menos.
¿Dónde gana Claude Fable 5.2?
Fable gana en contextos largos con mucho uso de caché. Sus lecturas de caché cuestan $0.20 por millón de tokens, el 2.5% del precio de entrada, y su ventana completa de 1M se factura a la tarifa estándar sin multiplicador por prompts largos.
Anthropic posiciona Fable 5.2 para sesiones de agente que duran horas. Su control de effort va de low a max; Anthropic sugiere empezar en high, el valor por defecto, y subir a xhigh solo donde hayas medido una ganancia.
También tiene la recepción temprana más fuerte en codificación creativa difícil. En la prueba de lanzamiento de Willison, un prompt de animación con Three.js ejecutado en ambos nuevos modelos de OpenAI con esfuerzo Ultra en Codex CLI, ninguno igualó el resultado que obtuvo de Fable 5.2.
Fable también funciona en Amazon Bedrock, Google Cloud y Microsoft Foundry, y su modo Fast ofrece hasta 2.5x mayor velocidad de salida a $16 / $80 por millón de tokens. Para ejemplos de peticiones, consulta la guía de la API de Claude Fable 5.2.
¿Cómo pruebas GPT-6.2 Astra y Claude Fable 5.2 en tu propia carga de trabajo de API?
Los benchmarks miden las tareas de otra persona. Ejecuta los mismos prompts a través de ambas APIs en su lugar:
- Elige de 5 a 10 prompts reales del historial de tu agente, como una corrección de bug, un refactor y una tarea de escritura de pruebas.
- Escribe una petición por modelo con contenido idéntico, usando el formato propio de cada API.
- Verifica un estado 200, una respuesta no vacía y la estructura que tu agente procesa.
- Ejecuta cada petición varias veces y compara tokens, latencia y tasa de éxito.
Ambas llamadas son HTTP simple. Aquí está la petición de Astra en la API de Responses:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 va a través de la API de Messages de Anthropic con claude-fable-5-2 como modelo y sin campo temperature.
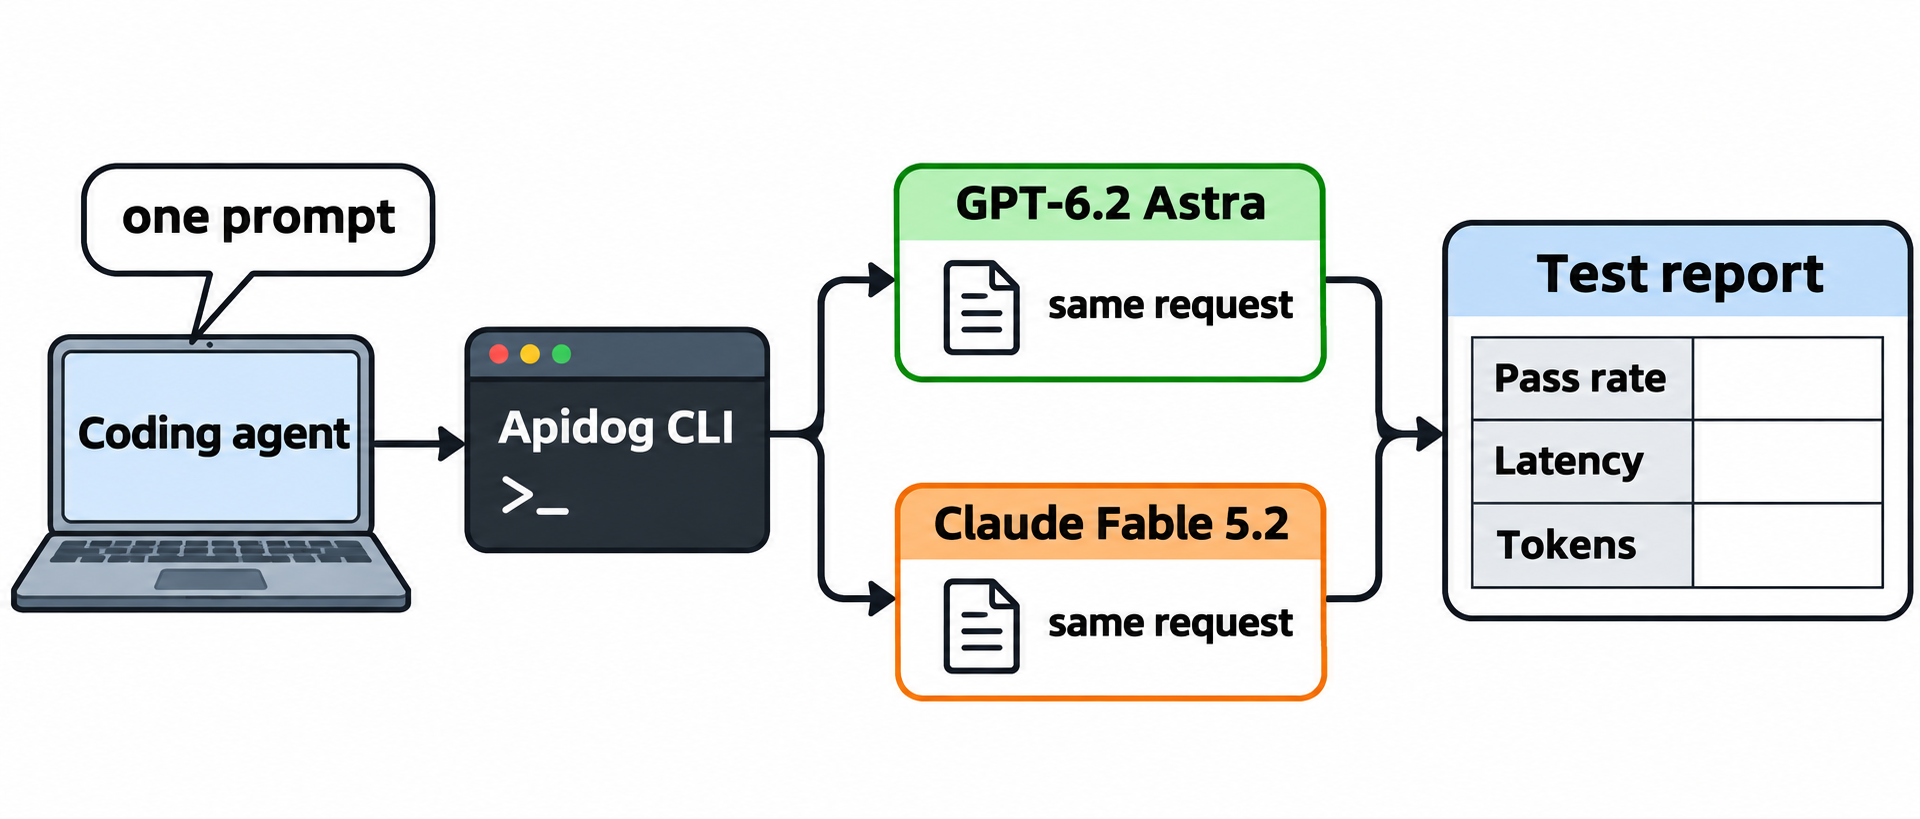
Deja que tu agente de codificación ejecute el A/B con Apidog CLI
Ejecutar pares de peticiones a mano se vuelve tedioso rápido. Deja que Claude Code, Codex o Cursor manejen Apidog CLI en su lugar. La configuración toma tres comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # elige tu agente cuando se te pregunte
Luego dale a tu agente un solo prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
El agente verifica el esquema del payload, escribe los casos y los ejecuta. Las opciones a continuación provienen de apidog run --help en CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 repite cada caso cinco veces, para que una respuesta lenta no decida el resultado. Agrega --upload-report para ver las ejecuciones en la app de Apidog. Esta es una plantilla de flujo de trabajo; no la hemos ejecutado contra Astra desde esta máquina.
También puedes convertir la sección de peculiaridades en pruebas. Pide al agente un caso negativo que envíe tool_choice: any a Fable y espere un 400, y otro que envíe effort: none a Astra y espere un 400. Si algún proveedor cambia la regla, tu suite te lo dirá antes que tu agente. La guía de Apidog CLI en Claude Code y la guía de Apidog CLI en Codex cubren la configuración del agente.
El plan gratuito de Apidog cubre hasta 4 usuarios, lo suficiente para ejecutar esta comparación.
FAQ
¿GPT-6.2 Astra es más barato que Claude Fable 5.2? El precio base es idéntico: $8 de entrada y $40 de salida por millón de tokens. Fable es más barato en lecturas de caché ($0.20 vs $0.40) y en cualquier petición de más de 272K tokens de entrada, donde Astra duplica su tarifa de entrada.
¿Qué modelo tiene la ventana de contexto más grande? Astra lista 1,050,000 tokens de contexto con un límite de entrada de 922,000 tokens. Fable 5.2 lista 1M de tokens. Ambos limitan la salida a 128K tokens por petición.
¿Puedo usar llamadas forzadas a herramientas con Claude Fable 5.2? No. Un tool_choice de any o tool devuelve un error 400. Deja que el modelo elija las herramientas por sí mismo y describe la estructura esperada en el prompt o en el esquema de la herramienta.
¿Puedo desactivar el razonamiento en GPT-6.2 Astra? No. La API rechaza reasoning.effort establecido en none con un error 400. En su lugar, elige un nivel de effort soportado más bajo para llamadas rápidas y económicas.
¿En qué modelo debería ejecutar mi agente de codificación? Empieza por tu carga de trabajo. Los prompts largos con mucho uso de caché favorecen a Fable 5.2, mientras que los stacks nativos de OpenAI que quieren herramientas alojadas de parches, shell y subagentes favorecen a Astra. Ejecuta ambos con de 5 a 10 prompts reales antes de cambiar.