
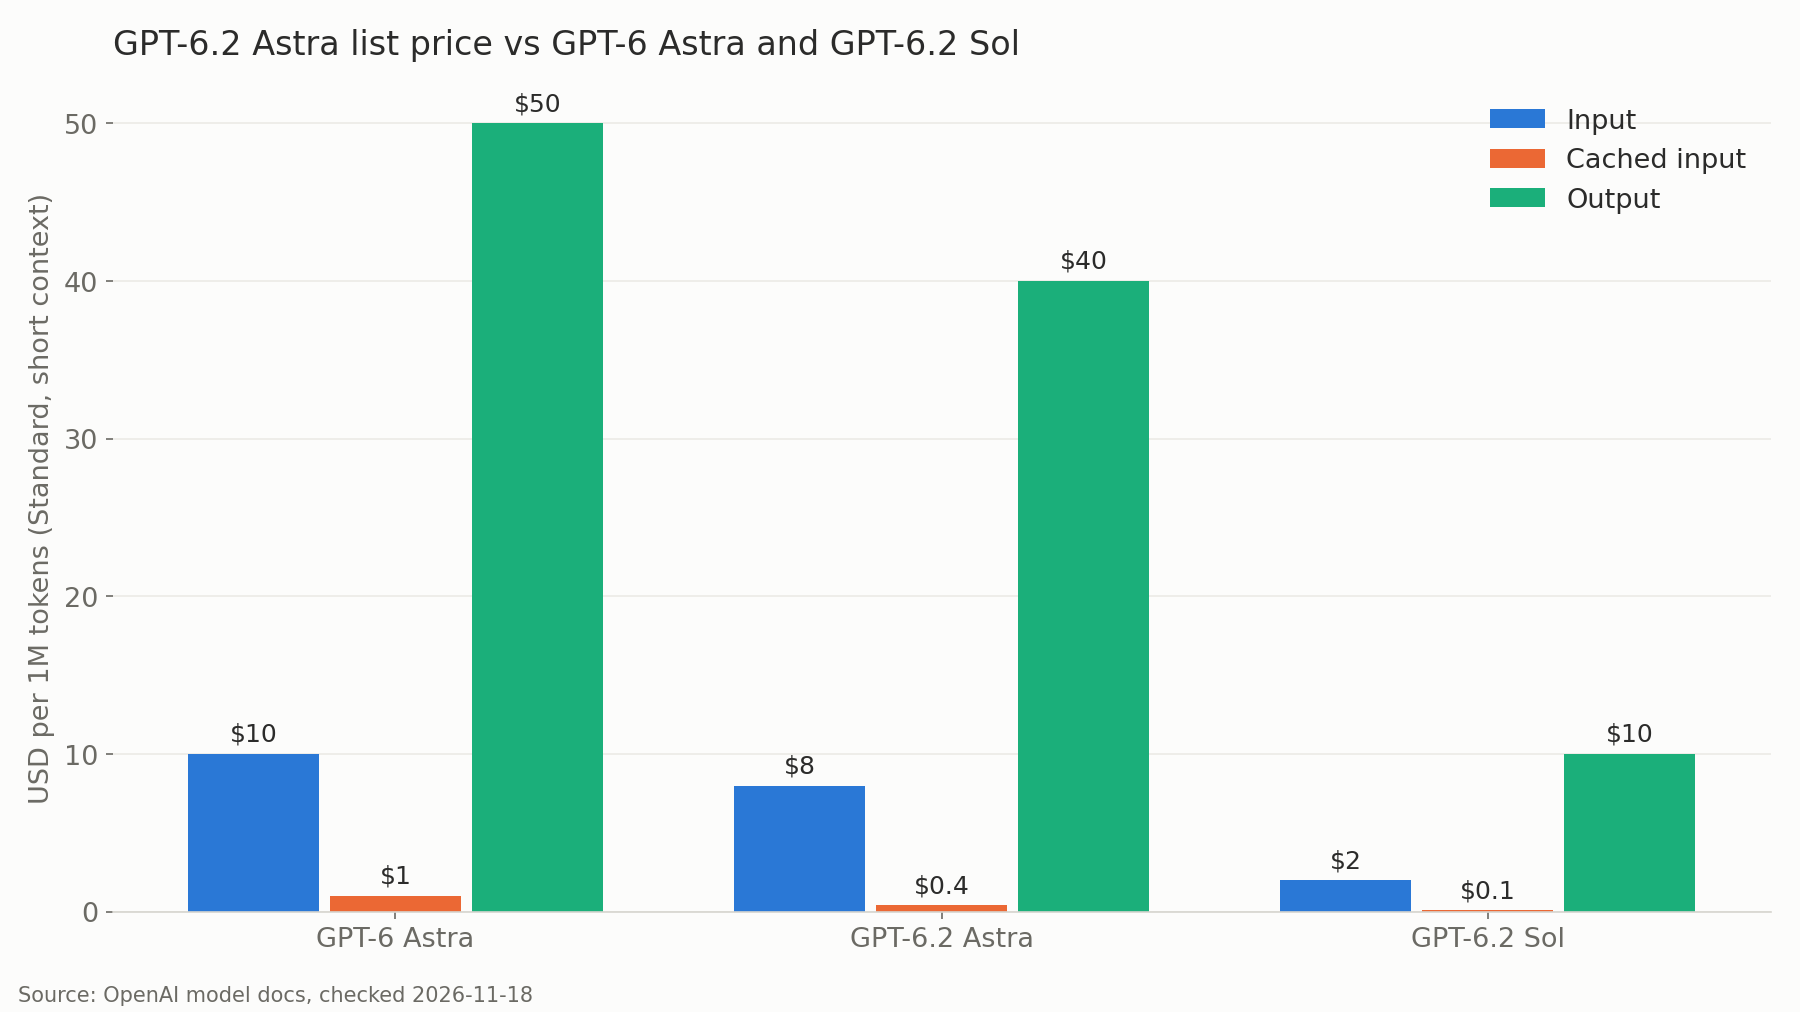
El precio de GPT-6.2 Astra es de $8 por cada 1M de tokens de entrada y $40 por cada 1M de tokens de salida en el nivel Standard de OpenAI, con la entrada en caché a $0.40 por 1M. Eso es un 20 % menos que GPT-6 Astra ($10/$50), y la tarifa de lectura de caché cayó un 60 %. Su modelo hermano, GPT-6.2 Sol, cuesta $2 de entrada y $10 de salida por cada 1M de tokens.
OpenAI lanzó ambos modelos el 17 de noviembre de 2026 como gpt-6.2-astra y gpt-6.2-sol.
Precios de GPT-6.2 Astra de un vistazo
GPT-6.2 Astra es el modelo frontera de OpenAI para proyectos largos y complejos: programación, uso de computadora y trabajo con documentos, con una ventana de contexto de 1.050.000 tokens y hasta 128.000 tokens de salida. En el nivel Standard factura $8 por cada 1M de tokens de entrada, $0.40 por cada 1M de tokens de entrada en caché y $40 por cada 1M de tokens de salida, para prompts de hasta 272K tokens.
| Tarifa (por 1M de tokens, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Entrada | $8.00 | $2.00 | $10.00 |
| Entrada en caché | $0.40 | $0.10 | $1.00 |
| Escritura en caché (30 minutos) | $10.00 | $2.50 | $12.50 |
| Escritura en caché (12 horas) | $20.00 | $5.00 | $25.00 |
| Salida | $40.00 | $10.00 | $50.00 |
Los tokens de razonamiento se facturan como tokens de salida. Esto importa en Astra, porque el modelo rechaza las solicitudes que establecen el esfuerzo de razonamiento en none, por lo que cada llamada conlleva cierto costo de razonamiento además de la respuesta visible.
Costo de la API de GPT-6.2 Astra por token
Un token de entrada cuesta $0.000008 y un token de salida cuesta $0.00004. La salida vale 5 veces el precio de la entrada, por lo que lo que el modelo escribe, incluido el razonamiento oculto, es lo que impulsa la mayor parte de tu factura.
Una solicitud de chat típica con 3.000 tokens de entrada y 800 tokens de salida cuesta:
- GPT-6.2 Astra: $0.024 de entrada + $0.032 de salida = $0.056
- GPT-6.2 Sol: $0.006 + $0.008 = $0.014
- GPT-6 Astra: $0.030 + $0.040 = $0.070
Escala eso a una aplicación que atiende 20.000 solicitudes de este tipo al día. En 30 días son 600.000 solicitudes: unos $33.600 con GPT-6.2 Astra, $8.400 con GPT-6.2 Sol y $42.000 con GPT-6 Astra. Sol mantiene el mismo precio de lista de $2/$10 que GPT-6 Sol y GPT-6.1 Sol, así que si ya presupuestaste para Sol, nada cambia.
Precios de caché de GPT-6.2 Astra: el mayor cambio
El recorte principal es del 20 %, pero el recorte en caché es mayor. Las lecturas en caché de GPT-6.2 Astra cuestan $0.40 por 1M, es decir, 0.05x la tarifa de entrada. GPT-6 Astra cobraba $1.00, o 0.1x. La guía de caché de prompts de OpenAI confirma que la tarifa de lectura de 0.05x aplica a GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol y GPT-6.1 Terra.
Tres reglas determinan lo que pagas:
- Las escrituras reemplazan la entrada, no se acumulan. Un token escrito en caché se factura a la tarifa de escritura en lugar de la tarifa de entrada, nunca ambas. Una escritura de 30 minutos cuesta 1.25x la entrada ($10 en Astra); una escritura de 12 horas cuesta 2.5x ($20).
- El prefijo mínimo es de 1.024 tokens. Los prompts más cortos nunca se almacenan en caché.
- Las lecturas cuestan lo mismo en ambas duraciones. Elige escrituras de 12 horas solo para prompts de sistema estables y documentación de referencia reutilizados a lo largo de largos intervalos.
Con estas tarifas, el almacenamiento en caché se amortiza en el primer reuso. Una escritura de 30 minutos más una lectura cuesta 1.30x el precio sin caché de un prefijo, frente a 2x por enviarlo dos veces. En diez solicitudes es 1.70x frente a 10x.
Simon Willison calificó el precio en caché de "excelente noticia para sesiones de agentes de larga duración" en su artículo del día de lanzamiento. Para conocer tácticas, consulta nuestra guía sobre caché de prompts en GPT-6.
Cuánto cuesta una sesión de agente de 50 turnos
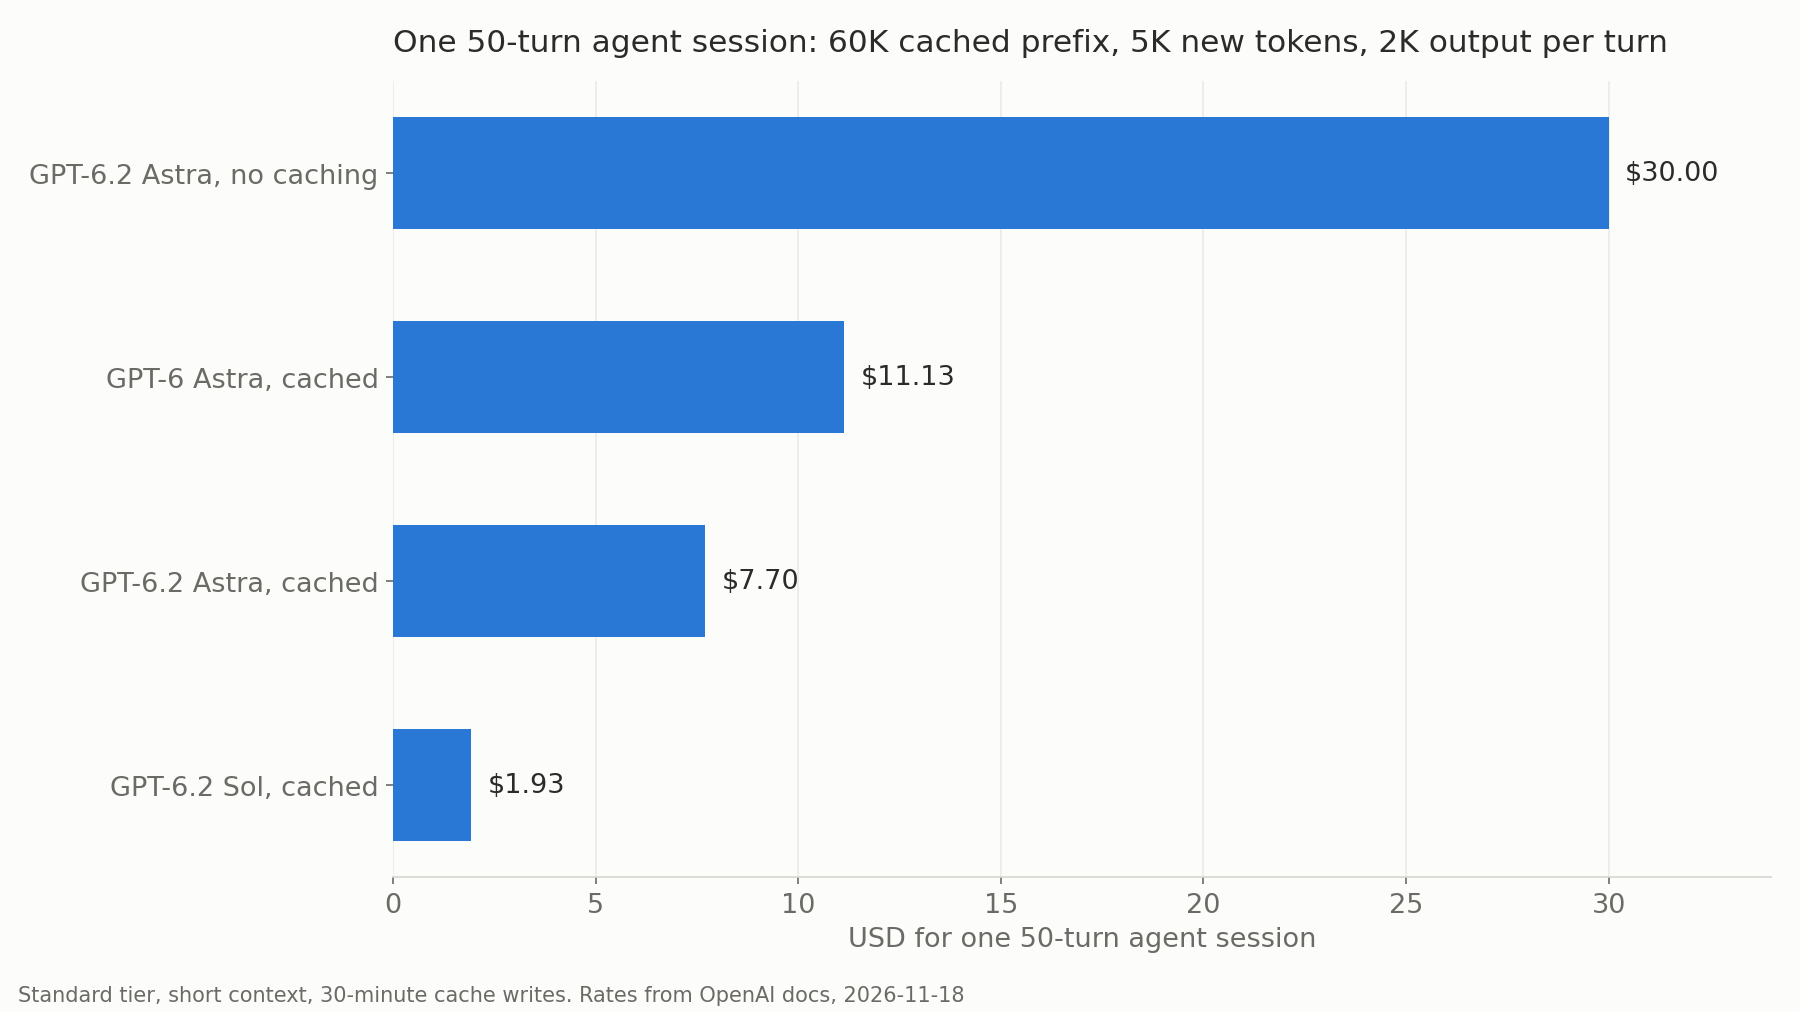
Tomemos un agente de programación que ejecuta 50 turnos. En cada turno relee un prefijo de 60K tokens desde la caché, escribe 5K tokens nuevos en una caché de 30 minutos y produce 2K tokens de salida.
| Modelo y configuración | Costo por turno | Costo por sesión |
|---|---|---|
| GPT-6.2 Astra, sin caché | $0.600 | $30.00 |
| GPT-6 Astra, con caché | $0.223 | $11.13 |
| GPT-6.2 Astra, con caché | $0.154 | $7.70 |
| GPT-6.2 Sol, con caché | $0.039 | $1.93 |
El almacenamiento en caché reduce la sesión de GPT-6.2 Astra un 74 %. Frente a GPT-6 Astra con la misma caché, el nuevo modelo es un 31 % más barato por sesión, más que el recorte de lista del 20 %, porque el prefijo en caché es la mayor parte de la entrada.
Precios de contexto largo por encima de 272K tokens
GPT-6.2 Astra acepta hasta 922.000 tokens de entrada, pero el precio cambia a partir de 272K. Una vez que la entrada de una solicitud supera los 272K tokens, las tarifas de entrada y caché se duplican y la salida sube a 1.5x, para toda la solicitud, no solo el excedente.
| Tarifa (por 1M de tokens) | Hasta 272K de entrada | Más de 272K de entrada |
|---|---|---|
| Entrada | $8.00 | $16.00 |
| Entrada en caché | $0.40 | $0.80 |
| Escritura en caché (30 minutos) | $10.00 | $20.00 |
| Salida | $40.00 | $60.00 |
Una revisión única de una base de código de 400K tokens con 4K de salida cuesta $6.40 + $0.24 = $6.64. Si recortas la misma revisión a 250K tokens, baja a $2.00 + $0.16 = $2.16. Si ejecutas la revisión de 400K repetidamente con 380K tokens servidos desde la caché y 20K tokens nuevos escritos, cuesta unos $0.94 por ejecución.
La recuperación y el recorte valen la pena cuando un prompt queda justo por encima de 272K.
Batch, ventanas en segundo plano, Fast y Ultrafast
La página de precios de OpenAI enumera GPT-6.2 Astra en cuatro niveles de procesamiento, además de ventanas en segundo plano con descuento. GPT-6.2 no aparece en la tabla Flex, por lo que las ventanas en segundo plano cubren ese rol para el trabajo que puede esperar.
| Nivel (contexto corto) | Astra entrada / salida | Sol entrada / salida |
|---|---|---|
| Standard | $8 / $40 | $2 / $10 |
| Batch (50 % de descuento) | $4 / $20 | $1 / $5 |
| Segundo plano, ventana de 8 horas (40 % de descuento) | $4.80 / $24 | $1.20 / $6 |
| Segundo plano, ventana de 2 horas (30 % de descuento) | $5.60 / $28 | $1.40 / $7 |
| Fast (2x) | $16 / $80 | $4 / $20 |
| Ultrafast, hasta el 28 de febrero de 2027 (3x) | $24 / $120 | $6 / $30 |
| Ultrafast, desde el 1 de marzo de 2027 (6x) | $48 / $240 | $12 / $60 |
Las ventanas en segundo plano son una beta pública en la API de Responses. Estableces background en true y background_options.completion_window en 2h o 8h, y dejas el streaming desactivado. La guía del modo en segundo plano señala dos inconvenientes: estas solicitudes comparten el límite de velocidad de Batch, y las solicitudes Standard no pueden reutilizar entradas de caché creadas por solicitudes de 2h u 8h.
Aquí tienes un trabajo nocturno que resume 10.000 documentos, cada uno con 4K tokens de entrada y 500 de salida:
| Nivel | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | $520 | $130 |
| Segundo plano, 2 horas | $364 | $91 |
| Segundo plano, 8 horas | $312 | $78 |
| Batch | $260 | $65 |
La tarifa de 3x de Ultrafast es una promoción; el 1 de marzo de 2027 se duplica a 6x, así que no la incluyas en tu presupuesto.
GPT-6.2 Astra frente a GPT-6.2 Sol y otros modelos insignia rivales
Astra cuesta exactamente 4 veces lo que Sol en cada línea. La página del modelo de Sol lista el mismo contexto de 1.050.000 tokens, el mismo límite de 128.000 tokens de salida, las mismas herramientas y los mismos límites de velocidad. Así que la elección se reduce a la calidad por tarea, no a las funciones.
| Modelo (por 1M de tokens) | Entrada | Lectura en caché | Salida |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| Claude Fable 5.2 | $8.00 | $0.20 | $40.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Los precios de Claude provienen de la página de precios de Anthropic, verificados el 18 de noviembre de 2026. GPT-6.2 Astra y Claude Fable 5.2 comparten el mismo precio de lista de $8/$40; los aciertos de caché de Fable 5.2 cuestan $0.20 y sus tarifas de escritura siguen las duraciones de 5 minutos y 1 hora de Anthropic, no las de 30 minutos y 12 horas de OpenAI, así que compara el costo real con tu propio tráfico.
Las primeras reseñas son mixtas en cuanto a calidad. Willison señala que GPT-6.2 Astra "no puntúa tan alto como Fable 5.2 en varios benchmarks", así que ejecuta tu propia evaluación antes de comprometerte. Si vienes de la generación anterior, nuestra guía de la API de GPT-6 Astra cubre el formato de las solicitudes, y la migración de GPT-6 Astra a Sol explica cuándo basta el modelo más barato.
Ambos modelos comparten los mismos límites de velocidad en Standard: 5.000 solicitudes y 1M de tokens por minuto en el nivel Build, y hasta 15.000 solicitudes y 40M de tokens por minuto en Grow.
Deja que Codex verifique tus costos de GPT-6.2 Astra con Apidog CLI
Las tablas de precios solo sirven si tus solicitudes realmente aprovechan la caché y se mantienen por debajo de 272K. Tu agente de programación puede verificarlo en cada compilación con Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
El agente lee el esquema, valida su carga útil, crea el caso y lo ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Si un cambio en el prompt rompe la caché o empuja una solicitud por encima de 272K, la ejecución falla antes de que llegue la factura. El mismo apidog run con -r junit se integra en CI; nuestra guía del pipeline de CI/CD de Apidog CLI incluye una configuración lista para copiar y pegar, y Apidog CLI en Codex cubre el lado del agente. El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.2 Astra por 1M de tokens? $8 por 1M de tokens de entrada, $0.40 por 1M de tokens de entrada en caché y $40 por 1M de tokens de salida en el nivel Standard, para solicitudes de hasta 272K tokens de entrada.
¿GPT-6.2 Astra es más barato que GPT-6 Astra? Sí. La entrada y la salida son un 20 % más bajas ($8/$40 frente a $10/$50) y las lecturas en caché un 60 % más bajas ($0.40 frente a $1.00). Nuestra sesión de agente con caché salió un 31 % más barata.
¿Cuánto cuesta GPT-6.2 Sol? $2 por 1M de tokens de entrada, $0.10 en caché y $10 de salida, el mismo precio de lista que GPT-6.1 Sol y GPT-6 Sol. Es un cuarto del precio de Astra en cada línea.
¿GPT-6.2 Astra cobra más por prompts largos? Sí. Por encima de 272K tokens de entrada, las tarifas de entrada y caché se duplican y la salida sube a 1.5x para toda la solicitud: $16 de entrada, $0.80 en caché y $60 de salida por 1M de tokens.
¿Puedo obtener un descuento en GPT-6.2 Astra? Batch cuesta el 50 % de Standard. Las solicitudes en segundo plano en la API de Responses obtienen un 30 % de descuento con una ventana de 2 horas o un 40 % con una ventana de 8 horas (beta pública). El almacenamiento en caché reduce los prefijos repetidos a 0.05x la tarifa de entrada.
¿Los tokens de razonamiento cuentan en la factura de GPT-6.2 Astra? Sí. Los tokens de razonamiento se facturan a la tarifa de salida de $40 por 1M, y el modelo rechaza el esfuerzo de razonamiento none, así que presupuesta el razonamiento en cada llamada.