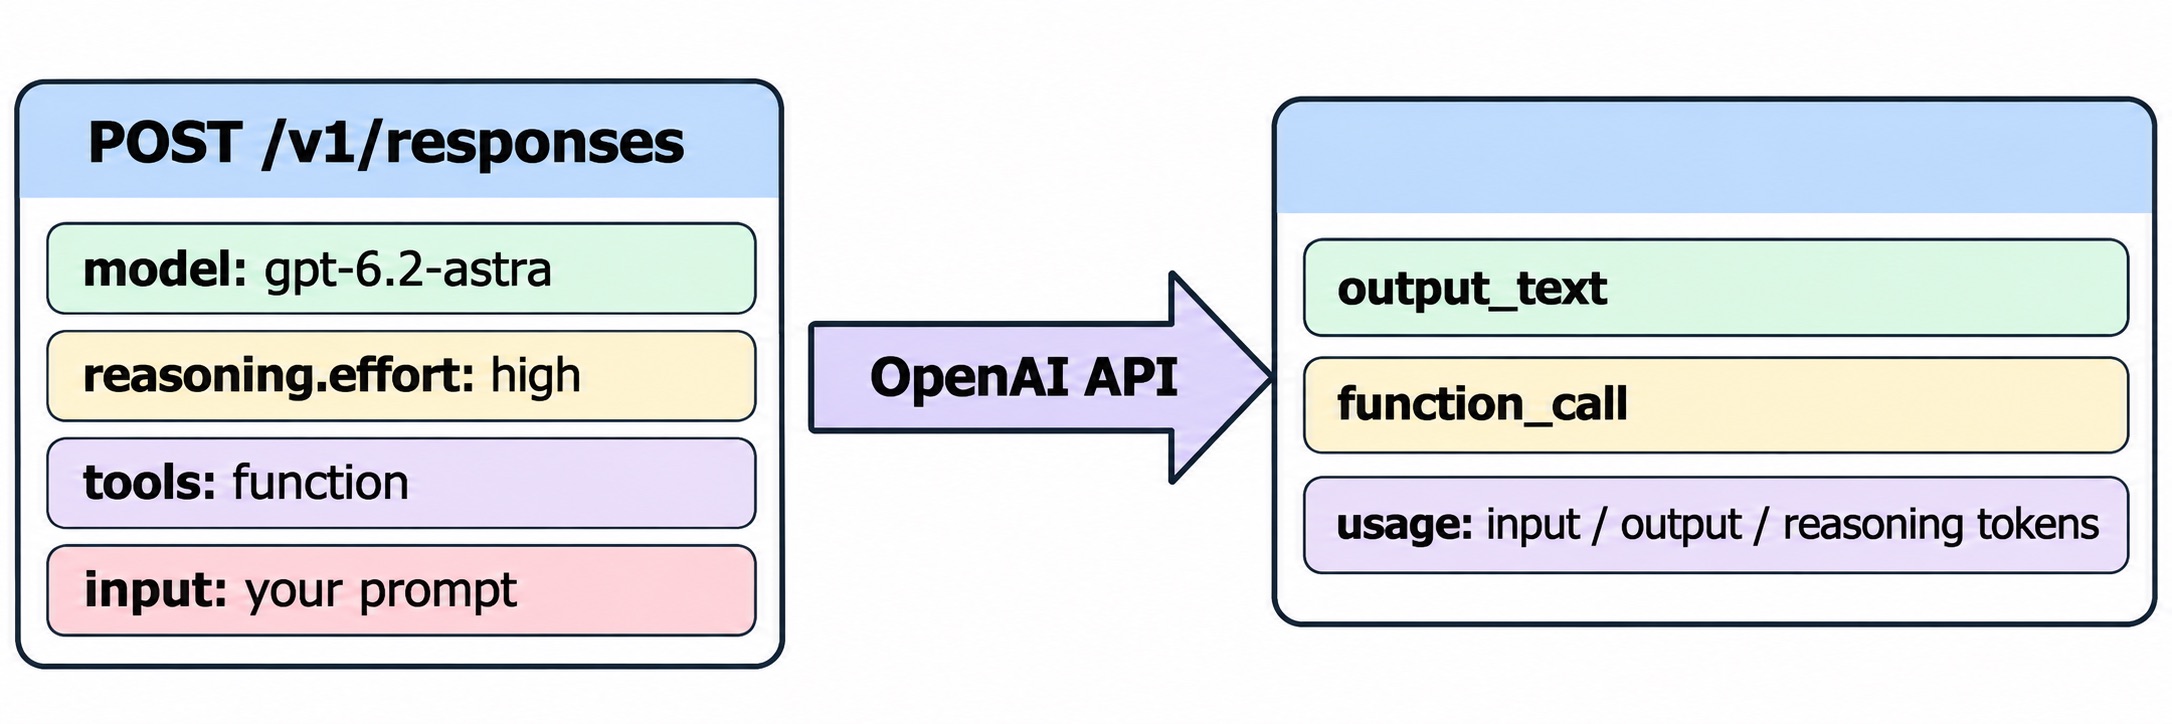
Respuesta rápida: Para usar la API de GPT-6.2 Astra, envía una solicitud al endpoint de Responses de OpenAI (POST /v1/responses) con "model": "gpt-6.2-astra", un nivel de esfuerzo de razonamiento como "high" y tu entrada. Cuesta 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida, admite hasta 922 000 tokens de entrada y devuelve hasta 128 000. No establezcas el esfuerzo en none: la API lo rechaza.
OpenAI lanzó GPT-6.2 Astra y su hermano más económico, GPT-6.2 Sol, el 17 de noviembre de 2026. Si ya has llamado a GPT-6 Astra antes, la mayor parte de tu código sigue funcionando. Esta guía recorre la API de GPT-6.2 Astra desde tu primera solicitud hasta las llamadas a herramientas, el ajuste del esfuerzo, las trampas de precios y una prueba repetible que tu agente de programación puede ejecutar por ti.
Qué necesitas antes de tu primera llamada a la API de GPT-6.2 Astra
Necesitas cuatro cosas, y probablemente ya tienes tres de ellas:
- Una clave de API de OpenAI del panel de la plataforma, exportada como
OPENAI_API_KEY. - Un nivel de uso de pago. La página de modelos de OpenAI indica que los límites de tasa de Astra comienzan en el nivel Build (5,000 solicitudes y 1M de tokens por minuto).
- El ID del modelo
gpt-6.2-astra. El modelo más económico esgpt-6.2-sol. - Un endpoint compatible: Responses, Chat Completions o Batch. Realtime, Assistants y fine-tuning no admiten ninguno de los dos modelos.
Estas especificaciones provienen de la página del modelo GPT-6.2 Astra de OpenAI, verificada el 18 de noviembre de 2026.
| Especificación | GPT-6.2 Astra |
|---|---|
| ID del modelo | gpt-6.2-astra |
| Ventana de contexto | 1,050,000 tokens |
| Entrada máxima | 922,000 tokens |
| Salida máxima | 128,000 tokens |
| Corte de conocimiento | 18 de mayo de 2026 |
| Endpoints | Responses, Chat Completions, Batch |
| Funciones | Streaming, function calling, salidas estructuradas, entrada de imágenes, almacenamiento en caché de prompts |
Cómo hacer tu primera solicitud a la API de GPT-6.2 Astra
La API de Responses es el endpoint para el que OpenAI desarrolla nuevas funciones, así que empieza por ahí. Estos son los pasos:
- Exporta tu clave:
export OPENAI_API_KEY=sk-... - Envía una solicitud con el ID del modelo y un nivel de esfuerzo.
- Lee
output_textpara la respuesta yusagepara el recuento de tokens.
Con curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
Con el SDK oficial de Python (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
Con Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
Revisa el bloque usage en cada llamada inicial. Astra gasta tokens de razonamiento antes de escribir una sola palabra, y estos se facturan como salida. Una respuesta breve puede costar más de lo que esperas.
Elige un nivel de esfuerzo de razonamiento para GPT-6.2 Astra
El esfuerzo de razonamiento es la palanca más importante tanto para la calidad como para el coste. La guía de razonamiento de OpenAI enumera los valores none, minimal, low, medium, high, xhigh y max, y señala que cada modelo solo admite un subconjunto. Para GPT-6.2 Astra y Sol, la única regla confirmada es que none se rechaza, por lo que cada llamada realiza algo de razonamiento.
| Esfuerzo | Úsalo para |
|---|---|
low / medium |
Ediciones simples, extracción, respuestas cortas |
high |
Revisión de código, planificación, la mayoría de los prompts difíciles. Un valor predeterminado razonable para empezar a probar |
xhigh |
Agentes de larga duración y trabajo asíncrono, solo cuando las evaluaciones muestren una mejora clara |
max |
Tus problemas más difíciles, donde una mejor respuesta justifica varios veces el coste en tokens |
OpenAI no indica el nivel de esfuerzo predeterminado de Astra, así que establécelo explícitamente en cada solicitud. Eso mantiene tus facturas y resultados de pruebas reproducibles.
¿Cuánto cambia el esfuerzo la factura? Simon Willison ejecutó el mismo prompt de imagen en cada modelo con tres niveles de esfuerzo el día del lanzamiento y publicó los costes. Astra costó 11,55 centavos con high, 17,70 centavos con xhigh y 88,71 centavos con max. Pasar de high a max multiplicó el coste por casi ocho.
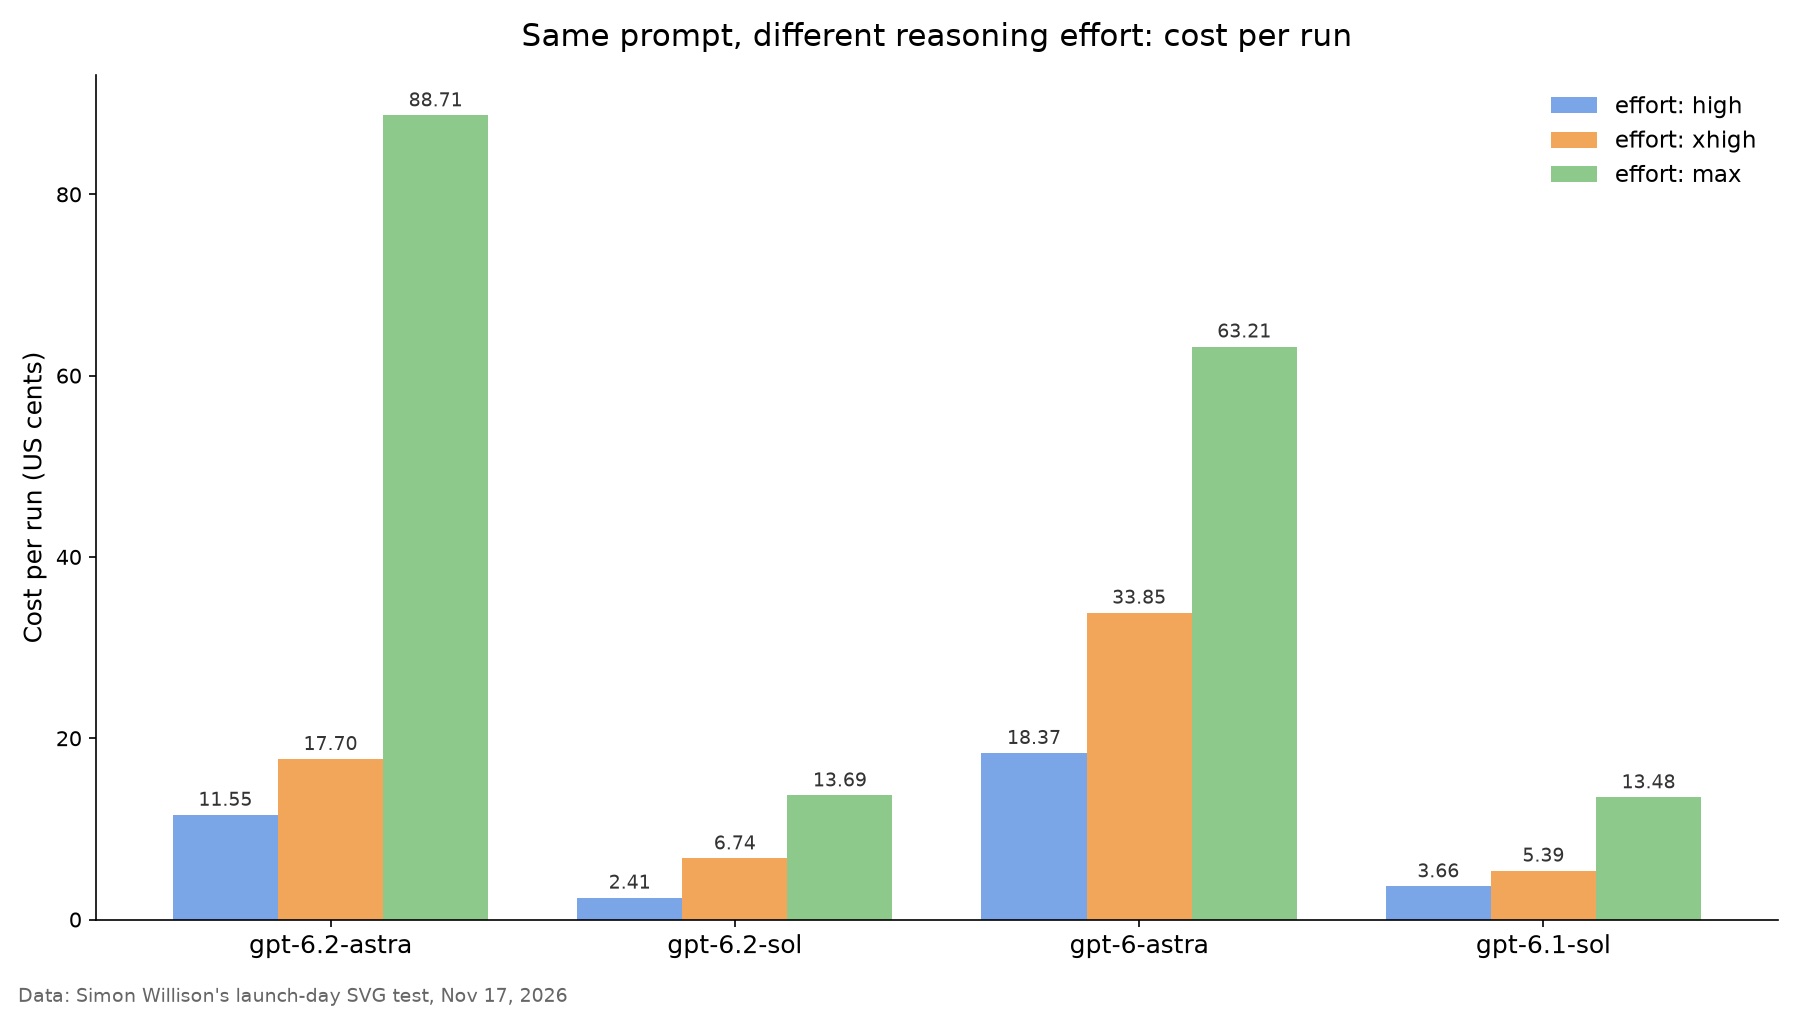
Fíjate en que GPT-6.2 Astra era más barato que GPT-6 Astra con high y xhigh, pero más caro con max. El precio por token bajó un 20 %, pero con esfuerzo max razona durante más tiempo. Mide el coste por tarea completada, no el coste por millón de tokens.
Usa herramientas y salidas estructuradas con la API de GPT-6.2 Astra
Astra admite function calling, salidas estructuradas y una larga lista de herramientas alojadas en la API de Responses: búsqueda web, búsqueda de archivos, generación de imágenes, intérprete de código, shell alojada, apply patch, skills, computer use, MCP y búsqueda de herramientas.
Una herramienta de función se ve igual que para GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
Ejecuta la función por tu cuenta y luego envía el resultado de vuelta como un elemento function_call_output con el call_id correspondiente. Astra redacta la respuesta final a partir de él.
Para obtener salida legible por máquinas, pasa un esquema JSON en text.format con "type": "json_schema" y "strict": true. El modelo devolverá entonces un JSON que coincide con tu esquema, así que puedes analizarlo sin conjeturas.
Con un modelo tan capaz, dos hábitos ayudan. Primero, da a cada herramienta una descripción precisa y un esquema estricto; los revisores del día del lanzamiento informaron que Astra puede divagar en tareas largas y abiertas. Segundo, establece max_output_tokens en los bucles de agentes para que un paso desbocado no consuma tu presupuesto. Para más información sobre el endpoint en sí, consulta nuestra guía de la API de Responses de OpenAI.
Precios y límites de tasa de la API de GPT-6.2 Astra
Astra se precio por millón de tokens, con un recargo para prompts muy largos. Estas tarifas provienen de la página del modelo:
| Concepto | GPT-6.2 Astra | GPT-6 Astra (referencia) |
|---|---|---|
| Entrada | $8.00 | $10.00 |
| Entrada en caché | $0.40 | $1.00 |
| Escrituras en caché (retención de 30 min) | $10.00 | n/a |
| Salida | $40.00 | $50.00 |
La trampa está en la regla de contexto largo. Una vez que una solicitud supera los 272 000 tokens de entrada, las tarifas de entrada y caché se duplican y la salida cuesta 1,5 veces más para toda la solicitud. Un prompt de 300 000 tokens se factura a 16 dólares de entrada y 60 dólares de salida, no solo los tokens que pasan el umbral. Si vas a alimentar a Astra con repositorios enteros, divide en fragmentos o usa la caché por debajo de 272 000 siempre que puedas.
Los trabajos por lotes (Batch) sirven para evaluaciones y rellenos que pueden esperar; según VentureBeat, Batch funciona a mitad de precio.
Límites de tasa estándar por nivel:
| Nivel | Solicitudes/min | Tokens/min |
|---|---|---|
| Build | 5,000 | 1,000,000 |
| Launch | 10,000 | 4,000,000 |
| Grow | 15,000 | 40,000,000 |
Gestiona las respuestas 429 con reintento exponencial. Una ejecución larga de agente con xhigh puede agotar rápidamente el presupuesto de tokens de un nivel Build.
Migrar de GPT-6 Astra a GPT-6.2 Astra
La mayoría del código solo necesita un cambio: la cadena del modelo. Antes de activarlo en producción, revisa esto:
- ID del modelo:
gpt-6-astrapasa a sergpt-6.2-astra. - Esfuerzo
none: si alguna ruta de código lo envía, ahora fallará. Cambia al valor más bajo que tus evaluaciones acepten. - Almacenamiento en caché de prompts: la entrada en caché bajó de 1,00 a 0,40 dólares, así que ahora vale la pena almacenar en caché los prompts de sistema estables y las listas de herramientas.
- Prompts largos: vuelve a revisar cualquier solicitud cercana a 272 000 tokens según la regla de contexto largo descrita anteriormente.
- Seguridad: OpenAI indica que ambos modelos GPT-6.2 alcanzan su umbral de ciberseguridad «Critical» y vienen con salvaguardas más estrictas. Los prompts de herramientas de seguridad pueden recibir rechazos que antes no recibían.
Las primeras reseñas son mixtas, así que prueba antes de cambiar. Ethan Mollick calificó a Astra de «muy desigual y extraño», y Dan Shipper dijo que a menudo se detenía antes de tiempo en construcciones de extremo a extremo, según el resumen de VentureBeat. Otros elogiaron su revisión de código y computer use. Tus propios prompts son la única referencia que importa. La guía de la API de GPT-6 Astra cubre qué se mantiene de la generación anterior, y si la mayor parte de tu tráfico es rutinario, la guía de la API de GPT-6.1 Sol muestra el formato de solicitud del nivel más económico.
Deja que tu agente de programación pruebe GPT-6.2 Astra con Apidog CLI
Pegar prompts en una terminal te dice cómo lo hizo Astra hoy. No te dirá cuándo una actualización rompe tu esquema el próximo mes. Deja que tu agente de programación construya la verificación y la ejecute con Apidog CLI; tú solo escribes un prompt.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a Claude Code, Codex o Cursor un único prompt:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
El agente lee el esquema del payload, comprueba su archivo, crea el caso y lo ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Guarda la clave en el entorno de Apidog, no en el prompt, para que nunca quede en el contexto de tu agente. Añade --upload-report para revisar la ejecución en la aplicación de Apidog, o -n 5 para repetirla y ver lo estables que son las llamadas a herramientas de Astra. Introduce -r junit en un pipeline y la verificación se volverá a ejecutar en cada despliegue; la guía de Apidog CLI en CI/CD muestra la configuración, y Apidog CLI en Claude Code cubre la parte del agente. El plan gratuito de Apidog cubre equipos de hasta 4 usuarios.
Preguntas frecuentes
¿Cuál es el ID del modelo de la API de GPT-6.2 Astra? gpt-6.2-astra. El hermano más económico es gpt-6.2-sol. Ambos funcionan en los endpoints Responses, Chat Completions y Batch.
¿Cuánto cuesta la API de GPT-6.2 Astra? 8 dólares por millón de tokens de entrada, 0,40 dólares por millón de tokens de entrada en caché y 40 dólares por millón de tokens de salida. Las solicitudes de más de 272 000 tokens de entrada pagan el doble de entrada y 1,5 veces más de salida para toda la solicitud.
¿Por qué mi solicitud a GPT-6.2 Astra falla con esfuerzo de razonamiento none? Ambos modelos GPT-6.2 rechazan "effort": "none". Establece high, o el nivel más bajo que tus pruebas muestren que funciona para tu tarea.
¿Cuál es la ventana de contexto de GPT-6.2 Astra? 1,050,000 tokens en total, con hasta 922,000 tokens de entrada y 128,000 tokens de salida.
¿Puedo usar GPT-6.2 Astra con la API de Chat Completions? Sí. Está soportado, pero las herramientas alojadas como búsqueda web, computer use y apply patch están disponibles para la API de Responses, así que usa Responses para el trabajo con agentes.
¿Está GPT-6.2 Astra disponible gratis? No en la API; cada llamada se factura. En ChatGPT Work y Codex está incluido en los planes Plus, Pro, Enterprise y Edu, según el anuncio de lanzamiento de OpenAI.