
Con pocas semanas de diferencia entre sí en el verano de 2026, OpenAI y Google lanzaron un modelo especializado en seguridad que la mayoría de los desarrolladores no pueden tocar. El GPT-5.6-Cyber de OpenAI llegó el 10 de agosto. El Gemini 3.5 Flash Cyber de Google llegó el 21 de julio. Ambos encuentran vulnerabilidades de software. Ambos están restringidos y requieren aprobación. Y ambos se niegan a entregar una clave API normal.
Sin embargo, no son el mismo tipo de herramienta. Uno se inclina hacia la defensa, el otro hacia la ofensiva, y se sitúan en niveles de modelo muy diferentes. Si intentas comprenderlos, así es como se comparan realmente y por qué no es posible un enfrentamiento directo de rendimiento entre ellos.
Comparativa
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| Proveedor | OpenAI | |
| Lanzado | 10 de agosto de 2026 | 21 de julio de 2026 |
| Basado en | GPT-5.6 Sol (nivel insignia) | Gemini Flash (nivel rápido y económico) |
| Orientación | Ofensiva: cadenas de exploits, descubrimiento de zero-days | Defensiva: encontrar y corregir vulnerabilidades |
| Acceso | Daybreak Rojo (equipos de seguridad verificados) | Piloto limitado (gobiernos, socios de confianza) |
| API pública | No | No |
| Precios públicos | No | No |
| Programa | OpenAI Daybreak | Google CodeMender |
La conclusión en una frase: GPT-5.6-Cyber es un modelo de investigación ofensiva de nivel de frontera, y Gemini 3.5 Flash Cyber es un modelo de parcheo defensivo de nivel más ligero. Esa diferencia de orientación explica casi todo lo demás.
Diferentes niveles de modelo
La división técnica más clara es el modelo base. GPT-5.6-Cyber se basa en GPT-5.6 Sol, el modelo de razonamiento más capaz de OpenAI. La investigación de vulnerabilidades en el mundo real necesita un razonamiento sostenido a través de grandes bases de código desconocidas, y OpenAI colocó su modelo de primer nivel debajo de Cyber para lograrlo.
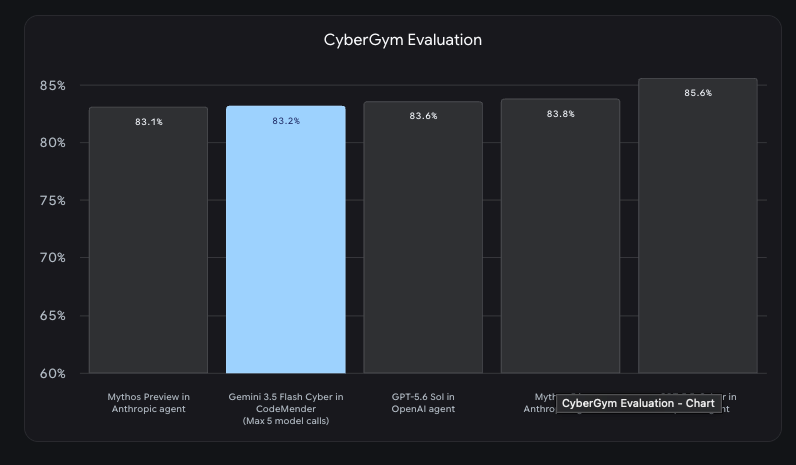
Gemini 3.5 Flash Cyber se basa en el nivel Flash, el modelo de trabajo rápido y económico de Google en lugar de su modelo insignia Pro. Esto se ajusta deliberadamente a su función. CodeMender, el programa de Google detrás de él, se trata de escanear código para encontrar y corregir fallos a escala, lo que recompensa la velocidad y la eficiencia de costos por encima de la máxima profundidad de razonamiento en una sola pasada. Tenga en cuenta también la peculiaridad de la versión: el modelo Flash general pasó a la versión 3.6, pero Cyber se mantuvo en la 3.5, porque los dos están en diferentes vías de lanzamiento.
Diferente orientación: ataque vs defensa
Esta es la verdadera distinción. Lee la descripción de cada proveedor y la división es obvia.
OpenAI entrenó GPT-5.6-Cyber para reducir las negativas en tareas de doble uso de mayor riesgo y para mejorar en la búsqueda de zero-days y la construcción de cadenas de exploits, según su anuncio de expansión de Daybreak. Se entrega a través de Daybreak Red, el nivel explícitamente para “investigación de vulnerabilidades autorizada, validación de exploits y pruebas de seguridad.” La evidencia de lanzamiento fue ofensiva: dos vulnerabilidades V8 encadenadas en Chrome, asignadas como CVE-2026-15903, además de hallazgos reportados en un sistema operativo móvil, una base de datos y un kernel de sistema operativo.
Google enmarcó Gemini 3.5 Flash Cyber en torno a la búsqueda y corrección. Anunciado en su actualización de modelos Gemini, es parte de CodeMender, un esfuerzo destinado a detectar fallas de seguridad en el código y proponer parches para ellas. El énfasis está en la remediación, cerrar brechas, no en armarlas.
Eso no hace que uno sea “seguro” y el otro “peligroso”. Un potente buscador de vulnerabilidades es de doble uso, sin importar cómo se enmarque, razón por la cual ambos están restringidos. Pero si estás mapeando el espacio, OpenAI se inclinó más hacia la investigación ofensiva, y Google se mantuvo más cerca del parcheo defensivo.
Diferente transparencia
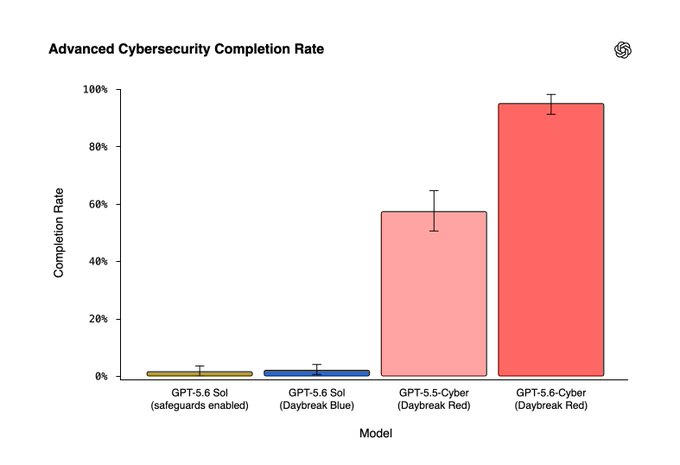
OpenAI publicó más cifras. Divulgó una métrica interna de tasa de finalización (GPT-5.6-Cyber responde al 95.0% de las indicaciones cibernéticas avanzadas frente al 1.5% para Sol base), nombró puntos de referencia como ExploitGym, informó un CVE real asignado y declaró una calificación de “Alta” pero por debajo de “Crítica” en su Marco de Preparación. Para un desglose completo de quién obtiene acceso a qué, consulta Daybreak Azul vs Rojo.
Google fue más vago en su lanzamiento. Confirmó la existencia del modelo, su propósito defensivo y su estado restringido, sin publicar tasas de finalización por tarea comparables o tablas de referencia. Así que, aunque puedes describir ambos modelos, no puedes ponerlos en el mismo gráfico. No hay un punto de referencia compartido que ninguno de los proveedores haya ejecutado cara a cara, y sus tareas objetivo (desarrollo de exploits vs generación de parches) apenas se superponen.
Lo que comparten
Elimina las diferencias y ambos modelos cuentan la misma historia sobre la dirección que está tomando el conjunto de herramientas de seguridad de IA:
- Acceso restringido, no API abierta. Ninguno es de autoservicio. Ambos requieren aprobación, y el acceso está limitado a organizaciones verificadas.
- Sin precios públicos. Debido a que no hay acceso abierto, no hay una tarifa por token publicada para ninguno. Cualquier tabla de precios que encuentres circulando no está verificada.
- La misma lógica de doble uso. Ambos proveedores razonan que un modelo bueno para encontrar vulnerabilidades es inherentemente bueno para encontrar vulnerabilidades, por lo que están comenzando de forma restringida con socios de confianza y observando antes de ampliar el acceso.
- Una historia de versiones confusa. El modelo de OpenAI se enmarca bajo la nomenclatura Sol/Terra/Luna; el de Google se mantuvo en 3.5 mientras que su hermano pasó a 3.6.
Si acudiste a cualquiera de los dos buscando una clave API, la respuesta es la misma: no hoy, y quizás no de la forma que esperas.
¿Cuál te importa a ti? Probablemente ninguno, todavía
Aquí está la lectura práctica. A menos que seas un proveedor de seguridad aprobado o un socio gubernamental, no puedes usar ninguno de los modelos en este momento. Observarlos es útil para comprender la dirección del progreso, pero ninguno de ellos debería estar en tu pila este trimestre.
Lo que sí pertenece a tu pila es la prueba de seguridad de las API que realmente posees. Ambos modelos existen porque las vulnerabilidades son costosas; las más baratas de prevenir son los aburridos errores de límites en tus propios servicios. No necesitas un modelo cibernético de vanguardia para detectarlos.
Con un cliente API como Apidog, puedes ejecutar las comprobaciones que detectan la mayoría de los problemas con el menor esfuerzo:
- Límites de autenticación. Envía solicitudes con tokens faltantes, caducados y válidos y verifica que cada uno devuelva el estado correcto. La misma disciplina de menor privilegio se aplica a tus agentes; consulta lo que realmente puede hacer la clave API de tu agente de IA.
- Seguridad de transporte. Verifica que los certificados de cliente y mTLS funcionen correctamente, y que se rechacen las solicitudes sin cifrar.
Ese es un trabajo que puedes comenzar hoy, con herramientas a las que realmente puedes acceder. Descarga Apidog y comienza con los casos de autenticación.
Preguntas frecuentes
¿Cuál es mejor, GPT-5.6-Cyber o Gemini 3.5 Flash Cyber? Están construidos para diferentes tareas, por lo que “mejor” depende de la tarea. GPT-5.6-Cyber es un modelo de nivel de frontera ajustado para la investigación ofensiva (desarrollo de exploits, descubrimiento de zero-days). Gemini 3.5 Flash Cyber es un modelo de nivel más ligero ajustado para el parcheo defensivo. Ninguno de los proveedores ha publicado un benchmark directo, por lo que no hay una comparación de puntuaciones directa disponible.
¿Puedo usar cualquiera de ellos a través de una API? No. Ambos están restringidos. GPT-5.6-Cyber requiere la aprobación de Daybreak Red; Gemini 3.5 Flash Cyber es un piloto limitado para gobiernos y socios de confianza. Ninguno ofrece un ID de modelo API de autoservicio.
¿Por qué ambos modelos están restringidos? Doble uso. Un modelo bueno para encontrar vulnerabilidades ayuda a los defensores a parchear y a los atacantes a explotar. Ambos proveedores están limitando el acceso a socios verificados mientras monitorean el uso en el mundo real.
¿Cuál es la diferencia en los modelos base? GPT-5.6-Cyber se basa en GPT-5.6 Sol, el nivel de razonamiento insignia de OpenAI. Gemini 3.5 Flash Cyber se basa en el nivel Flash de Google, más rápido y económico, lo que se adapta a su propósito de escaneo y corrección.
¿Qué debería usar en su lugar? Para asegurar tus propias API, ejecuta pruebas de autenticación, transporte y contrato con un cliente como Apidog. No se requiere un modelo restringido.