
GLM-5 de Z.ai ofrece un modelo de código abierto de nivel fronterizo ahora accesible a través de Ollama. Obtenga capacidades excepcionales en razonamiento complejo, ingeniería de software y flujos de trabajo agenciales de largo alcance, manteniendo todo en su propio hardware.
¿Qué hace que GLM-5 destaque?
Z.ai lanzó GLM-5 bajo la Licencia MIT, haciendo sus pesos libremente disponibles en Hugging Face y ModelScope. El modelo escala a 744 mil millones de parámetros totales en una arquitectura de Mezcla de Expertos (MoE), activando solo 40 mil millones de parámetros por token. Este diseño mantiene una alta inteligencia mientras controla los costos de inferencia.
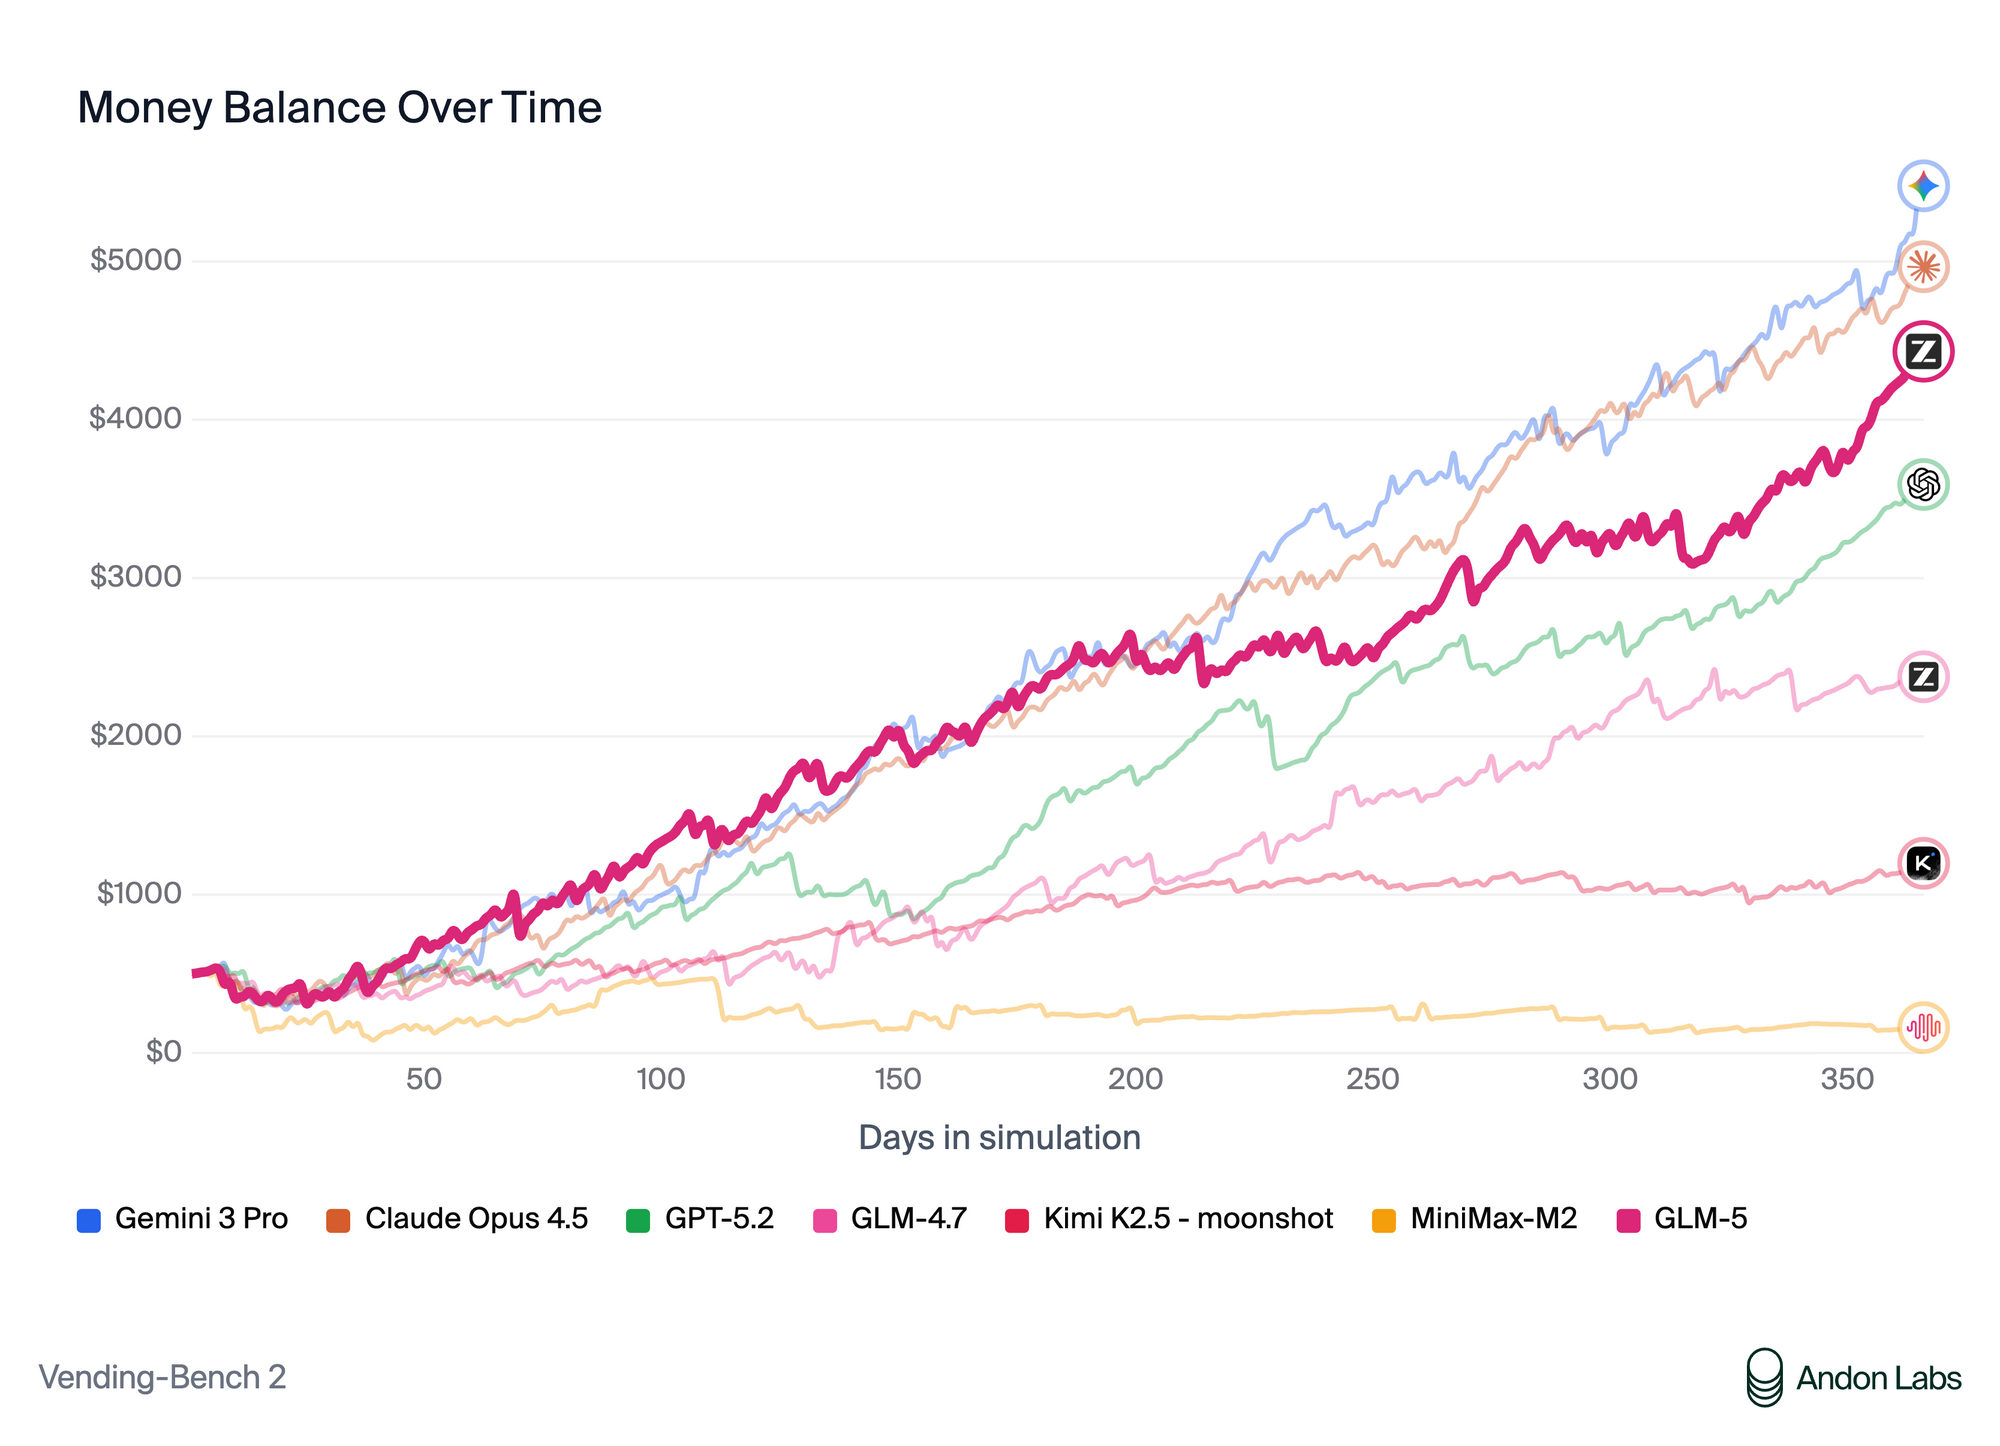
El preentrenamiento con 28.5 billones de tokens dota a GLM-5 de un sólido soporte multilingüe, destacando principalmente en inglés y chino. Maneja contextos de hasta aproximadamente 198K tokens en la implementación de Ollama a través de DeepSeek Sparse Attention (DSA), lo que reduce la sobrecarga computacional sin sacrificar el rendimiento en secuencias largas.
Los benchmarks resaltan sus puntos fuertes. GLM-5 alcanza un 92.7% en AIME 2026 I, 86.0% en GPQA-Diamond y 77.8% en SWE-bench Verified. Estos resultados lo posicionan competitivamente frente a modelos líderes en codificación, razonamiento matemático y tareas agenciales como planificación de múltiples pasos y uso de herramientas.
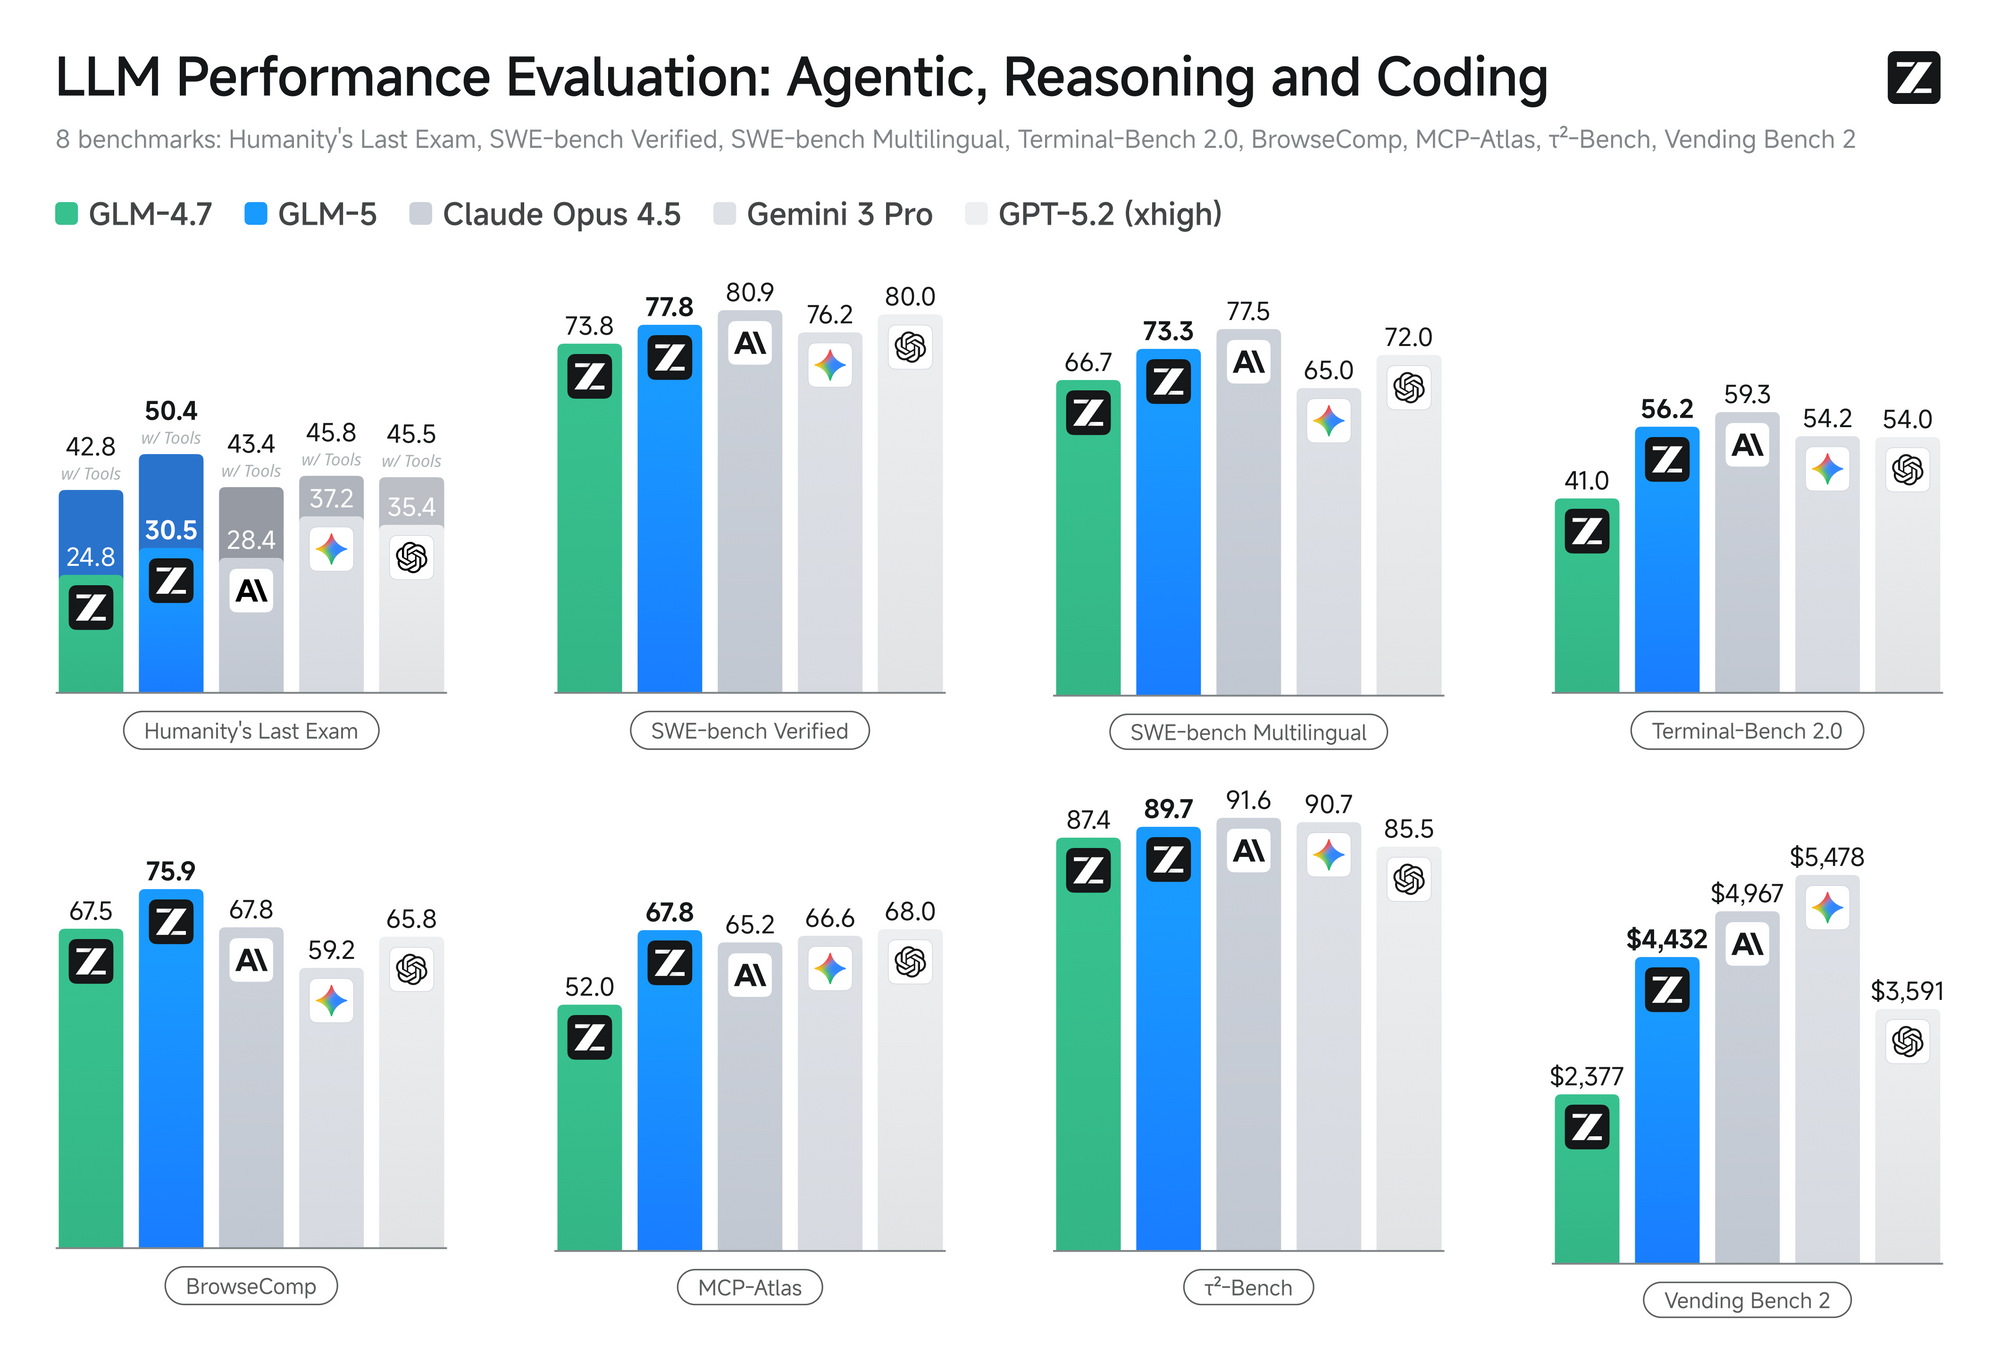
Los usuarios aprecian particularmente su capacidad para generar documentos estructurados como PRD, hojas de cálculo e informes, y su compatibilidad con frameworks de agentes. El modelo transita suavemente desde el chat simple a flujos de trabajo de ingeniería sofisticados.
Por qué emparejar GLM-5 con Ollama
Ollama simplifica la implementación local de LLM en macOS, Linux y Windows. Gestiona las descargas de modelos, la cuantificación y el servicio, mientras expone una API REST compatible con OpenAI en http://localhost:11434/v1. En consecuencia, cualquier herramienta creada para endpoints de OpenAI funciona con GLM-5 de forma inmediata.
Evita los costos de la nube, los límites de tasa y la transmisión de datos a terceros. Además, Ollama permite cambiar fácilmente entre modelos y se integra directamente con las herramientas de desarrollo. La etiqueta glm-5:cloud proporciona una variante optimizada adaptada para la ejecución local, equilibrando la capacidad y las demandas de recursos.
Requisitos previos para ejecutar GLM-5 localmente
Prepare su sistema antes de la instalación. Ollama funciona en hardware moderno, pero GLM-5 se beneficia de recursos sustanciales debido a su escala.
- Sistema Operativo: macOS (se prefiere Apple Silicon), Linux o Windows con WSL2.
- Recomendación de GPU: Tarjetas NVIDIA con 24 GB+ de VRAM ofrecen un rendimiento cómodo en longitudes de contexto más altas. Los Mac con Apple Silicon y 32 GB+ de memoria unificada también rinden bien. Las configuraciones solo con CPU funcionan, pero generan tokens más lentamente.
- RAM: Al menos 32 GB de memoria del sistema; 64 GB+ mejora la estabilidad durante contextos largos.
- Almacenamiento: Asigne 50 GB+ de espacio libre en SSD para los archivos del modelo y el tiempo de ejecución de Ollama.
- Internet: Necesario para el comando inicial
ollama pull.
Verifique su hardware con estas directrices. Los usuarios con GPU de gama media a menudo logran velocidades utilizables limitando el contexto o empleando una cuantificación más baja cuando esté disponible. Pruebe incrementalmente después de la configuración.
Paso 1: Instalar Ollama
Visite el sitio web oficial de Ollama y descargue el instalador para su plataforma. El proceso tarda segundos en la mayoría de los sistemas.
En macOS o Linux, abra una terminal y ejecute el comando de instalación proporcionado en el sitio. Los usuarios de Windows ejecutan el archivo .exe descargado.
Después de la instalación, verifique el éxito abriendo una terminal y escribiendo:
ollama --version
Este comando confirma que el tiempo de ejecución está activo. Inicie el servidor de Ollama en segundo plano con ollama serve si no se inicia automáticamente.
Paso 2: Descargar y ejecutar GLM-5
Descargue el modelo con un solo comando:
ollama pull glm-5:cloud
El proceso descarga los archivos necesarios y puede tardar tiempo dependiendo de su conexión. Supervise el progreso en la terminal.
Inicie una sesión interactiva inmediatamente después:
ollama run glm-5:cloud
Ahora interactuará directamente con GLM-5 en la línea de comandos. Escriba indicaciones y observe las respuestas. Salga de la sesión con /bye cuando termine.
Paso 3: Interactuar a través de la línea de comandos y llamadas básicas a la API
La CLI es adecuada para pruebas rápidas. Para acceso programático, use la API REST.
Pruebe una simple completación de chat con curl:
curl http://localhost:11434/api/chat -d '{
  "model": "glm-5:cloud",
  "messages": [
    { "role": "user", "content": "Explain the advantages of Mixture-of-Experts architectures in large language models." }
  ],
  "stream": false
}'
Ollama devuelve una respuesta JSON que contiene el mensaje del asistente. Este endpoint admite streaming cuando se establece "stream": true, lo que permite la salida de tokens en tiempo real en las aplicaciones.
Los desarrolladores de Python aprovechan la biblioteca oficial de ollama o el SDK de OpenAI para la compatibilidad:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"  # Placeholder; no real key required
)

response = client.chat.completions.create(
    model="glm-5:cloud",
    messages=[
        {"role": "system", "content": "You are an expert software architect."},
        {"role": "user", "content": "Design a scalable microservices system for an e-commerce platform handling 1M daily users."}
    ],
    temperature=0.7,
    max_tokens=2048
)

print(response.choices[0].message.content)
Este código demuestra cómo las bases de código existentes compatibles con OpenAI se adaptan sin esfuerzo al modelo local.
Paso 4: Mejore su flujo de trabajo con Apidog
Las pruebas visuales de API aceleran el desarrollo y la depuración. Apidog se destaca aquí al proporcionar una interfaz intuitiva para crear solicitudes, gestionar entornos y generar código de cliente.
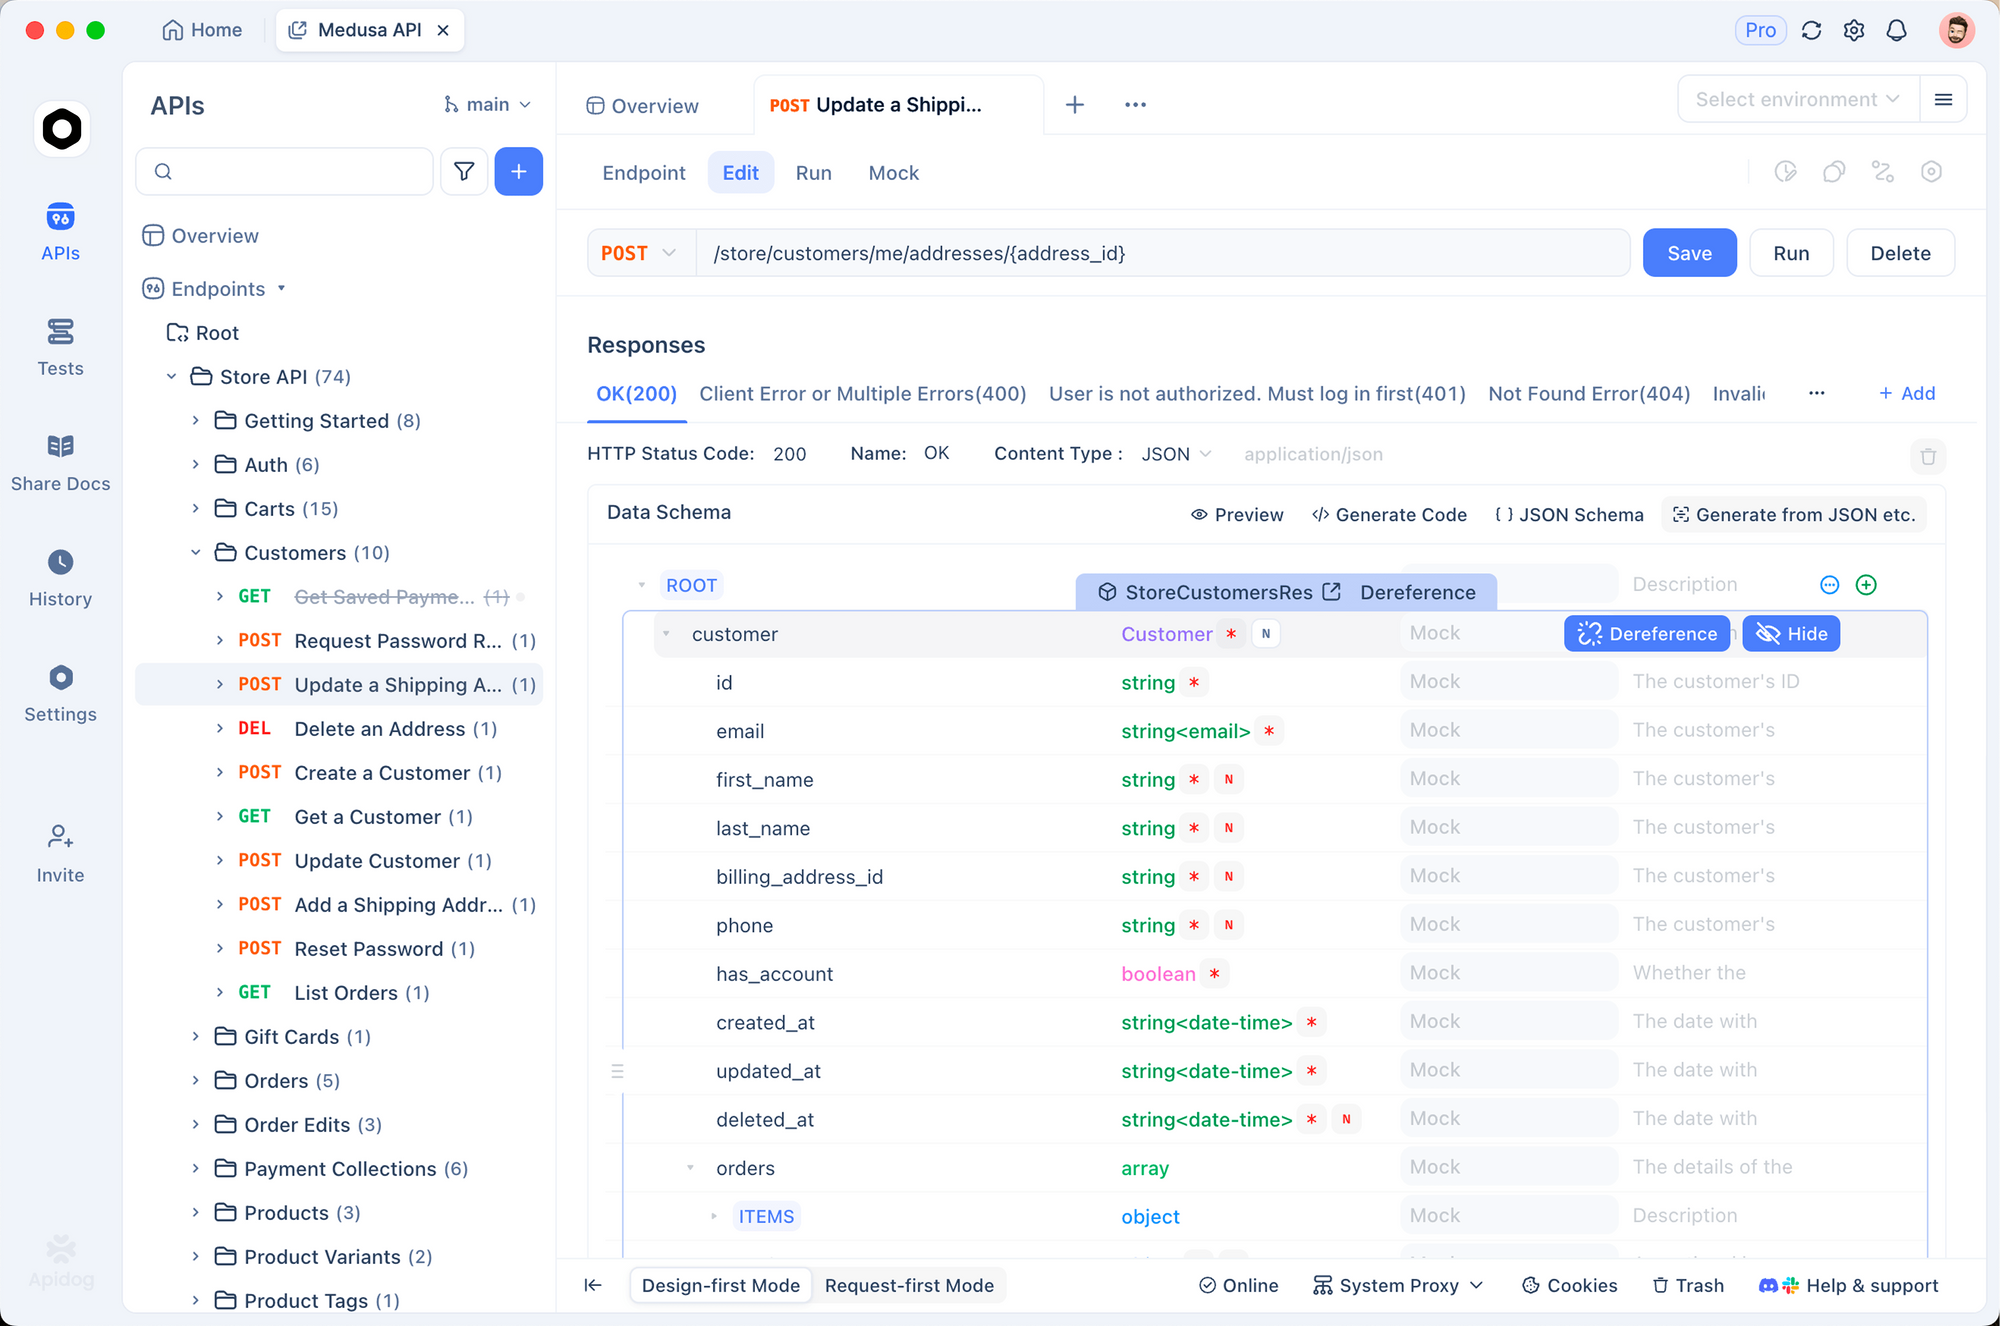
Descargue Apidog gratis desde el sitio oficial e instálelo. Cree un nuevo proyecto y configure lo siguiente:
- URL Base:
http://localhost:11434/v1 - Endpoint: Añada
/chat/completionscomo una solicitud POST. - Cabeceras: Establezca
Content-Type: application/json(no se necesita cabecera de Autorización para Ollama local).
Construya el cuerpo de su solicitud visualmente. Defina la matriz de mensajes, ajuste parámetros como temperature, top_p o max_tokens, e incluya el nombre del modelo "glm-5:cloud". Envíe la solicitud e inspeccione la respuesta JSON completa, incluido el uso de tokens y la temporización.
Apidog le permite además:
- Guardar entornos reutilizables para diferentes modelos o contextos.
- Generar código SDK en Python, JavaScript u otros lenguajes.
- Crear suites de pruebas automatizadas para validar las salidas de GLM-5 contra esquemas esperados.
- Simular respuestas para el desarrollo de frontend cuando el backend se ejecuta localmente.
Esta integración transforma la experimentación cruda de API en un proceso estructurado y colaborativo. Los desarrolladores que prueban conversaciones complejas de múltiples turnos o escenarios de llamada a herramientas se benefician particularmente de las herramientas de depuración visual de Apidog.
Configuraciones y optimizaciones avanzadas
Personalice el comportamiento creando un Modelfile. Por ejemplo:
FROM glm-5:cloud
SYSTEM Eres un asistente de ingeniería preciso centrado en la planificación a largo plazo y la calidad del código.
PARAMETER temperature 0.6
PARAMETER num_ctx 131072
Construya el modelo personalizado con ollama create my-glm5 -f Modelfile y ejecútelo como ollama run my-glm5.
Ajuste la longitud del contexto con cuidado. Ventanas más grandes consumen más memoria pero permiten el análisis de bases de código o documentos extensos. Supervise el uso de VRAM con herramientas como nvidia-smi.
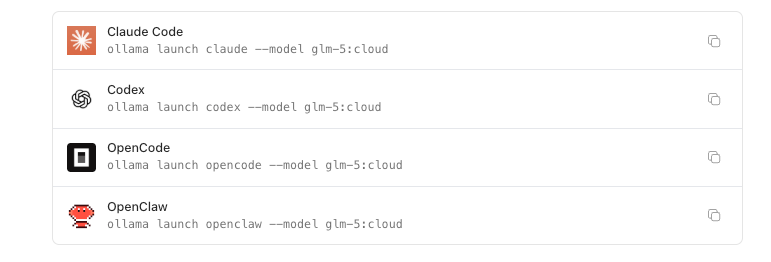
Para flujos de trabajo agenciales, inicie herramientas compatibles directamente:
ollama launch openclaw --model glm-5:cloud
Comandos similares admiten Claude Code, Codex y otros frameworks, permitiendo que GLM-5 impulse agentes de escritorio o asistentes de codificación localmente.
Experimente con prompts del sistema para guiar el modelo hacia dominios específicos, como arquitectura frontend o análisis de ciberseguridad. Realice un seguimiento de las métricas de rendimiento: los tokens por segundo suelen mejorar con la aceleración de la GPU y la gestión optimizada del contexto.
Solución de problemas comunes
Los usuarios ocasionalmente encuentran desafíos durante la configuración inicial. Si el comando de extracción falla, verifique su conexión a internet y el espacio en disco. Reinicie el servicio de Ollama e inténtelo de nuevo.
Los errores de memoria durante la inferencia indican VRAM insuficiente o un tamaño de contexto demasiado ambicioso. Reduzca num_ctx o cierre otras aplicaciones intensivas en GPU. En Apple Silicon, asegure una asignación de memoria unificada suficiente.
Los tiempos de respuesta lentos a menudo mejoran al confirmar la descarga a la GPU. Verifique los registros de Ollama para confirmar que las capas se cargan en el acelerador.
Cuando las llamadas a la API devuelven formatos inesperados, confirme que la etiqueta del modelo coincide exactamente y que el cuerpo de la solicitud sigue el esquema esperado. Apidog ayuda a aislar estos problemas rápidamente mostrando las solicitudes y respuestas en bruto lado a lado.
Los foros de la comunidad y la documentación oficial proporcionan soluciones adicionales a medida que el ecosistema evoluciona.
Conclusión: Tome el control de la IA avanzada hoy
Ejecutar GLM-5 localmente a través de Ollama elimina las barreras a la asistencia de IA de alta calidad. Accede a un rendimiento de razonamiento y codificación de última generación mientras mantiene la soberanía total de los datos y elimina los costos de uso.
Comience con los pasos de instalación descritos anteriormente, integre Apidog para refinar sus interacciones con la API y explore configuraciones personalizadas que coincidan con sus flujos de trabajo específicos. Pequeños ajustes, como prompts optimizados, gestión de contexto o integraciones de herramientas, a menudo producen mejoras sustanciales en la calidad y eficiencia de la salida.
La combinación de las capacidades de GLM-5 y la simplicidad de Ollama empodera a los desarrolladores para experimentar libremente y construir soluciones de grado de producción completamente en su propia infraestructura. Comience su implementación local ahora y desbloquee todo el potencial de este potente modelo de código abierto.