
Z.ai ahora vende dos modelos con nombres casi idénticos, la misma ventana de contexto de 1M de tokens y una diferencia de precio de nueve veces entre ellos. La nomenclatura no ayuda a elegir. "Flash" implica una variante más pequeña, más rápida y más débil, y solo una de esas tres palabras es precisa.
Aquí está la versión corta: GLM-5.3-Flash es más barato, maneja imágenes de forma nativa y ofrece a los usuarios del plan de codificación el triple de cuota. GLM-5.3 es algo más inteligente y genera casi el doble de rápido. Para la mayoría de las cargas de trabajo, Flash es la opción predeterminada correcta y la carga de la prueba recae en elegir el costoso.
Esta publicación explica dónde esa regla se rompe.
La tabla comparativa
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Índice de Inteligencia (Análisis Artificial) | 57 | 60 |
| Precio combinado por 1M de tokens | $0.10 | $0.90 |
| Entrada / salida de lista por 1M | $0.15 / $0.50 | $1.40 / $4.40 |
| Velocidad de salida | ~49 tokens/seg | ~86 tokens/seg |
| Tiempo hasta el primer token | 1.52s | 1.57s |
| Ventana de contexto | 1,048,576 | 1,048,576 |
| Entrada nativa de imagen | Sí | No, basada en adaptador |
| Parámetros | 320B total / 18B activos | Más grande, no completamente revelado |
| Licencia | MIT, pesos abiertos | Pesos abiertos |
| Cuota del Plan de Codificación | 3x | 1x |
Las cifras de velocidad e inteligencia son mediciones de Artificial Analysis. Los precios son los de lista de Z.ai, antes del descuento de lanzamiento que se discute a continuación.
De dónde viene la diferencia de precio de nueve veces
GLM-5.3-Flash es un modelo de mezcla de expertos de 320B que activa 18B parámetros por token, construido sobre una nueva base con atención híbrida lineal y dispersa. Z.ai informa aproximadamente tres veces menos computación de atención que GLM-5.3 y una caché KV aproximadamente 4.4 veces más pequeña.
El tamaño de la caché KV es lo que encarece el servicio de contexto largo. Reducirlo en 4.4x es la mayor parte de la razón por la que Z.ai puede ofrecer una ventana de 1M de tokens a una décima parte del precio. No está pagando menos por un contexto más corto o un modelo más débil. Está pagando menos porque la huella de servicio por solicitud es genuinamente más pequeña.
Ese es un resultado de ingeniería real más que un descuento promocional, lo cual es importante para saber si el precio se mantendrá.
Qué significa la brecha de inteligencia de tres puntos
57 versus 60 en el Índice de Inteligencia de Artificial Analysis es una brecha estrecha en términos absolutos. Para calibrar, el modelo de código abierto mediano de tamaño comparable obtiene 27, por lo que ambos se sitúan muy por encima del campo.
Tres puntos no es nada insignificante, sin embargo. Las brechas de índice de ese tamaño suelen manifestarse como: un rendimiento ligeramente peor en cadenas de razonamiento de varios pasos, un poco más de desviación en tareas agénticas muy largas y una mayor sensibilidad a instrucciones ambiguas. Rara vez aparecen en extracción, clasificación, resumen o ediciones de código de un solo archivo sencillas.
La prueba práctica es si su tarea tiene una respuesta verificable. Si puede verificar la salida programáticamente, el fallo ocasional de Flash es barato de detectar y barato de reintentar, y a un noveno del precio puede reintentar mucho. Si su tarea produce prosa que un humano tiene que leer y juzgar, la diferencia de calidad es más difícil de recuperar y la brecha de precio importa menos que el resultado.
La velocidad es el único lugar donde Flash realmente pierde
Esta es la parte donde el nombre se equivoca. GLM-5.3 genera aproximadamente 86 tokens por segundo. GLM-5.3-Flash logra unos 49. El modelo más grande y caro es casi el doble de rápido en la producción de resultados.
El tiempo hasta el primer token está prácticamente empatado, en 1.52 contra 1.57 segundos, por lo que ambos se sienten igualmente responsivos al inicio de una respuesta.
La consecuencia depende enteramente de la longitud de la salida:
- Respuestas cortas. Irrelevante. Ambos comienzan en aproximadamente 1.5 segundos y terminan antes de que alguien note la diferencia de rendimiento.
- Generaciones largas. Una respuesta de 4,000 tokens tarda unos 82 segundos en Flash y unos 47 en GLM-5.3. En una herramienta interactiva, esa es una brecha significativa.
- Trabajos por lotes con concurrencia. También en su mayoría irrelevante, porque se escala con solicitudes paralelas en lugar de la velocidad por flujo, y la diferencia de precio permite mucha paralelización.
Si está transmitiendo una salida de formato largo a alguien que está esperando, GLM-5.3 es la mejor experiencia. Ese es el caso más claro para pagar nueve veces más.
La multimodalidad es la verdadera línea divisoria
GLM-5.3-Flash acepta imágenes, videos y archivos como bloques de contenido en la misma solicitud de finalización de chat que su texto. GLM-5.3 no hace esto de forma nativa; la visión pasa por adaptadores separados.
Si su aplicación necesita que un modelo vea algo, esto no es una comparación, es un requisito. Flash es el único de los dos que lo hace en una sola llamada, en una sola ventana de contexto, en una sola línea de facturación.
Esa capacidad se combina con el contexto de 1M de una manera genuinamente nueva para esta familia de modelos: un documento de especificación largo y una captura de pantalla del resultado construido pueden ocupar el mismo prompt. El propio posicionamiento de Z.ai habla de observar interfaces y renderizar resultados, lo cual es un marco de agente de codificación en lugar de uno de subtitulado de imágenes.
Nuestra guía de visión cubre la carga útil y los flujos de trabajo. Los modelos de visión dedicados más antiguos se cubren en la guía de API de GLM-5V-Turbo si está manteniendo algo construido en esa ruta.
El ángulo del plan de codificación
Para los suscriptores del Plan de Codificación de GLM, el cálculo es diferente y más simple. Flash está incluido en el plan y, según se informa, tiene tres veces la cuota utilizable de GLM-5.3. Z.ai también señala que las llamadas fuera de horas pico consumen la mitad de los puntos estándar.
Si está ejecutando Claude Code o Cline contra su cuota de plan, tres veces las solicitudes por una caída de índice de tres puntos es un intercambio fácil para el trabajo rutinario. Mantenga GLM-5.3 para los problemas difíciles y deje que Flash absorba el volumen. La configuración para ambos arneses se encuentra en nuestra guía de Claude Code y Cline.
Verifique el multiplicador de cuota en z.ai antes de planificar en torno a él, ya que los términos del plan cambian con más frecuencia que las especificaciones del modelo.
El plazo de precios
Un descuento de lanzamiento del 50% en GLM-5.3-Flash se extiende hasta el 9 de septiembre de 2026. Hasta entonces, las tarifas efectivas son de $0.075 de entrada y $0.25 de salida por millón, lo que amplía la brecha con GLM-5.3 a aproximadamente dieciocho veces.
Después de que expire, se aplicará el precio de lista de $0.15 y $0.50 y la brecha volverá a ser de aproximadamente nueve veces. De cualquier manera, Flash es drásticamente más barato. El plazo es importante para fijar las proyecciones de costos, no para la elección entre los dos modelos. Nuestro desglose de precios tiene los números calculados.
Una regla de decisión
Use GLM-5.3-Flash cuando:
- Sus entradas incluyen imágenes, video o archivos.
- El costo por token es la restricción que está optimizando.
- Realiza extracción, clasificación o enrutamiento de alto volumen.
- Está en el Plan de Codificación y quiere que su cuota rinda más.
- Desea pesos abiertos con licencia MIT que pueda autoalojar. Ejecutarlo localmente cubre el hardware.
Use GLM-5.3 cuando:
- Transmite respuestas largas a un humano que está esperando y el rendimiento es la experiencia percibida.
- Su trabajo implica un razonamiento a largo plazo donde tres puntos de índice se acumulan en varios pasos.
- La calidad de la salida es juzgada por una persona en lugar de ser verificada por una prueba.
Use ambos cuando: pueda enrutar. Envíe la mayor parte del tráfico a Flash y escale a GLM-5.3 en caso de fallo, baja confianza o tipo de tarea. La diferencia de precio de nueve veces hace que valga la pena construir un enrutador, y como ambos modelos se encuentran detrás del mismo punto final compatible con OpenAI, el enrutamiento es un cambio de ID de modelo en lugar de una integración.
Migrar entre ellos
Si ya está usando GLM-5.3 y está evaluando un cambio, la parte mecánica es trivial y la parte de validación es donde reside el trabajo.
Lo que no cambia. La URL base, el esquema de autenticación, las formas de solicitud y respuesta, la semántica de streaming y los esquemas de llamada a herramientas. Ambos modelos se encuentran detrás de la misma superficie compatible con OpenAI. El intercambio es una cadena de ID de modelo.
Lo que sí cambia. El costo por llamada disminuye aproximadamente nueve veces. La generación se ralentiza aproximadamente a la mitad. La calidad del razonamiento se desplaza en tres puntos del índice. Y obtiene la entrada de imágenes que antes no estaba disponible.
Qué verificar antes de comprometerse. Ejecute sus prompts reales a través de ambos y compare en cuatro ejes: la corrección de la salida en casos que pueda verificar, la latencia de extremo a extremo, incluyendo el tiempo de generación en lugar de solo el primer token, el recuento de tokens del objeto `usage` en cada respuesta y el comportamiento en su contexto más largo y realista.
El cuarto punto es el que detecta la mayoría de los problemas. Los modelos que parecen equivalentes en prompts cortos pueden divergir notablemente cuando el contexto está lleno, y una tabla de referencia nunca le dirá eso sobre sus propios datos.
Si comenzó con el modelo base, qué es GLM-5.3 lo cubre en sus propios términos, y la guía de API de GLM-5.3 tiene la configuración de la que está migrando.
Pruébelo en lugar de confiar en la tabla
Cada número anterior es una afirmación del proveedor o un benchmark de terceros ejecutado en la carga de trabajo de otra persona. Ninguno le dirá cómo se comportan estos dos modelos con sus prompts.
El cambio es una cadena. Apunte un cliente compatible con OpenAI a `https://api.z.ai/api/paas/v4/`, ejecute sus prompts reales a través de `glm-5.3-flash` y `glm-5.3`, y compare las salidas, la latencia y el recuento de tokens en el tráfico que le interesa. La guía de la API tiene la configuración.
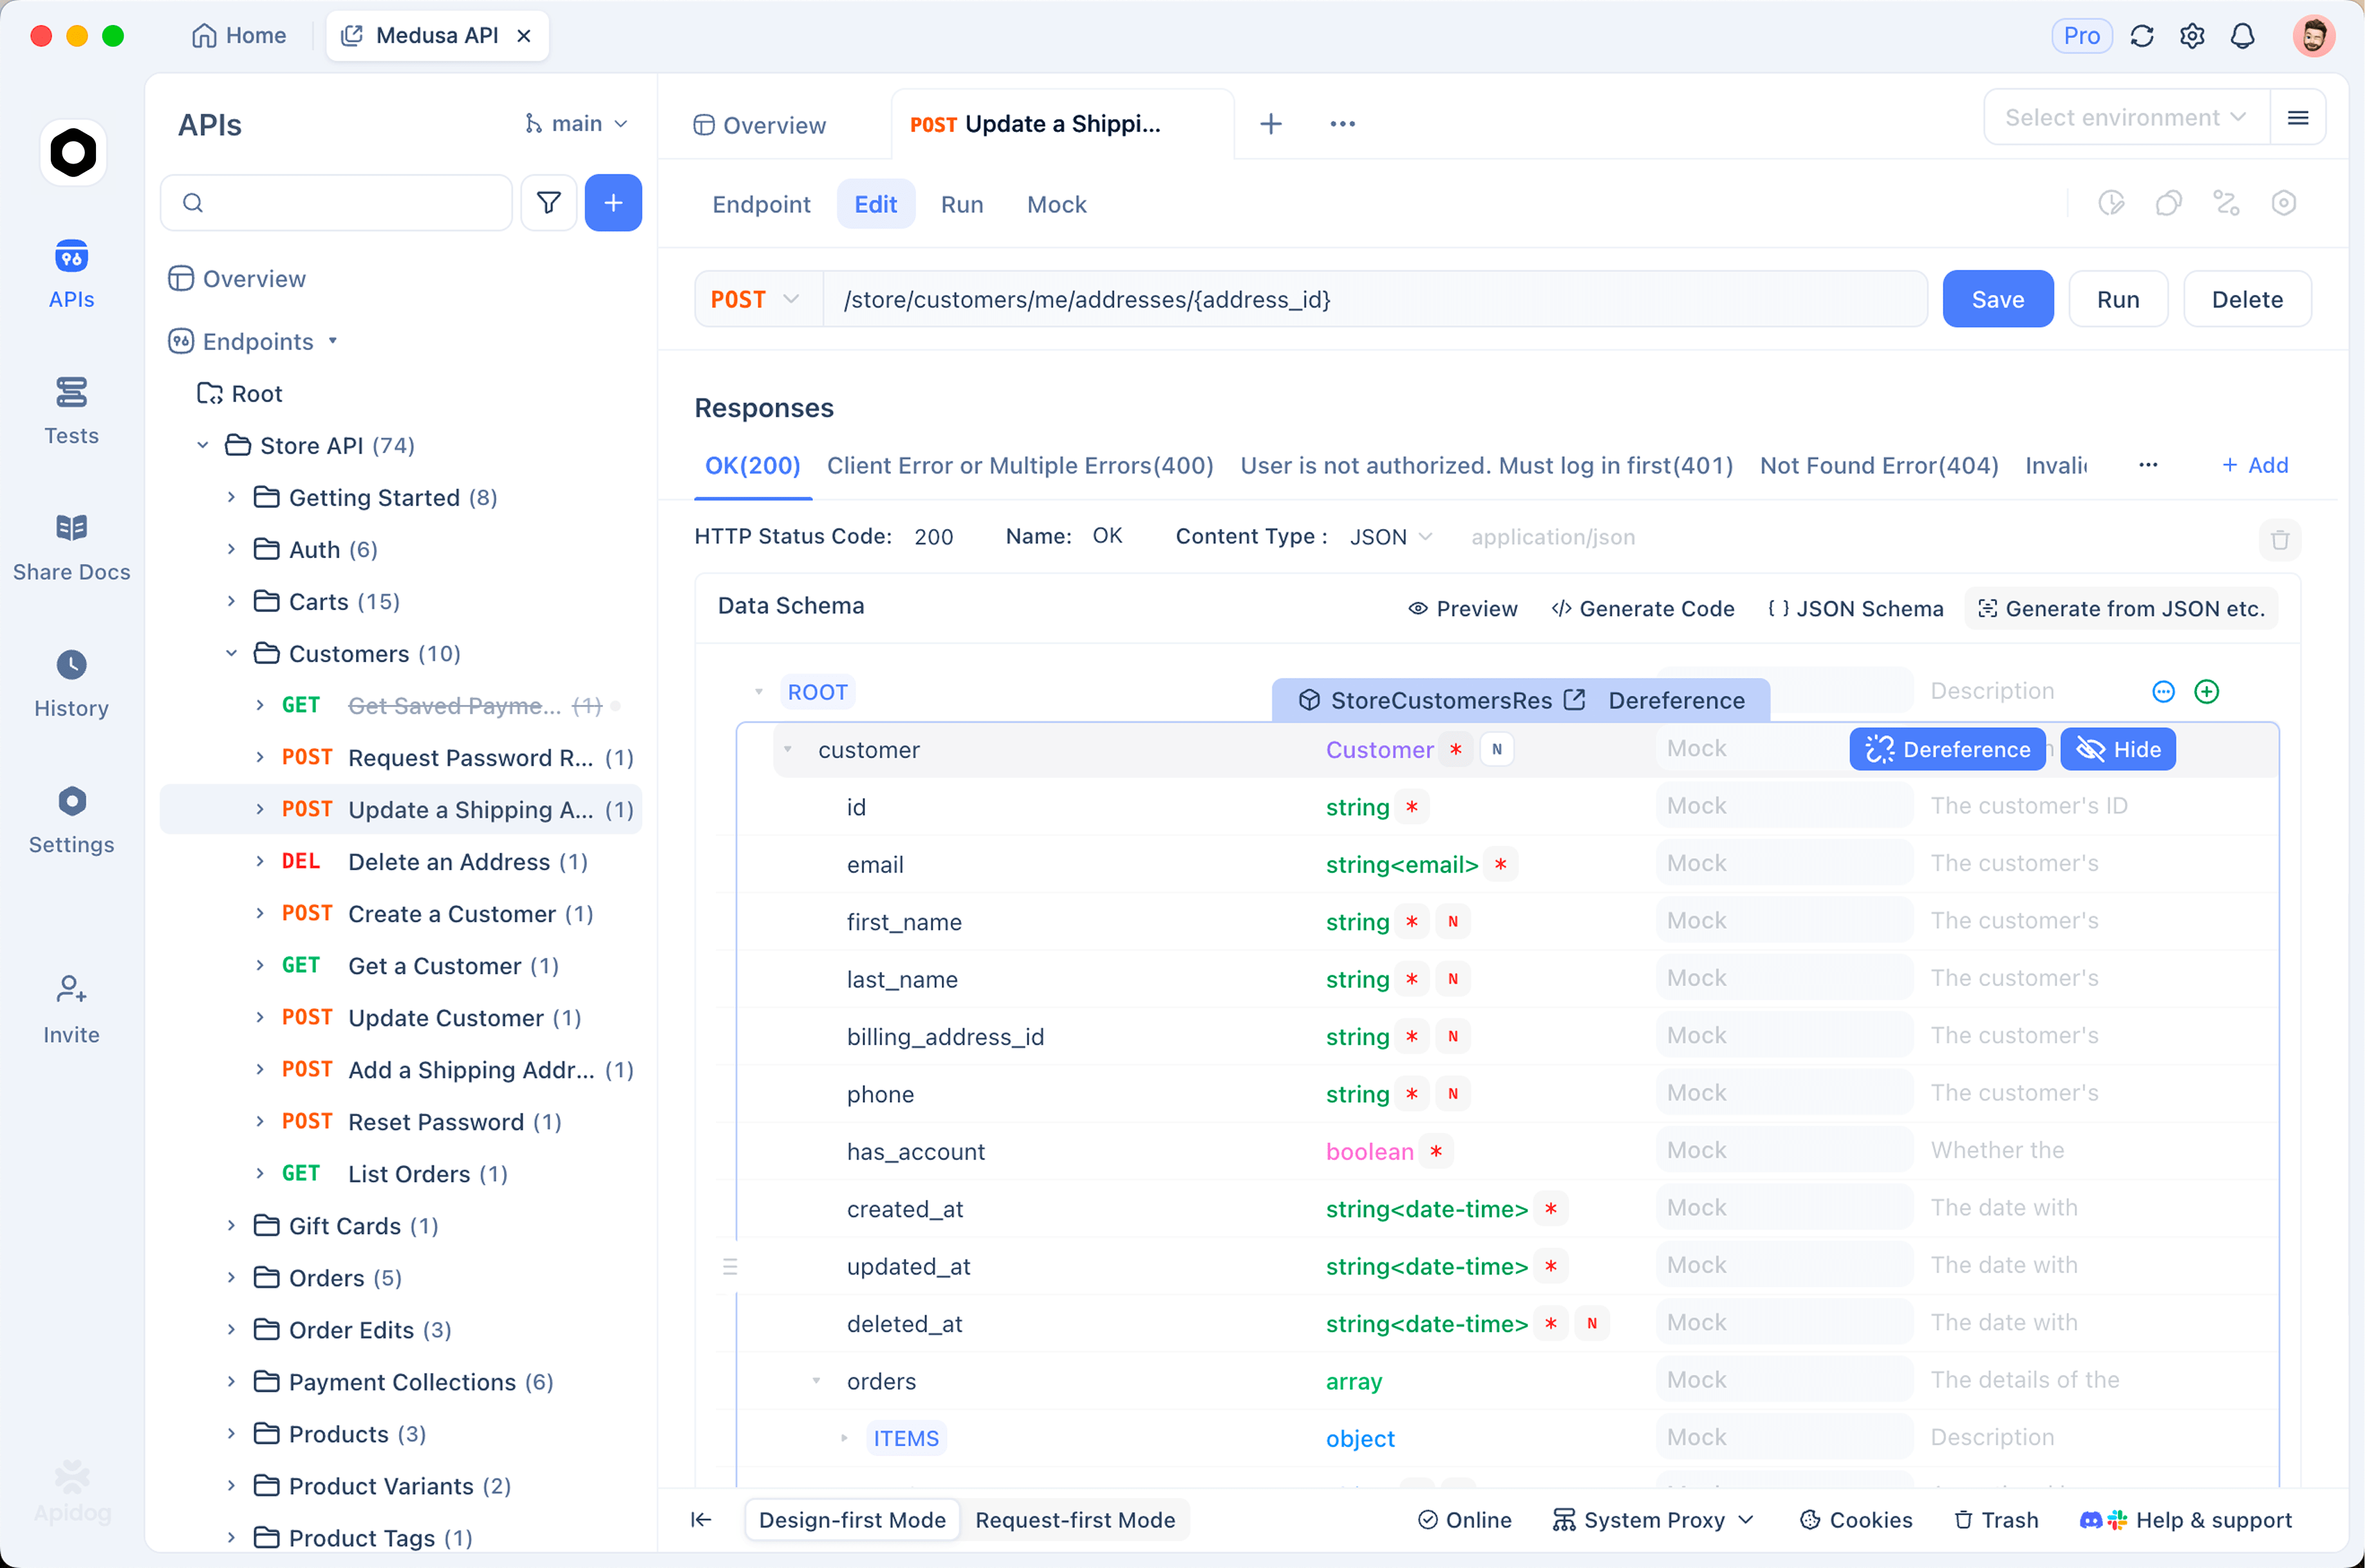
Aquí es donde vale la pena guardar la comparación como un conjunto repetible. En Apidog puede mantener ambas llamadas en una colección con el ID del modelo como variable de entorno, adjuntar aserciones a los campos que su aplicación lee y volver a ejecutar todo cuando expire el descuento o Z.ai lance la próxima revisión. Una elección de modelo que puede volver a probar en treinta segundos es una decisión que puede revisar; una que vive en el historial de comandos no lo es.
Preguntas frecuentes
¿Es GLM-5.3-Flash solo un GLM-5.3 más pequeño? No. Es un modelo base entrenado por separado con una arquitectura de atención diferente, no una destilación ni una variante podada.
¿Tienen la misma ventana de contexto? Sí, 1,048,576 tokens para ambos.
¿Cuál es mejor para codificar? Flash obtiene 84.3 en Terminal-Bench 2.1 y 63.4 en DeepSWE según Z.ai, lo cual es fuerte. GLM-5.3 es algo más fuerte en razonamiento general. Para los usuarios del plan de codificación, la cuota 3x suele ser decisiva.
¿Puedo cambiar entre ellos sin cambios en el código? Sí. El mismo punto final compatible con OpenAI, diferente ID de modelo. Solo la entrada de imagen es exclusiva de Flash.
¿El más barato seguirá siendo barato? El precio refleja una caché KV más pequeña y una computación de atención más baja en lugar de una promoción, por lo que la ventaja estructural debería persistir. El descuento adicional de lanzamiento del 50% expira el 9 de septiembre de 2026.