
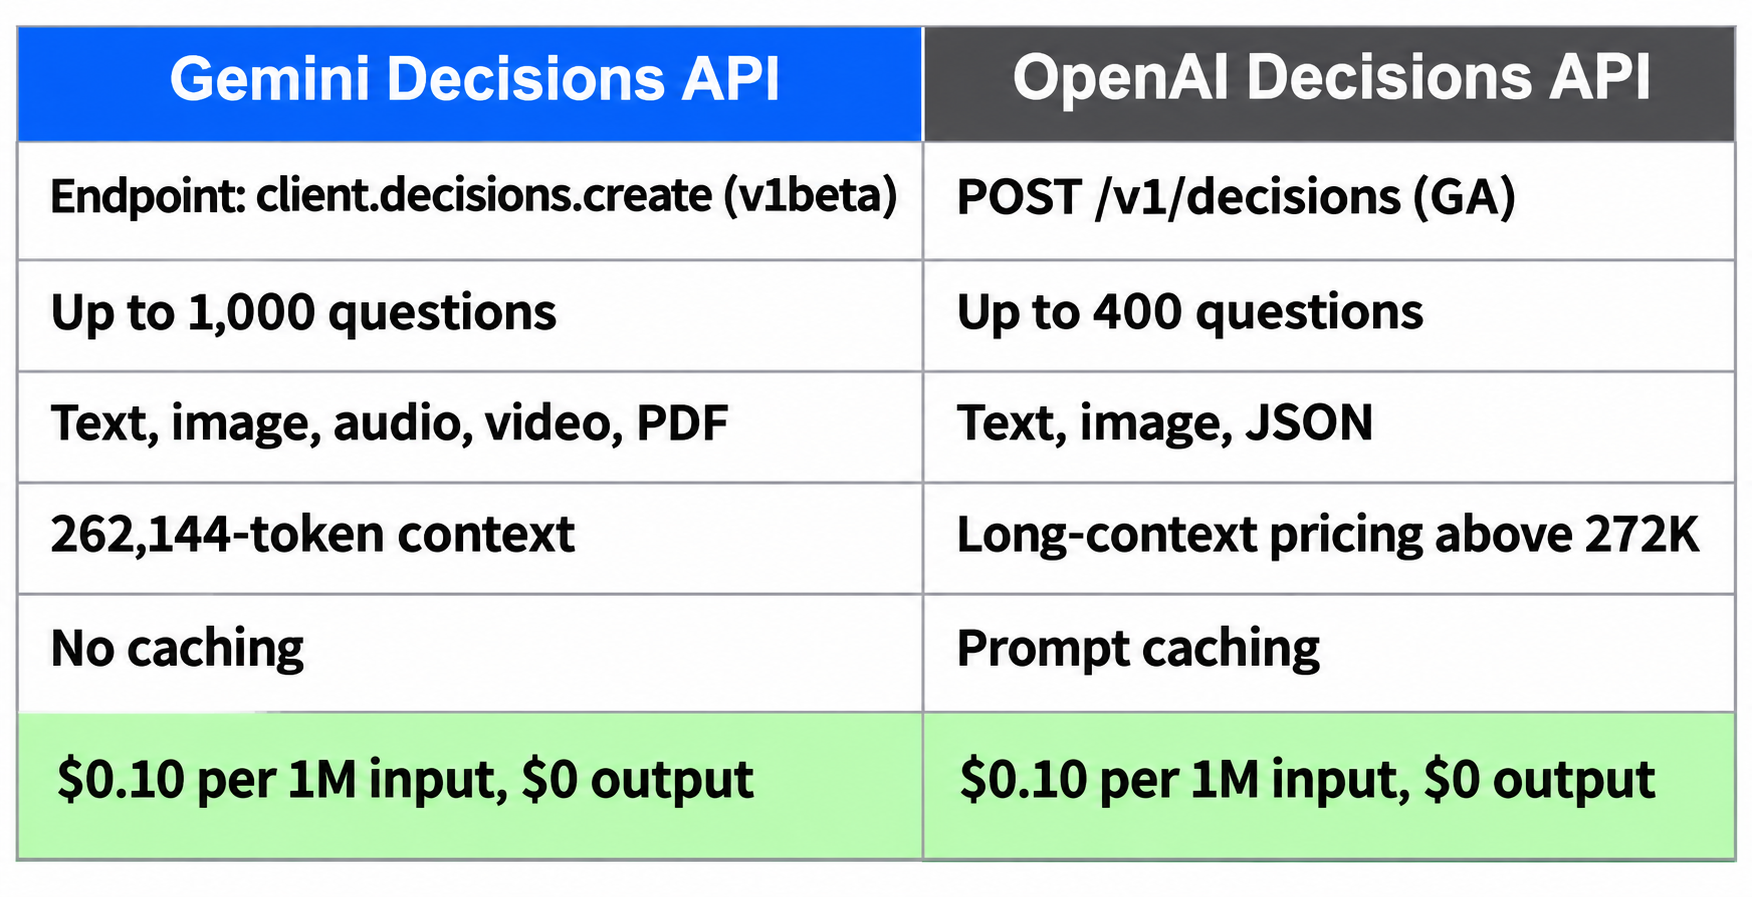
La comparación entre la Gemini Decisions API y la OpenAI Decisions API se reduce a las entradas y los límites, no al precio. Ambas cobran $0.10 por cada millón de tokens de entrada y nada por la salida. Elige Gemini si necesitas entrada de audio, video o PDF, más de 400 preguntas por solicitud, o un nivel gratuito. Elige OpenAI si necesitas un endpoint en GA, caché de prompts, evidencia en JSON y llamadas a herramientas, o términos ZDR y HIPAA.
Qué hace una Decisions API
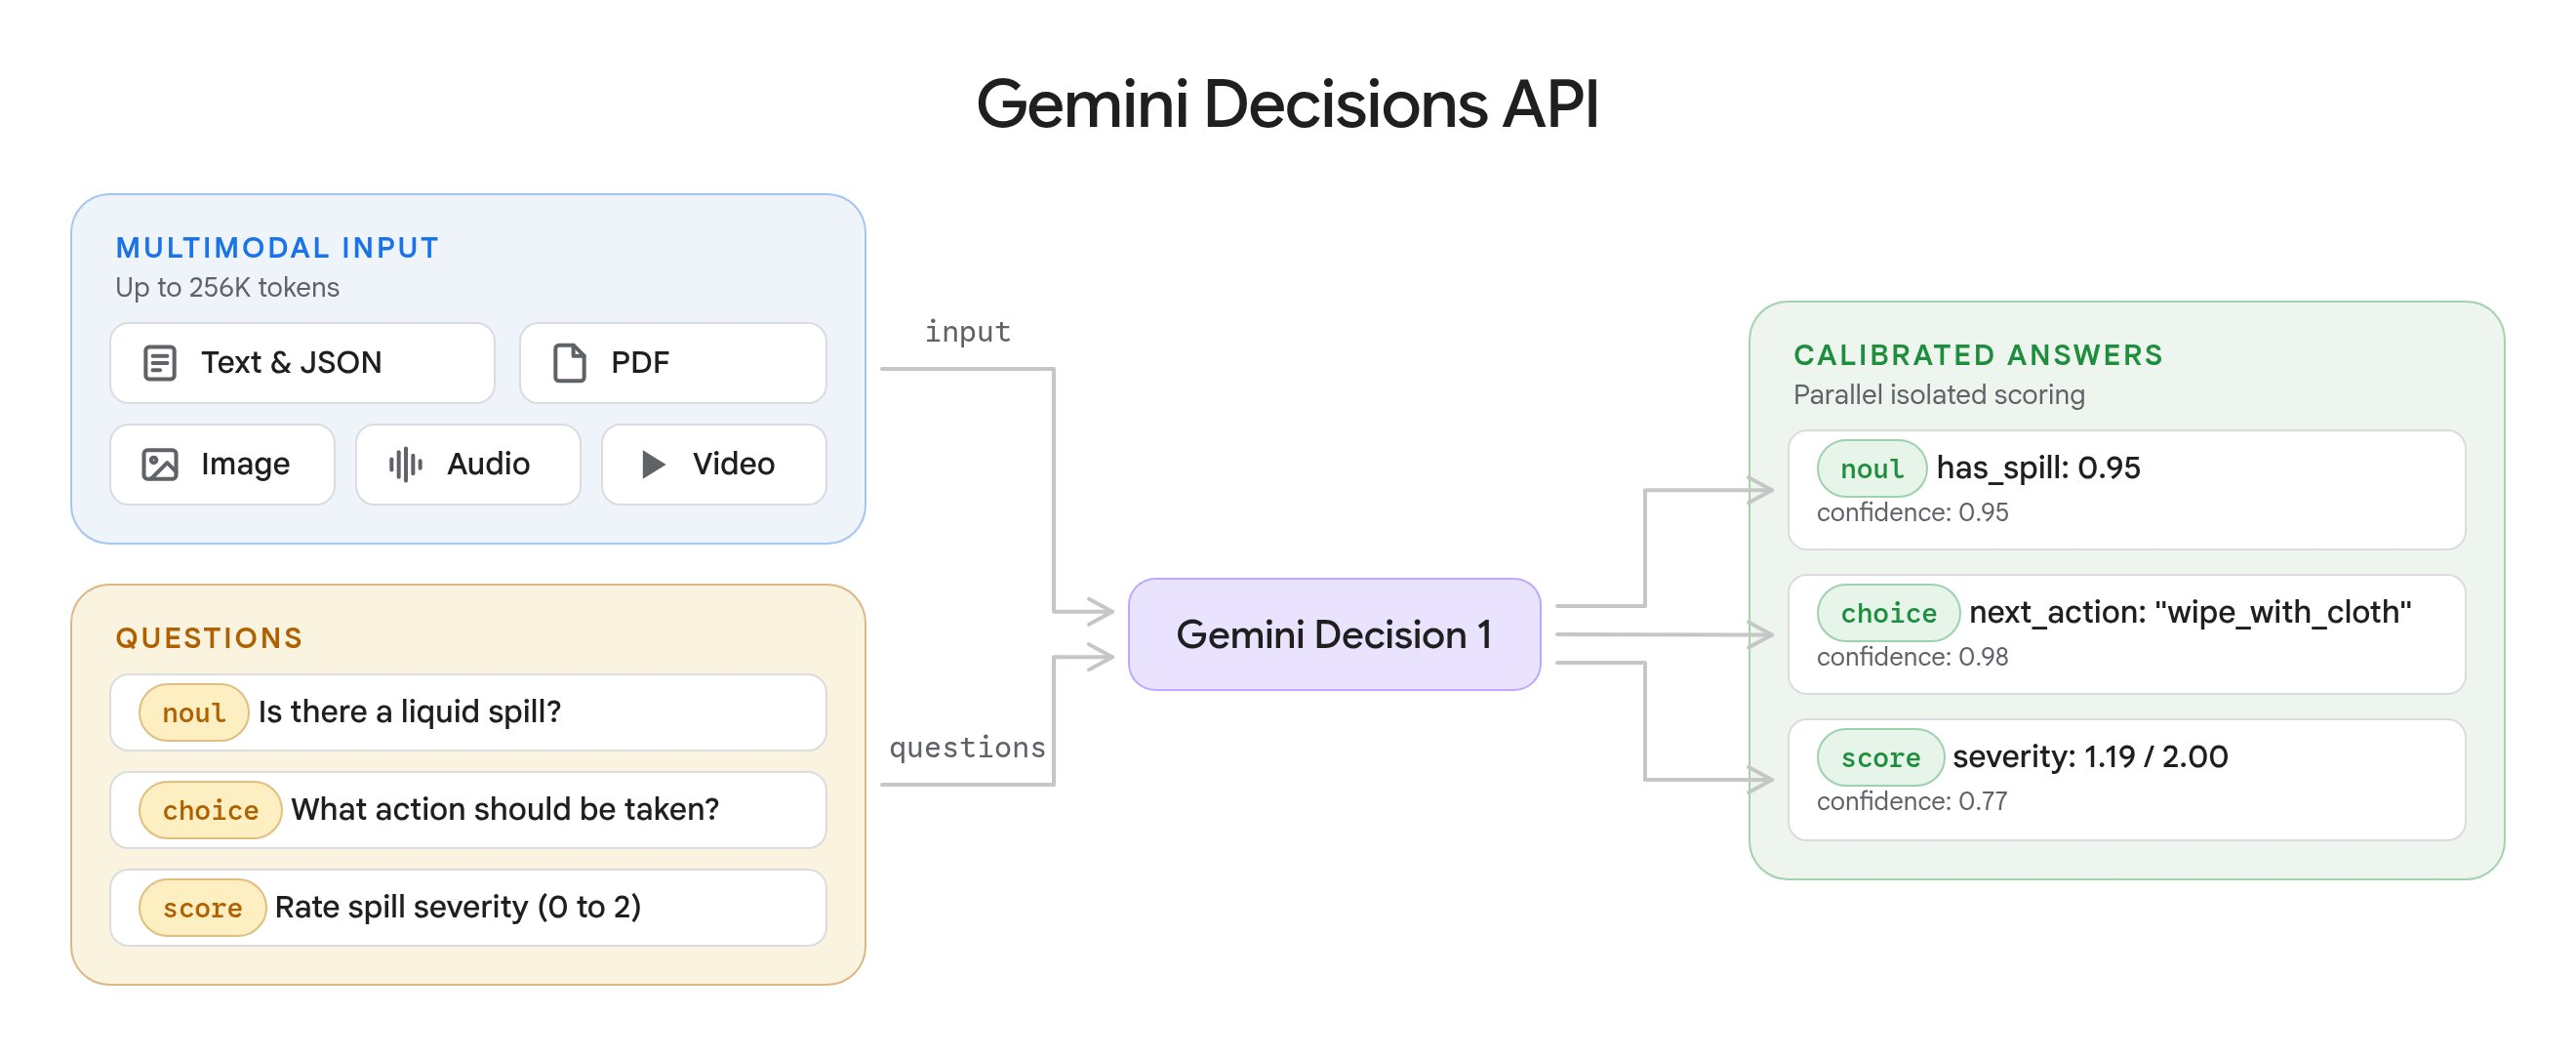
Una Decisions API es un endpoint que responde preguntas de conjunto cerrado sobre tu entrada en lugar de generar texto. Envías evidencia compartida más una lista de preguntas tipadas (sí/no, elegir una opción, puntuar en una escala) y recibes probabilidades y una puntuación de confianza por cada respuesta. Los tokens de salida cuestan cero, así que solo pagas por la entrada.
OpenAI lanzó la primera. Su Decisions API pasó a GA el 22 de octubre de 2026 con gpt-6-luna. Google respondió el 11 de noviembre de 2026 con la Gemini Decisions API, impulsada por un nuevo modelo, gemini-decision-1.
Ambas apuntan al enrutamiento, la selección de herramientas, las verificaciones de políticas y la calificación con rúbricas. Se diferencian en qué puedes alimentarles y hasta dónde llega una sola solicitud.
Gemini Decisions API vs OpenAI Decisions API de un vistazo
Cada fila proviene de la documentación de cada proveedor, consultada el 12 de noviembre de 2026. «No documentado» significa que la documentación no lo menciona.
| Gemini Decisions API | OpenAI Decisions API | |
|---|---|---|
| Modelo | gemini-decision-1 (única opción) |
gpt-6-luna (única opción) |
| Estado | v1beta en la Gemini Developer API |
GA desde el 22 de octubre de 2026 |
| Llamada | client.decisions.create(...), SDK 3.2+ |
POST /v1/decisions |
| Preguntas por solicitud | 1 a 1,000 | 1 a 400 |
| Formato de pregunta | Mapa con tus propios IDs como claves | Array, cada una con un name opcional |
| Tipo sí/no | noul (0.01 a 0.99) |
predicate (0 a 1) |
| Opciones de elección | 2 a 255 | 2 a 255 |
| Niveles de puntuación | 2 a 255 (se recomiendan de 2 a 10) | 2 a 10 |
| Tipos de entrada | Texto, imagen, audio, video, PDF | Texto, imagen, input_json, llamadas a herramientas y sus salidas |
| Media en el texto de la pregunta | No, solo texto | Sí, imágenes en instructions |
| Ventana de contexto | 262,144 tokens | No documentada para este endpoint; precios de contexto largo por encima de 272K |
| Precio de entrada | $0.10 / 1M | $0.10 / 1M (2x por encima de 272K) |
| Precio de salida | $0 | $0 |
| Caché | No compatible | Caché de prompts, $0.01 / 1M de entrada en caché |
| Batch / Flex | No compatibles | No documentado |
| Nivel gratuito | Sí, en Google AI Studio | No documentado para este endpoint |
| Latencia publicada | 150 a 250 ms de extremo a extremo (cifra de Google) | «Unas 10 veces más rápido que la Responses API» |
| Límites de frecuencia | Publicados por nivel | Por organización, no publicados por endpoint |
| ZDR / HIPAA | No documentado | Compatible para clientes elegibles |
| Procesamiento regional | No documentado | EE. UU. y UE, con un recargo del 10 % |
Formato de la solicitud: misma idea, JSON diferente
Las dos APIs se parecen hasta que escribes el payload. Gemini usa tus propios IDs como claves para las preguntas y llama a su tipo sí/no noul:
result = client.decisions.create(
    model="gemini-decision-1",
    input="I was charged twice for my order.",
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this request?",
            "criteria": {"billing": "Payments and refunds.", "other": ""},
        },
    },
)
OpenAI recibe un array ordenado, usa predicate para sí/no y lista las opciones como objetos value y description. Nuestra guía paso a paso de OpenAI incluye la solicitud completa.
Tres diferencias importan en el código de producción:
- Consulta de respuestas. Gemini devuelve un mapa con tus IDs de pregunta como claves. OpenAI devuelve un array que debes emparejar por
name. - Rechazos. OpenAI puede devolver una respuesta
refusalpara una pregunta mientras las demás siguen recibiendo respuesta. Gemini bloquea toda la solicitud con un HTTP 400 y un códigosafetyoprohibited_contentcuando se activan los filtros de entrada. - Ordenación de las opciones. Gemini ordena las claves de opciones alfabéticamente antes de puntuar, así que una clave como
none_of_the_abovequeda antes queshipping. Usaothercomo opción comodín en Gemini.
Las probabilidades de noul en Gemini están entre 0.01 y 0.99, por lo que un umbral de > 0.99 nunca se cumple. El modelo de preguntas de tres tipos te resultará familiar si ya leíste nuestra comparación de OpenAI vs Jev.
Entradas y límites: donde Gemini toma la delantera
La entrada de Gemini reutiliza los bloques de contenido de la Interactions API: text, image, audio, video y document (PDF). Combina una grabación de llamada con metadatos de cuenta y hazle 1,000 preguntas. Los datos inline admiten hasta 100 MB por solicitud (50 MB para PDFs); los URIs de la Files API y las URL HTTPS funcionan hasta 15 MB cada uno. Los bloques de imagen y video aceptan un ajuste de resolution para intercambiar detalle por tokens.
OpenAI cubre menos tipos de media, pero más estructura. Según la guía de Decisions de OpenAI, input acepta partes de texto, imágenes y input_json, además del historial de conversación con llamadas a funciones y sus salidas. No admite archivos ni audio. Las instructions de cada pregunta pueden incluir su propia imagen, lo que resulta útil para comparar muchos candidatos contra una sola referencia.
El reparto:
- Audio, video o PDFs escaneados como evidencia: Gemini.
- Transcripciones de llamadas a herramientas o JSON en bruto: OpenAI de forma nativa; Gemini exige serializarlos a texto.
- Imágenes por pregunta: solo OpenAI.
Precios: misma etiqueta, facturas diferentes
Ambas publican $0.10 por cada millón de tokens de entrada sin costo por la salida, y ambas facturan la entrada compartida una vez por solicitud. Las facturas divergen con la entrada repetida.
La documentación de Gemini afirma claramente que la Decisions API no admite caché de contexto, Batch, Flex ni Priority, y que «la entrada repetida entre solicitudes se cobra en su totalidad». OpenAI añadió caché de prompts en GA. Un prefijo de input compartido de al menos 1,024 tokens puede acceder a la caché a $0.01 por millón, con las escrituras en caché facturadas a las tarifas estándar de Luna ($0.125 por millón para escrituras de 30 minutos). Consulta la página de precios de OpenAI para ver las tarifas de caché actuales.
Un ejemplo práctico (nuestro cálculo, no una cotización de ningún proveedor): cada solicitud verifica el mismo documento de políticas de 10,000 tokens con 20 preguntas de 50 tokens cada una, un millón de veces al mes.
- Gemini: 11,000 tokens x 1M solicitudes = 11B tokens x $0.10 por millón = $1,100.
- OpenAI, con todos los accesos desde caché: 10B tokens en caché x $0.01 por millón = $100, más 1B tokens de preguntas sin caché x $0.10 por millón = $100, es decir, unos $200 más las escrituras en caché.
Con entrada nueva en cada solicitud, como un ticket o una foto nueva, la caché no ayuda y ambas cuestan lo mismo por token. OpenAI también aplica un multiplicador de 2x por encima de los 272K tokens de entrada y un recargo del 10 % por procesamiento regional.
La ventaja de Gemini es un nivel gratuito. La página de precios de Google indica que la entrada de Gemini Decision es «gratuita» allí, pero los datos del nivel gratuito se usan para mejorar los productos de Google. Los datos del nivel de pago no.
Velocidad y límites de frecuencia
Google dice que Gemini Decision 1 puntúa las opciones en un solo paso de inferencia: 50 a 100 ms de cómputo mediano del modelo, 150 a 250 ms de extremo a extremo, casi plano de 1 a 100 preguntas, con entradas de hasta 16K tokens. Esas son las afirmaciones de Google hasta que las midas tú mismo.
OpenAI publica una proporción, no un número: «unas 10 veces más rápido que la Responses API». Nuestro análisis de Decisions vs Responses API explica qué significa eso.
Los límites de frecuencia siguen el mismo patrón. La página de límites de frecuencia de Google lista los límites de Gemini Decision por nivel:
| Nivel | RPM | TPM | RPD |
|---|---|---|---|
| Gratuito | 200 | 50,000 | 10,000 |
| Nivel 1 | 1,500 | 1,000,000 | 50,000 |
| Nivel 2 | 5,000 | 4,000,000 | Ilimitado |
| Nivel 3 | 15,000 | 10,000,000 | Ilimitado |
OpenAI no publica un límite específico para Decisions; consulta la página de límites de tu organización.
Cuándo elegir cada una
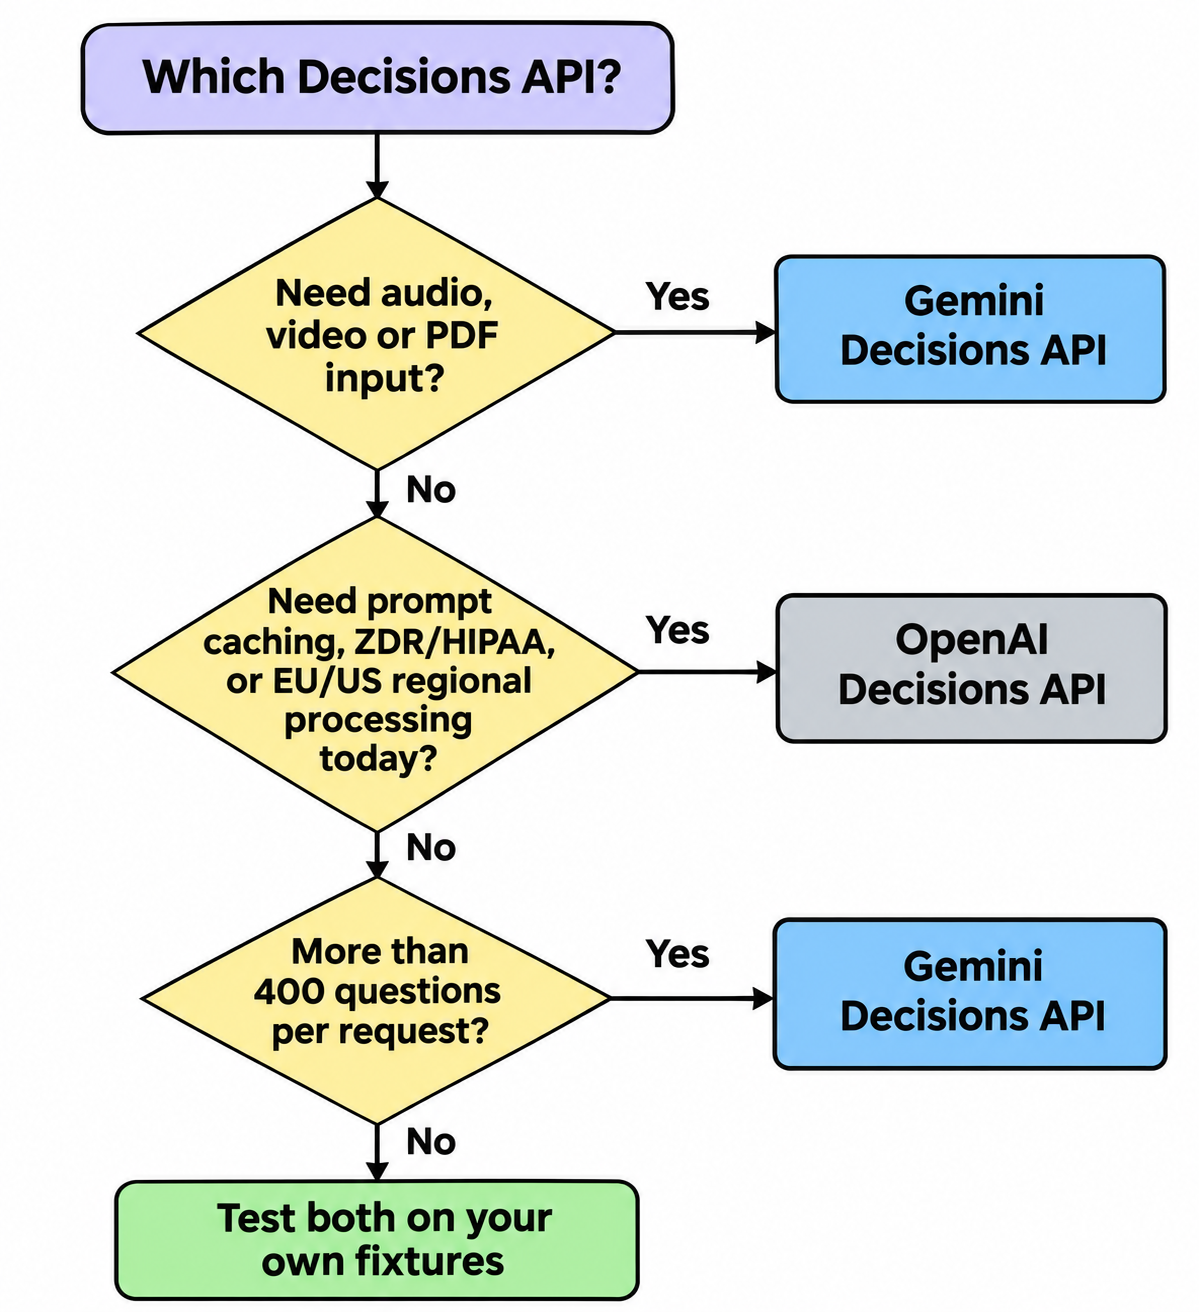
Elige la Gemini Decisions API cuando:
- Tu evidencia es audio, video o PDF, sin paso de transcripción ni OCR.
- Necesitas más de 400 preguntas por solicitud.
- Quieres hacer prototipos a $0 en Google AI Studio.
Elige la OpenAI Decisions API cuando:
- Necesitas un endpoint en GA hoy. El de Gemini está en
v1beta, y el soporte en Vertex AI «llegará pronto». - Reutilizas una gran entrada compartida y quieres que la caché reduzca la factura.
- Tu evidencia es el historial de un agente con llamadas a herramientas, o JSON en bruto.
- Necesitas ZDR, elegibilidad HIPAA, o procesamiento regional en EE. UU. y la UE.
- Ya usas GPT-6 Luna o GPT-Live; OpenAI documenta un activador nativo de GPT-Live para Decisions.
Si ninguna de esas razones lo resuelve, prueba ambas.
Deja que tu agente de código ejecute la prueba A/B con Apidog CLI
Los benchmarks de los proveedores no muestran cómo maneja cada modelo tus tickets. Una prueba A/B basada en fixtures sí lo hace, y tu agente de código puede construirla y ejecutarla con Apidog CLI.
Configura una sola vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Luego dale a tu agente un solo prompt:
In Apidog project <id>, create two endpoints: Gemini Decisions
(take the REST path from Google's Decisions API docs, model
gemini-decision-1) and OpenAI Decisions (POST /v1/decisions,
model gpt-6-luna). Both ask the same "department" choice question
(billing, technical, shipping, other) about {{ticket}}.
Build a test scenario that calls both for each row of fixtures.csv,
asserts HTTP 200, saves each answer, confidence and response time,
and flags rows where the two answers disagree. Run it and summarize.
El agente valida sus payloads, crea los recursos y ejecuta el escenario una vez por cada fila del fixture:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file gemini-decisions.json
apidog endpoint create --project <id> --file gemini-decisions.json
apidog endpoint create --project <id> --file openai-decisions.json
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <id> --file decisions-ab.json
apidog run -t <scenarioId> --project <id> -e <envId> -d fixtures.csv -r cli,json
La opción -d alimenta una fila de CSV por iteración, así que 200 tickets etiquetados se convierten en 200 llamadas emparejadas, y el reporte JSON alinea respuestas, confianza y tiempos. Compáralos con tus etiquetas y tendrás precisión y latencia sobre tus propios datos. Guarda ambas claves de API en el entorno de Apidog, no en el prompt. Consulta la referencia del comando apidog run y Apidog CLI en Claude Code.
El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿La Gemini Decisions API es más barata que la OpenAI Decisions API? No en precio de lista: ambas cobran $0.10 por cada millón de tokens de entrada. OpenAI resulta más barata con una entrada reutilizada grande ($0.01 por millón en caché). Gemini es más barata para prototipos gracias a su nivel gratuito.
¿Puede la OpenAI Decisions API leer audio o PDFs? No. Acepta texto, imágenes y JSON. Gemini añade audio, video y PDFs.
¿Está la Gemini Decisions API lista para producción? Se ofrece como v1beta; el soporte en Google Cloud «llegará pronto». El endpoint de OpenAI está en GA desde el 22 de octubre de 2026.
¿Cuántas preguntas puedo hacer por solicitud? Gemini permite de 1 a 1,000, limitadas por su ventana de contexto de 262,144 tokens. OpenAI permite de 1 a 400.
¿Puedo cambiar entre ambas sin reescribir el código? No directamente: mapas de preguntas vs arrays, noul vs predicate, formatos de opciones diferentes. Coloca un adaptador ligero por delante y prueba ambas con los mismos fixtures.