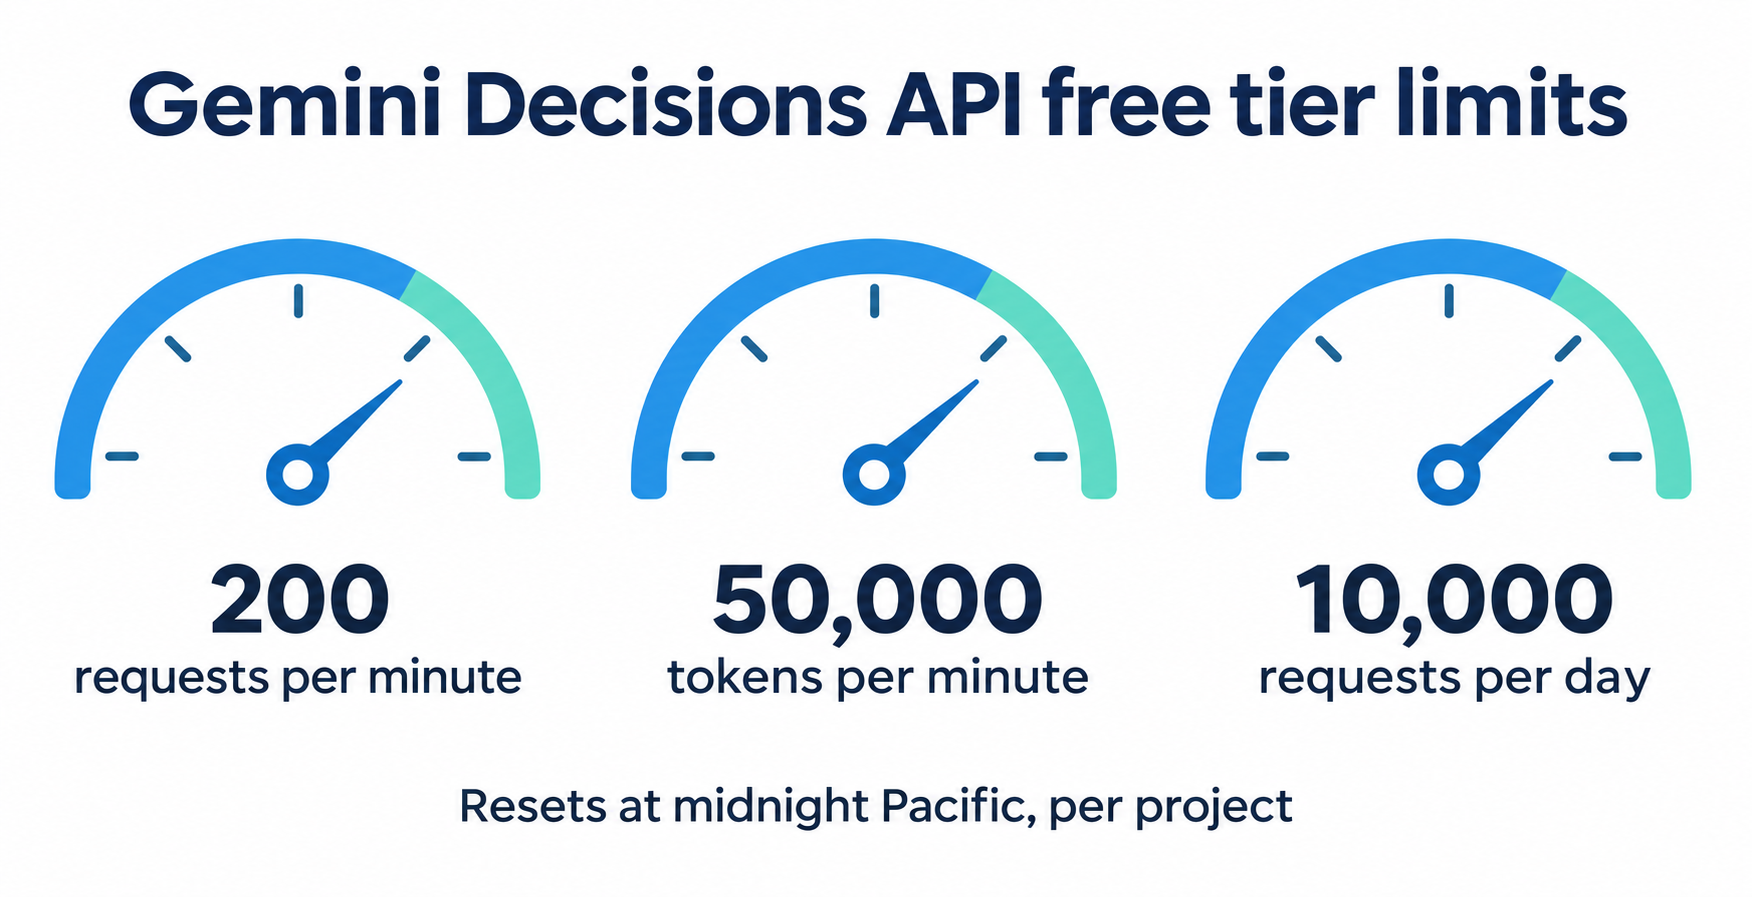
Hoy puedes usar la API de Gemini Decisions gratis. El nivel gratuito de Google para gemini-decision-1 no cobra nada por la entrada, no factura tokens de salida y permite 200 solicitudes por minuto, 50.000 tokens por minuto y 10.000 solicitudes al día por proyecto. Solo necesitas una clave de API de AI Studio y no se requiere cuenta de facturación. La contrapartida: en el nivel gratuito, Google puede usar tu contenido para mejorar sus productos.
A continuación: qué significan esos límites en cargas de trabajo reales, los cálculos de tokens detrás del precio de pago de $0.10 por 1M, las otras rutas gratuitas y cómo mantener las pruebas y la CI fuera de tu cuota diaria. Todas las cuotas y precios se leyeron de las páginas oficiales de Google el 12 de noviembre de 2026. La API se publica como v1beta, así que vuelve a verificar antes de hacer presupuestos. Para los tipos de preguntas en sí (noul, choice, score), consulta la guía de la API de Decisions de Google.
Qué incluye el nivel gratuito de la API de Gemini Decisions
El nivel gratuito de la API de Gemini Decisions es el nivel de uso sin costo de la API para desarrolladores de Gemini de Google aplicado al modelo gemini-decision-1. Proporciona a cada proyecto de Google Cloud procesamiento de entrada gratuito, cero cargos por salida y límites de tarifa fijos de 200 RPM, 50.000 TPM y 10.000 RPD, sin necesidad de configurar la facturación.
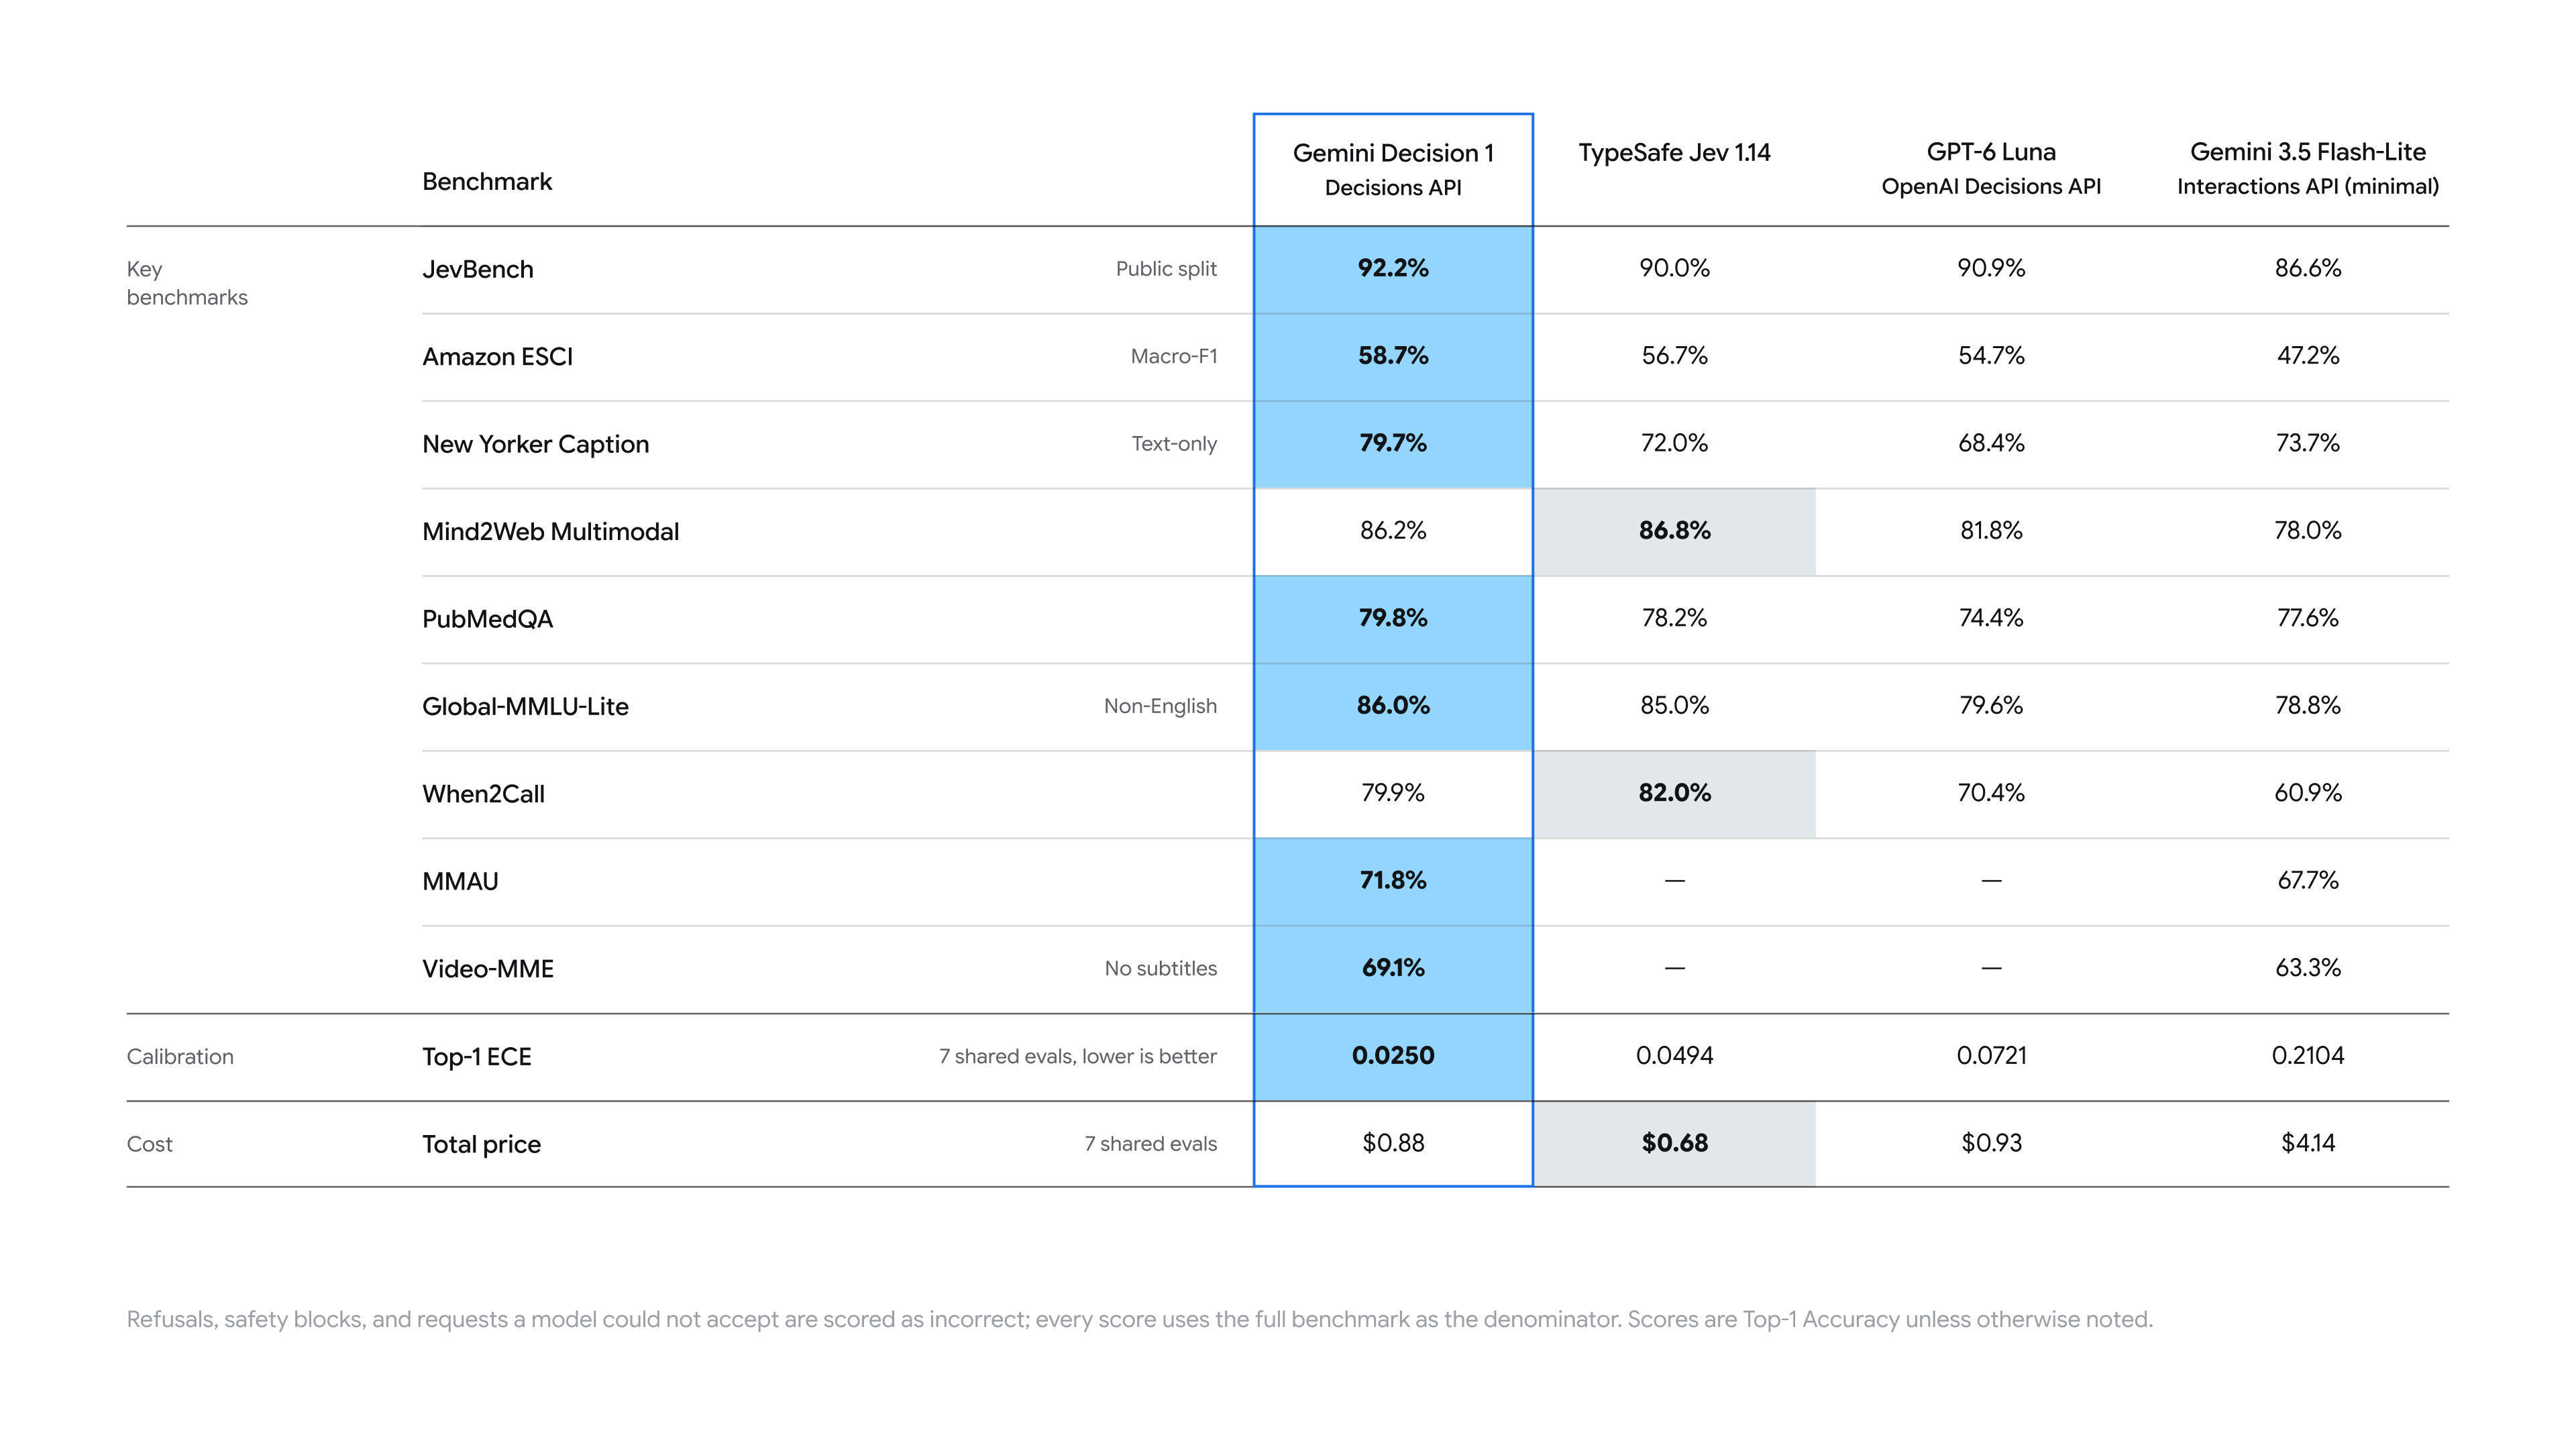
Esto es lo que dicen la página de precios y la página de límites de tarifa de Google, lado a lado:
| Elemento | Nivel gratuito | De pago (Nivel 1) |
|---|---|---|
| Precio de entrada (texto, imagen, video, audio, PDF) | Gratis | $0.10 por 1M de tokens |
| Precio de salida | No aplicable (0 tokens de salida) | No aplicable (0 tokens de salida) |
| Solicitudes por minuto | 200 | 1500 |
| Tokens por minuto | 50.000 | 1.000.000 |
| Solicitudes por día | 10.000 | 50.000 |
| Contenido usado para mejorar los productos de Google | Sí | No |
| Almacenamiento en caché de contexto | No disponible | No disponible |
Tres detalles importan más que las cifras destacadas:
- Los límites son por proyecto, no por clave de API. Crear cinco claves en un mismo proyecto no te da cinco cuotas.
- El límite diario se restablece a la medianoche, hora del Pacífico. Un trabajo por lotes que empieza a las 11 p. m., hora del Pacífico, obtiene una hora de la cuota de un día y 10.000 solicitudes nuevas después de la medianoche.
- Google puede usar los datos del nivel gratuito. La tabla de precios marca «Used to improve our products» como Sí en el nivel gratuito y No en el de pago. No envíes información personal de clientes, contratos ni imágenes médicas mediante una clave gratuita.
Cómo obtener una clave de API gratuita de Gemini Decisions
Puedes estar haciendo llamadas gratuitas en unos cinco minutos:
- Inicia sesión en Google AI Studio y haz clic en Create API key. Un proyecto nuevo empieza en el nivel gratuito.
- Instala el SDK 3.2 o posterior:
pip install -U google-genaionpm install @google/genai@latest. - Exporta la clave como
GEMINI_API_KEYpara que el SDK la detecte. - Envía una solicitud con
http_options={"api_version": "v1beta"}y lee el bloqueusagede la respuesta.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Order 8821 arrived with a cracked screen.",
    questions={
        "is_damaged": {"type": "noul", "instructions": "Did the item arrive damaged?"},
    },
)

print(result.answers["is_damaged"].noul)
print(result.usage.total_input_tokens)
Ese número de usage.total_input_tokens es el que debes registrar. En el nivel gratuito es lo que consume tus 50.000 TPM; en el de pago es lo único que se te factura.
Para el resto de las ofertas gratuitas de Google, consulta nuestra guía del nivel gratuito de la API de Gemini y cómo usar Gemini gratis.
Cómo funciona el precio de la API de Gemini Decisions
Solo pagas por los tokens de entrada, y la entrada compartida se cuenta una vez por solicitud sin importar cuántas preguntas hagas. Cada pregunta añade únicamente sus propios tokens de instrucción y criterios. La salida siempre es de 0 tokens, porque el modelo devuelve probabilidades, no texto.
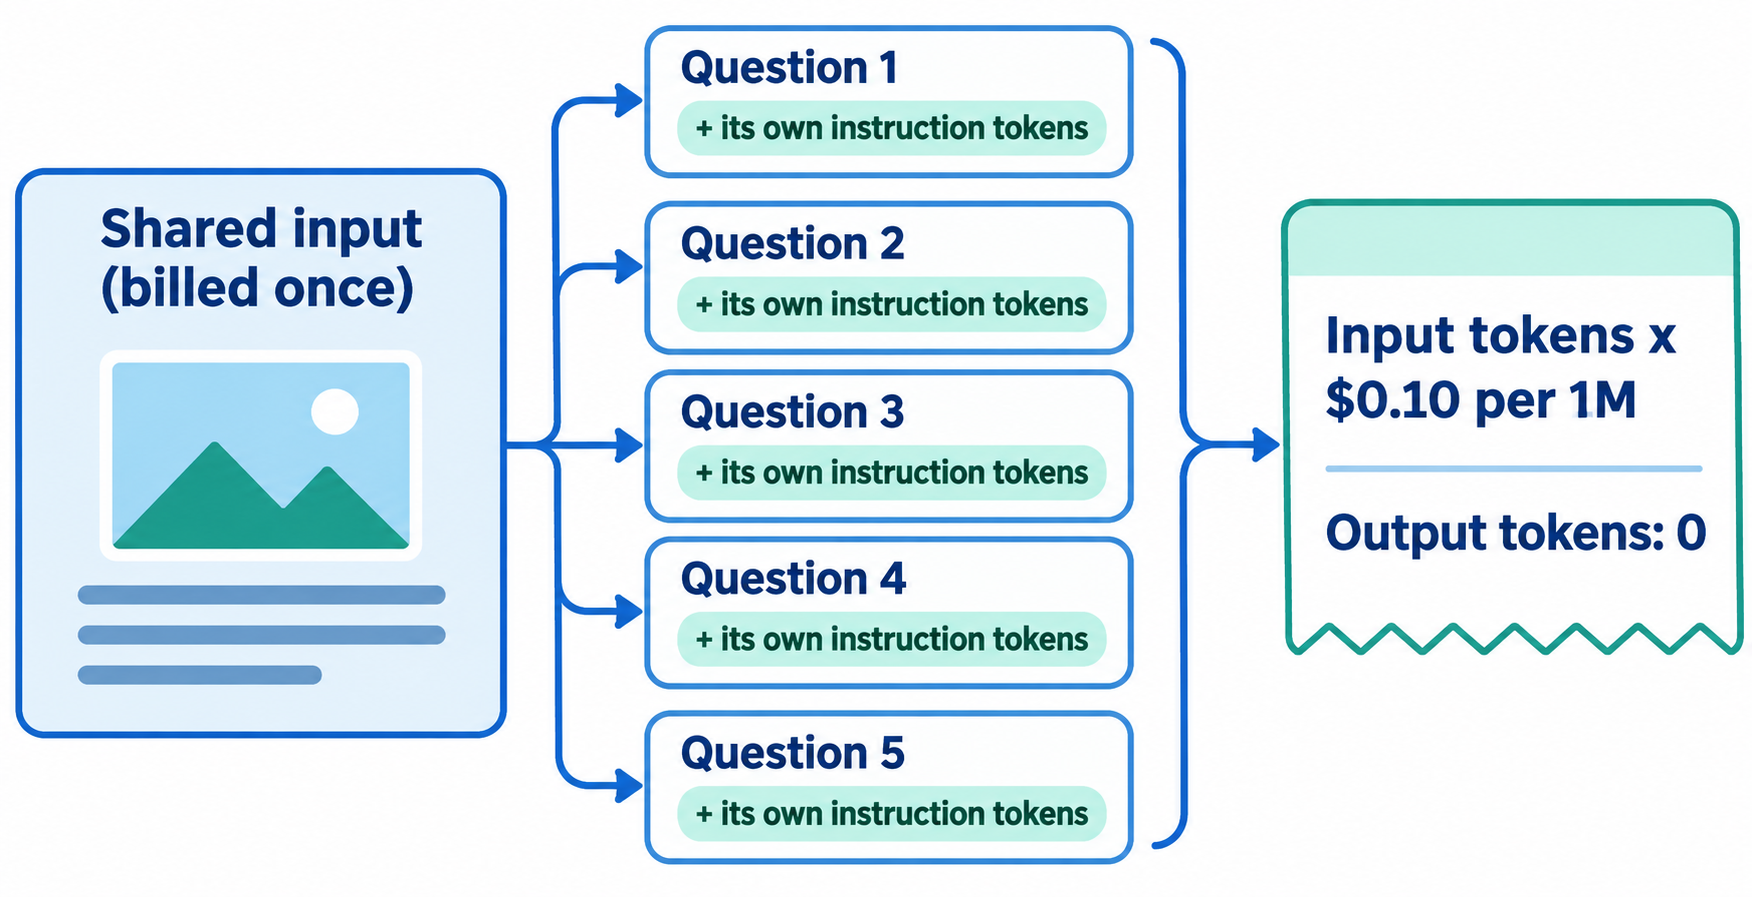
Así que la fórmula para una solicitud es sencilla:
input tokens = shared input + sum(each question's instructions + criteria)
paid cost    = input tokens / 1,000,000 x $0.10
Lo interesante es lo que esto hace al nivel gratuito. Con texto, el conteo de solicitudes (200 RPM, 10.000 RPD) suele ser el primer límite que se alcanza. Con imágenes, audio o documentos largos, el límite de 50.000 TPM es el que se alcanza primero.
Ejemplos de costos calculados: nivel gratuito frente a pago
Las cifras de tokens por pregunta siguientes son estimaciones (unos 30 tokens por pregunta corta). Los conteos de imagen y audio provienen de la tabla de resolución de medios de Google, que indica 280 tokens por imagen en low, 1120 en high, y 25 tokens por segundo de audio para los modelos actuales de Gemini. Ejecuta una solicitud real y reemplaza mis números por tus propios valores de usage.
10.000 fotos de productos x 16 preguntas
Supongamos que revisas fotos de entregas para verificar daños, colocación, legibilidad de etiquetas y otras 13 cosas.
- Por solicitud en resolución
low: 280 (imagen) + 20 (contexto de texto) + 16 x 30 (preguntas) = 780 tokens - 10.000 fotos: 10.000 x 780 = 7,8M de tokens
- Costo de pago: 7,8 x $0.10 = $0.78
- En resolución
high: 1120 + 20 + 480 = 1620 tokens por foto, 16,2M de tokens, $1.62
En el nivel gratuito, el TPM decide tu velocidad: 50.000 / 780 = unas 64 fotos por minuto. Las 10.000 terminan en unas 2 horas y 36 minutos y usan exactamente las 10.000 solicitudes de un día. En high, son unas 30 por minuto y 5,5 horas.
Ahora, el error que hay que evitar. Si envías las 16 verificaciones como 16 solicitudes separadas, cada una reenvía la imagen: 16 x 300 = 4800 tokens de imagen y contexto, más los mismos 480 tokens de preguntas, unos 5280 por foto. Eso da 52,8M de tokens ($5.28 pagados) y 160.000 solicitudes, es decir, 16 días de cuota del nivel gratuito. Agrupa las preguntas en una sola solicitud.
10.000 tickets de soporte x 3 preguntas de enrutamiento
- Por solicitud: 250 (texto del ticket) + 3 x 40 (preguntas con criterios) = 370 tokens
- 10.000 tickets: 3,7M de tokens, $0.37 pagados
- Nivel gratuito: 50.000 / 370 = 135 solicitudes por minuto, por debajo del límite de 200 RPM. Las 10.000 solicitudes de un día cubren 10.000 tickets.
PDFs largos
La ventana de contexto es de 262.144 tokens, pero el TPM gratuito es de 50.000, así que un solo contrato de 120.000 tokens supera un minuto completo del presupuesto gratuito. La documentación de Google no especifica cómo maneja el nivel gratuito una única solicitud por encima del límite de TPM, así que prueba primero con una. Los documentos largos son donde el Nivel 1 (1M de TPM) se paga por sí mismo.
Otras formas de usar Gemini Decision 1 a $0
| Ruta | Costo | ¿Se necesita tarjeta o facturación? | Para qué es útil |
|---|---|---|---|
| Nivel gratuito de la API de Gemini (clave de AI Studio) | $0, 200 RPM / 50.000 TPM / 10.000 RPD | No | Prototipos, herramientas internas, lotes nocturnos de menos de 10.000 solicitudes |
| Decisions Playground en AI Studio | $0 (nivel sin costo, según la publicación de lanzamiento de Google) | No | Probar la redacción de las preguntas antes de escribir código |
OpenRouter (google/gemini-decision-1) |
$0.10 por 1M de entrada, $0 de salida | Sí, créditos | Una sola clave para varios proveedores; no es gratis |
La página del modelo de OpenRouter, consultada el 12 de noviembre de 2026, muestra un solo proveedor (Google AI Studio) a $0.10 por 1M de tokens de entrada, salida gratuita y sin variante :free. Funciona en el endpoint de Decisions de OpenRouter, así que los SDK de chat completions no pueden llamarlo.
Cómo mantenerte dentro del nivel gratuito
Estos hábitos mantienen un prototipo en $0 el mayor tiempo posible:
- Haz todas las preguntas en una sola solicitud. La entrada compartida se factura una vez, y hasta 1000 preguntas caben en una llamada.
- Reduce la resolución de los medios.
lowcuesta un cuarto de lo que cuestahighpor imagen. - Envía solo los campos que necesitan las preguntas. Google indica que el contenido no relacionado reduce la precisión, y además consume TPM.
- Limita la velocidad por TPM, no por RPM. Regula los trabajadores a 50.000 dividido entre tus tokens medidos por solicitud.
- Almacena en caché las respuestas por tu cuenta. La API no tiene almacenamiento en caché de contexto y cuenta la entrada repetida en su totalidad, así que calcula un hash de entrada más preguntas y omite las repeticiones.
- Inicia las ejecuciones grandes después de la medianoche, hora del Pacífico, para tener un día completo de cuota.
- Mantén las pruebas y la CI fuera de la API real. Una suite que la llame en cada push puede gastar 10.000 solicitudes antes del mediodía. Usa un mock en su lugar.
Deja que tu agente de programación haga un mock de la API de Decisions con Apidog CLI
Las pruebas unitarias no necesitan un modelo en vivo. Necesitan la forma correcta: un mapa de answers, noul entre 0.01 y 0.99, un confidence, y usage.total_output_tokens: 0. Tu agente de programación puede construir ese mock con Apidog CLI, de modo que solo una prueba de humo toque Google.
Configura una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Luego dale a Claude Code, Codex o Cursor un solo prompt:
In Apidog project <id>, add the Gemini Decisions endpoint POST /v1beta/decisions
with a request body of model, input and questions. Create mock expectations that
return a damaged answer (noul 0.97) and an undamaged one (noul 0.04), each with
usage.total_output_tokens = 0. Add a test case that asserts the answers map,
confidence between 0 and 1 and zero output tokens. Run it against the mock
environment, then once against the real API with my free-tier key.
El agente lee cada esquema de payload, lo valida, y solo entonces escribe:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <id> --file decisions-endpoint.json

apidog cli-schema get mock-create
apidog cli-schema validate mock-create --file mock-damaged.json
apidog mock create --project <id> --file mock-damaged.json

apidog cli-schema get test-case-create
apidog test-case create --project <id> --file decisions-case.json
apidog run --test-case <caseId> --project <id> -e <mockEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <freeTierEnvId> -r cli
En CI, ejecuta solo el entorno de mock con -r junit (archivo de pipeline en nuestra guía de CI/CD de Apidog CLI); la configuración del agente está en Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios, así que un equipo pequeño comparte los mocks sin costo. ¿También estás evaluando la versión de OpenAI? Consulta nuestro explicador de la API de OpenAI Decisions.
Preguntas frecuentes
¿Es gratuita la API de Gemini Decisions? Sí, dentro de ciertos límites. El nivel gratuito no cobra nada por la entrada y la salida siempre es de 0 tokens. Obtienes 200 solicitudes por minuto, 50.000 tokens por minuto y 10.000 solicitudes por día por proyecto. Más allá de eso, configura la facturación y paga $0.10 por 1M de tokens de entrada.
¿Necesito una tarjeta de crédito para el nivel gratuito de la API de Gemini Decisions? No. Una clave de API de Google AI Studio empieza en el nivel gratuito. La página de límites de tarifa de Google indica que solo pasas a un nivel de pago después de configurar la facturación en AI Studio.
¿Google entrena con mis datos de la API de Decisions del nivel gratuito? La página de precios de Google marca «Used to improve our products» como Sí para el nivel gratuito y No para el de pago. Trata las claves del nivel gratuito como inadecuadas para datos sensibles.
¿Por qué recibo errores 429 muy por debajo de las 200 solicitudes por minuto? Probablemente estás superando los 50.000 tokens por minuto. Las entradas de imagen, audio y PDF consumen muchos tokens, así que el TPM suele ser el límite que se alcanza antes que el RPM. Registra usage.total_input_tokens y regula las solicitudes a 50.000 dividido entre ese número.
¿Hay un modelo gratuito de Gemini Decision 1 en OpenRouter? No a fecha del 12 de noviembre de 2026. OpenRouter lista google/gemini-decision-1 a $0.10 por 1M de tokens de entrada y $0 de salida, sin variante :free.
¿Puedo usar la Batch API o el almacenamiento en caché de contexto para estirar el nivel gratuito? No. La página del modelo indica que la Batch API y el almacenamiento en caché no son compatibles en ningún nivel. Agrupa las preguntas en una sola solicitud y almacena en caché las respuestas en tu propio código.