Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2, en una línea: Fable 5.2 obtiene la puntuación más alta, Neon cuesta menos por token y Astra completa una tarea de benchmark independiente por el menor costo. Neon tiene un precio de $3 / $15 por 1M de tokens de entrada/salida, mientras que Astra y Fable tienen un precio de $8 / $40. Los tres ofrecen alrededor de 1M de tokens de contexto.
Tres modelos de frontera se lanzaron en diez días: Claude Fable 5.2 el 9 de noviembre de 2026, GPT-6.2 Astra el 17 de noviembre y Gemini 4 Neon el 18 de noviembre. A continuación: precio, especificaciones, puntuaciones independientes, costo por tarea y una forma de probar los tres con Apidog CLI.
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2: el veredicto rápido
Elige según tu carga de trabajo, no por el puesto en la clasificación:
- Gemini 4 Neon para programación y análisis complejos que ejecutas todo el día. Es un 62.5% más barato por token que los otros dos y ocupa el segundo puesto en el índice Vals.
- GPT-6.2 Astra si tu stack vive en la API de Responses de OpenAI. Escribe muchos menos tokens por tarea, lo que lo convierte en el más barato de los tres por tarea de Artificial Analysis a pesar de su precio de $8 / $40.
- Claude Fable 5.2 para el trabajo de horizonte largo más difícil, donde una ejecución fallida cuesta más que los tokens. Lidera ambos índices independientes, con el costo más alto por tarea.
Si vienes del precedente de octubre, nuestra comparación de Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 cubre la generación anterior.
¿Cómo se comparan los tres modelos en precio y especificaciones?
Neon es la excepción en precio. Las cifras provienen del anuncio de lanzamiento de Gemini 4 Neon y la página de precios de Google, la página del modelo GPT-6.2 Astra y la descripción general de Claude Fable 5.2 de Anthropic.
| Especificación | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| ID de modelo de API | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Lanzamiento | 18 nov 2026 | 17 nov 2026 | 9 nov 2026 |
| Entrada / salida por 1M | $3 / $15 | $8 / $40 | $8 / $40 |
| Entrada en caché por 1M | $0.15 (solo implícito) | $0.40 | $0.20 |
| Ventana de contexto | 1,048,576 (compartida con la salida) | 1,050,000 (922,000 de entrada máxima) | 1M |
| Salida máxima por solicitud | 65,536 | 128,000 | 128K |
| Prompts largos | Tarifa plana en todo 1M | Más de 272K de entrada: entrada 2x, salida 1.5x | Tarifa plana en todo 1M |
| Descuento por lotes | 50% (Batch y Flex) | 50% | 50% |
| Control de razonamiento | thinking_level: de low a xhigh, predeterminado high |
reasoning.effort, none rechazado |
effort, predeterminado high |
| Nivel gratuito de API | No | No | No |
Dos detalles cambian las facturas reales. El almacenamiento en caché de Neon es implícito: solo obtienes la tarifa de $0.15 cuando Google coincide con un prefijo de prompt repetido. Y Neon devuelve como máximo 65,536 tokens por solicitud, por lo que las salidas muy largas necesitan la decodificación larga de Google o un bucle de continuación.
Para ver las tarifas completas, consulta nuestros desgloses de precios de Gemini 4 Neon, precios de GPT-6.2 Astra y precios de Claude Fable 5.2.
¿Qué modelo gana en benchmarks independientes?
Las tablas de benchmarks de los proveedores rara vez comparten pruebas. Dos clasificaciones independientes posicionan los tres en una misma suite, y no coinciden en el segundo puesto.
| Métrica | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Índice de inteligencia de Artificial Analysis | 61 (xhigh) | 62 (max) | 65 (max) |
| Índice Vals | 70.87%, n.º 2 | 67.66%, n.º 8 | 71.31%, n.º 1 |
| Costo de AA por tarea del índice | $6.44 | $4.00 | $26.54 |
| Tiempo de AA por tarea del índice | 21.5 min | 13.9 min | 41.8 min |
| Velocidad de salida de AA | 110 tok/s | 49 tok/s | 109 tok/s |
| Tokens de salida en todo el índice de AA | 283M | 65.8M | 275M |
Fuentes: las páginas de modelo de Artificial Analysis para cada modelo, consultadas el 19 de noviembre de 2026, y el Vals Index con fecha del 18 de noviembre de 2026.
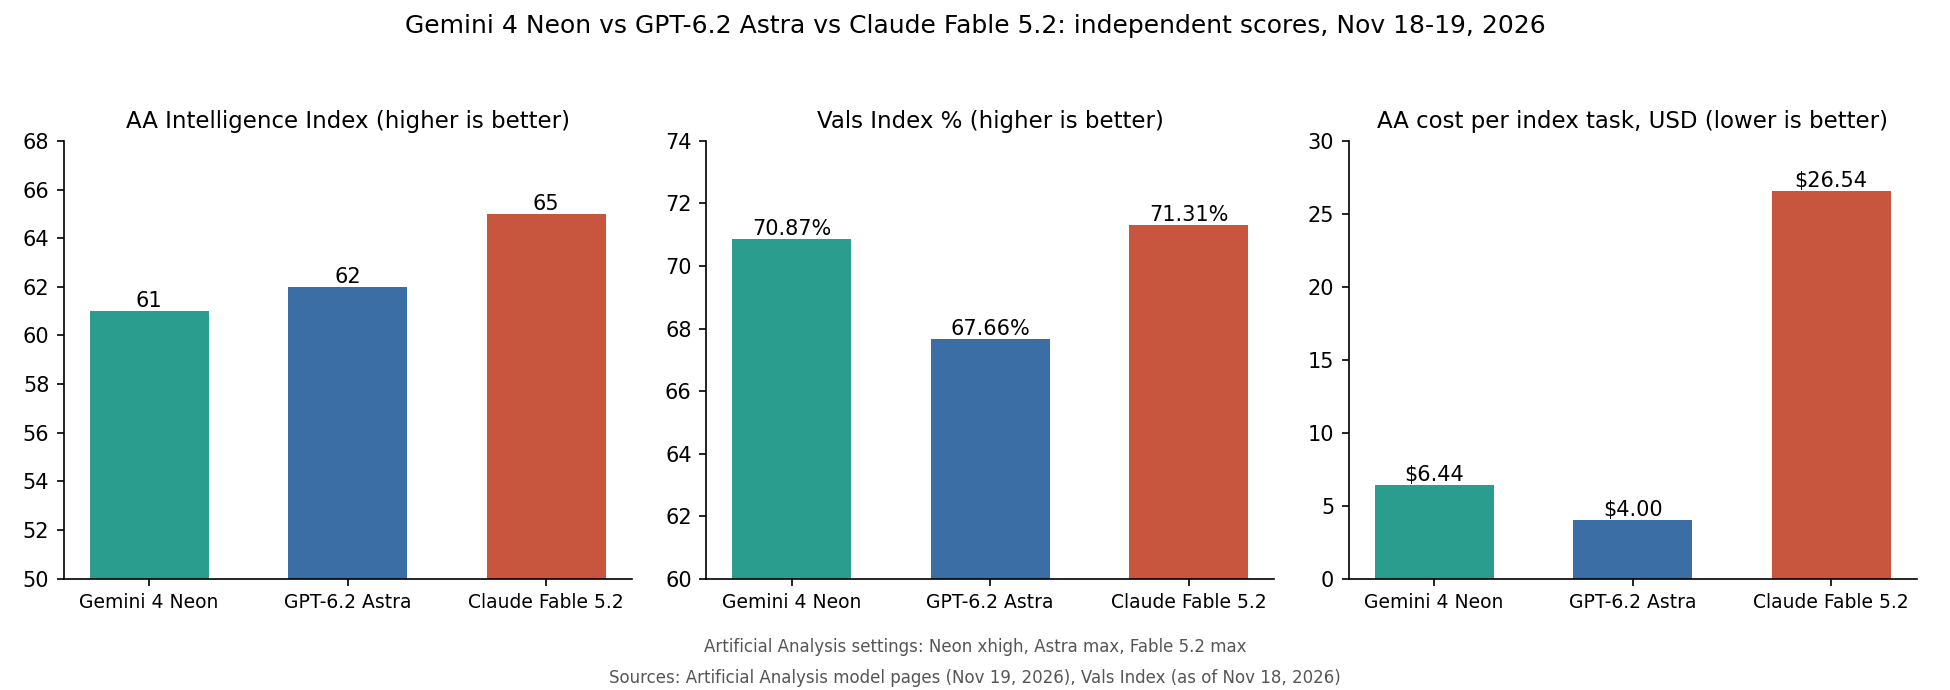
Fable 5.2 lidera ambas clasificaciones, y en Vals Neon se queda solo 0.44 puntos por detrás. Artificial Analysis sitúa a Astra un punto por delante de Neon; Vals sitúa a Neon más de 3 puntos por delante de Astra.
El anuncio de lanzamiento de Google clasificó a Neon en el n.º 3 de Artificial Analysis; el 19 de noviembre, la misma página lo sitúa en el n.º 6 de 96. Las posiciones del día de lanzamiento cambian rápido, y una diferencia de un punto es ruido. Las filas de costo y velocidad dicen más sobre cómo se comportará cada modelo en tu agente.
¿Por qué el más caro por token cuesta menos por tarea?
La mitad de la factura es el precio por token; la otra mitad es cuántos tokens escribe un modelo antes de responder. En la suite de Artificial Analysis, Astra generó 65.8M de tokens de salida. Neon generó 283M y Fable 275M, más de cuatro veces más. La tarifa de salida de $40 de Astra se aplicó a un volumen mucho menor, así que su costo por tarea quedó en $4.00, por debajo de los $6.44 de Neon, aunque la tarifa de salida de Neon es un 62.5% más baja.
La configuración importa. Artificial Analysis ejecutó Neon en xhigh; en high obtiene 60 con 123M de tokens de salida en lugar de 283M, un punto por menos de la mitad de los tokens. Nuestra guía de niveles de pensamiento de Gemini 4 Neon muestra la curva completa.
Los $26.54 de Fable combinan una tarifa de salida alta con una gran verbosidad: el precio de la puntuación más alta.
¿Cuánto cuesta una carga de trabajo real de agente en cada modelo?
Dos cargas de trabajo con tarifas de lista, suponiendo recuentos de tokens idénticos en cada modelo (no lo serán, así que léelo como una comparación de precios, no como una previsión).
| Carga de trabajo | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Sesión de agente: 150K de entrada nueva, 1.35M de lecturas de caché, 150K de salida | $0.45 + $0.20 + $2.25 = $2.90 | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| Una solicitud larga: 400K de entrada, 8K de salida, sin caché | $1.20 + $0.12 = $1.32 | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
Astra y Fable cobran los primeros 150K como una escritura de caché de $10 por 1M; Neon no tiene tarifa de escritura. La solicitud larga muestra la regla de 272K de Astra: pasado ese límite, OpenAI cobra $16 de entrada y $60 de salida por 1M por toda la solicitud.
Si Neon escribe 3x más tokens que Astra con tus prompts, su sesión de $2.90 puede costar más que la de Astra. Mide los tokens de salida antes de elegir por precio.
¿Qué diferencias de API romperán tu harness de agente?
Cada API rechaza ajustes que las otras aceptan:
- Gemini 4 Neon: el antiguo parámetro
thinking_budgetdevuelve HTTP 400, al igual quefrequency_penaltyypresence_penalty. Los valores personalizados detemperature,top_kytop_pse ignoran, según la guía para desarrolladores de Google Cloud. - GPT-6.2 Astra:
reasoning.effortestablecido ennonedevuelve un 400, y la página del modelo indica que Realtime, Assistants y el fine-tuning no son compatibles. - Claude Fable 5.2: el uso forzado de herramientas (
tool_choiceconanyotool) y parámetros de muestreo comotemperaturedevuelven un 400, y el pensamiento no se puede desactivar.
Nuestra guía de GPT-6.2 Astra vs Claude Fable 5.2 cubre en detalle las particularidades de Astra y Fable, y la guía de la API de Gemini 4 Neon cubre el formato de solicitud de Neon.
¿Dónde encaja mejor cada modelo?
Gemini 4 Neon está diseñado para trabajo frecuente y complejo. Google dice que reduce las lecturas redundantes de archivos y puede planificar mientras subagentes más baratos de Gemini 4 Hydrogen ejecutan los pasos; en Google Antigravity, /swarm ejecuta agentes en paralelo.
GPT-6.2 Astra trae la caja de herramientas de OpenAI: apply_patch, shell alojado, computer use, MCP y una beta multiagente en la API de Responses. Es el más rápido de los tres en Artificial Analysis, con 13.9 minutos por tarea. Simon Willison señaló el día del lanzamiento que obtiene una puntuación un poco inferior a Fable 5.2 en varios benchmarks.
Claude Fable 5.2 es la elección cuando la calidad pesa más que el costo: sesiones largas de agente, refactorizaciones difíciles, tareas de investigación. Sus lecturas de caché de $0.20 y el precio plano de 1M suavizan la tarifa de salida de $40.
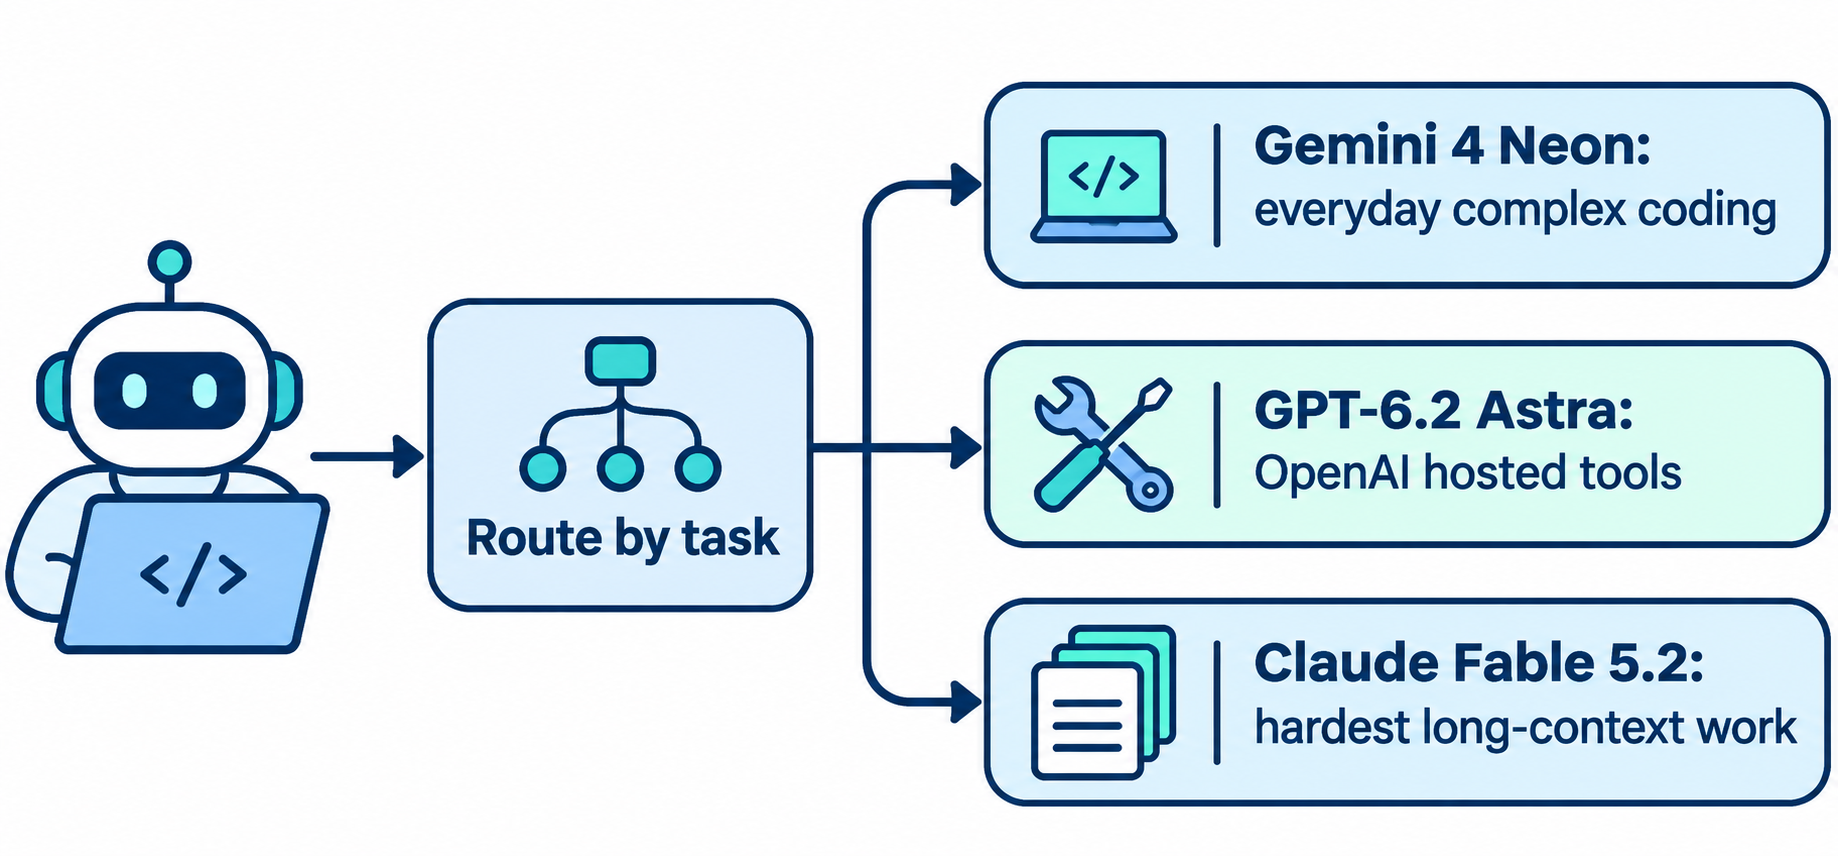
No tienes que elegir uno solo. Envía la mayor parte de los pasos del agente a Neon y las pocas tareas que fallen allí a Fable o Astra; tu costo promedio se mantiene cerca del de Neon.
¿Cómo pruebas los tres modelos con tu propia carga de trabajo?
Las clasificaciones miden las tareas de otra persona. Envía de 5 a 10 prompts reales del historial de tu agente a las tres API y compara la tasa de éxito, los tokens y la latencia. Ejecutar esas solicitudes a mano se vuelve tedioso rápido, así que deja que Claude Code, Codex o Cursor controlen Apidog CLI. La configuración requiere tres comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale un prompt a tu agente:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
El agente comprueba el esquema de cada payload, escribe los casos y los ejecuta. Estos flags provienen de apidog run --help en la CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Repite el último comando con los ID de caso de Astra y Fable. -n 5 ejecuta cada caso cinco veces, y --upload-report muestra las ejecuciones en la aplicación Apidog. Esta es una plantilla de flujo de trabajo; no la hemos ejecutado contra las tres API desde esta máquina.
Añade casos negativos para los 400 anteriores, para que un cambio en las reglas de un proveedor aparezca primero en tu suite. La guía de Apidog CLI en Claude Code cubre la configuración del agente, y el plan Free de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Es Gemini 4 Neon mejor que GPT-6.2 Astra? Depende de la clasificación: Neon lidera en el índice Vals (70.87% vs 67.66%), Astra lidera por un punto en el índice de inteligencia de Artificial Analysis (62 vs 61). Neon cuesta $3 / $15 por 1M de tokens frente a los $8 / $40 de Astra.
¿Cuál de los tres es más barato? Por token, Gemini 4 Neon a $3 de entrada y $15 de salida por 1M. Por tarea de Artificial Analysis, GPT-6.2 Astra a $4.00, porque escribe muchos menos tokens que Neon ($6.44) o Fable 5.2 ($26.54).
¿Qué modelo obtiene la puntuación más alta? Claude Fable 5.2 lidera tanto el índice de inteligencia de Artificial Analysis (65) como el índice Vals (71.31%) según datos del 18 y 19 de noviembre de 2026.
¿Alguno tiene un nivel gratuito de API? No. Google no indica ningún nivel gratuito para Neon, y Astra y Fable 5.2 son modelos de API de pago. Los suscriptores de Google AI Pro y Ultra pueden usar Neon en la app Gemini y en Antigravity. Consulta nuestra guía de Gemini 4 Neon gratis para las opciones de $0.
¿Puedo usar más de uno en el mismo agente? Sí. Dirige los pasos rutinarios a Neon y las tareas en las que falle a Fable 5.2 o Astra. Prueba cada ruta primero: los recuentos de tokens por tarea difieren en más de 4x entre modelos.