
Gemini 4 Neon vs Carbon es ahora una elección real para cualquier equipo que use la API de Gemini. Google añadió Neon en noviembre de 2026 como un modelo intermedio situado entre Hydrogen y Carbon, y los tres comparten un mismo esquema de petición, una ventana de contexto de 1M de tokens y las mismas herramientas integradas. Lo que los diferencia es la profundidad con la que razonan, la rapidez con la que terminan y lo que cuesta cada token.
Respuesta rápida: usa Gemini 4 Hydrogen ($1,50 de entrada / $7,50 de salida por cada 1M de tokens, con nivel gratuito disponible) como opción predeterminada para el trabajo diario de programación y para agentes. Pasa una tarea a Gemini 4 Neon ($3 / $15, solo nivel de pago) cuando sea compleja y se ejecute con frecuencia, como refactorizaciones multarchivo o análisis de documentos densos. Reserva Gemini 4 Carbon ($2 / $10 hasta el 30 de noviembre de 2026, luego $4 / $20) para tus problemas más difíciles de arquitectura, depuración y seguridad.
Gemini 4 Neon vs Carbon vs Hydrogen de un vistazo
Gemini 4 Neon es el modelo Gemini 4 intermedio de Google, diseñado para tareas complejas de ingeniería de software, trabajo del conocimiento y ciencia que se ejecutan con alta frecuencia. Razona más a fondo que Hydrogen, termina más rápido y con menos tokens de salida que Carbon, y cuesta $3 por cada 1M de tokens de entrada y $15 por cada 1M de tokens de salida, solo en el nivel de pago.
Aquí tienes la comparación lado a lado, tomada de la guía Choosing a model y de la página de precios de la API de Gemini, ambas consultadas el 19 de noviembre de 2026:
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| ID del modelo | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| Posicionamiento | Predeterminado rápido | Trabajo complejo y de alta frecuencia | Razonamiento más potente |
| Velocidad (etiqueta de Google) | Rápido | Moderado | Deliberado |
| Entrada / salida por 1M | $1,50 / $7,50 | $3,00 / $15,00 | $2,00 / $10,00 hasta el 30 de nov., luego $4,00 / $20,00 |
| Entrada en caché por 1M | $0,075 | $0,15 | $0,10, luego $0,20 |
| Niveles de pensamiento | low, medium, high (predeterminado), xhigh | low, medium, high (predeterminado), xhigh | low, medium (predeterminado), high |
| Nivel gratuito de la API | Sí | No | No |
| Ventana de contexto | 1.048.576 tokens, unificada | 1.048.576 tokens, unificada | 1.048.576 tokens, unificada |
Los tres aceptan texto, imágenes, vídeo, audio y PDF como entrada, y admiten llamadas a funciones, salidas estructuradas, ejecución de código, uso de ordenador y grounding con Google Search. Cada uno tiene un límite de salida síncrona de 65.536 tokens y puede superarlo hasta 1M de tokens con long decode.
¿Qué modelo de Gemini 4 deberías usar?
La propia guía de Google es breve y merece la pena seguirla como punto de partida:
- Empieza con Hydrogen para la mayoría de los proyectos nuevos: programación cotidiana, apps interactivas, agentes que usan herramientas y pipelines de documentos multimodales. Google afirma que reduce las afirmaciones inventadas más de 5 veces en comparación con Gemini 3.8 Flash.
- Sube a Neon cuando Hydrogen no baste y no necesites la verificación adicional de Carbon: depuración a nivel de repositorio, refactorizaciones multarchivo y análisis legal, financiero o científico que se ejecutan muchas veces al día.
- Reserva Carbon para arquitectura de sistemas, depuración multarchivo, pruebas formales, auditorías de seguridad o cualquier tarea en la que un modelo más rápido se atasque.
- Baja a Gemini 3.5 Flash-Lite ($0,30 / $2,50) para trabajo de texto de gran volumen como traducción, extracción y resumen.
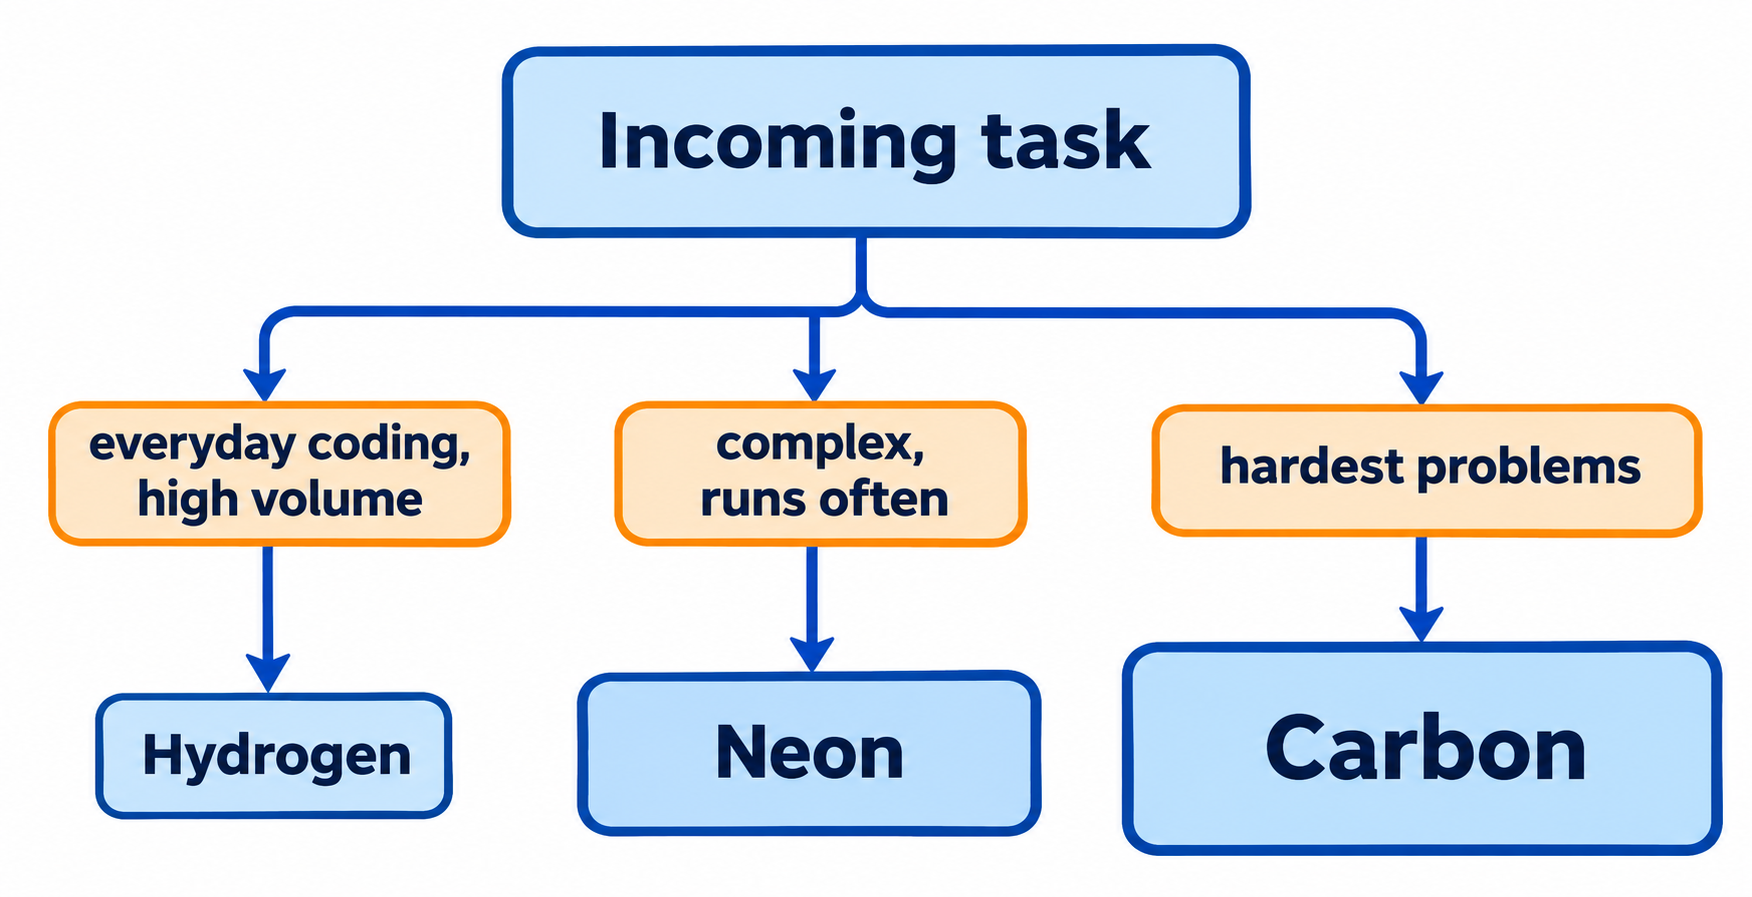
La palabra clave para Neon es «a menudo». Una auditoría de seguridad trimestral puede permitirse el razonamiento más lento de Carbon. Un agente de refactorización que procesa 200 pull requests a la semana necesita algo que termine rápido y acierte igualmente en las partes difíciles.
Gemini 4 Neon vs Carbon: precio y profundidad de razonamiento
Esta es la comparación que más importa a la mayoría de los equipos, porque tanto Neon como Carbon apuntan al trabajo difícil.
Estilo de razonamiento. Carbon gasta más tokens de pensamiento por turno para probar hipótesis, aislar causas raíz en los repositorios y verificar las correcciones contra las pruebas. Neon busca calidad de frontera con un uso de tokens más ajustado. Según la página What’s new in Gemini 4 Neon de Google, completa la depuración a nivel de repositorio en menos pasos, reduce lecturas redundantes de archivos en sesiones largas de llamadas a herramientas y gestiona la compactación de contexto de forma fiable.
Los valores predeterminados difieren. Carbon usa por defecto el pensamiento medium y llega como máximo a high. Neon usa por defecto high y añade xhigh para los problemas multi-paso más difíciles. Si sustituyes Carbon por Neon sin fijar thinking_level, también cambias la intensidad con la que razona el modelo.
El precio cambia el 1 de diciembre. Hasta el 30 de noviembre de 2026, la tarifa de lanzamiento de Carbon ($2 / $10) es en realidad más barata por token que la de Neon ($3 / $15). A partir del 1 de diciembre, Carbon se duplica a $4 / $20 y Neon pasa a ser un 25% más barato por token. Neon no tiene precio de lanzamiento, así que su tarifa no se mueve.
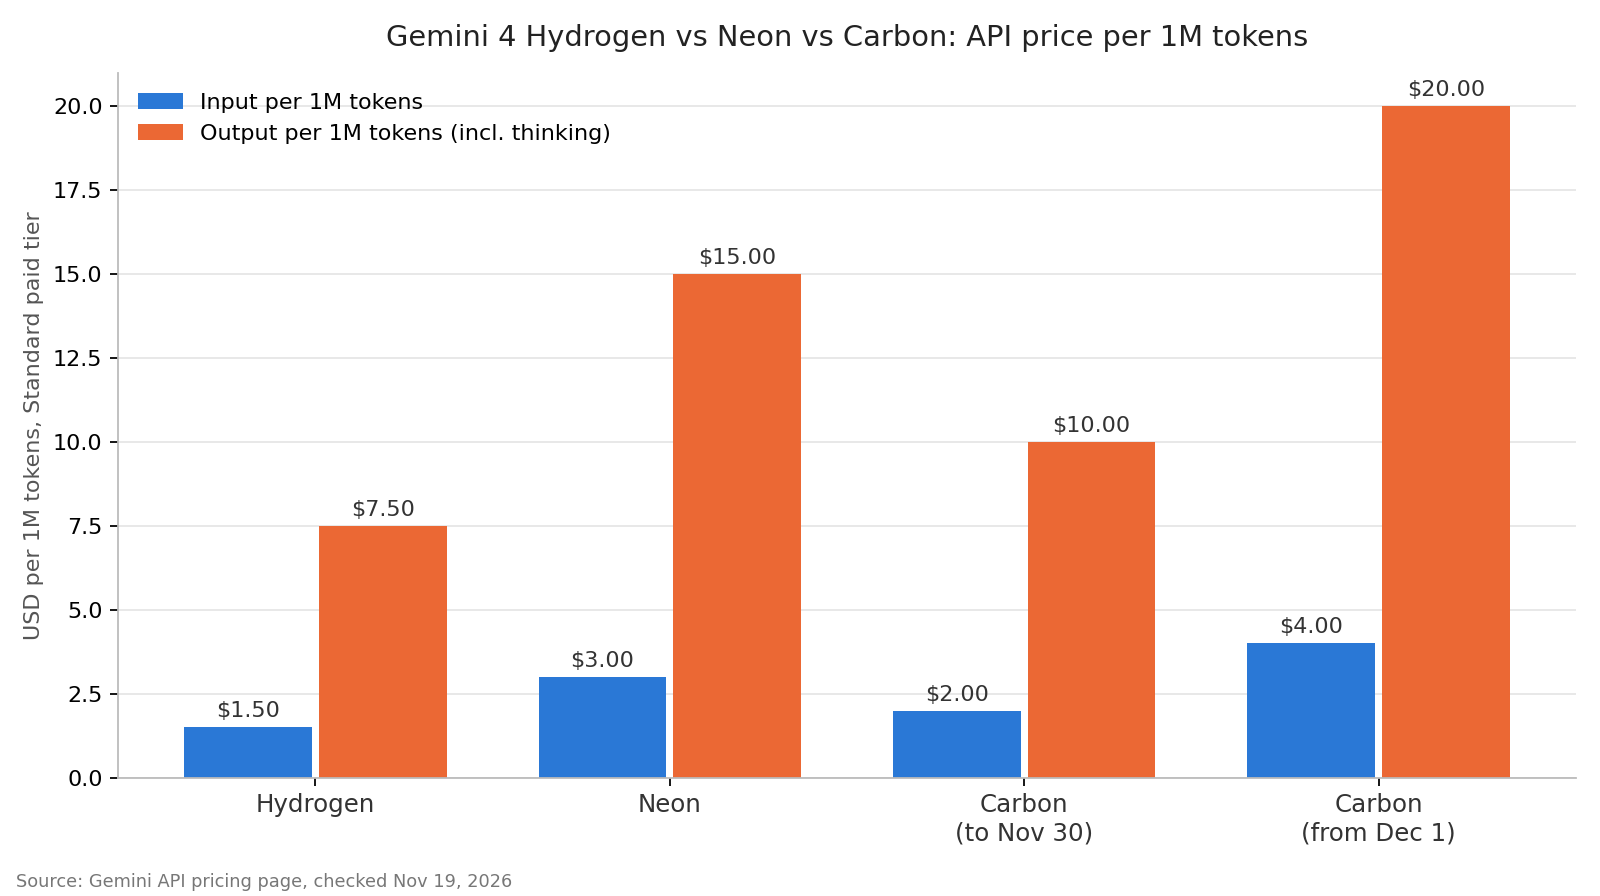
Eso sí, el precio por token es solo la mitad de la factura: el precio de salida incluye los tokens de pensamiento, y Carbon está diseñado para pensar más.
Gemini 4 Neon vs Hydrogen: cuándo compensa la mejora
Hydrogen y Neon parecen iguales sobre el papel: mismos niveles de pensamiento, mismo valor predeterminado, misma ventana de contexto, mismas herramientas. Neon cuesta exactamente el doble por token.
La mejora compensa cuando la respuesta de Hydrogen obliga a reintentar. Si Hydrogen necesita tres intentos para lograr una refactorización multarchivo que Neon consigue en uno, el modelo más barato es el que resulta caro.
Dos diferencias prácticas:
- Nivel gratuito. Hydrogen tiene un nivel gratuito de la API para prototipos. Neon no, así que necesitas un proyecto de nivel de pago antes de tu primera llamada. En ese nivel gratuito, Google puede usar tus datos para mejorar sus productos.
- Precio por lotes. Ambos reducen su precio a la mitad en modo Batch: Hydrogen baja a $0,75 / $3,75 y Neon a $1,50 / $7,50. Un trabajo por lotes nocturno con Neon cuesta lo mismo por token que una llamada en tiempo real con Hydrogen.
Si ya usas Hydrogen como trabajador rápido bajo Carbon como planificador, consulta nuestro análisis del patrón orquestador de Gemini 4 Hydrogen. Neon añade a ese montaje una tercera vía para los pasos de dificultad media.
Coste por tarea: un ejemplo resuelto
Esta es una tarea de agente con 40.000 tokens de entrada y 8.000 tokens de salida (pensamiento incluido), con precios de nivel de pago estándar:
| Modelo | Coste de entrada | Coste de salida | Por tarea | Por cada 1.000 tareas |
|---|---|---|---|---|
| Hydrogen | $0,060 | $0,060 | $0,12 | $120 |
| Neon | $0,120 | $0,120 | $0,24 | $240 |
| Carbon (hasta el 30 de nov.) | $0,080 | $0,080 | $0,16 | $160 |
| Carbon (desde el 1 de dic.) | $0,160 | $0,160 | $0,32 | $320 |
Esta tabla asume que cada modelo usa la misma cantidad de tokens, lo cual no será así. Google indica que Carbon gasta más tokens de pensamiento por turno y que Neon termina con menos tokens de salida que Carbon. Si Carbon necesita 12.000 tokens de salida para esa misma tarea, su coste en diciembre sube a $0,40 por tarea, y la brecha con Neon pasa de $0,08 a $0,16. Estos recuentos de tokens son ilustrativos; mide los tuyos antes de elaborar un presupuesto.
Tres palancas reducen la factura:
- Almacenamiento en caché implícito. Se activa por defecto en prompts de al menos 4.096 tokens y descuenta un 95% de la entrada en caché. Pon primero los prompts de sistema y las definiciones de herramientas estables para que entren en la caché.
- Nivel de pensamiento. Google recomienda ejecutar tus evaluaciones en los cuatro niveles y elegir el más bajo que cumpla tu umbral de calidad.
xhighes el que más tokens y latencia cuesta. - Modo Batch. El trabajo no urgente pertenece al modo Batch, a la mitad del precio estándar.
Para ver la cronología completa de precios de Carbon, lee nuestra guía de precios de Gemini 4 Carbon.
Cambiar entre los tres: qué cambia en tu código
Alternar entre los modelos de Gemini 4 no requiere cambios en el esquema de la petición. Cambias la cadena model y, normalmente, el thinking_level:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
Cuando migres una carga de trabajo:
- Fija
thinking_levelexplícitamente. El predeterminado de Carbon esmedium; el de Neon y Hydrogen eshigh. Un cambio sin fijar ese valor altera el coste y la latencia. - Usa un proyecto de nivel de pago para Neon y Carbon. Las claves del nivel gratuito solo llegan a Hydrogen y Flash-Lite.
- Elimina los parámetros de muestreo. La guía de migración de Neon indica que
temperature,top_pytop_kse ignoran si están dentro del rango y devuelven un400si están fuera de él. - Encadena modelos con
previous_interaction_id. Como los tres comparten un esquema, puedes planificar con Carbon, implementar con Hydrogen y enviar los pasos intermedios más delicados a Neon en una sola conversación.
Deja que tu agente de programación los compare con Apidog CLI
La forma más rápida de resolver Neon vs Carbon vs Hydrogen es enviar el mismo prompt a los tres y comparar estado, latencia y uso de tokens. Tu agente de programación puede crear y ejecutar esa prueba con Apidog CLI mientras tú sigues trabajando.
Instala la CLI y dota a tu agente de la skill de Apidog:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a Claude Code, Codex o Cursor un único prompt:
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
El agente lee el esquema del payload, valida su archivo, crea el escenario y lo ejecuta tres veces, cambiando solo el modelo:
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
Guarda GEMINI_API_KEY en el entorno de Apidog. Añade --upload-report para ver cada ejecución en la app, y pon el mismo comando en CI con -r junit para detectar regresiones cuando Google actualice un modelo. Nuestra guía sobre Apidog CLI en Claude Code cubre la configuración de principio a fin. El plan gratuito de Apidog cubre equipos de hasta 4 usuarios.
FAQ
¿Es Gemini 4 Neon mejor que Gemini 4 Carbon? No en todos los casos. Carbon es el modelo de razonamiento más potente de Google. Neon sacrifica algo de profundidad a cambio de completar más rápido y con menos tokens de salida, lo que encaja con trabajo complejo que se ejecuta con frecuencia.
¿Es gratuito Gemini 4 Neon? No. Neon está solo en el nivel de pago de la API de Gemini, y en Google AI Studio con los planes Google AI Pro y Ultra. Hydrogen es el modelo de Gemini 4 con nivel gratuito de API.
¿Es Neon más barato que Carbon? Por token, solo desde el 1 de diciembre de 2026. Hasta el 30 de noviembre, la tarifa de lanzamiento de Carbon de $2 / $10 se sitúa por debajo de los $3 / $15 de Neon. Después, Carbon cuesta $4 / $20 y Neon es un 25% más barato por token, sin contar el mayor consumo de pensamiento de Carbon.
¿Tienen Gemini 4 Neon, Carbon y Hydrogen la misma ventana de contexto? Sí. Los tres comparten una ventana unificada de 1.048.576 tokens para entrada, pensamiento y salida, con un límite de salida síncrona de 65.536 tokens y long decode de hasta 1M de tokens.
¿Puedo usar Neon, Carbon y Hydrogen en el mismo flujo de trabajo? Sí. Comparten un esquema de petición, así que puedes pasar previous_interaction_id del turno de un modelo al de otro. Planifica con Carbon, implementa con Hydrogen y da a Neon los pasos intermedios.
¿Cuál es el modelo de Gemini 4 más rápido? Hydrogen. Google etiqueta a Hydrogen como rápido, a Neon como moderado y a Carbon como deliberado.