
Los niveles de razonamiento de Gemini 4 Neon te ofrecen cuatro ajustes para decidir cuánto razona el modelo antes de responder: low, medium, high y xhigh. Neon usa high por defecto. Google recomienda mantener high para la mayoría del trabajo complejo y pasar a xhigh solo cuando high no dé la talla en problemas difíciles de varios pasos, porque xhigh consume más tokens y tarda más.
¿Qué son los niveles de razonamiento de Gemini 4 Neon?
Los niveles de razonamiento son valores del parámetro thinking_level que determinan cuánto razonamiento interno lleva a cabo gemini-4-neon antes de redactar una respuesta. Neon admite cuatro: low, medium, high (el predeterminado) y xhigh. Los niveles más altos consumen más tokens de pensamiento y añaden latencia; los más bajos responden más rápido y cuestan menos.
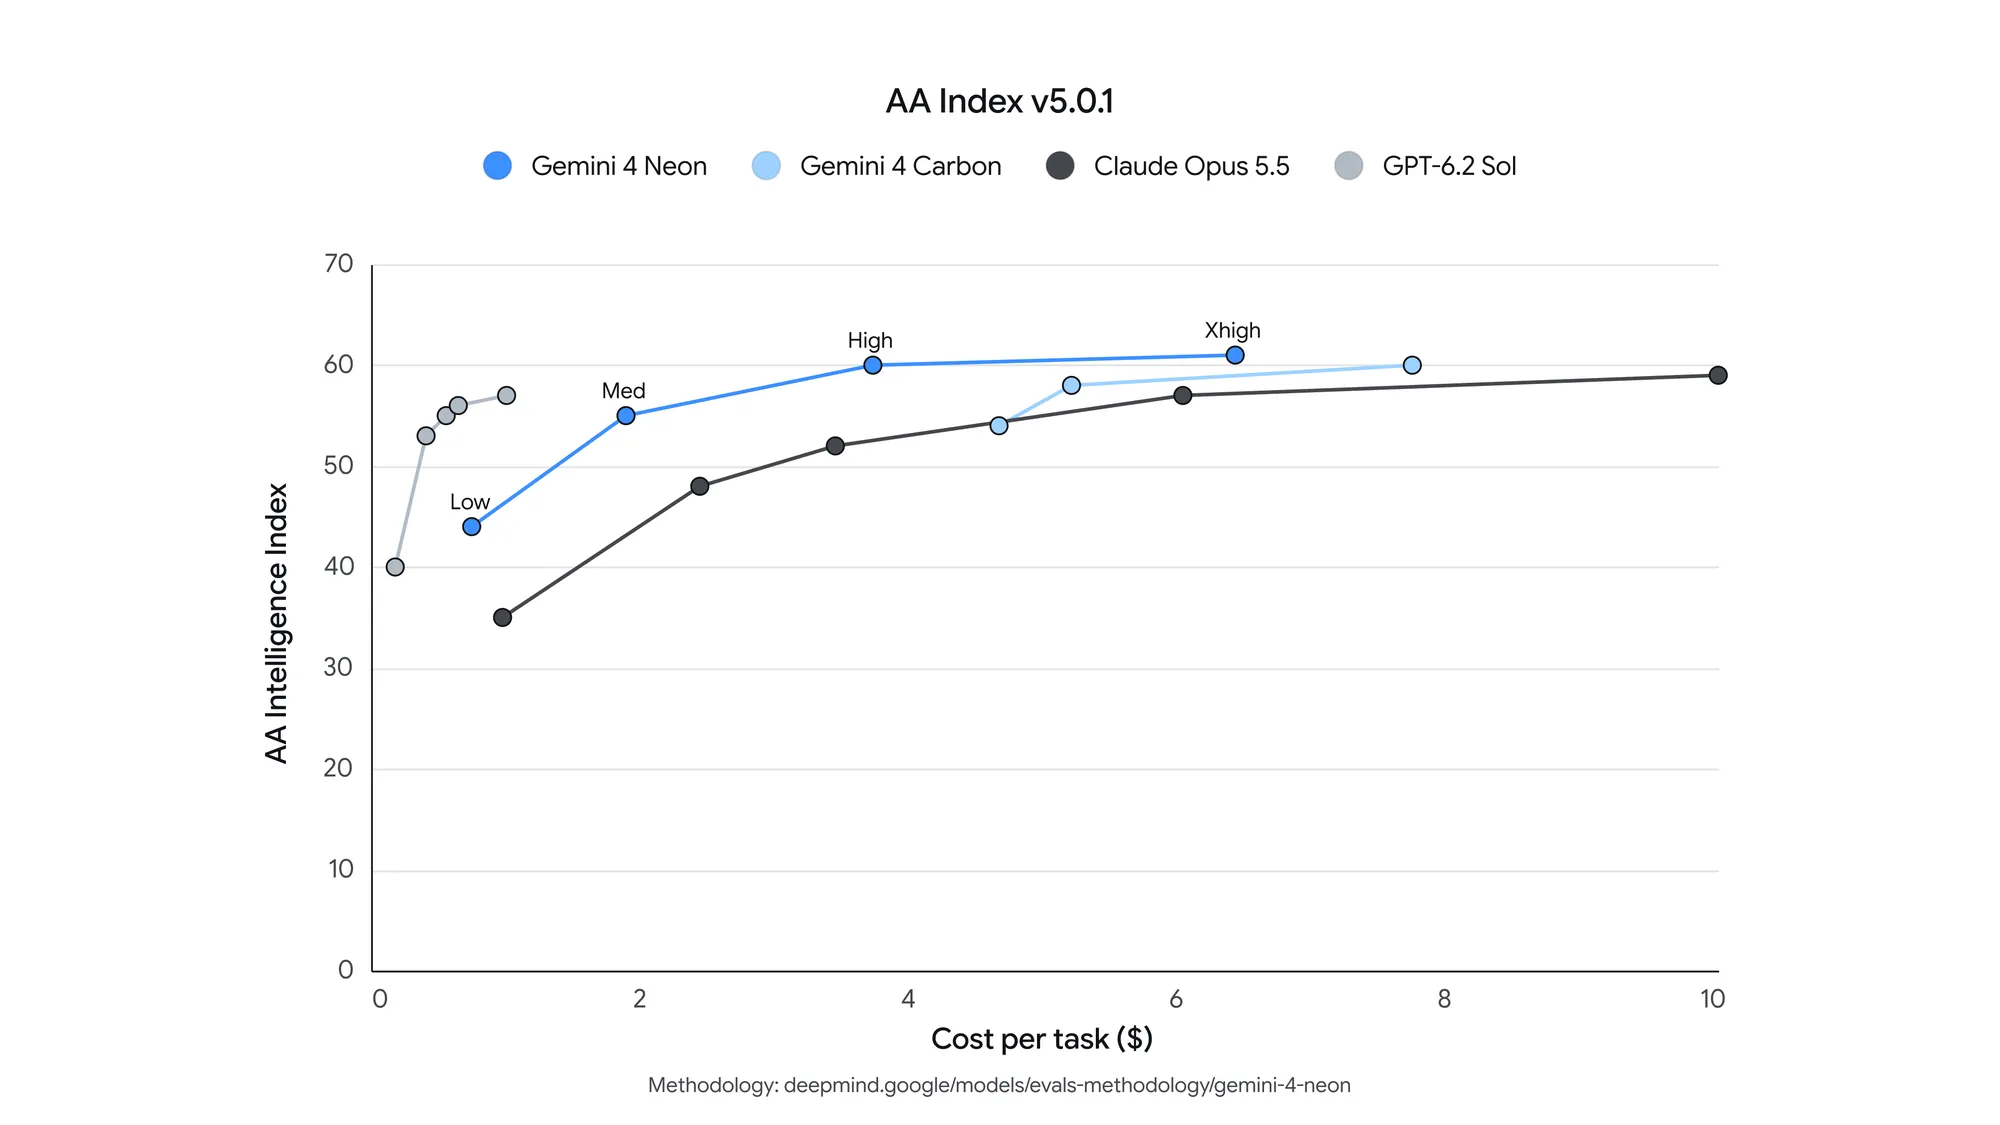
Así describe cada nivel para Neon la guía de razonamiento de Google:
thinking_level |
Uso de tokens | Uso sugerido por Google |
|---|---|---|
low |
Menos tokens, menor latencia | Chat rápido, procesamiento de alto rendimiento; sigue siendo capaz en tareas agénticas |
medium |
Menor uso de tokens, respuestas más rápidas | Programación interactiva, prototipado de UI en vivo, llamadas a herramientas sensibles a la latencia |
high (predeterminado) |
Equilibrio entre inteligencia y velocidad | Programación compleja, ejecución agéntica, llamadas a herramientas, trabajo de conocimiento multimodal |
xhigh |
Más tokens, razonamiento más profundo | Ingeniería difícil de varios pasos, problemas analíticos y científicos donde high no basta |
Faltan dos valores que podrías esperar. Neon rechaza minimal con un error, así que el código copiado de una aplicación con Gemini 3 Flash falla si envía ese valor. Y el antiguo recuento de tokens thinkingBudget está obsoleto en Gemini 4: si se envía solo, se asigna al nivel más cercano con una advertencia; si se envía junto con thinkingLevel, devuelve un 400.
¿Cómo se compara el valor predeterminado de Neon con el de otros modelos Gemini 4?
Neon arranca un escalón por encima de sus hermanos mayores. Según las notas de la versión de Gemini 4 Neon, Neon y Hydrogen usan high por defecto y admiten xhigh, mientras que Carbon y Argon usan medium por defecto y llegan como máximo a high.
| Modelo | Nivel predeterminado | Niveles admitidos |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Esto importa cuando cambias de modelo. Si trasladas una carga de trabajo de Carbon a Neon sin definir thinking_level, todas las solicitudes pasan del razonamiento medium al high, lo que altera tu recuento de tokens. Si estás sopesando los modelos más grandes, nuestra comparativa de Gemini 4 Carbon vs Argon cubre esa diferencia.
¿Cómo se define thinking_level en la API de Gemini?
Neon funciona en el nivel de pago tanto de la API de Interactions como de generateContent. El nombre del campo cambia según cuál uses.
API de Interactions: coloca thinking_level dentro de generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: usa thinkingLevel dentro de generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
En el SDK de Python, la llamada a Interactions acepta generation_config={"thinking_level": "high"}, y la llamada a generateContent acepta thinking_config=types.ThinkingConfig(thinking_level="low"). Deja fuera temperature, top_p y top_k: Google indica que Neon ignora los valores dentro de rango y rechaza los que están fuera de rango con un 400. Para una guía completa de la primera solicitud con el mismo diseño de API, consulta nuestra guía de la API de Gemini 4 Hydrogen.
¿Cuándo deberías usar high y cuándo xhigh?
Usa high por defecto y promueve una tarea a xhigh solo después de que high no alcance tu nivel de calidad en ella. El anuncio de lanzamiento de Google describe xhigh como «razonamiento más profundo y de varios pasos para las cargas de trabajo de ingeniería, analíticas y científicas más difíciles».
Elige xhigh cuando:
- La tarea tenga muchos pasos dependientes y un error temprano arruine el resultado, como una refactorización de varios archivos o una auditoría de concurrencia.
highhaya dado una respuesta segura pero incorrecta en tu conjunto de evaluación, no solo una respuesta más lenta.- La latencia no importe demasiado, como en trabajos en segundo plano, revisiones nocturnas o análisis por lotes.
- Una respuesta incorrecta cueste más que los tokens, como en parches de seguridad o cálculos financieros.
Quédate en high (o baja aún más) cuando:
- El prompt sea de extracción o formato. Google advierte que
xhigh«puede provocar un razonamiento excesivo o agotarmax_output_tokensen prompts más sencillos, como la extracción de texto o JSON». - Haya un usuario esperando. El chat, el autocompletado y las llamadas a herramientas en vivo encajan con
mediumolow. - Operes con un volumen alto. Cada token de pensamiento adicional se factura, y la diferencia se multiplica en cada solicitud.
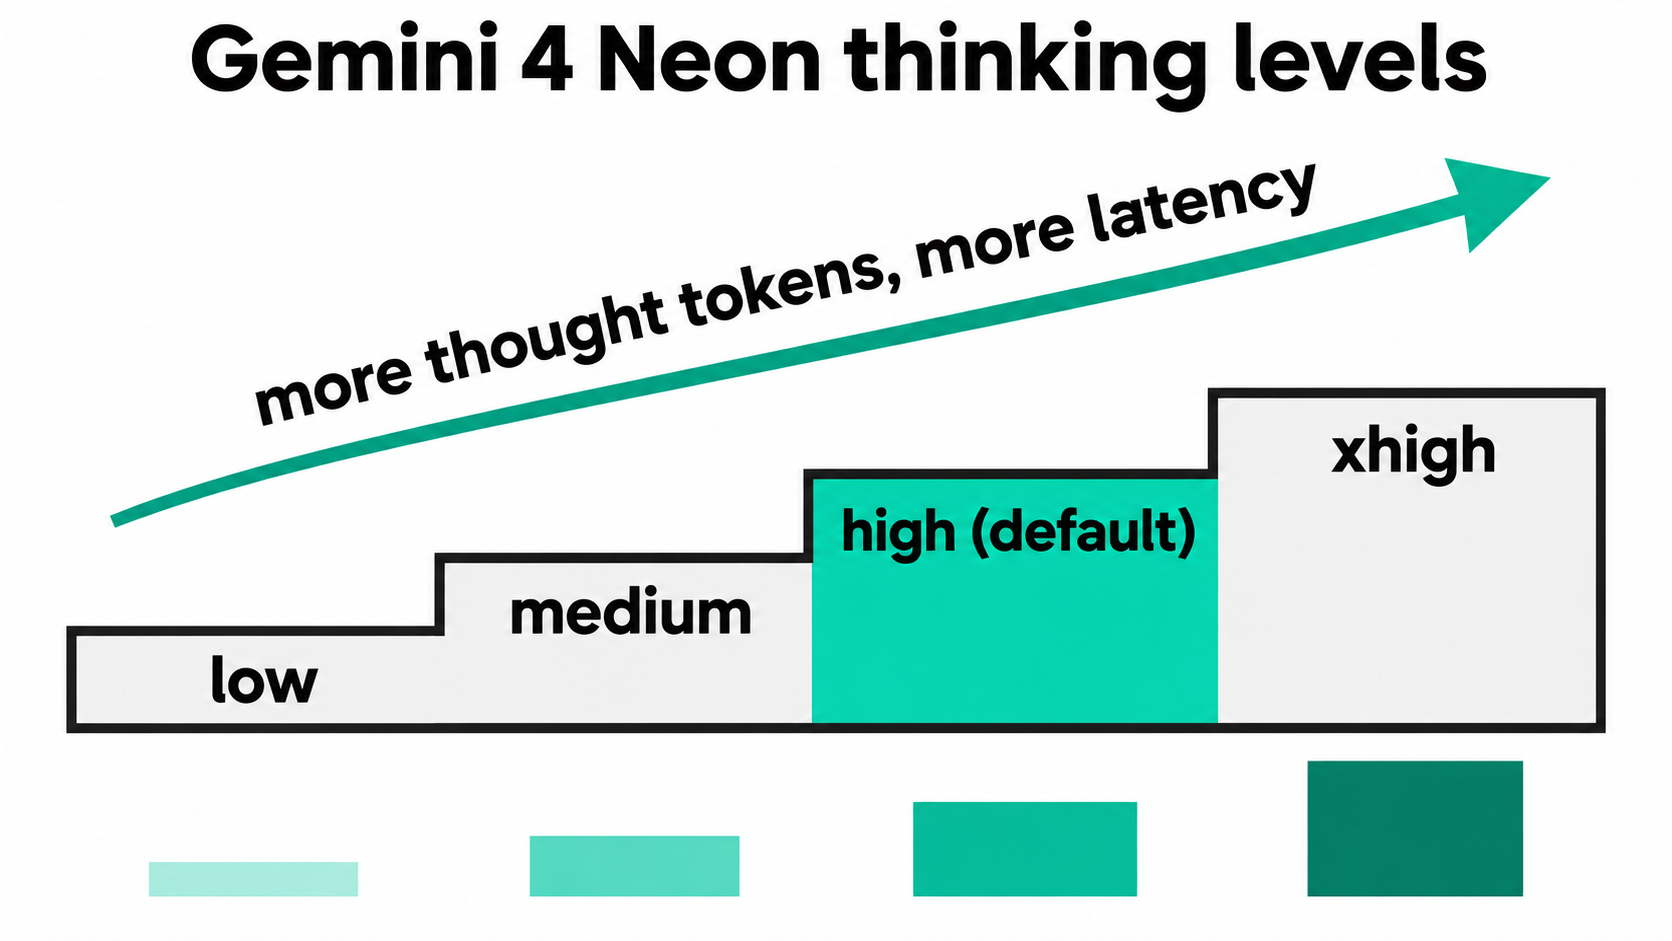
Los números de referencia de Google respaldan esta división. En su anuncio de lanzamiento, Neon con xhigh obtiene 61 en el Artificial Analysis Intelligence Index, en tercera posición. Con el high predeterminado, Google reporta un coste por tarea un 32 % menor que Carbon. Son cifras de Google, no de nuestras pruebas, pero muestran el compromiso: xhigh compra la puntuación más alta de Neon, high compra eficiencia.
¿Cuánto cuesta cada nivel de razonamiento?
Todos los niveles tienen el mismo precio por token; lo que cambia es cuántos tokens pagas. Neon cuesta $3.00 por 1M de tokens de entrada y $15.00 por 1M de tokens de salida, y la página de precios de Google indica que la tarifa de salida incluye los tokens de pensamiento. La entrada en caché baja a $0.15 por 1M mediante caché implícita (la caché explícita no es compatible con Neon). Este modelo no tiene nivel gratuito.
Así que el coste de un nivel son los tokens de pensamiento que añade, multiplicados por $15 por millón. Aquí tienes la aritmética para una solicitud con 2.000 tokens de entrada y una respuesta visible de 800 tokens. Los recuentos de tokens de pensamiento son hipotéticos, elegidos para mostrar el cálculo, no medidos:
| Tokens de pensamiento (hipotéticos) | Coste de entrada | Coste de salida + razonamiento | Total por solicitud | Por 10.000 solicitudes |
|---|---|---|---|---|
| 500 | $0.006 | $0.0195 | $0.0255 | $255 |
| 2.000 | $0.006 | $0.042 | $0.048 | $480 |
| 8.000 | $0.006 | $0.132 | $0.138 | $1.380 |
El razonamiento domina la factura rápidamente. Con 8.000 tokens de pensamiento, el razonamiento supone el 87 % del coste de la solicitud. Por eso el propio consejo de Google es ejecutar tu evaluación en los cuatro niveles y «elegir el thinking_level más bajo que cumpla tu nivel de calidad». Nuestra guía de niveles de razonamiento de Gemini 3.8 Flash cubre el mismo compromiso en un modelo más económico si quieres comparar.
¿Cómo se miden los tokens y la latencia por nivel?
Ejecuta el mismo prompt en cada nivel y lee el bloque de uso. En la API de Interactions, el objeto usage de la respuesta informa por separado total_input_tokens, total_output_tokens y total_thought_tokens. En generateContent, los tokens de pensamiento aparecen como usageMetadata.thoughtsTokenCount.
Este bucle envía un prompt en los cuatro niveles e imprime los tokens de pensamiento junto con el tiempo real transcurrido:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Ejecútalo con entre 10 y 20 prompts de tu carga de trabajo real. Un solo prompt dice poco; un conjunto muestra dónde empiezan a discrepar high y xhigh en calidad.
Configura un tiempo de espera alto en tu cliente HTTP mientras haces las pruebas. Las notas de migración de Google indican que los prompts difíciles pueden tardar varios minutos y sugieren un tiempo de espera de al menos 15 minutos, o bien la ejecución en segundo plano.
¿Por qué xhigh devuelve a veces una respuesta vacía?
max_output_tokens limita conjuntamente el razonamiento y la salida visible. Si Neon consume todo el presupuesto razonando, la interacción se detiene con el estado incomplete y devuelve una respuesta truncada o vacía, y aun así pagas por los tokens de pensamiento que generó.
Tres reglas de la documentación de Google evitan esto:
- Elimina los límites bajos antiguos. Si tu aplicación fija algo como 8.192, súbelo a 65.536, el límite síncrono predeterminado.
- Baja el nivel, no el límite. Para reducir coste o latencia, pasa a
mediumolowen lugar de reducirmax_output_tokens. - Usa el modo en segundo plano para trabajos largos. Para respuestas de más de 65.536 tokens, define
backgroundcomotrueymax_output_tokenshasta 1.048.576 menos tu entrada. La entrada, el razonamiento y la salida comparten una única ventana de 1M de tokens. Nuestra guía de salidas largas de Gemini 4 Argon explica el patrón de sondeo.
Deja que tu agente de programación compare los cuatro niveles con Apidog CLI
Repetir ese bucle a mano acaba cansando. En su lugar, deja que tu agente de programación (Claude Code, Codex, Cursor) cree una prueba reutilizable con Apidog CLI y la vuelva a ejecutar en cada nivel cuando quieras cifras actualizadas.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale un prompt a tu agente:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
El agente lee el esquema de cada payload, valida su JSON, crea los recursos y repite la ejecución:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
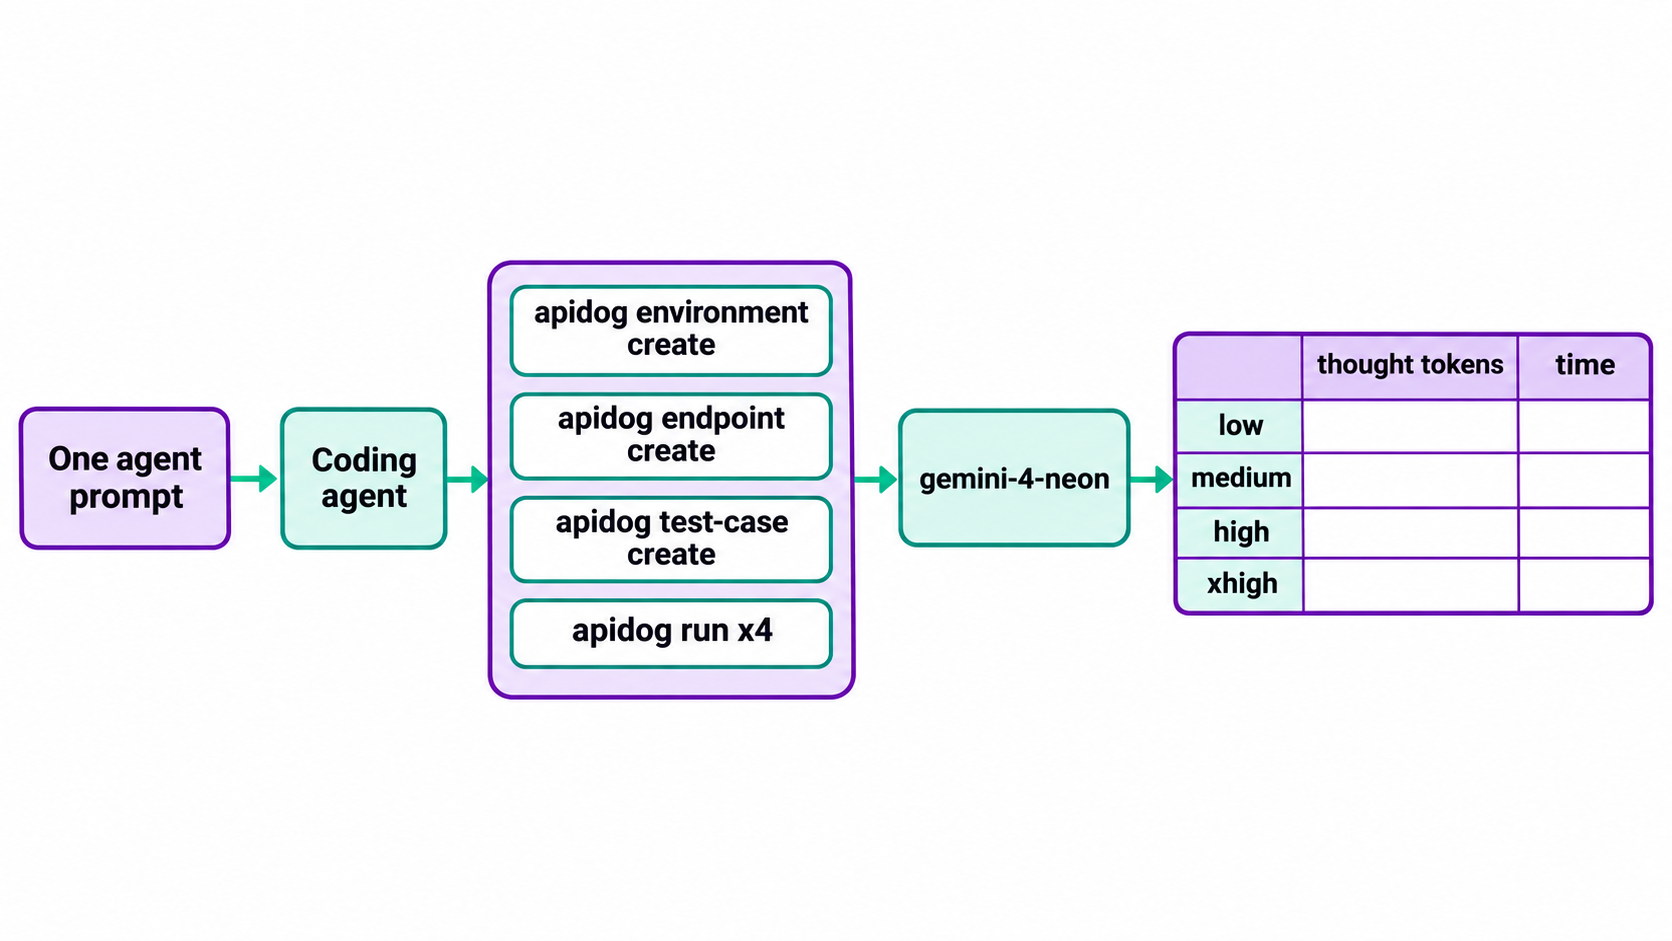
La aserción status is "completed" detecta la trampa de incomplete de la sección anterior, de modo que un nivel que se queda sin presupuesto falla de forma visible en lugar de devolver una cadena vacía. Cambia -r cli,json por -r junit y la misma ejecución entra en CI; la guía de CI/CD de Apidog CLI muestra el pipeline, y Apidog CLI en Claude Code cubre la configuración del agente. El plan Free de Apidog admite hasta 4 usuarios.
Preguntas frecuentes
¿Cuál es el nivel de razonamiento predeterminado de Gemini 4 Neon? high. No necesitas enviar thinking_level para obtenerlo. Carbon y Argon usan medium por defecto, así que define el nivel explícitamente cuando migres desde ellos.
¿Gemini 4 Neon admite el razonamiento mínimo? No. Neon admite low, medium, high y xhigh, y rechaza minimal con un error. Usa low para las respuestas más rápidas y económicas.
¿Se facturan los tokens de pensamiento en Gemini 4 Neon? Sí. Los tokens de pensamiento se facturan a la tarifa de salida de $15.00 por 1M. Google cuenta todos los tokens que procesa el modelo, incluidos los tokens de pensamiento.
¿Todavía puedo usar thinkingBudget con Gemini 4 Neon? Está obsoleto en los modelos Gemini 4. Si se envía solo, se asigna al thinkingLevel más cercano y devuelve una advertencia. Si se envía junto con thinkingLevel, la solicitud falla con un 400.
¿xhigh es siempre más preciso que high? No siempre. Google indica que xhigh puede razonar en exceso con prompts sencillos, como la extracción de texto o JSON, y puede agotar max_output_tokens. Prueba ambos con tus propios prompts y quédate con el nivel más bajo que pase.
¿Puedo usar los niveles de razonamiento de Gemini 4 Neon gratis? No. Gemini 4 Neon no está disponible en el nivel gratuito de la API de Gemini. En Google AI Studio y Google Antigravity está vinculado a los planes de pago Google AI Pro y Ultra.