
Gemini 4 Neon cuesta 3 USD por cada millón de tokens de entrada y 15 USD por cada millón de tokens de salida en el nivel de pago Standard de la API de Gemini, un precio fijo en toda su ventana de contexto de 1M de tokens. Los tokens de thinking se facturan a la tarifa de salida, la entrada cacheada cuesta 0,15 USD por millón, Batch y Flex reducen a la mitad todas las tarifas y Priority cuesta 5,40 USD y 27 USD. No existe un nivel gratuito de la API.
Google lanzó Neon el 18 de noviembre de 2026 como el modelo intermedio de la familia Gemini 4, entre el rápido Hydrogen y el potente Carbon. A continuación: la tabla de tarifas, lo que cuestan las llamadas reales, cómo los niveles de thinking afectan tu factura y cómo se compara Neon con sus hermanos antes y después del 1 de diciembre.
¿Cuánto cuesta Gemini 4 Neon por millón de tokens?
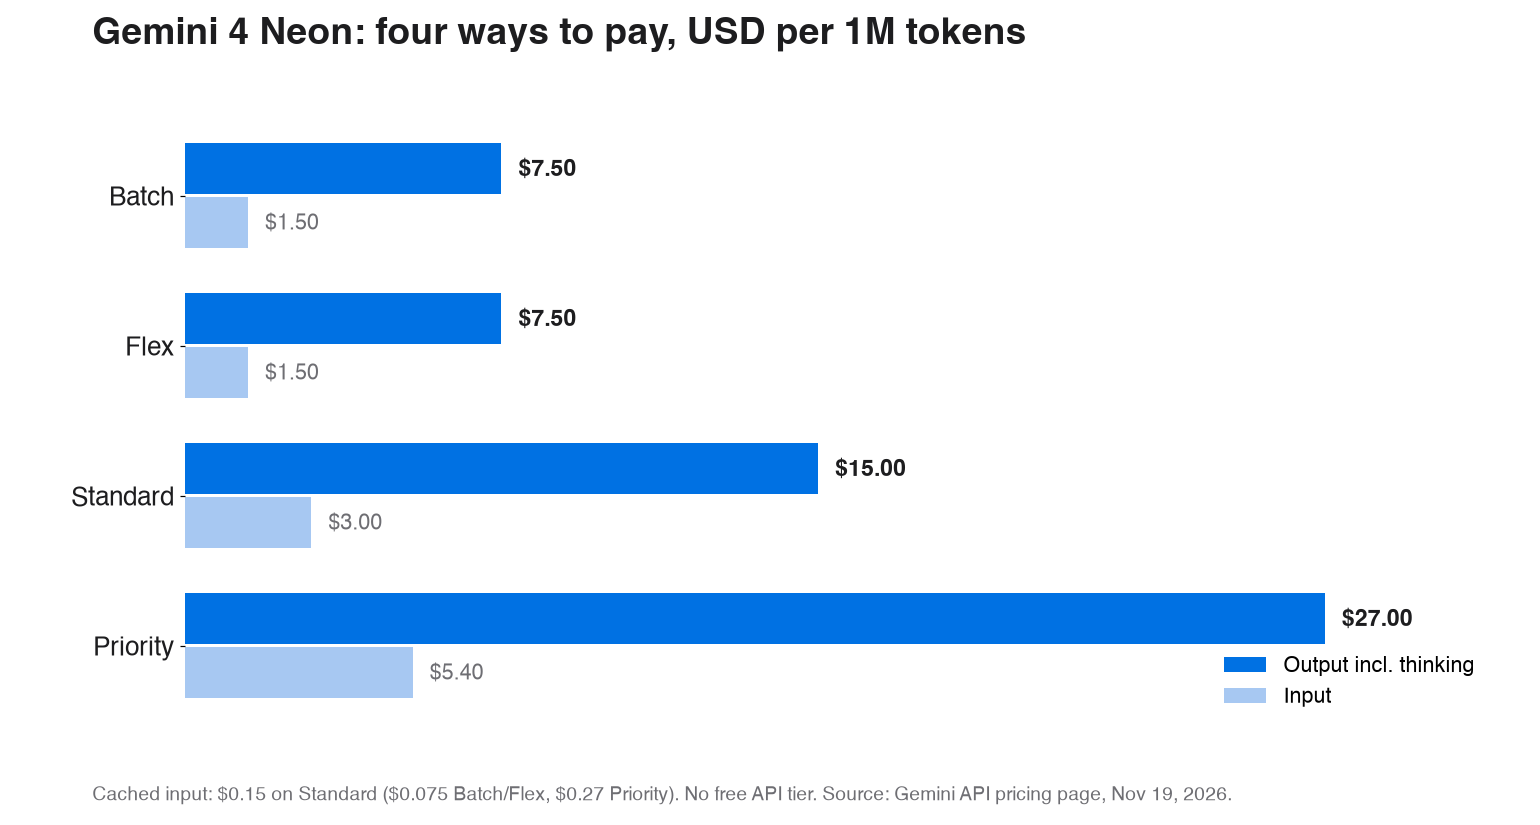
Gemini 4 Neon (ID de modelo gemini-4-neon) tiene cuatro niveles de pago en la página de precios de Google. Todos los precios están en USD por millón de tokens:
| Nivel | Entrada | Salida incl. thinking | Entrada cacheada |
|---|---|---|---|
| Standard | 3,00 USD | 15,00 USD | 0,15 USD |
| Batch | 1,50 USD | 7,50 USD | 0,075 USD |
| Flex | 1,50 USD | 7,50 USD | 0,075 USD |
| Priority | 5,40 USD | 27,00 USD | 0,27 USD |
| Nivel gratuito | No disponible | No disponible | No disponible |
Tres detalles son los más importantes:
- El thinking cuenta como salida. La columna de salida indica "incluye tokens de thinking", así que cada token que Neon dedica a razonar cuesta 15 USD por millón en Standard, aunque nunca lo veas en la respuesta.
- El caching es solo implícito. Obtienes la tarifa de 0,15 USD cuando la caché de Google coincide con un prefijo de prompt repetido; no puedes crear un objeto de caché por tu cuenta.
- No hay nivel gratuito. La página de precios de Google indica que Neon no está disponible en el nivel gratuito. Hydrogen es el modelo de Gemini 4 que puedes llamar por 0 USD (consulta nuestra guía de Gemini 4 Hydrogen gratis).
¿Qué significan los cuatro niveles de Gemini 4 Neon?
Los cuatro niveles venden el mismo modelo con distintas garantías de velocidad. Batch devuelve resultados de forma asíncrona a mitad de precio, Flex ofrece la mitad de precio para tráfico que tolera un procesamiento más lento, y Priority cuesta un 80 % más que Standard para mantener la velocidad cuando la capacidad está limitada. Elige según tus plazos:
| Tu carga de trabajo | Nivel | Por qué |
|---|---|---|
| Asistente de programación interactivo, chat | Standard | Hay un usuario esperando; 3/15 USD es la referencia |
| Revisiones de código nocturnas, ejecuciones de evals, relleno de documentos | Batch | Nadie espera; pagas 1,50/7,50 USD |
| Agentes en segundo plano que pueden reintentar más tarde | Flex | Misma mitad de precio, sin empaquetar un archivo de lote |
| Agente orientado al cliente con promesa de disponibilidad | Priority | 5,40/27 USD te compra capacidad bajo carga |
El grounding tiene su propio contador. En Standard y Priority, el grounding con Google Search incluye 5.000 solicitudes de búsqueda gratuitas al mes, compartidas entre los modelos Gemini 3 y posteriores, y luego cuesta 14 USD por cada 1.000. El grounding con Google Maps sigue el mismo patrón: 5.000 gratuitas y luego 14 USD por cada 1.000. La página de precios no lista precio de grounding para Batch ni Flex.
¿Cómo afectan los niveles de thinking a tu factura de Gemini 4 Neon?
Neon admite cuatro niveles de thinking: low, medium, high y xhigh. El nivel no cambia el precio por token; cambia cuántos tokens de salida consume Neon antes de responder.
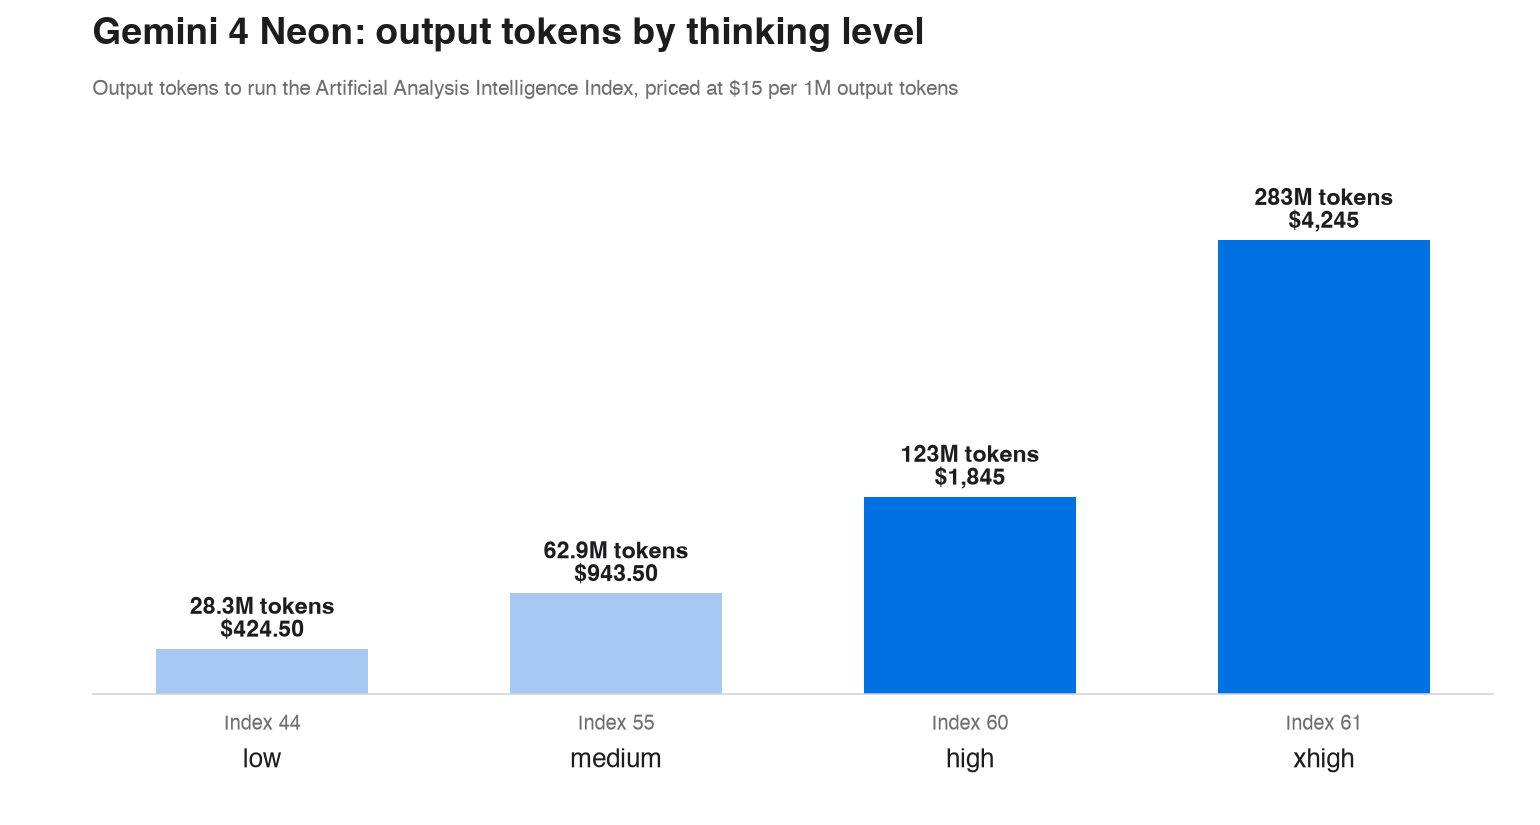
Artificial Analysis ejecutó su Intelligence Index en cada nivel y publicó los tokens de salida que utilizó cada ejecución. Multiplica por la tarifa de salida de 15 USD de Standard y obtienes el costo de salida de la ejecución completa:
| Nivel de thinking | Intelligence Index | Tokens de salida | Costo de salida a 15 USD/1M | Tiempo por tarea |
|---|---|---|---|---|
| low | 44 | 28,3M | 424,50 USD | 3,7 min |
| medium | 55 | 62,9M | 943,50 USD | 8,3 min |
| high | 60 | 123M | 1.845 USD | 14,8 min |
| xhigh | 61 | 283M | 4.245 USD | 21,5 min |
Dos cosas llaman la atención. Pasar de high a xhigh compra un solo punto de índice por 2,3 veces más tokens de salida. Y medium ofrece la mayor parte de la puntuación de high por aproximadamente la mitad de los tokens. Artificial Analysis sitúa el costo principal de Neon en 6,44 USD por tarea de índice en xhigh.
La regla práctica: empieza tus pruebas en medium, pasa una tarea a high solo cuando puedas demostrar que falla en medium, y reserva xhigh para el raro problema donde un punto extra de calidad vale más que duplicar el costo.
¿Cuánto cuesta una llamada a Gemini 4 Neon?
Aquí tienes tres formas comunes de solicitud, con precios en Standard. Las cifras de salida incluyen tokens de thinking.
1. Una llamada de revisión de código. 20.000 tokens de entrada (el diff más el contexto), 3.000 tokens de salida:
- Entrada: 20.000 × 3 USD / 1M = 0,060 USD
- Salida: 3.000 × 15 USD / 1M = 0,045 USD
- Total: 0,105 USD por llamada, o 0,0525 USD en Batch
Ejecuta 1.000 de esas al día durante 30 días y gastarás 3.150 USD al mes en Standard, o 1.575 USD si las revisiones pueden esperar a Batch.
2. Un bucle de agente con prefijo cacheado. Diez turnos, cada uno enviando el mismo prompt de sistema de 50.000 tokens y lista de herramientas, más 5.000 tokens de entrada nuevos y 2.000 tokens de salida:
- Con acierto de caché en el prefijo: 50.000 × 0,15 USD / 1M + 5.000 × 3 USD / 1M + 2.000 × 15 USD / 1M = 0,0525 USD por turno, 0,53 USD por el bucle
- Sin acierto de caché: 55.000 × 3 USD / 1M + 2.000 × 15 USD / 1M = 0,195 USD por turno, 1,95 USD por el bucle
Eso supone una diferencia del 73 % solo por el caching. Como el caching de Neon es implícito, no puedes forzar el acierto; aumentas sus probabilidades manteniendo la parte estable del prompt al inicio e idéntica byte a byte entre turnos.
3. Una pregunta sobre un documento largo. 800.000 tokens de entrada (una base de código grande o un conjunto de contratos) y 4.000 tokens de salida:
- Entrada: 800.000 × 3 USD / 1M = 2,40 USD
- Salida: 4.000 × 15 USD / 1M = 0,06 USD
- Total: 2,46 USD, o 1,23 USD en Batch
Neon no tiene recargo por contexto largo en la página de precios, así que el token 900.000 cuesta lo mismo que el token 1. La ventana de contexto es de 1.048.576 tokens compartidos entre entrada y salida, y una única solicitud síncrona devuelve hasta 65.536 tokens de salida por defecto.
¿Cómo se comparan los precios de Neon con Hydrogen y Carbon?
Neon cuesta exactamente el doble que Hydrogen por token. La comparación con Carbon cambia el 1 de diciembre, cuando termina la tarifa introductoria de Carbon:
| Modelo | Entrada / 1M | Salida / 1M | Llamada de revisión de código (20K entrada, 3K salida) | Nivel gratuito |
|---|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 USD | 7,50 USD | 0,0525 USD | Sí |
| Gemini 4 Neon | 3,00 USD | 15,00 USD | 0,105 USD | No |
| Gemini 4 Carbon, hasta el 30 de noviembre | 2,00 USD | 10,00 USD | 0,070 USD | No |
| Gemini 4 Carbon, desde el 1 de diciembre | 4,00 USD | 20,00 USD | 0,140 USD | No |
Durante los próximos once días, Carbon es más barato por token que Neon. Si construyes sobre los 2/10 USD de Carbon hoy, presupuesta 4/20 USD en diciembre. Nuestro análisis de precios de Gemini 4 Carbon cubre ese cambio en detalle.
A partir del 1 de diciembre, Neon se sitúa en el medio: un 25 % por debajo de Carbon y el doble que Hydrogen por token. Por tarea, la diferencia depende de los tokens de thinking, así que mide el costo por solicitud con tus propios prompts en lugar de comparar tablas de tarifas.
Enruta según la dificultad: Hydrogen para llamadas cotidianas de alto volumen, Neon para tareas complejas de programación y análisis que ejecutes con frecuencia, y Carbon para los problemas individuales más difíciles.
¿Cómo puedes reducir tu factura de Gemini 4 Neon?
Cinco palancas, en el orden en que suelen dar resultado:
- Baja el nivel de thinking.
mediumusa aproximadamente la mitad de los tokens de salida dehighen las ejecuciones de Artificial Analysis. - Envía el trabajo que puede esperar a Batch o Flex. Todo lo que nadie lee en tiempo real cuesta la mitad.
- Moldea los prompts para el caching implícito. Mantén los prompts de sistema y las definiciones de herramientas al principio sin cambios, para que los prefijos repetidos se facturen a 0,15 USD en lugar de 3 USD.
- Limita la salida. Establece un número máximo de tokens de salida adecuado a la tarea.
- Enruta las llamadas sencillas a Hydrogen. Reserva Neon para el trabajo que lo necesite.
Consulta la página de límites de tarifa de la API de Gemini para tu nivel antes de planificar el rendimiento.
Mide tu costo real de Gemini 4 Neon con Apidog CLI
Cada respuesta de la API de Interactions de Google incluye un objeto usage con los recuentos de tokens de entrada, cacheados, de thinking y de salida. Ese bloque, multiplicado por la tabla de tarifas anterior, es tu costo real por solicitud. Ejecutar los mismos prompts en cada nivel de thinking y compararlos es un trabajo repetitivo, así que delega esa tarea en tu agente de programación.
Apidog CLI ofrece a Claude Code, Codex, Cursor u OpenCode una forma de línea de comandos para crear y ejecutar pruebas de API. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un único prompt:
In Apidog project <id>, create an environment for the Gemini API with
GEMINI_API_KEY and THINKING_LEVEL variables. Add a test case for
POST /v1beta/interactions with model gemini-4-neon and
generation_config.thinking_level set from THINKING_LEVEL. Send our code review
prompt, assert HTTP 200 and non-empty output, and save usage.total_input_tokens,
total_cached_tokens, total_thought_tokens and total_output_tokens. Run it at
low, medium and high, then compute the Standard cost of each run at $3 input,
$0.15 cached and $15 per 1M for thought and output tokens.
El agente crea el entorno, valida el payload de su caso de prueba contra el esquema y luego lo ejecuta una vez por nivel:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=low" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=medium" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=high" -r cli,json
Los informes JSON le dan a tu agente los recuentos de tokens para calcular precios, de modo que obtienes una tabla de costo por nivel con tus propios prompts. Añade apidog run ... -r junit a tu CI con la guía de CI/CD de Apidog CLI para detectar un cambio de prompt que duplique tus tokens de thinking, o empieza con Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Es gratis Gemini 4 Neon? No a través de la API. La página de precios de Google indica que Neon no está disponible en el nivel gratuito, por lo que necesitas un proyecto de pago de la API de Gemini. Hydrogen es el modelo de Gemini 4 con nivel gratuito.
¿Los tokens de thinking se facturan por separado? No. Se facturan como tokens de salida, a 15 USD por millón en Standard. El objeto usage de la API de Interactions los reporta como total_thought_tokens, así que puedes ver cuánta parte de cada factura es razonamiento.
¿Gemini 4 Neon cuesta más a partir de 200K tokens? No. La página de precios muestra una única tarifa de entrada y una única de salida para Neon, sin nivel de contexto largo, en toda la ventana de 1.048.576 tokens.
¿Cuánto más barato es Batch? Exactamente la mitad: 1,50 USD por millón de tokens de entrada y 7,50 USD por millón de tokens de salida, con entrada cacheada a 0,075 USD. Flex tiene las mismas tarifas.
¿Neon es más barato que Carbon? No hasta el 1 de diciembre. La tarifa introductoria de Carbon de 2/10 USD se mantiene hasta el 30 de noviembre y luego sube a 4/20 USD, lo que deja los 3/15 USD de Neon aproximadamente un 25 % por debajo de Carbon por token.