
La caché de contexto de Gemini 4 Neon es únicamente implícita. No creas una caché. Google almacena en caché por su cuenta los prefijos de prompt repetidos de al menos 4.096 tokens y factura esos tokens de entrada en caché a $0.15 por 1M en lugar de $3, un descuento del 95%. Lo obtienes manteniendo la parte estable de cada solicitud al principio y byte a byte idéntica, y luego confirmando los aciertos en usage.total_cached_tokens.
A continuación: la estructura del prompt para acertar en la caché, la regla del bucle de agente, cómo leer el contador de tokens en caché y una prueba que tu agente de programación ejecuta por ti.
¿Cómo funciona la caché de contexto de Gemini 4 Neon?
La caché de contexto de Gemini 4 Neon es una caché de prefijos automática. Cuando una nueva solicitud comienza con los mismos tokens que una reciente, y ese prefijo compartido tiene al menos 4.096 tokens, Google sirve la parte repetida desde la caché y la factura a la tarifa de caché. No hay nada que activar, ni objeto de caché, TTL ni tarifa de almacenamiento que gestionar.
Google lanzó Neon el 18 de noviembre de 2026 (ID de modelo gemini-4-neon, consulta la publicación de lanzamiento). Sus datos sobre la caché caben en una tabla:
| Concepto | Gemini 4 Neon |
|---|---|
| Modo de caché | Solo implícita, activada por defecto |
Caché explícita (cachedContents, caches.create) |
No compatible |
| Prefijo mínimo para un acierto de caché | 4.096 tokens |
| Entrada estándar | $3.00 por 1M de tokens |
| Entrada en caché (estándar) | $0.15 por 1M de tokens |
| Entrada en caché (Batch y Flex) | $0.075 por 1M de tokens |
| Entrada en caché (Priority) | $0.27 por 1M de tokens |
| Dónde ver los aciertos | usage.total_cached_tokens |
| Nivel gratuito | Ninguno, solo nivel de pago |
El descuento es del 95% en todos los niveles: $0.15 es el 5% de $3, $0.075 es el 5% de $1.50 y $0.27 es el 5% de $5.40. Los tokens de salida, incluidos los tokens de razonamiento, se mantienen a $15 por 1M en el nivel estándar. La caché solo afecta a la entrada.
Caché implícita frente a caché explícita en Gemini 4 Neon
Si usaste la caché explícita en Gemini 2.5 o 3, este es el cambio que rompe el código. Las notas de migración de Google sobre Neon lo dicen claramente: Gemini 4 Neon “no admite la caché explícita (cachedContents y caches.create)”, y debes “eliminar los campos cached_content de las solicitudes”.
La documentación de la caché añade que la API de Interactions solo admite la caché implícita, y que la caché explícita no está disponible para ningún modelo de Gemini 4. Las cachés explícitas siguen funcionando en los modelos compatibles de Gemini 3 y 2.5 a través de generateContent.
Lo que esto significa para una migración:
- Elimina el código que llama a
caches.createy almacena un nombre de caché. - Quita
cached_contentdel cuerpo de cada solicitud. - Deja de pagar por el almacenamiento de caché que ya no usas.
- Reestructura los prompts para que el contenido que antes almacenabas en caché explícitamente quede al inicio de cada solicitud.
No puedes fijar un documento ni elegir un TTL, y un acierto no está garantizado. Pero puedes aumentar mucho las probabilidades.
¿Cómo estructurar los prompts para acertar en la caché de Gemini 4 Neon?
Un acierto de caché requiere un prefijo largo e idéntico enviado de nuevo poco después. La documentación de Google da dos consejos: coloca el contenido grande y común al principio de tu prompt, y envía solicitudes con un prefijo similar en un plazo corto de tiempo.
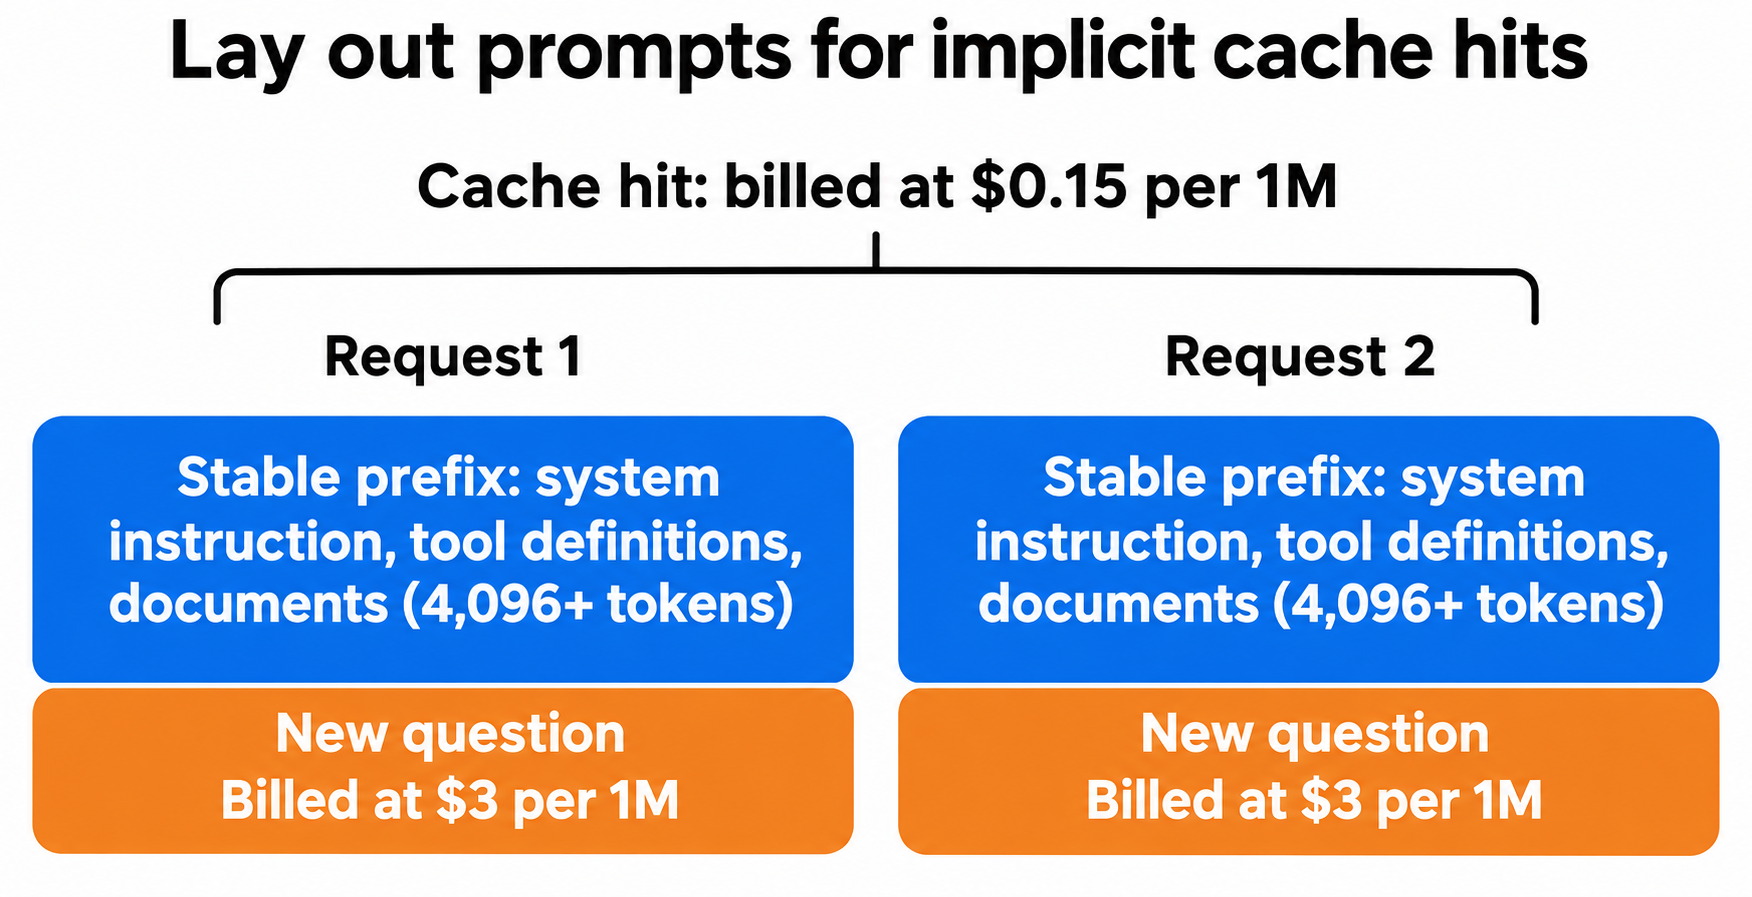
Ordena cada solicitud así:
- Instrucción del sistema. Texto fijo, sin marcas de tiempo, sin nombres de usuario, sin IDs de solicitud.
- Declaraciones de herramientas y funciones. La misma lista, el mismo orden, las mismas descripciones siempre.
- Documentos compartidos. El código base, el contrato, la especificación de la API, el archivo largo de políticas.
- La parte que cambia. La pregunta del usuario, el último resultado de una herramienta, la fecha de hoy.
La forma más común de fallar la caché es un pequeño valor dinámico cerca del principio. Una línea como Current time: 2026-11-19T09:14:02Z en la instrucción del sistema cambia el prefijo en cada llamada, por lo que nada posterior puede coincidir. Muévela al final, después de los documentos.
Otros rompedores de prefijos: listas de herramientas construidas en un orden aleatorio, documentos re-serializados con espacios en blanco diferentes y fragmentos recuperados devueltos en un orden distinto.
Mantén el prefijo por encima de los 4.096 tokens. Un prompt de sistema de 2.000 tokens por sí solo no califica. Si le añades un documento compartido largo, el prefijo combinado sí lo hará.
Con la API de Interactions, pasa la instrucción estable en system_instruction y coloca los documentos al principio de input:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
La primera llamada llena la caché. Si la segunda imprime 0 tokens en caché, algo en el prefijo cambió.
La caché implícita funciona en ambos modos de conversación. Las llamadas sin estado como la de arriba califican, y también las sesiones con estado encadenadas con previous_interaction_id. Para ver las formas completas de solicitud, consulta nuestra guía de la API de Gemini 4 Neon.
Cómo funciona la caché en los bucles de agente: la regla de los 2.050 tokens
Los bucles de agente son donde la caché rinde más, porque cada turno reenvía todo el historial. Los modelos de Gemini 4 añaden una regla que necesitas conocer. Según la documentación de caché de Google: “Gemini solo almacena en caché la solicitud anterior completa si la nueva solicitud añade al menos 2.050 tokens”. La salida del modelo, los pensamientos y los resultados de funciones cuentan todos para ese total.
Si un turno añade menos de 2.050 tokens, Gemini reprocesa los últimos 2.050 tokens de la solicitud anterior a la tarifa estándar de entrada. La parte anterior del prefijo puede seguir acertando, pero esa cola se factura a $3 por 1M.
Google señala que la mayoría de los turnos de agente superan el umbral. El problema aparece en bucles muy comunicativos con pasos diminutos, como una verificación de estado que devuelve {"ok": true}. El coste por turno es pequeño (2.050 tokens a $3 por 1M son unos $0.006), pero se acumula a lo largo de miles de turnos cortos. Si tu bucle hace muchas llamadas diminutas, agrupa los resultados pequeños de herramientas en un solo turno cuando tu lógica lo permita.
¿Cuánto ahorra la caché de contexto de Gemini 4 Neon?
Tomemos un asistente de revisión de código que responde a 20 preguntas sobre un código base de 200.000 tokens. Cada pregunta añade 3.000 tokens y recibe una respuesta de 1.000 tokens, en el nivel estándar.
Sin aciertos de caché, cada llamada cuesta:
- Entrada: 203.000 × $3 / 1M = $0.609
- Salida: 1.000 × $15 / 1M = $0.015
- Por llamada: $0.624, es decir, $12.48 por 20 llamadas
Con aciertos de caché después de la primera llamada, las llamadas 2 a 20 cuestan:
- Prefijo en caché: 200.000 × $0.15 / 1M = $0.030
- Entrada nueva: 3.000 × $3 / 1M = $0.009
- Salida: $0.015
- Por llamada: $0.054
Sumando la primera llamada sin caché de $0.624, la sesión cuesta $1.65, aproximadamente un 87% menos.
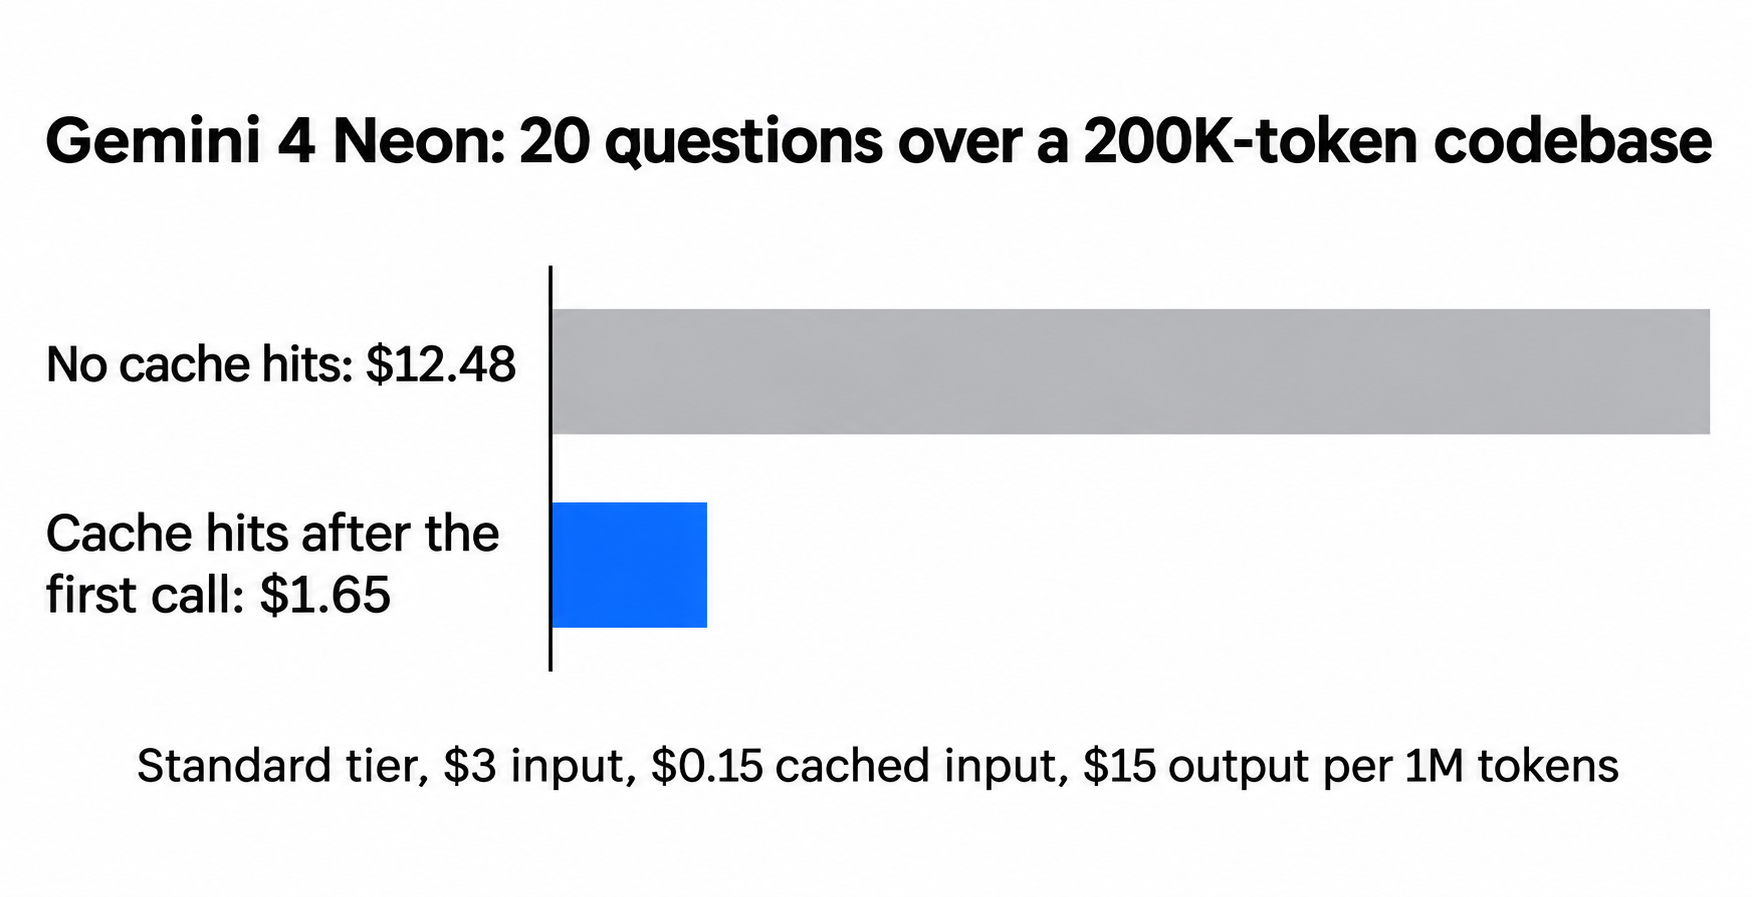
El ahorro es inferior al 95% porque la salida y la entrada nueva nunca reciben el descuento. Cuanto mayor sea el prefijo compartido respecto al resto, más te acercas al 95% en la entrada. Ejecuta el mismo trabajo con Batch y la tarifa de caché se reduce a la mitad, a $0.075. Para ver la lista completa de tarifas y los costes por nivel de razonamiento, consulta precios de Gemini 4 Neon.
¿Cómo comprobar los tokens en caché de Gemini 4 Neon en la respuesta?
Lee usage.total_cached_tokens en cada respuesta. Google lo documenta como el campo que muestra cuántos tokens fueron aciertos de caché, tanto en los SDK de Python como de JavaScript.
Con curl y jq:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
Para calcular el precio de una llamada, factura los tokens en caché a $0.15 por 1M, el resto de tu entrada a $3 y la salida más el razonamiento a $15. Registra el contador de caché junto a tu ID de solicitud. Una caída repentina a 0 en todo el tráfico suele significar que un despliegue cambió el prefijo: una herramienta nueva, una regla reformulada o una marca de tiempo que se coló en la instrucción del sistema.
Deja que tu agente de programación pruebe los aciertos de caché con Apidog CLI
Los prefijos se rompen durante refactorizaciones cotidianas, y nadie se entera hasta que llega la factura. Convierte la comprobación de caché en una prueba de API que tu agente de programación mantiene y CI ejecuta.
Apidog CLI permite a Claude Code, Codex, Cursor u OpenCode crear y ejecutar pruebas de API desde la terminal. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
El agente crea el entorno y el escenario, comprueba su payload contra el esquema de la CLI y lo ejecuta:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Si alguien añade una marca de tiempo al prompt del sistema el mes que viene, la aserción del paso 2 fallará antes de que el cambio se envíe. Coloca apidog run -t <scenarioId> --project <id> -e <envId> -r junit en tu pipeline con la guía de CI/CD de Apidog CLI, o empieza con Apidog CLI en Claude Code. Cada ejecución hace dos llamadas reales a Neon, por lo que cuesta unos pocos centavos por ejecución a las tarifas anteriores. El plan gratuito de Apidog cubre hasta 4 usuarios.
Para saber cómo funciona la caché de prefijos entre proveedores, consulta qué es la caché de prompts.
Preguntas frecuentes
¿Admite Gemini 4 Neon la caché de contexto explícita? No. La guía de Google sobre Neon dice que no admite cachedContents ni caches.create, y que debes eliminar cached_content de las solicitudes. Neon usa solo la caché implícita, que está activada por defecto.
¿Cuál es el tamaño mínimo de prompt para un acierto de caché en Gemini 4 Neon? 4.096 tokens de prefijo compartido. Es el mismo mínimo que en Gemini 4 Hydrogen, Argon y Carbon. Gemini 2.5 Flash y Pro necesitan 2.048.
¿Cuánto es el descuento de caché de Gemini 4 Neon? 95% en la entrada en caché. El nivel estándar baja de $3 a $0.15 por 1M de tokens, Batch y Flex de $1.50 a $0.075, y Priority de $5.40 a $0.27. Los tokens de salida y razonamiento no tienen descuento.
¿Puedo obligar a Gemini 4 Neon a almacenar un prompt en caché? No. La caché implícita no tiene ninguna opción que puedas activar, ningún TTL que puedas elegir y ningún acierto garantizado. Aumentas las probabilidades manteniendo un prefijo largo e idéntico al inicio de cada solicitud y enviando solicitudes similares en momentos cercanos.
¿Cómo sé si mi solicitud acertó en la caché? Consulta usage.total_cached_tokens en la respuesta. Un valor superior a cero significa que esa cantidad de tokens de entrada se facturó a la tarifa de caché.
¿Funciona la caché con previous_interaction_id? Sí. La documentación de Google indica que la caché implícita funciona tanto en conversaciones con estado encadenadas con previous_interaction_id como en las sin estado, donde envías tú mismo el historial completo.