
Los benchmarks de Gemini 4 Neon lo sitúan en el n.º 1 del Artificial Analysis Coding Agent Index (58,6), con un 65,2 % en Terminal-Bench 4.1 y en el n.º 2 del Vals Index (70,9 %). Google también afirma que cuesta un 32 % menos por tarea que Gemini 4 Carbon con su nivel de pensamiento high predeterminado. Sin embargo, la mayoría de las filas se ejecutaron con xhigh, y algunas con el propio arnés de Google.
Ese último detalle es el tema de este artículo. Nuestro resumen de Gemini 4 Neon cubre especificaciones y precios. Aquí tienes todas las puntuaciones publicadas, quién las midió, con qué nivel de pensamiento y cómo convertir el «coste por tarea» en una cifra que puedas contrastar con tu propia factura.
Benchmarks de Gemini 4 Neon de un vistazo
Gemini 4 Neon es el modelo intermedio de Gemini 4 de Google, lanzado el 18 de noviembre de 2026, con un precio de 3 USD por millón de tokens de entrada y 15 USD por millón de tokens de salida. Sus resultados publicados más sólidos están en programación agéntica y trabajo de conocimiento, donde ocupa el n.º 1 o el n.º 2 en cuatro clasificaciones independientes.
Estas son las filas destacadas de la publicación de lanzamiento de Google:
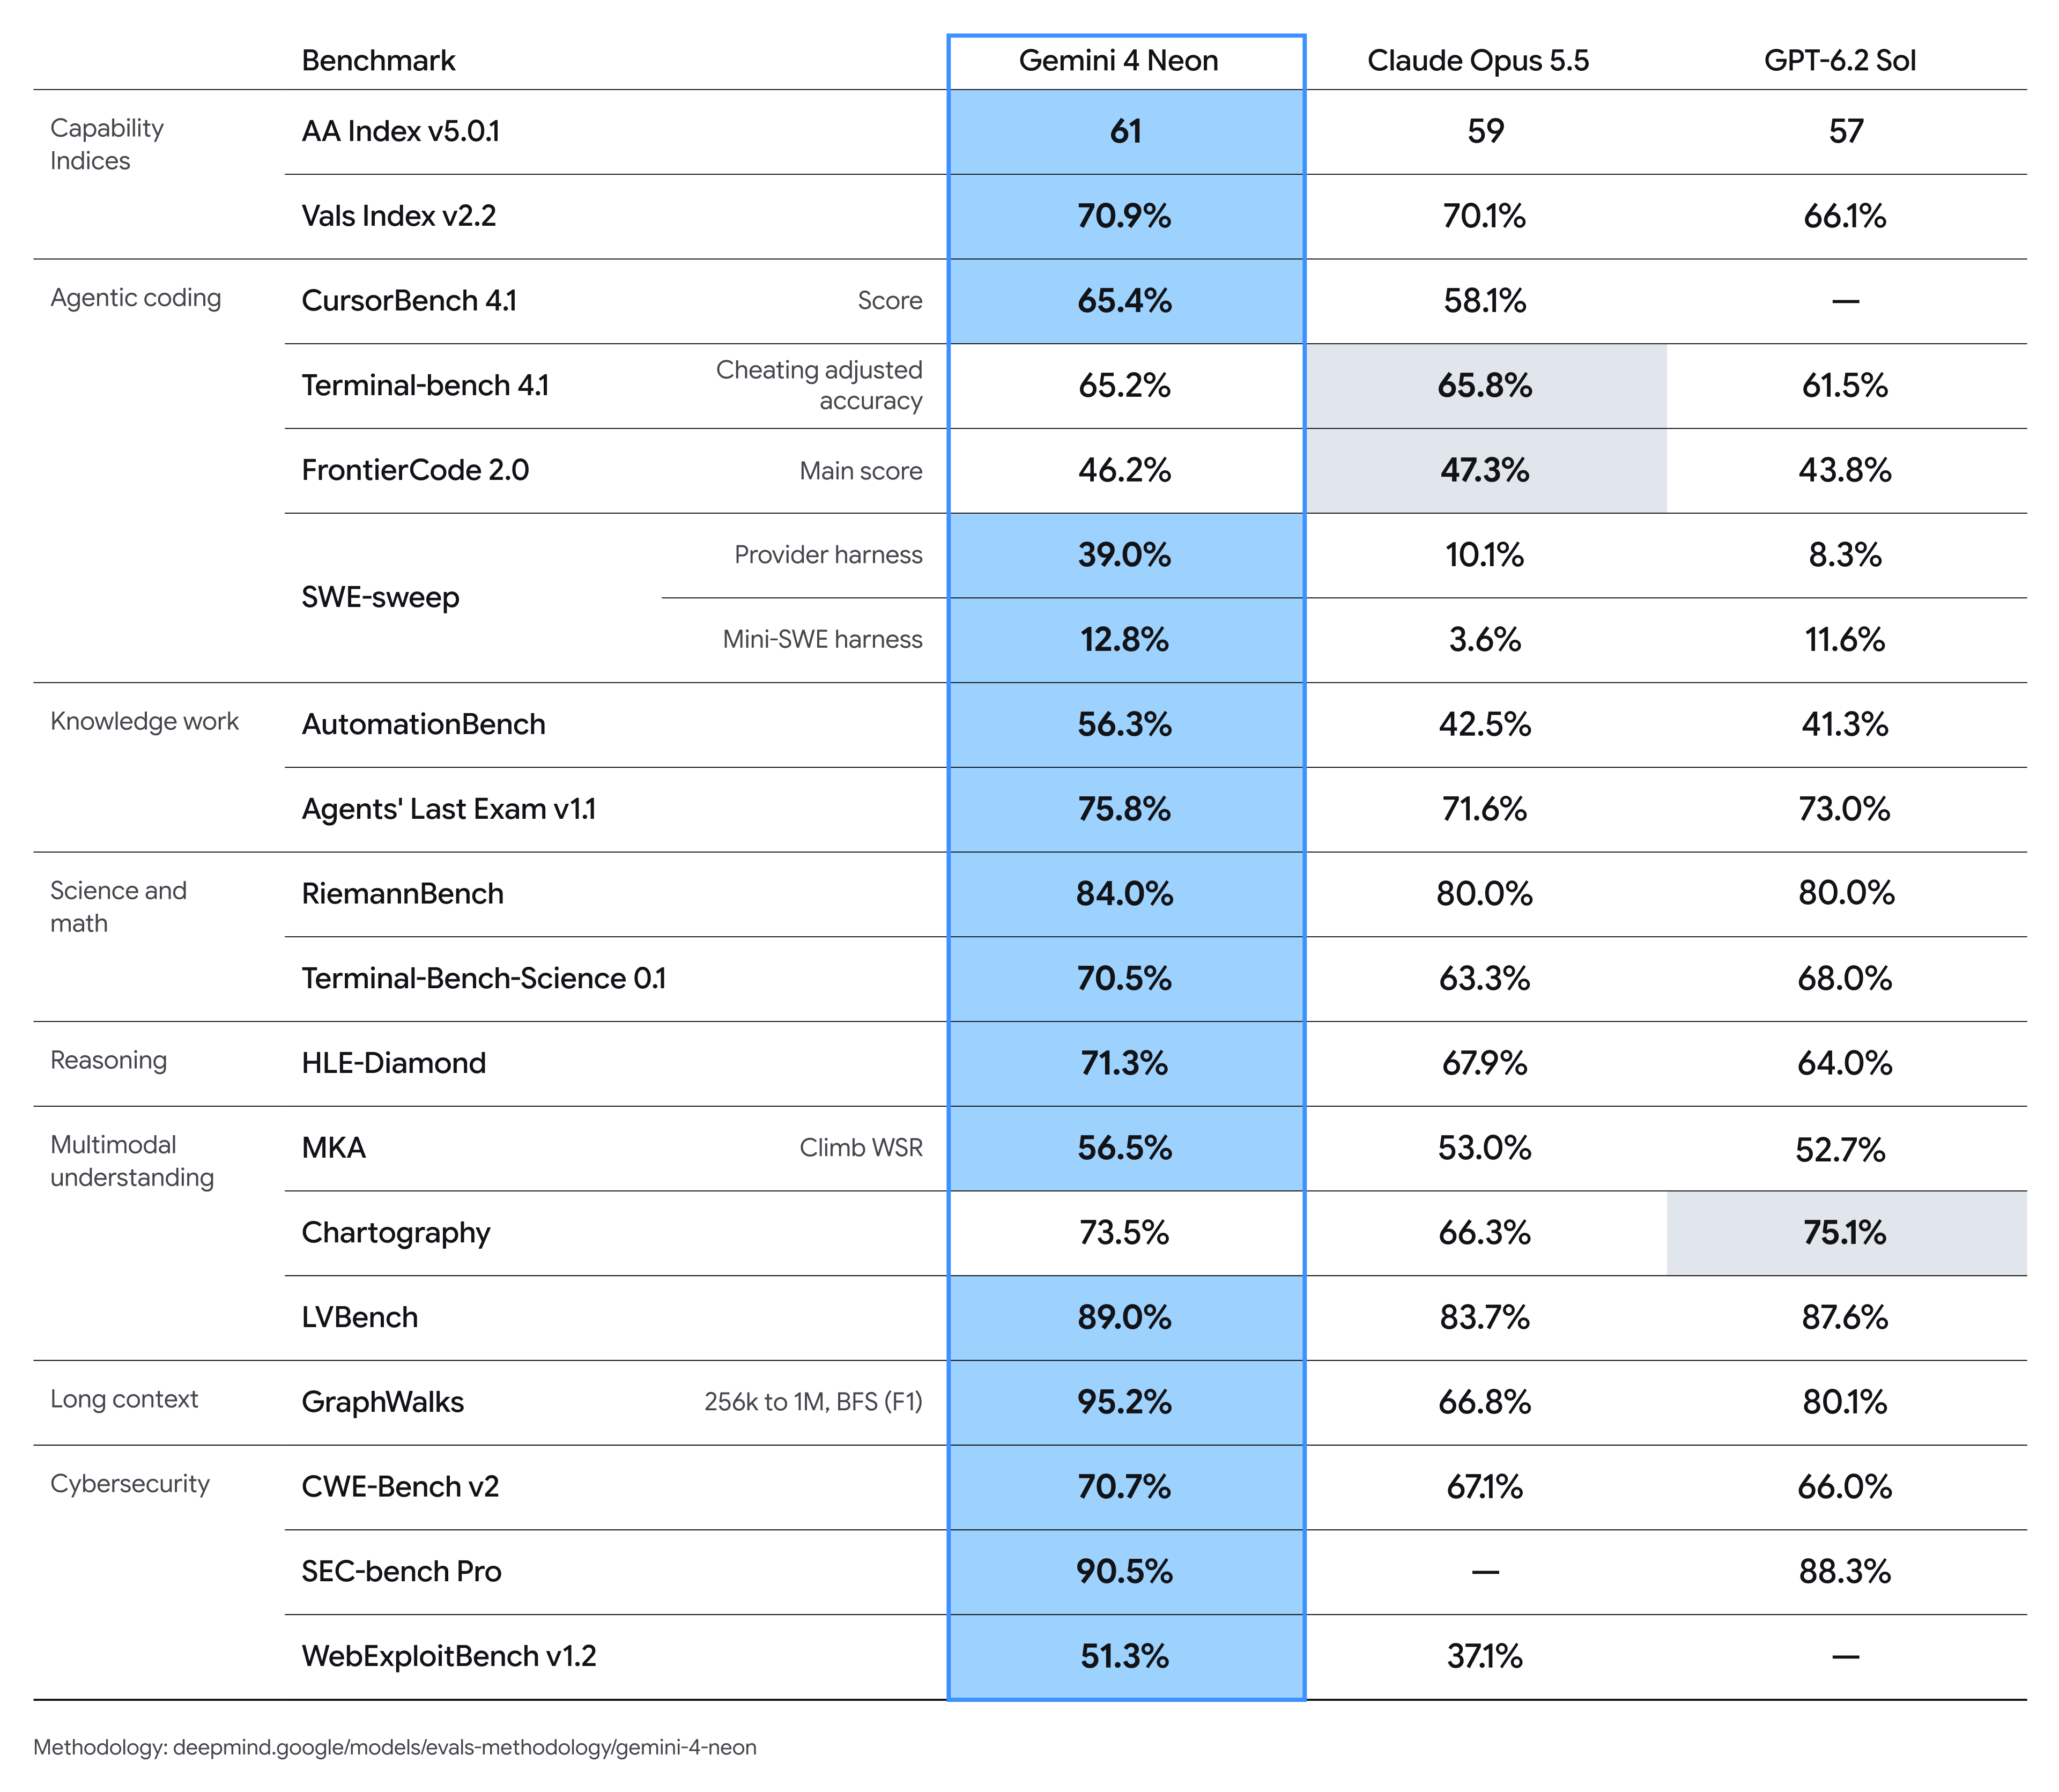
Google también informa del n.º 1 en Legal Research Bench y Tax Agent Bench de Vals AI.
Benchmarks de programación de Gemini 4 Neon
La programación es donde el argumento de Neon es más sólido y también donde más importa el arnés. El PDF de metodología de evaluación de Google explica cómo se generó cada fila de programación.
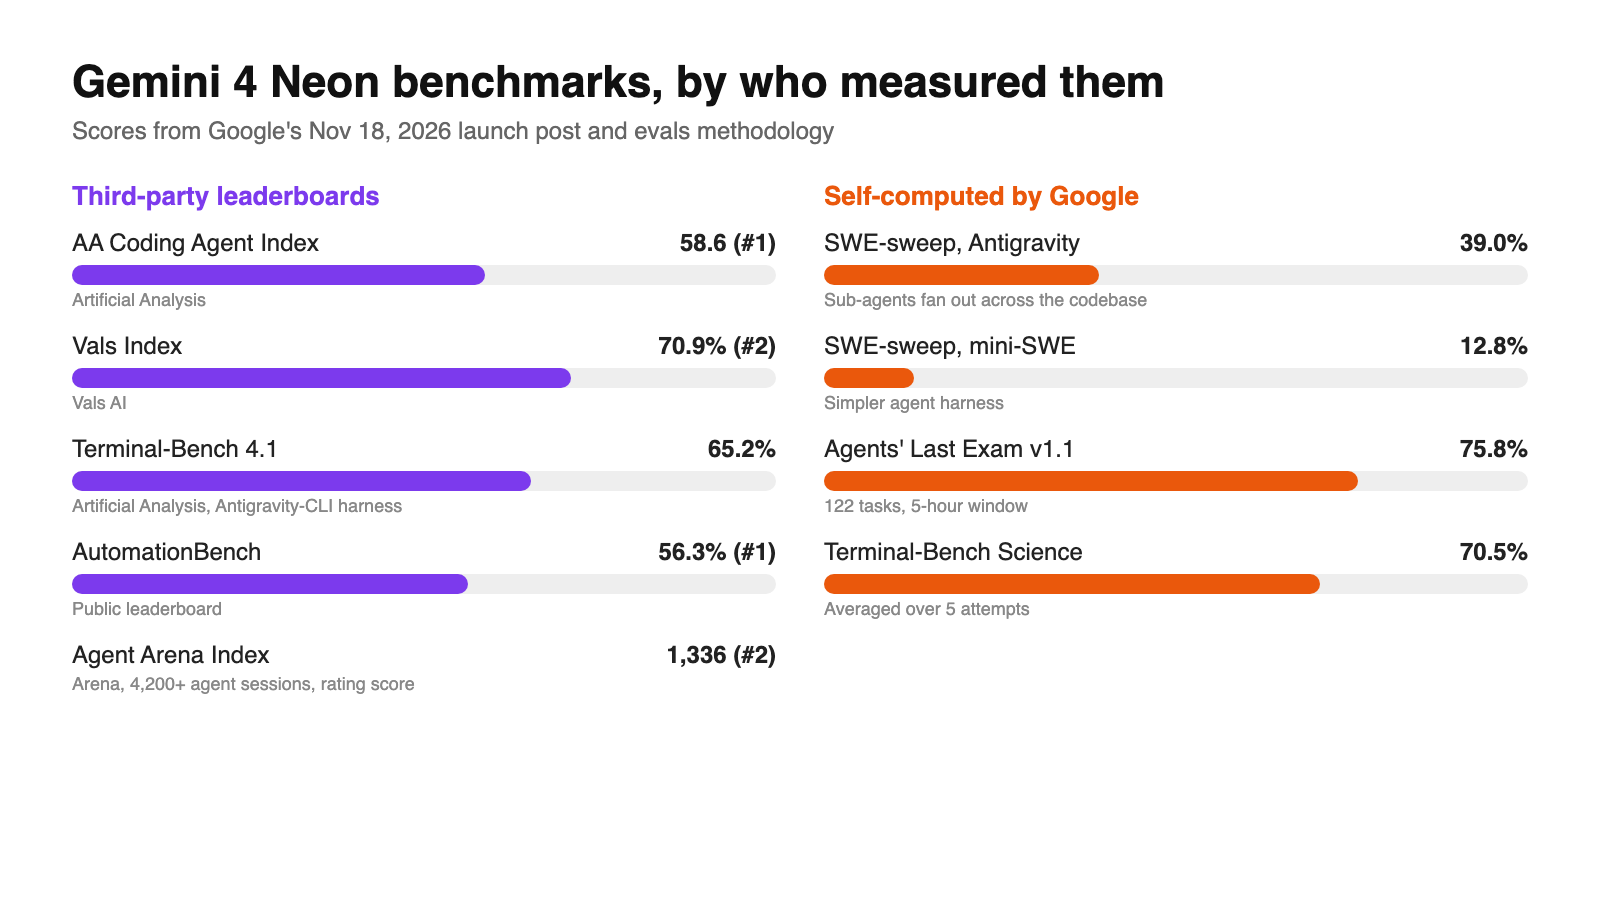
Artificial Analysis Coding Agent Index: 58,6, n.º 1. Es un compuesto independiente, así que es la fila menos condicionada por la configuración de Google. Puedes consultar la clasificación actual en Artificial Analysis.
Terminal-Bench 4.1: 65,2 %. Artificial Analysis ejecutó Neon con el arnés público Antigravity-CLI, versión 1.5.9. Las puntuaciones de otros modelos provienen de la clasificación oficial y todos los resultados usan una precisión ajustada por trampas. Es justo, pero Neon se ejecutó dentro de las propias herramientas de agente de Google.
FrontierCode 2.0: 46,2 %. Esta procede de la clasificación pública y se ejecutó con high, el valor predeterminado que tienes en producción. Si solo vas a fiarte de una cifra de programación para el tráfico diario, fíate de esta.
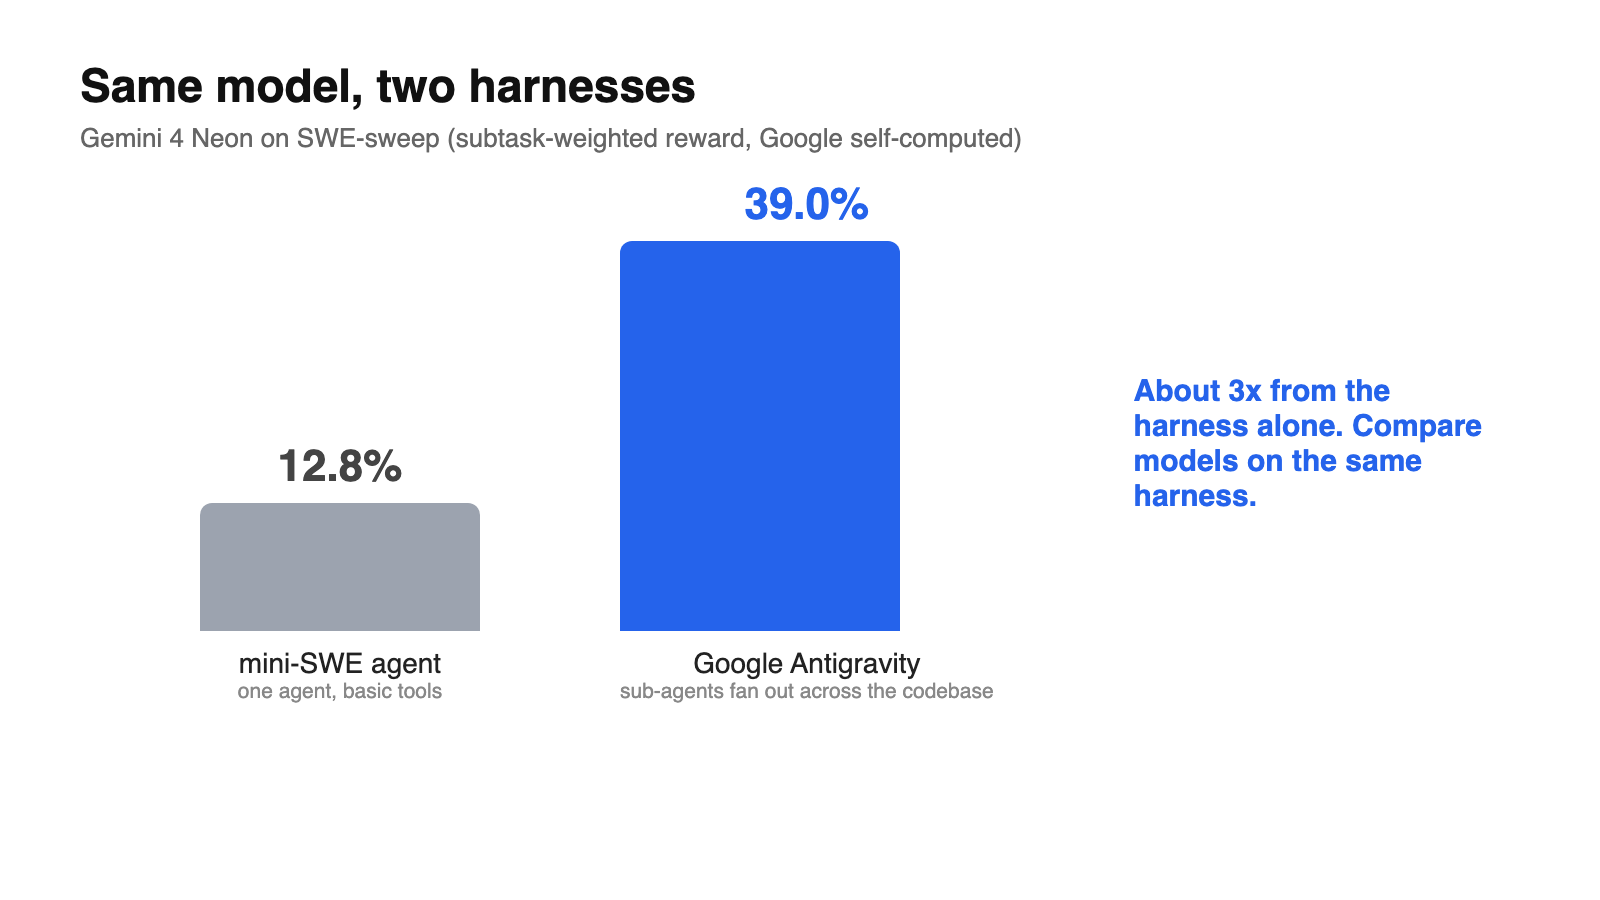
SWE-sweep: 39,0 % en Antigravity, 12,8 % con mini-SWE. Ambas las calcula Google por su cuenta. El salto de 3× proviene del arnés: Google señala que Antigravity-CLI incluye una herramienta predeterminada que distribuye subagentes por todo el código base, lo que encaja con tareas de detección de errores. Opus 5.5 se ejecutó en Claude Code y GPT-6.2 Sol en Codex para la misma comparación. Interpreta 12,8 % como el modelo y 39,0 % como el modelo más sus mejores herramientas.
Benchmarks de agentes y trabajo de conocimiento
Estas filas importan si piensas ejecutar Neon sin supervisión durante muchos pasos.
- Agent Arena Index: 1.336, n.º 2. Se construyó a partir de más de 4.200 sesiones reales de agentes. Google también afirma que Neon ocupa el n.º 2 en capacidad de guiado, lo que significa que se adapta bien cuando un usuario lo corrige a mitad de tarea.
- AutomationBench: 56,3 %, n.º 1. El benchmark de Zapier para automatización empresarial, tomado de la clasificación pública.
- Vending-Bench 2: 16.843 USD, n.º 1. La simulación de horizonte largo de Andon Labs sobre llevar un negocio. La puntuación es dinero ganado, no un porcentaje.
- Agents’ Last Exam v1.1: 75,8 %. Calculado por Google sobre el conjunto de 122 tareas dentro de Antigravity-CLI 1.4.8, con una ventana de 5 horas por ejecución. La puntuación de Opus 5.5 proviene de la clasificación pública y la de GPT-6.2 Sol de su ficha de sistema, así que las configuraciones difieren.
- Chartography: 73,5 %. Lectura de gráficos profesionales densos, calculado por Google sin herramientas.
En ciencia y matemáticas, Neon registra 70,5 % en Terminal-Bench Science (calculado por Google, promediado sobre 5 intentos), 84,0 % en RiemannBench y 71,3 % en HLE-Diamond (de la clasificación de Artificial Analysis).
Cómo obtuvo Google las cifras
Cuatro reglas de la metodología cambian cómo deberías leer la tabla:
- Nivel de pensamiento más alto de forma predeterminada. «Todos los resultados se ejecutan con la API de Gemini con los ajustes de pensamiento más altos, salvo que se indique lo contrario». Eso es
xhigh. Solo FrontierCode 2.0 está marcado explícitamente comohigh. Las llamadas de producción usanhighde forma predeterminada, así que espera menos tokens de pensamiento y posiblemente puntuaciones más bajas que las de la tabla. - Pass@1, un solo intento. Sin votación por mayoría ni cómputo paralelo en tiempo de prueba, salvo donde se indique (Terminal-Bench Science promedia 5 intentos).
- Las cifras de los competidores son autodeclaradas. Las puntuaciones que no son de Gemini provienen de cada proveedor, salvo que se indique lo contrario. Opus 5.5 y GPT-6.2 Sol usan su configuración de razonamiento máxima cuando está disponible.
- Filtros de seguridad activados, excepto en ciberseguridad. Las filas de ciberseguridad se ejecutaron con los filtros desactivados.
Nuestra guía de niveles de pensamiento explica cuándo merece la pena xhigh con sus tokens adicionales.
Coste por tarea: qué significa la afirmación del 32 %
El coste por tarea es el gasto total para completar una tarea de benchmark, no el precio por token. Un modelo con un precio por token más alto puede costar menos por tarea si llega a la respuesta en menos pasos y con menos tokens de pensamiento.
Google hace tres afirmaciones sobre costes:
| Afirmación | Nivel de pensamiento | Comparado con |
|---|---|---|
| 32 % menos coste por tarea, con una puntuación alta en el AA Intelligence Index | high |
Gemini 4 Carbon |
| Aproximadamente entre un 50 % y un 80 % menos de coste por tarea en Vals Index y Agent Arena | high |
Modelos frontera competidores más destacados |
| 36 % o más de reducción del coste por tarea | xhigh |
Modelos competidores con su configuración más alta |
Fíjate en la discrepancia: las filas de precisión usan mayoritariamente xhigh, mientras que el ahorro destacado del 32 % es con high. Ambas cosas son ciertas, pero no a la vez. Obtienes el ahorro de coste o la mejor puntuación, y la diferencia entre ambos es cosa tuya medirla.
Así puedes estimar tu propio coste por tarea. Los tokens de pensamiento se facturan como salida.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Una tarea de programación con 20.000 tokens de entrada y 4.000 tokens de salida cuesta 0,06 USD + 0,06 USD = 0,12 USD. Si 15.000 de esos tokens de entrada se sirven desde la caché, baja a 0,015 USD + 0,00225 USD + 0,06 USD = alrededor de 0,077 USD. Ejecuta la misma tarea con xhigh y lo que cambia es el recuento de salida, así que registra los tokens por nivel, no solo si pasa o falla. Nuestro desglose de precios de Gemini 4 Neon cubre las tarifas Batch, Flex y Priority.
Filas de ciberseguridad y seguridad
Las puntuaciones de ciberseguridad provienen de «Gemini 4 Neon for cyber», que se ofrece a defensores de confianza a través del Fairwind Program en lugar de la API pública.
| Benchmark | Puntuación | Nota |
|---|---|---|
| SEC-bench Pro | 90,5 % | Estado del arte, aproximadamente la mitad del coste por desafío |
| WebExploitBench v1.2 | 51,26 % | Estado del arte, la mitad del coste de los modelos grandes |
| AutoBaxBench (nivel difícil) | 76 % | Estado del arte, código más seguro que Carbon en todos los niveles |
| CWE-bench v2 | 70,7 % | 3,4 % de mejora sobre Carbon |
| ExploitGym | No indicado | Nivel frontera usando la mitad de los tokens de Carbon |
Cifras de seguridad de la misma publicación: Neon rechazó el 1,98 % de las tareas de Terminal-Bench 4.0, obtuvo un 0,0 % de trampas en Terminal-Bench 4.0, tomó atajos en el 2,45 % de la evaluación de trampas de programación de Google y superó el 99,2 % de su evaluación de honestidad como agente. Con salvaguardas en tiempo real y su nivel de pensamiento más alto, resistió todos los ataques del benchmark de inyección indirecta de prompts de Gray Swan.
Dónde no lidera Neon
Neon no es el primero en todo, y Google lo reconoce:
- Artificial Analysis Intelligence Index: n.º 3 en general, «justo por detrás de modelos más grandes y lentos».
- Vals Index: n.º 2, no n.º 1.
- Agent Arena Index: n.º 2.
Google además sigue remitiéndote a Carbon para sus proyectos de horizonte largo más difíciles. Si estás eligiendo entre los tres modelos de Gemini 4, nuestra comparativa Neon vs Carbon vs Hydrogen describe los compromisos, y el artículo sobre los benchmarks de Gemini 4 Argon muestra cómo se leía la tabla del modelo anterior.
Evalúa Gemini 4 Neon por tu cuenta con Apidog CLI
Las clasificaciones describen el arnés de Google, no tu producto. La forma más rápida de saber si Neon justifica su precio es dejar que tu agente de programación ejecute los mismos prompts con high y xhigh y registre los tokens y la latencia de cada uno.
No hay nivel gratuito de API para Neon, así que necesitas una clave de API de Gemini de pago. Esta solicitud sigue el formato documentado de la Interactions API de Google; no la hemos ejecutado en vivo para este artículo:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI permite que Claude Code, Codex, Cursor u OpenCode creen y ejecuten pruebas de API desde la terminal. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Después, dale un solo prompt a tu agente:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
El agente crea el entorno, valida la carga útil del caso de prueba con su esquema y luego lo ejecuta una vez por nivel de pensamiento:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Añade --timeout-request 900000 si tus prompts son largos, ya que las ejecuciones difíciles con xhigh pueden tardar varios minutos. Para volver a ejecutar la comparación cada vez que cambies un prompt, incluye el mismo apidog run ... -r junit en CI con la guía de CI/CD de Apidog CLI, o empieza por Apidog CLI en Claude Code. El plan Free de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Cuál es el mejor resultado de Gemini 4 Neon en los benchmarks? El n.º 1 en el Artificial Analysis Coding Agent Index con 58,6, además del n.º 1 en AutomationBench (56,3 %) y Vending-Bench 2 (16.843 USD).
¿Con qué nivel de pensamiento se ejecutaron los benchmarks? Mayoritariamente con xhigh, la configuración más alta. La metodología de Google indica que los resultados usan las configuraciones de pensamiento más altas salvo que se indique lo contrario; FrontierCode 2.0 (46,2 %) está marcado como el high predeterminado.
¿Gemini 4 Neon es más barato que Carbon por tarea? Google afirma que cuesta un 32 % menos por tarea con high. Es una cifra por tarea obtenida de ejecuciones de benchmark, así que confírmala con tus propios prompts antes de migrar tráfico.
¿Por qué Neon obtiene 39,0 % y 12,8 % en SWE-sweep? Porque son arneses distintos. El 39,0 % se obtiene dentro de Google Antigravity, que distribuye subagentes por todo el código base; el 12,8 % corresponde al agente mini-SWE, más simple.
¿Los benchmarks de Gemini 4 Neon son independientes? En parte. Las filas de Artificial Analysis, Vals, Arena, AutomationBench y FrontierCode provienen de terceros. SWE-sweep, Agents’ Last Exam y Terminal-Bench Science los calcula Google por su cuenta.