
Gemini 4 Hydrogen cuesta $1.50 por cada millón de tokens de entrada y $7.50 por cada millón de tokens de salida en el nivel Standard de pago de la API de Gemini, un precio fijo en toda la ventana de contexto de 1M de tokens. Los tokens de thinking se facturan a la tarifa de salida, la entrada en caché cuesta $0.075 por millón, y Batch o Flex reducen todas las tarifas a la mitad.
Hydrogen, lanzado el 12 de noviembre de 2026, es el miembro rápido de la familia Gemini 4. A diferencia de Carbon y Argon, no tiene un precio de introducción que se duplique después, y está disponible en el nivel Free. A continuación encontrarás: la tabla de precios, ejemplos de costos calculados, cómo los niveles de thinking afectan tu factura y cómo medir tu propio costo. ¿No conoces el modelo? Empieza con qué es Gemini 4 Hydrogen.
¿Cuánto cuesta Gemini 4 Hydrogen por millón de tokens?
Gemini 4 Hydrogen (ID de modelo gemini-4-hydrogen) tiene cuatro niveles de pago en la página de precios de Google. Todos los precios son por millón de tokens:
| Nivel | Entrada | Salida (incluye thinking) | Entrada en caché | Nivel Free |
|---|---|---|---|---|
| Standard | $1.50 | $7.50 | $0.075 | Gratis |
| Batch | $0.75 | $3.75 | $0.0375 | No disponible |
| Flex | $0.75 | $3.75 | $0.0375 | No disponible |
| Priority | $2.70 | $13.50 | $0.135 | Ver página de precios |
Tres detalles de esa misma página afectan tu presupuesto:
- El thinking se factura. "Cada token que el modelo procesa se cuenta y se factura, incluidos los tokens de thinking."
- Solo caché implícita. La caché explícita no está disponible; obtienes la tarifa de caché cuando la caché implícita de Google coincide con un prefijo de prompt repetido.
- El grounding cuesta aparte. El grounding con Google Search incluye 5,000 solicitudes gratis al mes, y luego $14 por cada 1,000.
El uso del nivel Free está marcado como "Usado para mejorar nuestros productos: Sí" en la página. Nuestra guía de Gemini 4 Hydrogen gratis repasa todas las opciones con costo $0.
¿Qué significa "precio fijo hasta 1M de tokens"?
Significa que hay un solo precio para prompts de cualquier tamaño. Google dice en su publicación de lanzamiento que Hydrogen "tiene un precio fijo en toda su ventana de contexto de un millón de tokens: $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida". Un prompt de 5K tokens y uno de 900K tokens se facturan a la misma tarifa por token.
No todos los modelos de Gemini funcionan así: Gemini 3.1 Pro Preview cobra $2.00/$12.00 por millón hasta 200K tokens y $4.00/$18.00 por encima de ese umbral.
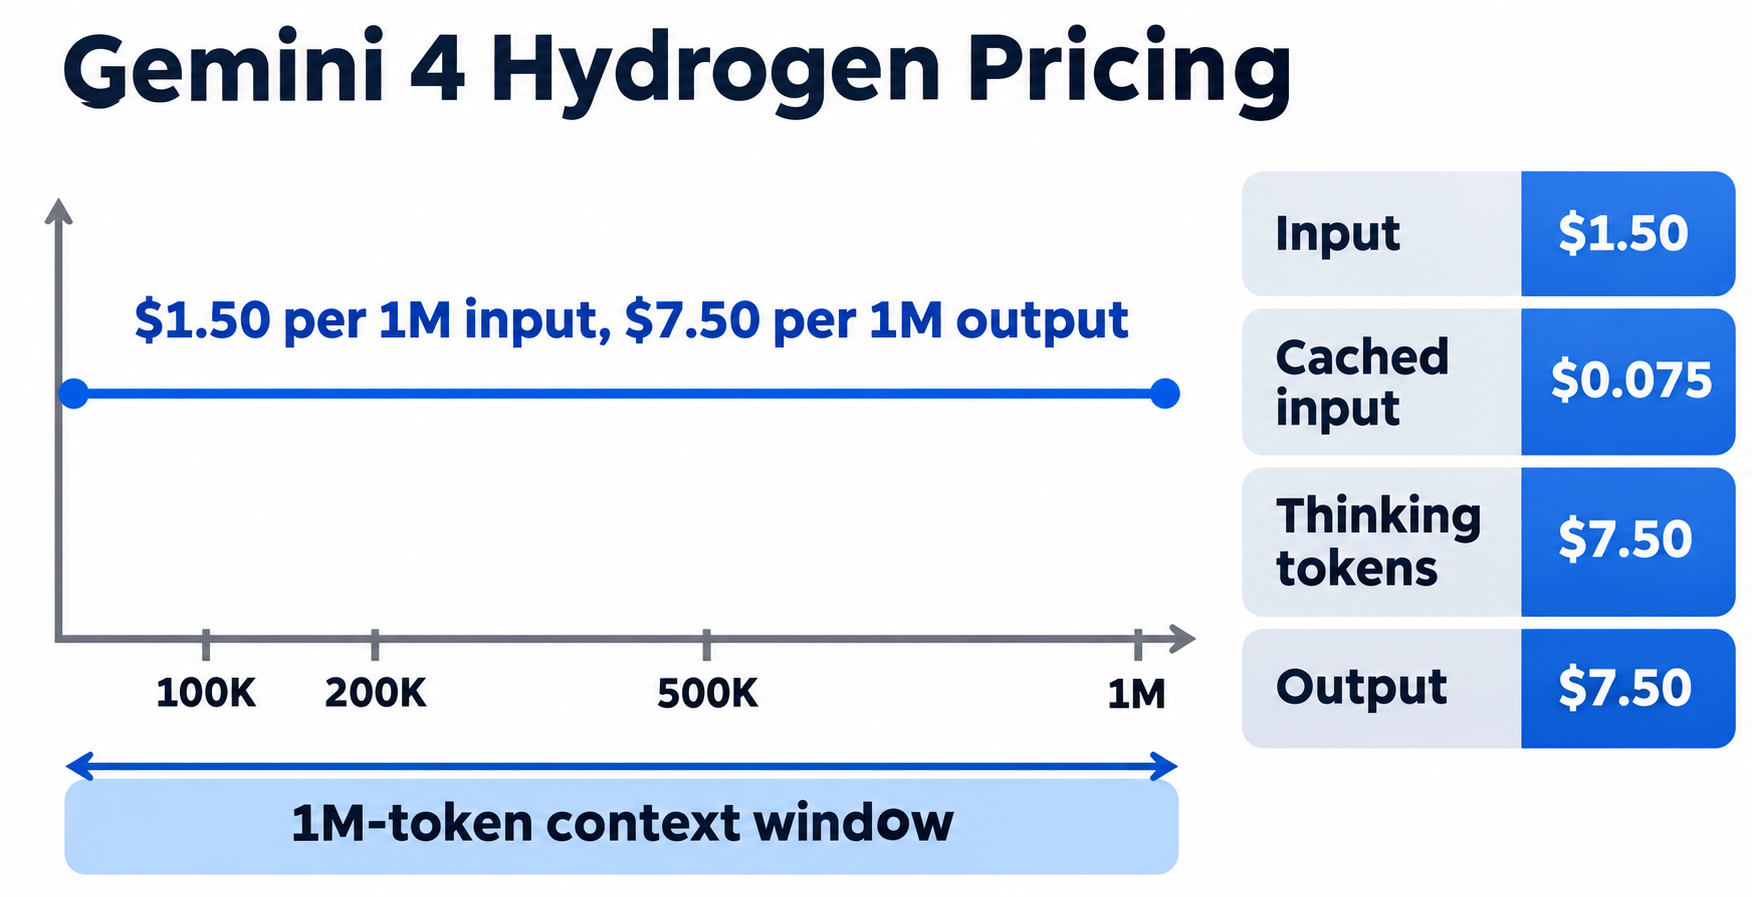
Dos cifras lo dejan claro:
- Un prompt de 900K tokens (una base de código grande o un montón de PDFs) cuesta $1.35 de entrada en el nivel Standard, o $0.0675 cuando acierta la caché implícita.
- La ventana de contexto es unificada: entrada, thinking y salida comparten 1,048,576 tokens. Un prompt de 900K deja unos 148K tokens para el thinking y la respuesta combinados.
Las respuestas síncronas se limitan a 65,536 tokens. Las salidas más largas pasan por long decode, igualmente a $7.50 por millón.
¿Cómo afectan los niveles de thinking a tu factura de Gemini 4 Hydrogen?
Hydrogen admite cuatro niveles de thinking: low, medium, high (el predeterminado) y un nuevo xhigh. Se configura con generation_config.thinking_level. El precio por token nunca cambia; lo que cambia es la cantidad de tokens de thinking, que se facturan a la tarifa de salida.
Artificial Analysis ejecutó su Índice de Inteligencia en cada nivel. Esto fue lo que reportó:
| Nivel de thinking | Puntuación del índice | Tokens generados en el índice | Costo por tarea del índice |
|---|---|---|---|
| low | 27 | 20.3M | $0.29 |
| medium | 41 | 54.4M | $0.80 |
| high (predeterminado) | 51 | 110M | $1.87 |
| xhigh | 54 | 304M | $3.16 |
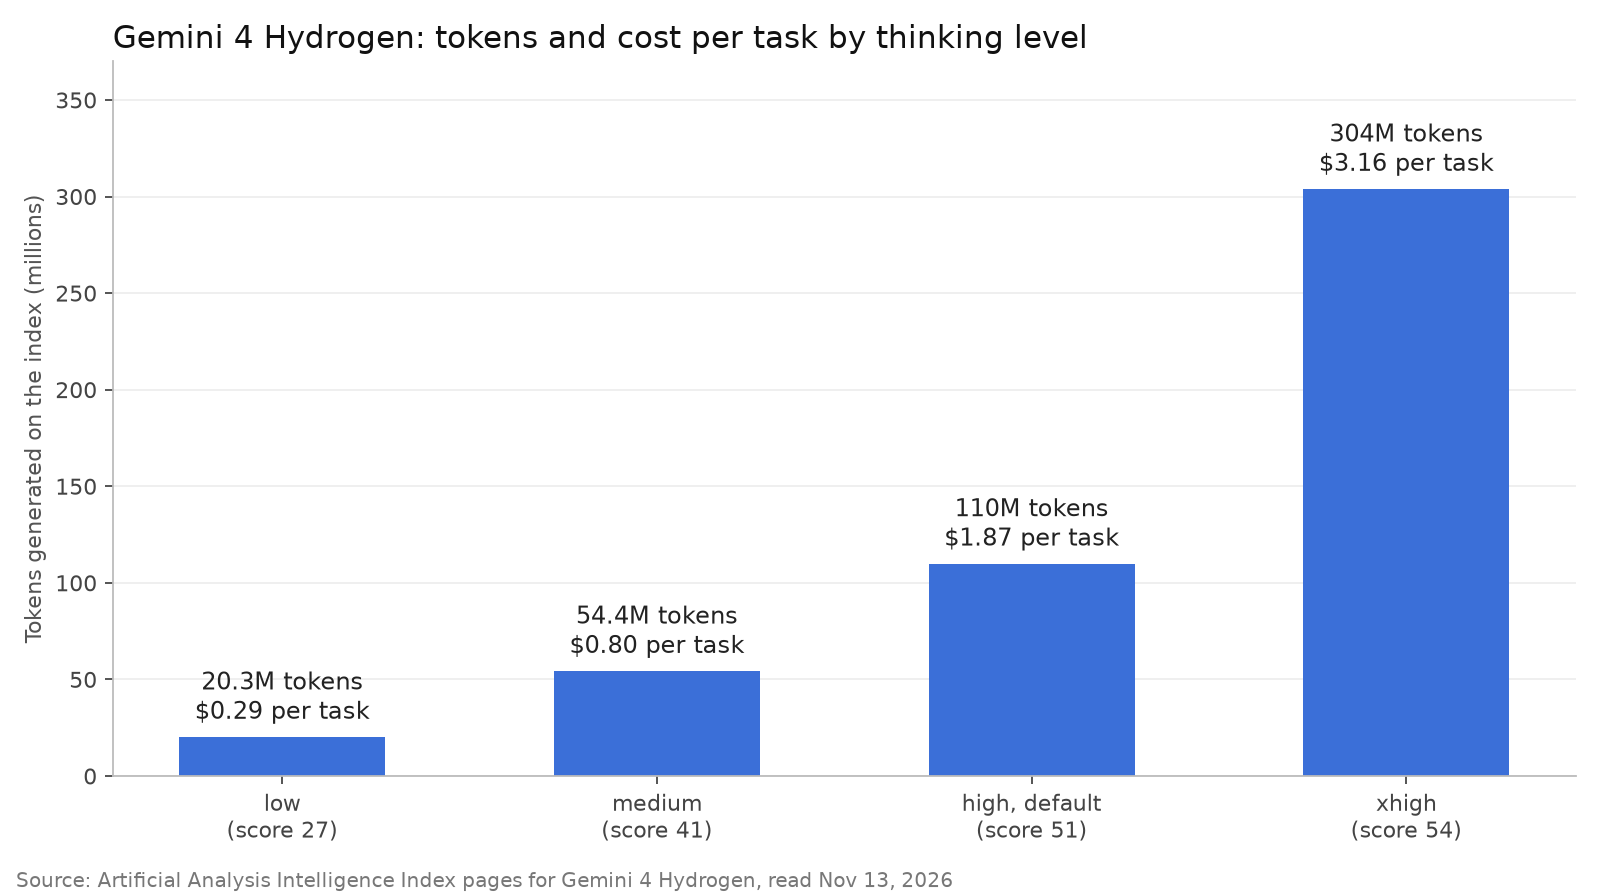
Lee la tabla como proporciones. Pasar de high a xhigh generó alrededor de 2.8 veces más tokens y aumentó el costo por tarea unas 1.7 veces, a cambio de 3 puntos más en el índice. Bajar de high a low redujo los tokens a menos de una quinta parte.
La página Novedades de Gemini 4 Hydrogen de Google advierte que xhigh "puede provocar sobrepensamiento en prompts más simples" y recomienda elegir "el thinking_level más bajo que cumpla tu estándar de calidad". Ten en cuenta que max_output_tokens limita el thinking y la salida en conjunto.
¿Cuánto cuesta una llamada a Gemini 4 Hydrogen?
Cada solicitud sigue una única fórmula. Extrae los conteos de tokens del objeto usage en la respuesta (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens):
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
Los dos ejemplos siguientes usan conteos de tokens ilustrativos, no mediciones reales. Sustitúyelos por los tuyos.
Ejemplo 1: una llamada de chat en high. 2,000 tokens de entrada, 1,500 tokens de thinking, 600 tokens de salida.
| Concepto | Standard | Batch o Flex |
|---|---|---|
| Entrada (2,000) | $0.0030 | $0.0015 |
| Thinking + salida (2,100) | $0.0158 | $0.0079 |
| Total por llamada | $0.0188 | $0.0094 |
| 10,000 llamadas al mes | $187.50 | $93.75 |
Ejemplo 2: un bucle de agente. Un agente de programación ejecuta 40 turnos. Reenvía la conversación en cada turno, así que lee 1.2M de tokens de entrada en total, y 900K de ellos aciertan en la caché implícita. Piensa durante 200K tokens y escribe 60K tokens de código y llamadas a herramientas.
| Concepto | Standard | Batch o Flex | Priority |
|---|---|---|---|
| Entrada sin caché (300K) | $0.45 | $0.23 | $0.81 |
| Entrada en caché (900K) | $0.07 | $0.03 | $0.12 |
| Thinking + salida (260K) | $1.95 | $0.98 | $3.51 |
| Total por ejecución | $2.47 | $1.23 | $4.44 |
Cerca del 79% de la factura en Standard corresponde a thinking y salida, así que el nivel de thinking importa más que recortar tu prompt. El código de solicitud de ambos ejemplos está en nuestra guía de la API de Gemini 4 Hydrogen.
¿Cómo se comparan los precios de Hydrogen con Carbon, Argon y Gemini 3.8 Flash?
Estas son las tarifas del nivel Standard de pago por millón de tokens según la página de precios de Google, consultada el 13 de noviembre de 2026:
| Modelo | Entrada | Salida | Entrada en caché | Nivel Free |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | Sí |
| Gemini 4 Carbon (hasta el 30 de nov.) | $2.00 | $10.00 | $0.10 | No |
| Gemini 4 Carbon (desde el 1 de dic.) | $4.00 | $20.00 | $0.20 | No |
| Gemini 4 Argon (hasta el 30 de nov.) | $2.00 | $10.00 | $0.10 | No |
| Gemini 4 Argon (desde el 1 de dic.) | $4.00 | $20.00 | $0.20 | No |
| Gemini 3.8 Flash (hasta el 31 de dic.) | $0.75 | $3.75 | $0.075 | Sí |
| Gemini 3.8 Flash (desde el 1 de enero de 2027) | $1.50 | $7.50 | $0.15 | Sí |
Si aplicas los conteos de tokens del bucle de agente del Ejemplo 2 a cada precio, obtienes $2.47 en Hydrogen, $3.29 en Carbon o Argon este mes y $6.58 a partir del 1 de diciembre, y $1.27 en Gemini 3.8 Flash hasta el 31 de diciembre. Cuando suba el precio de Flash el 1 de enero de 2027, los mismos tokens costarán $2.54 en Flash, algo más que en Hydrogen porque la tarifa de caché de Flash se duplica a $0.15. Para los detalles del cambio de precio de los modelos frontera, consulta nuestras guías de precios de Gemini 4 Carbon y precios de Gemini 4 Argon.
Aun así, la comparación real no son los mismos tokens, porque cada modelo gasta una cantidad distinta de tokens por tarea. Las páginas del Índice de Inteligencia de Artificial Analysis ofrecen una visión de esto:
| Modelo (nivel de thinking) | Puntuación del índice | Tokens generados | Costo por tarea del índice |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110M | $1.87 |
| Gemini 4 Hydrogen (xhigh) | 54 | 304M | $3.16 |
| Gemini 4 Argon (high) | 50 | 113M | $4.97 |
| Gemini 4 Carbon (high) | 60 | 205M | $5.48 |
| Gemini 3.8 Flash (high) | 31 | 126M | no comparado aquí |
En este benchmark, Hydrogen en su nivel predeterminado igualó la puntuación de Argon con cerca del 38% del costo por tarea de Argon, mientras que Carbon obtuvo la puntuación más alta. Tómalo como la visión de un solo benchmark. Google también indica que Hydrogen completa las tareas 2.5 veces más rápido que Gemini 3.8 Flash en el nivel high.
La división práctica: Hydrogen para programación y agentes del día a día, Carbon para arquitectura compleja, depuración y revisiones de seguridad. En Antigravity, la opción Orchestrator alterna entre Carbon y Hydrogen dentro de una misma ejecución. Nuestra comparación entre Gemini 4 Carbon y Argon cubre el lado de los modelos frontera.
¿Cómo reducir tu factura de Gemini 4 Hydrogen?
- Usa Batch o Flex para trabajos que pueden esperar. Ambos cuestan la mitad.
- Elige el nivel de thinking más bajo que pase tus evaluaciones.
mediumusó aproximadamente la mitad de los tokens dehigh. - Reserva
xhighpara los turnos difíciles. - Mantén un prefijo de prompt estable para que la caché implícita facture la entrada repetida a $0.075 por millón, un descuento del 95%.
- Prototipa en el nivel Free.
Mide tu costo real de Gemini 4 Hydrogen con Apidog CLI
Tu factura depende de tus propios prompts. La forma más rápida de obtener números reales es dejar que tu agente de programación (Claude Code, Codex, Cursor) ejecute tus prompts en cada nivel de thinking a través de Apidog CLI y registre el objeto usage de cada ejecución.
Configúralo una sola vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Coloca entre 5 y 10 de tus prompts reales en levels.csv, una fila por prompt y nivel de thinking, con las columnas prompt y thinking_level (low, medium, high, xhigh). Luego dale a tu agente un solo prompt:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
El agente comprueba la forma del payload antes de escribir nada, y luego ejecuta cada fila:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
El reporte JSON muestra cuánto cuesta cada nivel de thinking en tu carga de trabajo. Añade -r junit y el mismo comando se ejecuta en CI, donde una aserción de presupuesto de tokens puede hacer fallar el build. La guía de CI/CD de Apidog CLI muestra el pipeline, y Apidog CLI en Claude Code cubre la configuración del agente. El plan Free de Apidog cubre hasta 4 usuarios.
Un atajo: dile a tu agente "Lee https://apidog.com/apidog-cli-installation-guide.md y configura Apidog CLI."
FAQ
¿Gemini 4 Hydrogen es gratis? En la API, sí, dentro de los límites de velocidad del nivel Free: Google lista la entrada y salida de Standard como "Gratis" en el nivel Free. Batch, Flex y el grounding con Search requieren una clave de pago. Consulta nuestra guía de Gemini 4 Hydrogen gratis.
¿Subirá el precio de Gemini 4 Hydrogen como el de Carbon? La página de precios de Google lista una única tarifa de $1.50/$7.50 para Hydrogen, sin periodo de introducción ni fecha de vencimiento. Carbon y Argon tienen precios introductorios con fecha límite; Hydrogen no.
¿Se facturan los tokens de thinking de Gemini 4 Hydrogen? Sí, a la tarifa de salida de $7.50 por millón en Standard. El objeto usage de la respuesta los reporta por separado como total_thought_tokens.
¿Es Gemini 4 Hydrogen más barato que Gemini 3.8 Flash? Este año no: Flash cuesta $0.75/$3.75 hasta el 31 de diciembre de 2026. A partir del 1 de enero de 2027, Flash sube a $1.50/$7.50, la misma tarifa por token que Hydrogen, y Hydrogen obtuvo 51 frente a 31 de Flash en el índice de Artificial Analysis.