
La API de Gemini 4 Hydrogen usa el ID de modelo gemini-4-hydrogen. Se invoca con un POST a https://generativelanguage.googleapis.com/v1beta/interactions, con tu clave en la cabecera x-goog-api-key, y model más input en el cuerpo JSON. Está disponible en el nivel gratuito y en el de pago ($1.50 de entrada, $7.50 de salida por cada millón de tokens) y por defecto usa el nivel de razonamiento high.
Esta guía recorre todo el camino: la clave, la primera petición, el nivel de razonamiento, un PDF, function calling, streaming y manejo de errores. Cada nombre de campo proviene de la documentación de Google.
¿Qué necesitas antes de tu primera llamada a la API de Gemini 4 Hydrogen?
Necesitas una clave de API de Gemini, el ID de modelo gemini-4-hydrogen y el endpoint de Interactions. Google lanzó Hydrogen el 12 de noviembre de 2026 como el modelo rápido de Gemini 4 junto a Carbon y Argon (qué es Gemini 4 Hydrogen).
| Elemento | Valor |
|---|---|
| ID de modelo | gemini-4-hydrogen |
| Endpoint | POST /v1beta/interactions en generativelanguage.googleapis.com |
| Cabecera de autenticación | x-goog-api-key: $GEMINI_API_KEY |
| APIs | Interactions API y generateContent |
| Niveles de razonamiento | low, medium, high (predeterminado), xhigh |
| Ventana de contexto | 1.048.576 tokens, compartidos entre entrada, razonamiento y salida |
| Salida por ciclo síncrono | 65.536 tokens, con streaming o sin él |
| Nivel gratuito | Sí, con límites de tarifa |
| Precio de pago | $1.50 / 1M de entrada, $7.50 / 1M de salida (razonamiento incluido) |
| Entrada en caché | $0.075 / 1M mediante el almacenamiento en caché implícito |
La documentación de Google marca generateContent como heredado, así que estos ejemplos usan Interactions.
¿Cómo obtener una clave de API de Gemini para Hydrogen?
Hydrogen está en el nivel gratuito, así que puedes empezar sin activar la facturación:
- Abre la página de claves de API en Google AI Studio.
- Haz clic en Create API key. Las claves nuevas creadas en AI Studio son claves de autorización, vinculadas a una cuenta de servicio.
- Expórtala:
export GEMINI_API_KEY="TU_CLAVE_API". Los SDK leenGEMINI_API_KEYoGOOGLE_API_KEY; si ambas están definidas,GOOGLE_API_KEYtiene prioridad. - Un proyecto de Cloud creado fuera de AI Studio puede requerir verificación del proyecto antes de que funcione el nivel gratuito.
Google publica las cifras del nivel gratuito en su página de límites de tarifa, no en la guía de lanzamiento. Nuestra guía de Gemini 4 Hydrogen gratis cubre lo que obtienes a $0.
¿Cómo enviar tu primera petición a la API de Gemini 4 Hydrogen?
Envía model e input al endpoint de Interactions. Guarda el modelo en una variable para que cambiar de modelo sea un cambio de una sola línea.
export GEMINI_MODEL="gemini-4-hydrogen"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Write a Python function that retries an HTTP call with exponential backoff."
  }'
La misma llamada con el SDK de Python (pip install -U google-genai):
import os
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model=os.environ.get("GEMINI_MODEL", "gemini-4-hydrogen"),
    input="Write a Python function that retries an HTTP call with exponential backoff.",
)

print(interaction.output_text)
print(interaction.usage)
La respuesta incluye un id, un status y un array de steps. El texto vive en los pasos model_output, el razonamiento en los pasos thought, y el output_text del SDK une el texto por ti. El objeto usage contiene total_input_tokens, total_thought_tokens, total_output_tokens y total_tokens.
Estos fragmentos siguen la guía de inicio rápido de Google. No los ejecutamos para esta publicación (no teníamos clave de Gemini en nuestra máquina de pruebas), así que verifica la estructura con tu propia primera respuesta.
¿Cómo configurar el nivel de razonamiento de Gemini 4 Hydrogen?
Configura thinking_level dentro de generation_config. Hydrogen usa high por defecto, añade un nuevo nivel xhigh y rechaza minimal con un error.
thinking_level |
Uso de tokens | Uso sugerido por Google |
|---|---|---|
low |
Menos tokens, menor latencia | Chat rápido, procesamiento de alto rendimiento |
medium |
Menos tokens, más rápido | Programación interactiva, prototipado de UI en vivo, llamadas rápidas a herramientas |
high (predeterminado) |
Equilibrado | Programación compleja, ejecución agéntica, trabajo con documentos multimodales |
xhigh |
Más tokens, razonamiento más profundo | Problemas difíciles de varios pasos donde high se queda corto |
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "medium",
      "max_output_tokens": 65536
    }
  }'
Dos reglas importan. max_output_tokens limita el razonamiento y la salida juntos, así que un límite antiguo y bajo (digamos 8.192) puede cortar las respuestas; Google recomienda subirlo a 65.536 y bajar el nivel de razonamiento en su lugar. Y los tokens de razonamiento se facturan a la tarifa de salida de $7.50, así que xhigh cuesta más incluso cuando la respuesta visible tiene la misma longitud. El análisis de precios de Gemini 4 Hydrogen hace los cálculos por nivel.
Google también indica que el servidor ignora temperature, top_p y top_k en Hydrogen, así que elimínalos de tus peticiones.
¿Cómo enviar un PDF a Gemini 4 Hydrogen?
Añade un elemento document al array de input, junto a un elemento text con tu instrucción. Para archivos pequeños, envía el PDF en línea como base64:
PDF_PATH="invoice.pdf"
B64=$(base64 < "$PDF_PATH" | tr -d '\n')

curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": [
      {"type": "document", "data": "'"$B64"'", "mime_type": "application/pdf"},
      {"type": "text", "text": "Extract the line items as a table."}
    ]
  }'
Para archivos más grandes o reutilización entre turnos, sube el archivo una vez con la Files API (gratis, se conserva 48 horas) y pasa {"type": "document", "uri": "<file uri>", "mime_type": "application/pdf"} en su lugar. Según la guía de procesamiento de documentos, los PDF pueden tener hasta 50 MB o 1.000 páginas, y el modelo lee los gráficos, tablas e imágenes que contienen, no solo el texto.
¿Cómo funciona el function calling con Gemini 4 Hydrogen?
Declara tu función en tools. El modelo no ejecuta nada; devuelve un paso function_call, tu código ejecuta la función, y tú devuelves un function_result. Aquí está el primer paso, de la guía de function calling de Google:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "What'\''s the temperature in London?",
    "tools": [{
      "type": "function",
      "name": "get_current_temperature",
      "description": "Gets the current temperature for a given location.",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "The city name"}
        },
        "required": ["location"]
      }
    }]
  }'
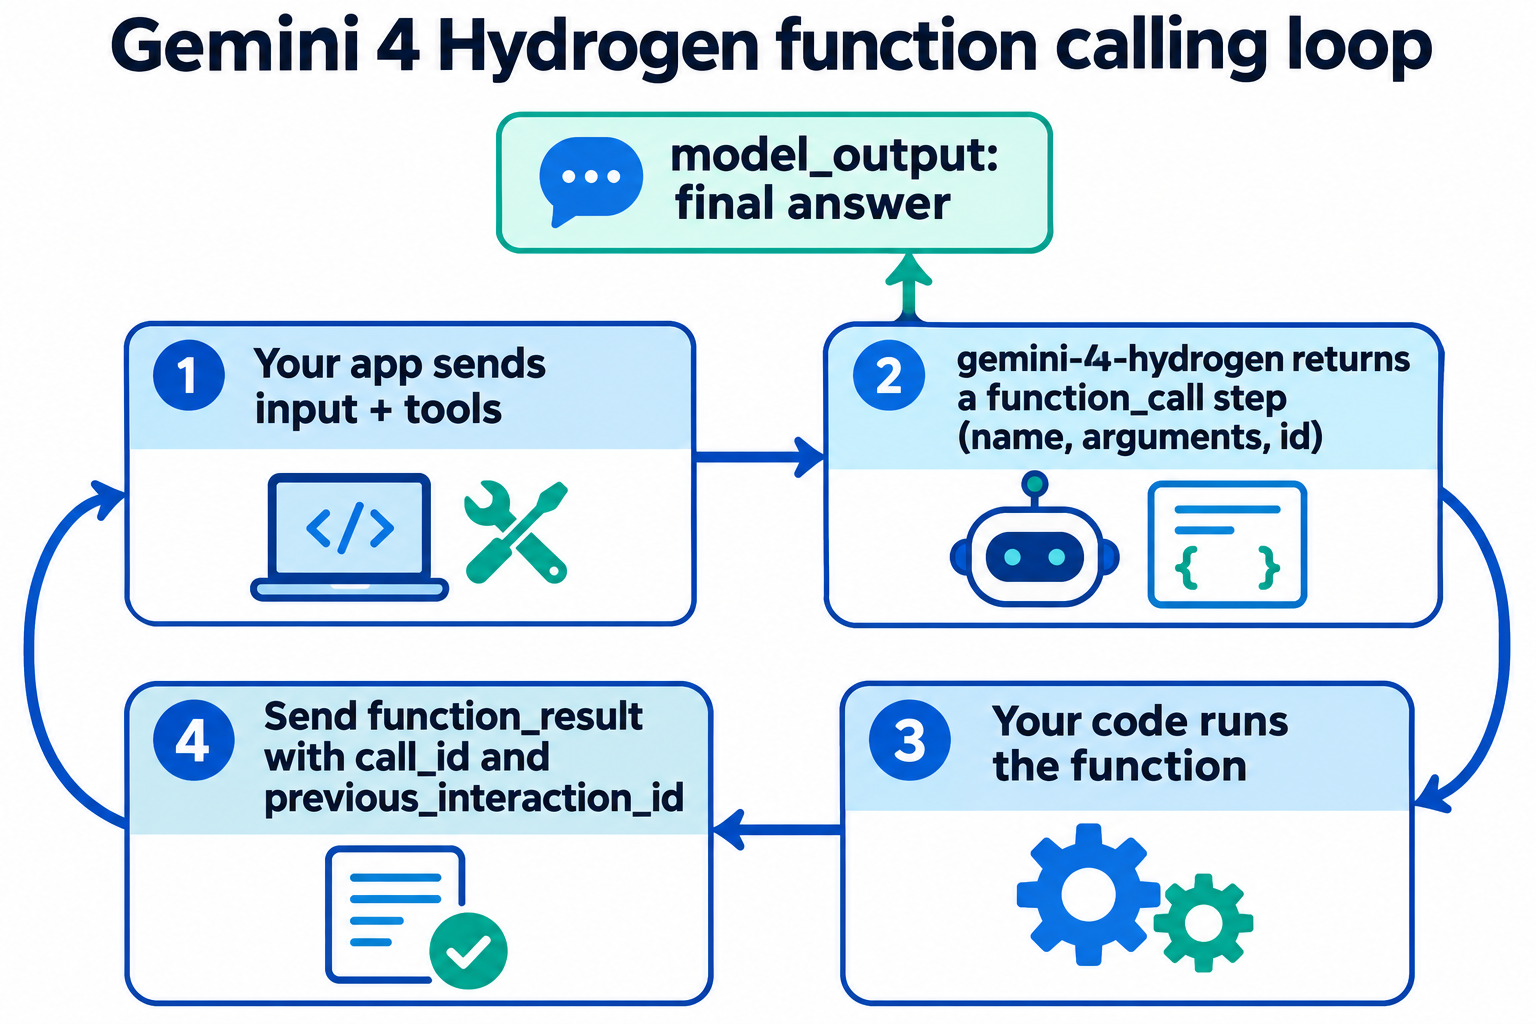
Busca el paso donde type sea function_call y lee su name, arguments e id. Ejecuta tu función y luego devuelve el resultado en la misma sesión:
fc = next(s for s in interaction.steps if s.type == "function_call")
result = get_current_temperature(**fc.arguments)

final = client.interactions.create(
    model="gemini-4-hydrogen",
    input=[{
        "type": "function_result",
        "name": fc.name,
        "call_id": fc.id,
        "result": [{"type": "text", "text": json.dumps(result)}],
    }],
    tools=[weather_function],
    previous_interaction_id=interaction.id,
)
print(final.output_text)
previous_interaction_id mantiene el estado de la conversación y del razonamiento en el lado de Google, así que no tienes que reenviar el historial. Una advertencia de las notas de migración de Google: pedirle al modelo que imprima «llamadas a herramientas» en JSON puro sin herramientas declaradas puede devolver MALFORMED_FUNCTION_CALL. Declara las herramientas de forma nativa o usa salidas estructuradas.
¿Cómo hacer streaming de las respuestas de Gemini 4 Hydrogen?
Añade "stream": true al cuerpo. La API responde con Server-Sent Events:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  --no-buffer \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain idempotency keys in three short paragraphs.",
    "stream": true
  }'
Según la guía de streaming de Google, recibes interaction.created, luego step.start, step.delta y step.stop para cada paso (thought, luego model_output), y finalmente interaction.completed con el usage final. Concatena delta.text de los pasos model_output para construir la respuesta. El streaming no eleva el límite: cada ciclo sigue deteniéndose en los 65.536 tokens. Para salidas más largas, configura "background": true con max_output_tokens por encima de 65.536 y consulta GET /v1beta/interactions/{id} hasta que status deje de ser in_progress o queued.
¿Cómo manejar los errores de la API de Gemini 4 Hydrogen?
Los errores sin streaming llegan como un código de estado HTTP más un objeto error con code y message. En un stream, recibes un evento error con los mismos campos. Los códigos que más encontrarás, según la página de errores de la API de Google:
| HTTP | code |
Qué hacer |
|---|---|---|
| 400 | invalid_request |
Corrige el payload; comprueba los nombres de campo contra la documentación |
| 403 | permission_denied |
Revisa los permisos de la clave, la verificación o la facturación |
| 404 | model_not_found |
Comprueba que la cadena del modelo sea gemini-4-hydrogen |
| 429 | rate_limit_exceeded |
Espera y reintenta |
| 429 | quota_exceeded |
Cuota diaria alcanzada; espera el reinicio |
| 503 | service_unavailable |
Espera y reintenta |
La guía de solución de problemas de Google recomienda reintentar solo 429, 408 y 5xx, con retroceso exponencial más jitter y un límite de reintentos, y nunca 400, 402 ni 403. El SDK de Python ya reintenta los errores transitorios hasta cuatro veces.
Deja que tu agente de programación pruebe la API de Hydrogen con Apidog CLI
En lugar de leer JSON después de cada prompt o cambio de nivel de razonamiento, deja que tu agente de programación (Claude Code, Codex, Cursor) construya una prueba repetible y la ejecute con Apidog CLI.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING (default "low"). Add an endpoint for POST /v1beta/interactions with the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-hydrogen", a short prompt and generation_config.thinking_level
{{THINKING}}, and asserts: HTTP 200, status is "completed", steps contains a
non-empty model_output, and usage.total_tokens exists. Run it at low and at high,
then compare usage.total_thought_tokens.
El agente verifica cada payload contra los esquemas de la CLI antes de escribir nada:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=low" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=high" -r cli,json
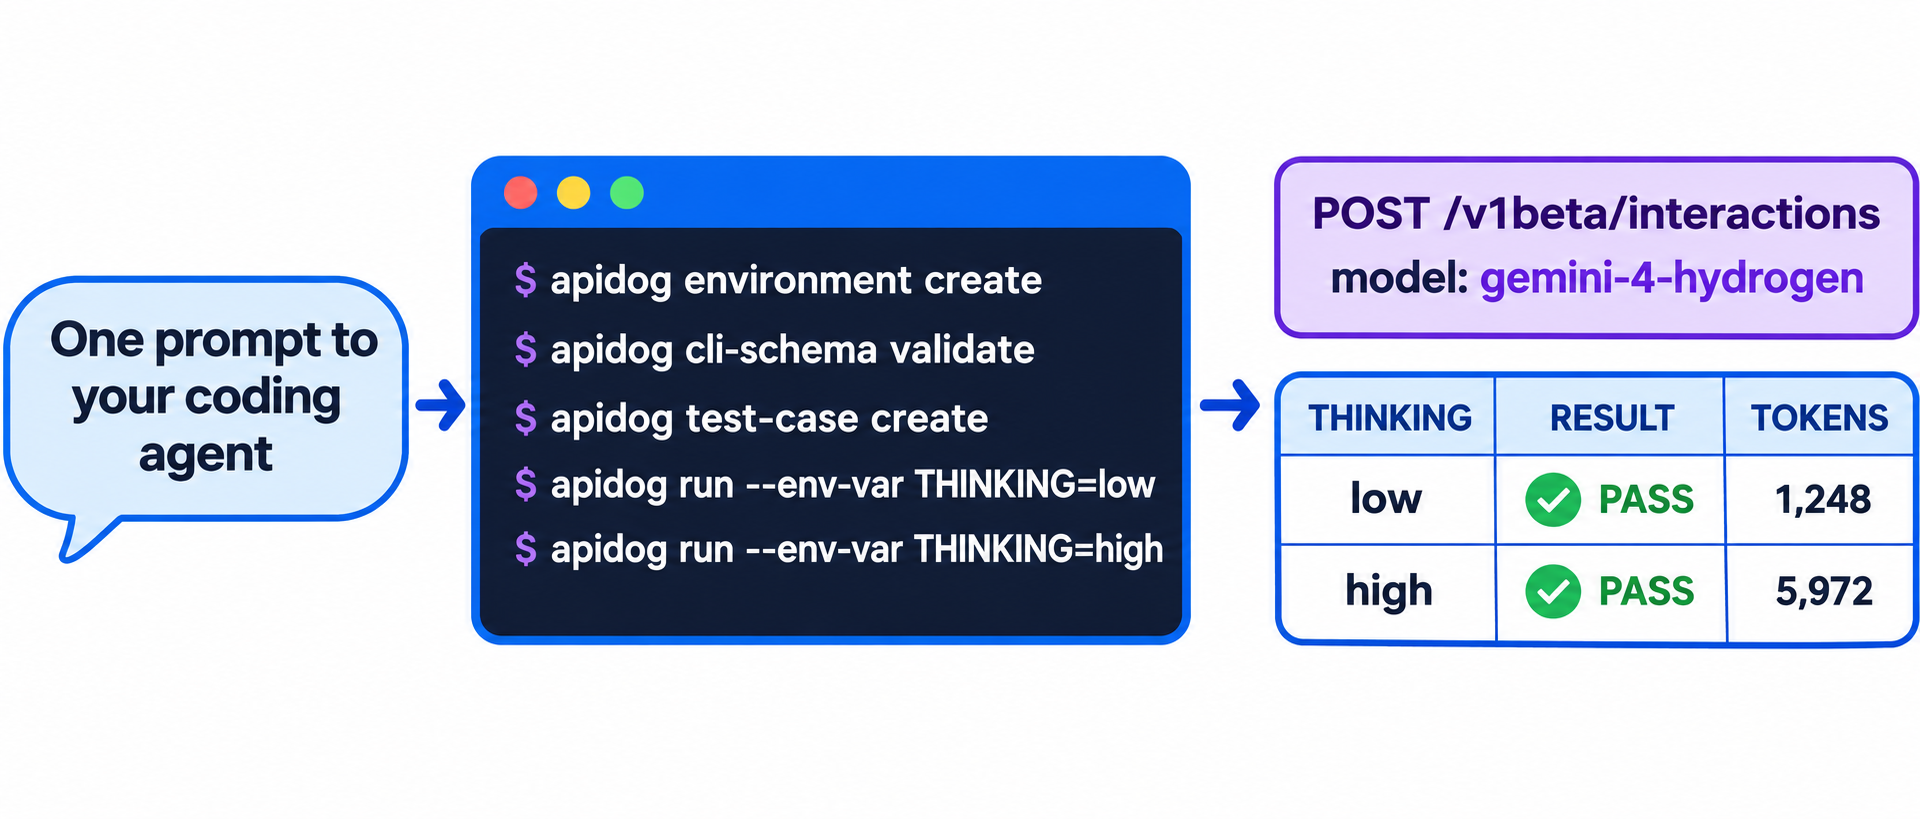
Las dos ejecuciones comparan los tokens de razonamiento para el mismo prompt, la cifra que mueve tu factura. Cambia -r cli,json por -r junit y la misma ejecución se integra en CI; la guía de CI/CD de Apidog CLI muestra el pipeline y Apidog CLI en Claude Code cubre la configuración del agente. El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Cuál es el ID de modelo de Gemini 4 Hydrogen? gemini-4-hydrogen. Funciona con la Interactions API y con generateContent.
¿La API de Gemini 4 Hydrogen es gratuita? Sí, dentro de ciertos límites. Google incluye Hydrogen en el nivel gratuito de la API de Gemini y de AI Studio, con límites de tarifa. El uso de pago cuesta $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida.
¿Cómo migro desde Gemini 3.8 Flash? Cambia la cadena del modelo, sube los límites bajos de max_output_tokens, elimina temperature, top_p, top_k y el almacenamiento en caché explícito (cachedContents), y sustituye el razonamiento minimal por low o medium.
¿Hydrogen admite el almacenamiento en caché de contexto? Solo el caché implícito. Se ejecuta por defecto en prompts de al menos 4.096 tokens y aplica un descuento del 95 % en los aciertos de caché. El caché explícito no está disponible.
¿En qué se diferencia Hydrogen de Gemini 4 Argon en la API? El mismo esquema de petición. Hydrogen usa high por defecto y añade xhigh, mientras que Argon usa medium por defecto. Consulta la guía de la API de Gemini 4 Argon, la guía de la API de Gemini 4 Carbon y Gemini 4 Hydrogen Orchestrator para combinar modelos.