
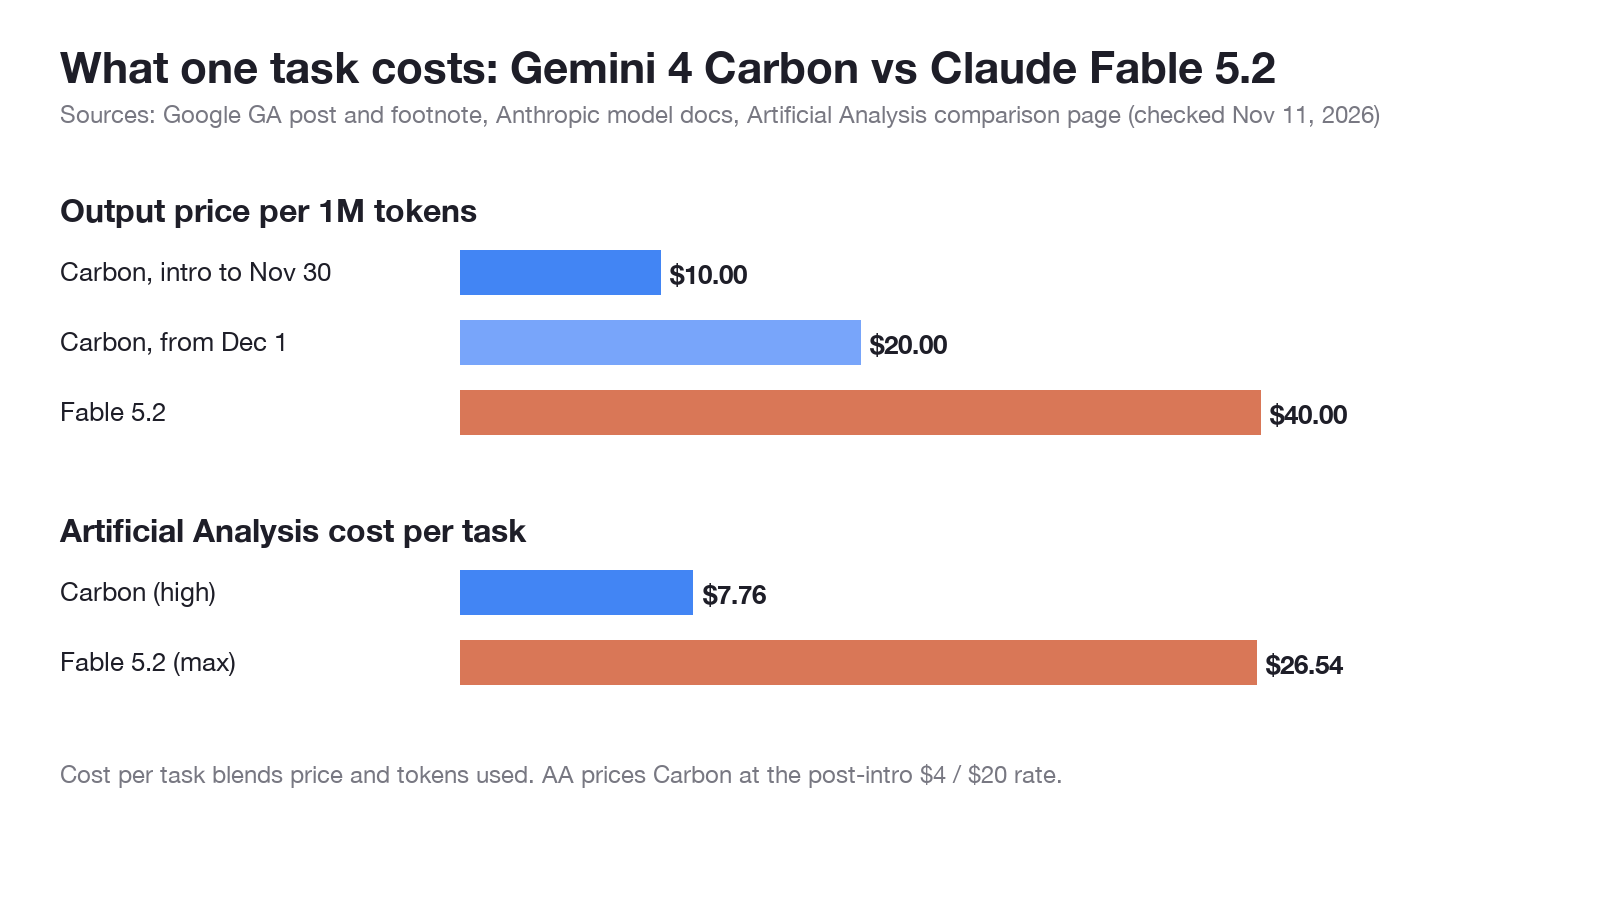
A fecha de 11 de noviembre de 2026, el Gemini 4 Carbon de Google es el modelo más barato y el Claude Fable 5.2 es el más potente en la mayoría de los benchmarks publicados de programación y agentes. Carbon tiene un precio de lista de $2 / $10 por cada 1M de tokens de entrada/salida hasta el 30 de noviembre (luego $4 / $20), y Fable 5.2 cuesta $8 / $40; según Artificial Analysis, el costo de una tarea es de $7.76 frente a $26.54.
Los dos se lanzaron con un día de diferencia (Fable 5.2 el 9 de noviembre y Carbon en GA el 10 de noviembre), y la tabla de cada proveedor favorece a su propio modelo. Esta guía desglosa cada cifra según quién la midió y, después, te muestra cómo hacer una prueba A/B de ambos con tus propias solicitudes.
Gemini 4 Carbon vs Claude Fable 5.2: el veredicto rápido
Elige Gemini 4 Carbon cuando el costo por tarea sea lo más importante, para flujos de automatización de negocio o para trabajo de seguridad. Elige Claude Fable 5.2 cuando necesites la puntuación más alta en tareas difíciles de programación, de terminal y de uso de ordenador, y puedas pagar unas 3.4 veces más por tarea. Para la ingeniería del día a día, ambos proveedores te recomiendan primero un modelo por defecto más económico.
La publicación de GA de Google dice que «Argon sigue siendo la opción ideal para la mayoría del trabajo de ingeniería de software y del conocimiento», y posiciona a Carbon para las tareas más difíciles, en las que gasta más tokens explorando y verificando. La documentación de modelos de Anthropic dice lo mismo con sus propias palabras: empieza con Claude Opus 5.5 para la mayoría de las cargas de trabajo y pasa a Fable 5.2 para razonamiento exigente y trabajo agéntico de largo alcance.
Así que acudes a cualquiera de los dos cuando tu modelo por defecto se queda corto. ¿Sigues eligiendo un modelo por defecto? Lee primero Gemini 4 Carbon vs Argon.
¿Cómo se comparan Gemini 4 Carbon y Claude Fable 5.2 en precio y especificaciones?
Aquí están los datos que publica cada proveedor, con la fuente de cada fila.
| Especificación | Gemini 4 Carbon | Claude Fable 5.2 | Fuente |
|---|---|---|---|
| ID del modelo | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Lanzamiento | GA el 10 de noviembre de 2026 | 9 de noviembre de 2026 | Google, Anthropic |
| Precio de entrada por 1M de tokens | $2 hasta el 30 de noviembre, luego $4 | $8 ($16 en modo rápido) | Nota al pie de Google, Anthropic |
| Precio de salida por 1M de tokens | $10 hasta el 30 de noviembre, luego $20 | $40 ($80 en modo rápido) | Nota al pie de Google, Anthropic |
| Ventana de contexto | 1M de tokens | 1M de tokens | Ficha del modelo en AI Studio, documentación de Anthropic |
| Salida máxima | 65K / 1M según lo indicado [VERIFICAR] | 128K tokens | Ficha del modelo en AI Studio, documentación de Anthropic |
| Razonamiento | Nivel de razonamiento configurable | Adaptativo, siempre activo, esfuerzo predeterminado high |
Guía de inicio rápido de Google, documentación de Anthropic |
| Dónde obtenerlo | Nivel de pago de la API de Gemini, AI Studio, Android Studio, Gemini para empresas, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Nivel gratuito de API | Ninguno indicado | Ninguno indicado | Google, Anthropic |
La publicación de GA de Google no menciona Vertex AI, Gemini CLI ni GitHub Copilot, así que no planifiques en torno a ellos por ahora. El precio de lanzamiento de Carbon coincide con el de Argon, lo que hace de noviembre el mes más barato para ejecutar tu evaluación.
Para ver las tarifas completas, consulta los precios de Claude Fable 5.2 y el anuncio de Gemini 4 Carbon de Google.
¿Qué modelo gana en los benchmarks?
Depende de qué tabla leas, así que aquí tienes tres tablas separadas.
La tabla de Anthropic (publicada con Fable 5.2)
La publicación de lanzamiento de Fable 5.2 de Anthropic incluye una columna para Gemini 4 Carbon. La página no indica quién ejecutó las cifras de Carbon, así que trátalas como datos reportados por el proveedor.
| Benchmark (tabla de Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1% (esfuerzo xhigh) | 41.1% (esfuerzo medium) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1 (conjunto sin conexión, parcial) | 89.3% | 81.5% |
| AA-Briefcase v1.1 (rúbrica) | 66.1% | 61.8% |
| Chartography (sin herramientas) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
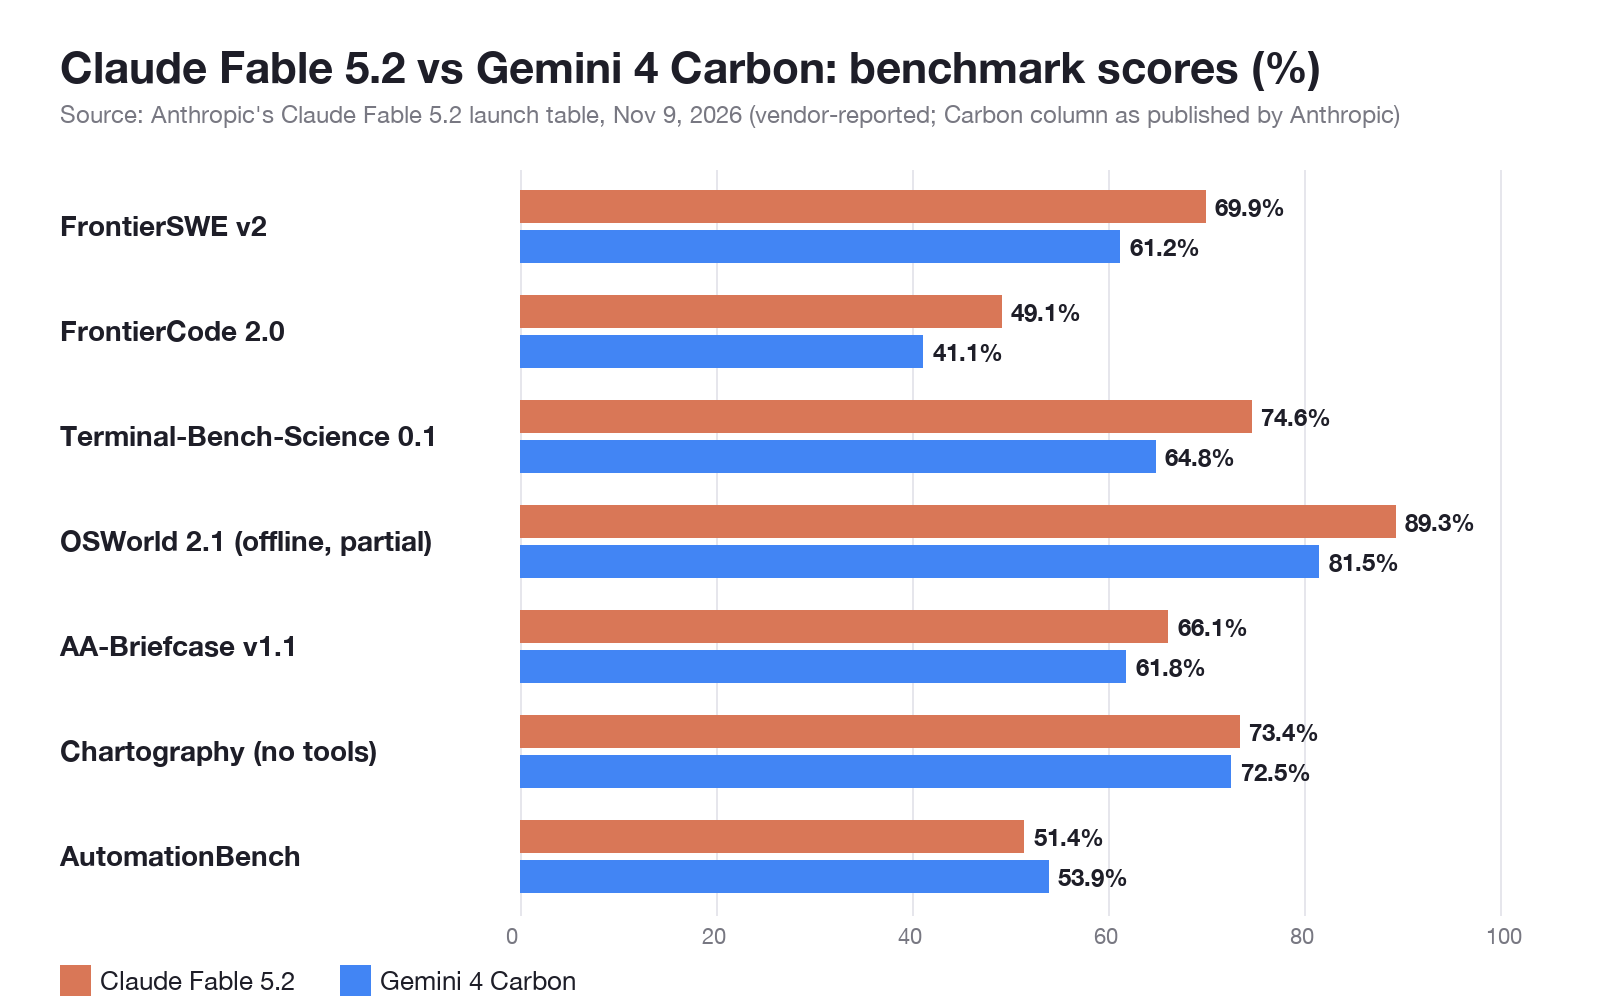
Fíjate en la fila de FrontierCode: Fable se ejecutó con esfuerzo xhigh y Carbon con medium. Esa diferencia de configuración importa tanto como la diferencia de puntuaciones.
La tabla de Google (publicada con el GA de Carbon)
Google no publica una comparación directa con Fable 5.2. En su lugar, informa de clasificaciones de socios: Carbon ocupa el primer puesto en CursorBench 4.0, WANDR de Perplexity y AutomationBench de Zapier «con más de 2 veces menos costo por tarea en comparación con el siguiente mejor modelo externo». Ocupa el segundo puesto en el benchmark Multimodal Knowledge Agent con más de 6 veces menos costo promedio por tarea que el modelo líder. Google no nombra a los modelos rivales en esas afirmaciones.
Artificial Analysis (independiente)
La página de comparación de Artificial Analysis ejecuta ambos modelos con el mismo Intelligence Index v5.0.1:
| Métrica (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Índice de inteligencia | 65 | 60 |
| Costo por tarea | $26.54 | $7.76 |
| Costo de ejecutar el índice completo | $22,191 | $8,240 |
| Velocidad de salida | 103 tokens/s | 82 tokens/s |
Fable 5.2 (max) ocupa hoy el primer puesto de ese índice. Carbon puntúa 5 puntos menos a aproximadamente el 29 % del costo por tarea. Artificial Analysis evalúa Carbon con los precios de $4 / $20, la tarifa posterior a noviembre, de modo que sus cifras de costo ya reflejan el precio de diciembre.
¿Dónde gana Claude Fable 5.2?
Fable 5.2 gana en las tareas más difíciles de programación y uso de ordenador, según las cifras de Anthropic:
- Programación a escala de repositorio: 69.9 % frente a 61.2 % en FrontierSWE v2.
- Trabajo de terminal e investigación: 74.6 % frente a 64.8 % en Terminal-Bench-Science 0.1.
- Uso de ordenador: 89.3 % frente a 81.5 % en OSWorld 2.1.
- Índice independiente: 65 frente a 60 en Artificial Analysis, la única puntuación que ninguno de los dos proveedores ejecutó.
- Longitud de salida: una salida máxima documentada de 128K tokens por solicitud.
Si una tarea fallida le cuesta a un ingeniero una tarde, una ganancia de 8 puntos en FrontierSWE puede compensar la factura de tokens. Para la configuración, consulta la guía de la API de Claude Fable 5.2.
¿Dónde gana Gemini 4 Carbon?
Carbon gana en costo por tarea y en las cargas de trabajo para las que Google lo creó:
- Costo por tarea: $7.76 frente a $26.54 en Artificial Analysis, unas 3.4 veces más barato.
- Automatización de negocio: 53.9 % frente a 51.4 % en AutomationBench, según la propia tabla de Anthropic.
- Seguridad: lidera en SEC-bench Pro, ExploitGym y CWE-bench v1 según Google, y ofrece un modelo Carbon para ciberseguridad con acceso restringido para defensores a través del programa Fairwind.
- Precio en noviembre: $2 / $10 hasta el 30 de noviembre, un cuarto de la tarifa de Fable tanto en entrada como en salida.
- Equipos de agentes: la vista previa /swarm en Google Antigravity convierte un solo prompt en un equipo coordinado, con Carbon planificando y auditando mientras modelos más ligeros trabajan en paralelo.
¿No conocías el modelo? Empieza con qué es Gemini 4 Carbon.
¿Cuánto cuesta realmente una tarea?
El precio de lista te indica la tarifa, no la factura. El costo de una tarea es el precio por los tokens que el modelo decide gastar, y Google dice que Carbon gasta más tokens explorando y verificando.
Toma una solicitud con 50,000 tokens de entrada y 10,000 tokens de salida:
- Carbon, tarifa de lanzamiento: (0.05 x $2) + (0.01 x $10) = $0.20
- Carbon, a partir del 1 de diciembre: (0.05 x $4) + (0.01 x $20) = $0.40
- Fable 5.2: (0.05 x $8) + (0.01 x $40) = $0.80
Esto supone que ambos emiten 10,000 tokens. No lo harán. Si Carbon escribe 30,000 tokens de razonamiento donde Fable escribe 10,000, el costo de Carbon en diciembre sube a $0.80 y la diferencia se reduce. Artificial Analysis midió el caso real en toda su suite y aun así encontró que Carbon es unas 3.4 veces más barato por tarea, que es la señal más fiable que tienes hasta que hagas tus propias mediciones.
¿Cómo hacer una prueba A/B de Gemini 4 Carbon y Claude Fable 5.2 con tus propias solicitudes?
Los benchmarks son las tareas de otros. La prueba justa envía el mismo prompt a ambas APIs y registra los tokens y la latencia en paralelo.
Ambas llamadas son HTTP sencillo. Aquí tienes la solicitud de Carbon, construida a partir de la guía de inicio rápido de Google para la API de Interactions, con el nombre del modelo en una variable:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 funciona a través de la API de Messages de Anthropic con claude-fable-5-2 como modelo.
Deja que tu agente de programación ejecute la prueba A/B con Apidog CLI
Ejecutar pares de solicitudes a mano cansa rápido. Deja que Claude Code, Codex o Cursor manejen Apidog CLI. La configuración requiere tres comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # elige tu agente cuando se te pida
Luego dale a tu agente un solo prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
El agente comprueba el esquema, escribe los casos y los ejecuta. Las opciones siguientes provienen de apidog run --help en la CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 repite cada caso cinco veces, para que una respuesta lenta no decida el resultado. Añade --upload-report para ver las ejecuciones en la aplicación de Apidog. Esta es una plantilla de flujo de trabajo; no la hemos ejecutado contra Carbon desde esta máquina. La guía de Apidog CLI en Claude Code cubre la configuración del agente, y la guía de la API de Gemini 4 Argon cubre la parte de la solicitud a Gemini.
El plan gratuito de Apidog cubre hasta 4 usuarios, suficiente para ejecutar esta comparación.
Preguntas frecuentes
¿Es Gemini 4 Carbon mejor que Claude Fable 5.2?
No en todo. Fable 5.2 puntúa más alto en la mayoría de los benchmarks de Anthropic y en el índice de Artificial Analysis (65 frente a 60). Carbon gana en costo por tarea ($7.76 frente a $26.54) y en AutomationBench.
¿Cuánto más barato es Gemini 4 Carbon que Claude Fable 5.2?
A precio de lista, Carbon es 4 veces más barato hasta el 30 de noviembre de 2026 ($2 / $10 frente a $8 / $40 por 1M de tokens) y 2 veces más barato a partir del 1 de diciembre ($4 / $20). Medido por tarea por Artificial Analysis, es unas 3.4 veces más barato.
¿Tienen ambos modelos una ventana de contexto de 1M de tokens?
Sí. La ficha del modelo de Google AI Studio indica 1M de tokens para Carbon, y la documentación de Anthropic indica 1M de tokens para Fable 5.2. La salida máxima de Fable es de 128K tokens; consulta la guía para desarrolladores de Google para conocer el límite exacto de salida de Carbon.
¿Hay un nivel gratuito para Gemini 4 Carbon o Claude Fable 5.2 en la API?
Ninguno de los dos proveedores indica que lo haya. Carbon está en el nivel de pago de la API de Gemini y en las aplicaciones de Google AI Ultra; Fable 5.2 se factura por token.
¿Debería cambiar mi modelo por defecto a cualquiera de los dos?
Probablemente no. Google dice que Argon sigue siendo la opción correcta para la mayoría del trabajo de ingeniería de software y del conocimiento, y Anthropic recomienda Opus 5.5 para la mayoría de las cargas de trabajo. Enruta solo hacia Carbon o Fable las tareas en las que tu modelo por defecto falle, y compara los resultados con tus propias solicitudes.