A partir del 11 de noviembre de 2026, la API de Gemini 4 Carbon de Google usa el ID de modelo gemini-4-carbon y cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida hasta el 30 de noviembre de 2026, y después 4 $ y 20 $. Google lo puso a disposición general el 10 de noviembre de 2026, solo en el nivel de pago de la API de Gemini.
Esta guía te lleva desde una clave recién creada hasta tu primera petición, te muestra qué números de uso determinan tu factura y deja las pruebas en manos de tu agente de programación.
¿Cuál es el ID de modelo de Gemini 4 Carbon?
El ID de modelo de Gemini 4 Carbon es gemini-4-carbon. Lo pasas como campo model en una petición al endpoint de Interactions de la API de Gemini, en el SDK de Python o JavaScript, o en un prompt de Google AI Studio. Google describe Carbon como su modelo de razonamiento más potente y lo recomienda para tareas difíciles, mientras que Gemini 4 Argon sigue siendo la opción predeterminada para el trabajo cotidiano.
Para más información sobre el modelo en sí, empieza por qué es Gemini 4 Carbon.
| Elemento | Valor | Fuente |
|---|---|---|
| ID de modelo | gemini-4-carbon |
Documentación de Google AI Studio |
| Disponible desde | 10 de noviembre de 2026 | Publicación de lanzamiento de Google |
| Dónde | Nivel de pago de la API de Gemini, Google AI Studio, Android Studio | Publicación de lanzamiento de Google |
| Nivel gratuito | No disponible | Documentación de Google AI Studio |
| Ventana de contexto | 1.048.576 tokens, compartidos entre entrada, razonamiento y salida | Documentación de Google AI Studio |
| Salida máxima por respuesta síncrona | 65.536 tokens | Documentación de Google AI Studio |
| Decodificación larga | Hasta 1 M de tokens menos tu entrada, con background: true |
Documentación de Google AI Studio |
| Niveles de razonamiento | low, medium (predeterminado), high |
Documentación de Google AI Studio |
| Precio hasta el 30 de noviembre de 2026 | 2 $ de entrada, 10 $ de salida por 1 M de tokens | Publicación de lanzamiento de Google |
| Precio desde el 1 de diciembre de 2026 | 4 $ de entrada, 20 $ de salida por 1 M de tokens | Publicación de lanzamiento de Google |
| Entrada en caché (caché implícita) | 0,10 $ por 1 M, luego 0,20 $ desde el 1 de diciembre | Documentación de Google AI Studio |
¿Cómo obtener una clave de la API de Gemini para Gemini 4 Carbon?
Carbon solo funciona en el nivel de pago, así que una clave por sí sola no basta. Necesitas una clave en un proyecto con Cloud Billing vinculado:
- Abre la página de claves de API en Google AI Studio. A los usuarios nuevos se les crea automáticamente un proyecto y una clave; en caso contrario, haz clic en Crear clave de API.
- Haz clic en Configurar facturación en la página de claves de API o de Proyectos.
- Crea o vincula una cuenta de Cloud Billing, añade un método de pago y prepaga al menos 5 $ en créditos, según la guía de inicio rápido de Google.
- Exporta la clave en tu terminal:
export GEMINI_API_KEY="YOUR_API_KEY".
La publicación sobre las opciones gratuitas de Gemini 4 Carbon cubre las rutas que no necesitan ninguna clave de API.
¿Cómo enviar tu primera petición a la API de Gemini 4 Carbon?
La guía de inicio rápido de Google para Carbon usa la API de Interactions: un POST a /v1beta/interactions con model e input en el cuerpo. Pon el nombre del modelo en una variable para que cambiar entre Carbon y Argon más adelante sea un cambio de una sola línea.
Con curl:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
Con el SDK de Python (pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
Ambos fragmentos siguen los ejemplos de la documentación de Google. No los ejecutamos para este artículo, ya que no disponemos de una clave de pago de Carbon en esta máquina, así que comprueba la forma de la respuesta con tu primera llamada propia.
Tres detalles de las notas de migración de Google te ahorran una sesión de depuración:
- Elimina los parámetros de muestreo. Carbon ignora
temperature,top_pytop_k, así que quítalos. - Aumenta los tiempos de espera. Los prompts difíciles pueden tardar varios minutos. Google sugiere la ejecución en segundo plano o tiempos de espera HTTP de al menos 15 minutos.
- Guarda el estado en el servidor. Pasa
previous_interaction_idpara chats de varios turnos y llamadas a funciones en lugar de reenviar el historial.
¿Ya usas Argon? Nuestra guía de la API de Gemini 4 Argon usa la misma estructura de petición.
¿Cómo leer los tokens de uso y de razonamiento en la respuesta?
Cada interacción devuelve un objeto usage. Estos son los campos que importan para el coste:
total_input_tokens: lo que enviaste, incluidas las instrucciones del sistema y las declaraciones de herramientas.total_thought_tokens: los tokens que el modelo gastó razonando antes de responder.total_output_tokens: la respuesta visible.total_tokens: la suma.
El que hay que vigilar es total_thought_tokens. Según la guía de razonamiento de Google, el precio de la respuesta es la suma de los tokens de salida y los tokens de razonamiento, por lo que el razonamiento se factura a la tarifa de salida de 10 $. Google también indica que Carbon «gasta más tokens de razonamiento» por turno que Argon para explorar y verificar su trabajo. En un prompt difícil, el razonamiento puede ser la mayor parte de la factura.
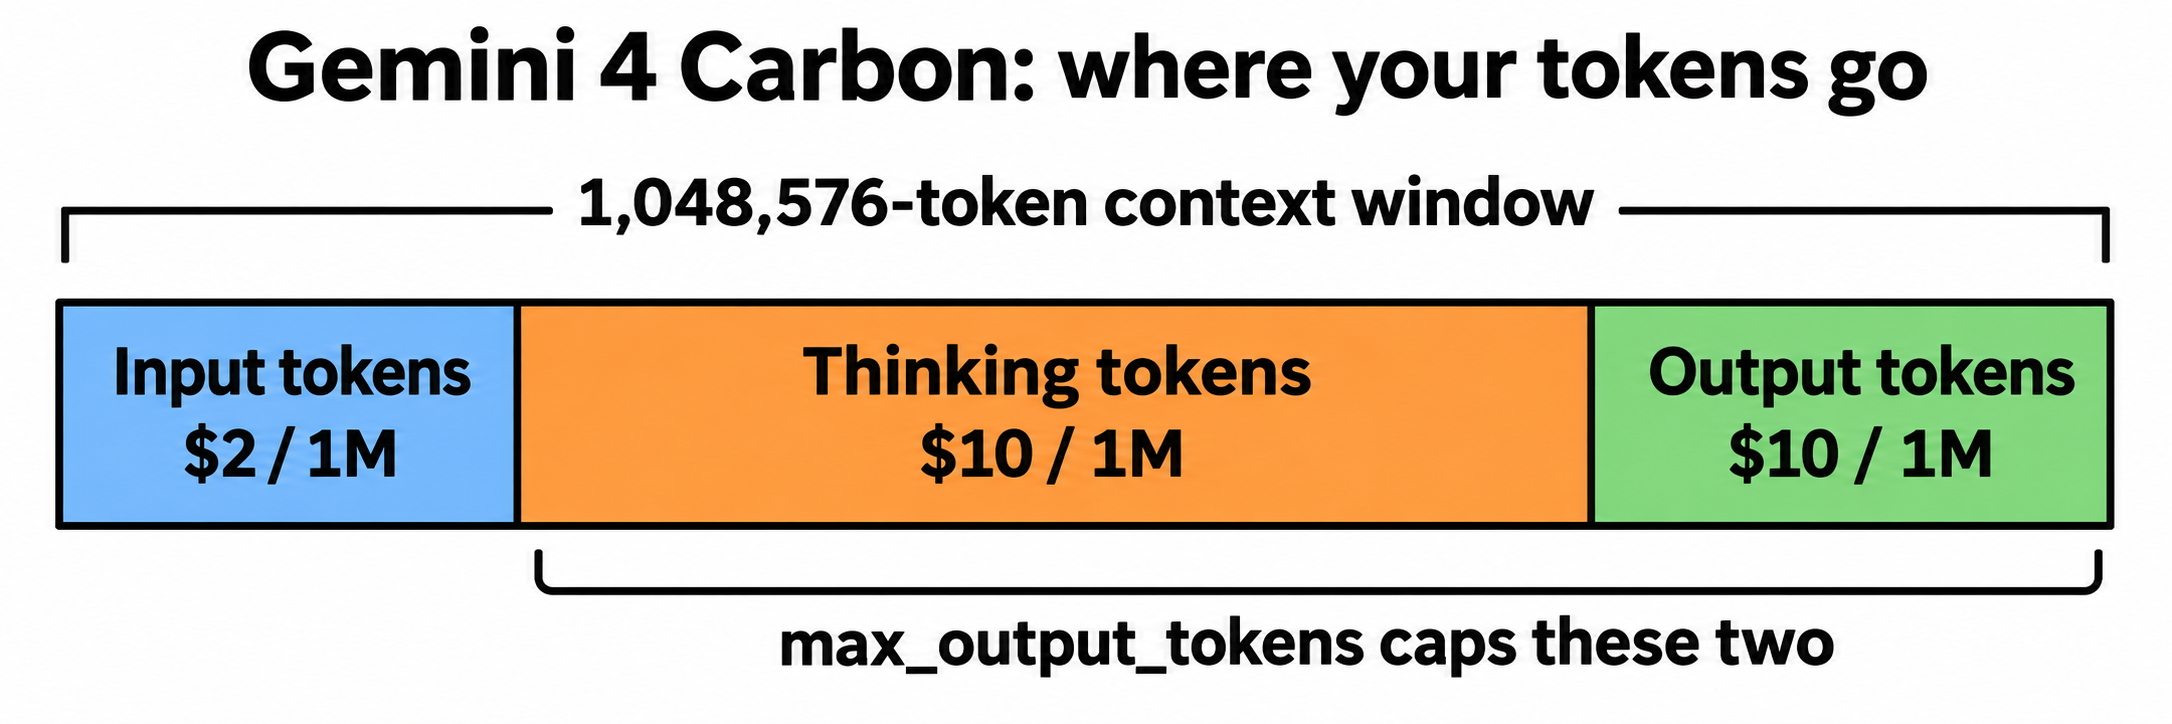
max_output_tokens limita la suma de razonamiento y salida. Si lo configuras demasiado bajo, Carbon puede agotar el presupuesto razonando y truncar la respuesta. Los puntos de partida de Google:
- Tareas estándar: mantén el valor predeterminado de 65.536.
- Aplicaciones con un límite inferior a 32 K: súbelo al menos a 32.768.
- Razonamiento complejo y programación: configura
background: truey 131.072 o 262.144 tokens.
Con background: true, los servidores de Google continúan la respuesta en saltos de 64 K tokens. Consultas la interacción hasta que su estado deja de ser in_progress o queued, y luego unes el texto de cada paso model_output.
¿Qué nivel de razonamiento de Gemini 4 Carbon deberías usar?
El nivel de razonamiento es tu control principal sobre calidad, latencia y gasto. La orientación de Google, según la guía de razonamiento y la documentación de Carbon:
| Nivel de razonamiento | Uso de tokens | Úsalo para |
|---|---|---|
low |
Menos tokens, menor latencia | Tareas simples y sensibles al coste, análisis y redacción ligeros |
medium (predeterminado) |
Equilibrado | La mayoría de las tareas, incluidos código complejo y trabajo con agentes |
high |
Más tokens, primer token más lento | Matemáticas y ciencias difíciles, y las tareas de código o de agentes más complicadas |
Google recomienda ejecutar tus evaluaciones en los tres niveles y quedarte con el más bajo que cumpla tu umbral de calidad. En Carbon, la diferencia entre low y high es donde se va tu presupuesto.
¿Cuándo deberías enviar una tarea a Gemini 4 Carbon en lugar de Argon?
Google es claro en este punto: «Argon sigue siendo la opción ideal para la mayoría del trabajo de ingeniería de software y de conocimiento». Ambos modelos comparten la ventana de contexto de 1 M, las herramientas integradas y el mismo precio de lanzamiento por token, así que la diferencia está en cuántos tokens gasta cada uno por turno. Usa Carbon para depuración compleja de causas raíz, diseño de arquitectura, síntesis multimodal densa, demostraciones y auditorías de seguridad. Mantén Argon para programación interactiva, funciones cotidianas y ciclos rápidos de producción. Nuestra comparación de Gemini 4 Carbon frente a Argon profundiza en el tema, y si estás sopesando Carbon frente al modelo más reciente de Anthropic, consulta Gemini 4 Carbon vs Claude Fable 5.2 y la guía de la API de Claude Fable 5.2.
¿Cuánto cuesta una llamada a la API de Gemini 4 Carbon?
Gemini 4 Carbon cuesta 2 $ por 1 M de tokens de entrada y 10 $ por 1 M de tokens de salida (razonamiento incluido) hasta el 30 de noviembre de 2026, y después 4 $ y 20 $, según Google.
Para ponerlo en una llamada, toma una petición ilustrativa con 2.000 tokens de entrada, 6.000 tokens de razonamiento y 1.500 tokens de salida. Estos son números de ejemplo, no una medición:
- Entrada: 2.000 x 2 $ / 1 M = 0,004 $
- Razonamiento más salida: 7.500 x 10 $ / 1 M = 0,075 $
- Total: unos 0,079 $ hoy, unos 0,158 $ a partir del 1 de diciembre
El razonamiento varía mucho según el prompt, así que consulta tu propio objeto usage. Para el cálculo completo de precios, el salto de diciembre y el coste por tarea, consulta precios de Gemini 4 Carbon.
Deja que tu agente de programación pruebe la API de Carbon con Apidog CLI
Cambiarás niveles de razonamiento, límites de salida y prompts muchas veces. En lugar de inspeccionar el JSON a mano tras cada cambio, deja que tu agente de programación (Claude Code, Codex, Cursor) escriba una prueba repetible y la ejecute con Apidog CLI.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
Usar low en la prueba mantiene cada ejecución barata. El agente lee los esquemas, valida sus payloads y ejecuta el caso:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
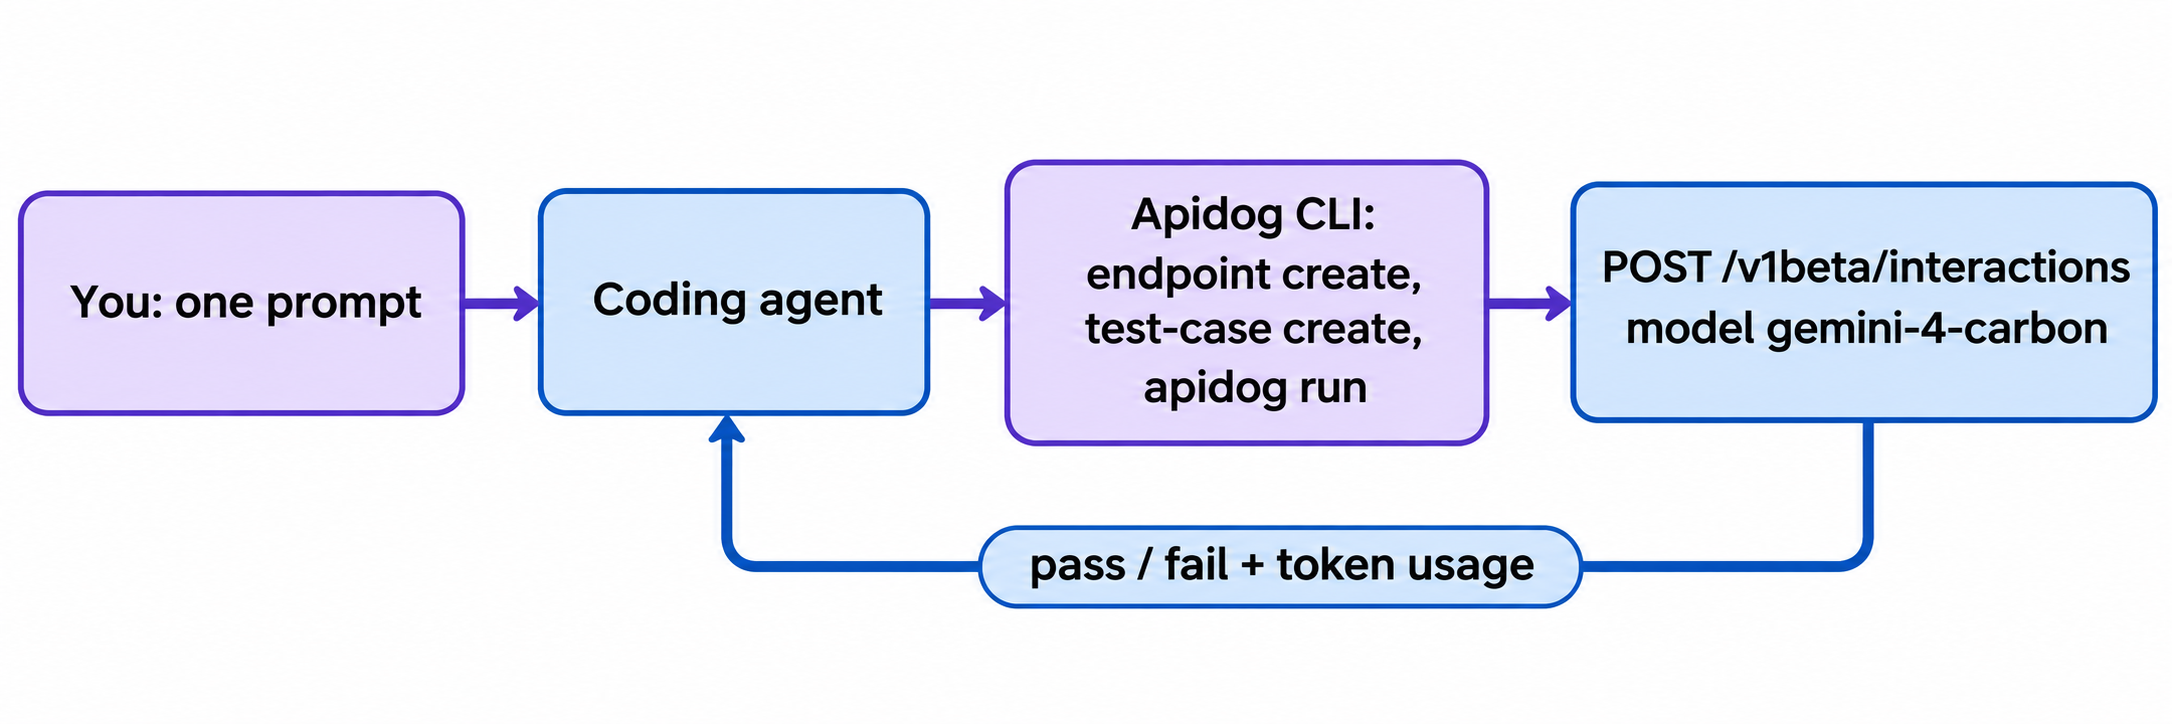
La aserción del presupuesto de tokens es la más útil. Si un cambio en el prompt hace que el razonamiento supere tu límite, la prueba falla antes de que crezca la factura. Cambia -r cli,json por -r junit y el mismo comando se ejecuta en CI; la guía de CI/CD de Apidog CLI muestra el pipeline, y Apidog CLI en Claude Code explica la configuración del agente paso a paso. El plan gratuito de Apidog cubre hasta 4 usuarios.
Si quieres que el agente configure todo desde cero, dile: «Lee https://apidog.com/apidog-cli-installation-guide.md y configura Apidog CLI».
Preguntas frecuentes
¿La API de Gemini 4 Carbon es gratuita? No. La documentación de Google indica que Gemini 4 Carbon no está disponible en el nivel gratuito de la API de Gemini. Necesitas un proyecto de nivel de pago con Cloud Billing y al menos 5 $ en créditos prepagados. En el lado del consumidor, Google está lanzando Carbon para los suscriptores de Google AI Ultra en la app de Gemini, AI Mode y Antigravity.
¿Está Gemini 4 Carbon en Vertex AI? La publicación de lanzamiento de Google menciona la API de Gemini, Google AI Studio, Android Studio, Gemini para empresas, Antigravity y CodeMender. No menciona Vertex AI, así que revisa la lista de modelos de Google Cloud antes de planificar en torno a ello.
¿Cuál es la ventana de contexto de Gemini 4 Carbon? 1.048.576 tokens, compartidos entre entrada, razonamiento y salida. Una respuesta síncrona se detiene en 65.536 tokens; con ejecución en segundo plano, una respuesta puede llegar hasta 1 M de tokens menos tu entrada.
¿Puedo usar generateContent en lugar de la API de Interactions? La guía de inicio rápido de Carbon usa la API de Interactions, y su documentación menciona la API GenerateContent para la continuación de decodificación larga en el lado del cliente. Si tu aplicación ya usa generateContent, prueba el cambio de ID de modelo ahí antes de migrar.
¿Cómo cambio de Gemini 4 Argon a Carbon? Cambia la cadena del modelo de gemini-4-argon a gemini-4-carbon. Google afirma que no se necesitan cambios en el esquema de la petición. Aumenta max_output_tokens y tus tiempos de espera HTTP, ya que Carbon razona durante más tiempo, y mantén thinking_level en medium salvo que una tarea necesite high.