
Gemini 4 Argon cuesta $2 por 1 millón de tokens de entrada y $10 por 1 millón de tokens de salida durante un período introductorio, luego $4 y $20. La entrada en caché tiene un 95% de descuento sobre el precio de entrada, lo que equivale a $0.10 por 1 millón de tokens con la tarifa introductoria y $0.20 después. Google no ha dicho cuánto dura el período introductorio, y aún no se puede comprar Argon: se ha anunciado pero no está disponible de forma general, y hoy se está implementando solo para los ciberdefensores del Programa Fairwind.
Esta publicación convierte esa hoja de precios en cifras presupuestarias: una comparación con siete modelos actuales, cuatro escenarios trabajados, el costo por tarea de terceros y los controles de costos a configurar ahora. Para el modelo en sí, comience con qué es Gemini 4 Argon; para el acceso, consulte si Gemini 4 Argon es gratis. Puede crear aserciones de costos en Apidog contra un modelo que puede llamar hoy e intercambiar el nombre del modelo más tarde.
La hoja de precios
Google publicó los precios en la publicación de lanzamiento de Gemini 4 Argon, con la tarifa posterior al período introductorio en la nota al pie 1: "Una vez que expire el período introductorio, se aplicará el precio de $4 por 1 millón de tokens de entrada y $20 por 1 millón de tokens de salida".
| Gemini 4 Argon, por 1 millón de tokens | Introducción | Estándar (después de la introducción) |
|---|---|---|
| Entrada | $2.00 | $4.00 |
| Entrada en caché (95% de descuento sobre la entrada) | $0.10 | $0.20 |
| Salida | $10.00 | $20.00 |
| Salida máxima por respuesta (Google) | 1M de tokens | 1M de tokens |
| Costo de una salida completa de 1M de tokens | $10.00 | $20.00 |
Las tarifas en caché son aritméticas de la regla del 95% de Google ($2 x 0.05 y $4 x 0.05). Google no ha publicado una ventana de contexto de entrada ni una ID de modelo. Dice que el límite de salida es de 1M de tokens, "subiendo desde los 64K tokens anteriores"; al menos un evaluador de terceros, Vals AI, enumera una salida máxima de 262K para la configuración que probó.
Argon vs. modelos actuales de frontera y Gemini
Todos los precios son por 1 millón de tokens.
| Modelo | Entrada | Entrada en caché | Salida | Salida máxima |
|---|---|---|---|---|
| Gemini 4 Argon (introducción) | $2 | $0.10 | $10 | 1M |
| Gemini 4 Argon (estándar) | $4 | $0.20 | $20 | 1M |
| GPT-6 Astra | $10 | $1 | $50 | 128,000 |
| Claude Opus 5.5 | $4 | $0.20 | $20 | 128K (300K en Batch, beta) |
| Claude Sonnet 5.5 | $2 | $0.20 | $10 | 128K (300K en Batch, beta) |
| GPT-6.1 Sol | $2 | $0.10 | $10 | 128,000 |
| Claude Fable 5.1 | $10 | $0.25 | $50 | 128K |
| gemini-3.1-pro-preview (prompt <=200K / >200K) | $2 / $4 | $0.20 / $0.40 | $12 / $18 | 65,536 |
| gemini-3.8-flash (introducción / desde 01-01-2027) | $0.75 / $1.50 | $0.075 / $0.15 | $3.75 / $7.50 | 65,536 |
Los precios de la competencia provienen de las propias páginas de los proveedores: la página de GPT-6 Astra de OpenAI, la página de precios de Anthropic y la página de precios de la API de Gemini de Google.
- Argon estándar = Claude Opus 5.5. Mismos $4/$20, misma entrada en caché de $0.20.
- Argon introductorio = Claude Sonnet 5.5 y GPT-6.1 Sol. Mismos $2/$10; la tarifa en caché introductoria de $0.10 coincide con GPT-6.1 Sol.
- GPT-6 Astra y Claude Fable 5.1 cuestan 5 veces más que Argon introductorio y 2.5 veces más que Argon estándar. Consulte los precios de Claude Fable 5.1.
- La salida introductoria de Argon ($10) está por debajo de la de gemini-3.1-pro-preview ($12), el modelo Pro superior anterior de Google.
- Los prompts largos cambian los cálculos. OpenAI cobra los prompts de más de 272K tokens de entrada a 2x la entrada y caché y 1.5x la salida para la solicitud completa. Gemini 3.1 Pro cobra más por encima de 200K; Anthropic no. Google no ha dicho si Argon tiene un nivel para prompts largos.
Para conocer la capacidad junto con el precio, consulte Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5.
Los tokens de "pensamiento" se facturan como salida
En los modelos Gemini actuales, los tokens de "pensamiento" se facturan como salida: la documentación de pensamiento de Google dice "el precio de respuesta es la suma de los tokens de salida y los tokens de pensamiento". Google no ha documentado Argon específicamente, pero se debe contar con la misma regla. Google ejecutó las evaluaciones de Argon "con la configuración de pensamiento más alta", por lo que "10$ por 1 millón de tokens de salida" debe interpretarse como la respuesta más el razonamiento.
Cuatro escenarios trabajados
Cada cifra a continuación es tokens divididos por 1M, multiplicados por la tarifa por 1M. Los escenarios 1 a 3 asumen que no hay almacenamiento en caché.
1. Una llamada API típica: 20K de entrada, 5K de salida
- Introducción: 20,000 / 1M x $2 = $0.04 de entrada, más 5,000 / 1M x $10 = $0.05 de salida. Total $0.09.
- Estándar: $0.08 + $0.10 = $0.18.
Con 1,000 llamadas al día, eso es $90 introductorios o $180 estándar. La misma llamada cuesta $0.18 en Claude Opus 5.5, $0.45 en GPT-6 Astra ($0.20 + $0.25), $0.10 en gemini-3.1-pro-preview ($0.04 + $0.06), y aproximadamente $0.034 en gemini-3.8-flash a su tarifa introductoria ($0.015 + $0.019).
2. Un turno de agente largo: 200K de entrada, 50K de salida
- Introducción: 200,000 / 1M x $2 = $0.40, más 50,000 / 1M x $10 = $0.50. Total $0.90.
- Estándar: $0.80 + $1.00 = $1.80.
GPT-6 Astra cobraría $4.50 ($2.00 + $2.50). gemini-3.1-pro-preview cobra $1.00 ($0.40 + $0.60), pero 200K es su límite de nivel: los prompts más largos se facturan a $4/$18. Si Argon obtiene un nivel similar, los turnos más largos cuestan más.
3. Una respuesta con salida máxima: 1 millón de tokens de salida
Solo la salida es 1,000,000 / 1M x $10 = $10.00 en introducción y $20.00 en estándar. Añadiendo un prompt de 100K tokens ($0.20 introducción, $0.40 estándar) la llamada cuesta $10.20 o $20.40.
Ningún otro modelo en la tabla produce esto en una sola respuesta síncrona: los competidores tienen un límite de 128K, el anterior Gemini Pro de 65,536. Con la salida máxima de 262K listada por Vals, una respuesta completa cuesta aproximadamente $2.62 en introducción o $5.24 en estándar. El lado de ingeniería (tiempos de espera, streaming, pasarelas) se encuentra en los 1M tokens de salida de Gemini 4 Argon.
4. Un prompt en caché de 500K tokens reutilizado 10 veces
Supongamos que envía el mismo código base o conjunto de contratos de 500K tokens diez veces, con 5K tokens de salida cada vez. Asumamos que la primera llamada paga el precio completo de entrada para construir la caché y las nueve siguientes leen de ella.
| 10 llamadas, 500K de prompt, 5K de salida cada una | Introducción | Estándar |
|---|---|---|
| Entrada, sin caché (10 x 500K) | $10.00 | $20.00 |
| Entrada, en caché (1 completa + 9 en caché) | $1.00 + 9 x $0.05 = $1.45 | $2.00 + 9 x $0.10 = $2.90 |
| Salida (10 x 5K) | $0.50 | $1.00 |
| Total con caché | $1.95 | $3.90 |
| Total sin caché | $10.50 | $21.00 |
El almacenamiento en caché reduce la factura de entrada en un 85.5%. Dos advertencias: Google no ha dicho si Argon cobra por el almacenamiento en caché (gemini-3.1-pro-preview cobra $4.50 por 1 millón de tokens por hora, lo que añadiría $2.25 para mantener 500K tokens durante una hora), y un prompt de 500K supera el límite de 200K de 3.1 Pro. La tarifa en caché estándar de Argon coincide con los $0.20 de Opus 5.5, por lo que la lógica de punto de equilibrio en las matemáticas de costos de almacenamiento en caché de prompts de Claude Opus 5.5 se mantiene.
El precio por token no es el costo por tarea
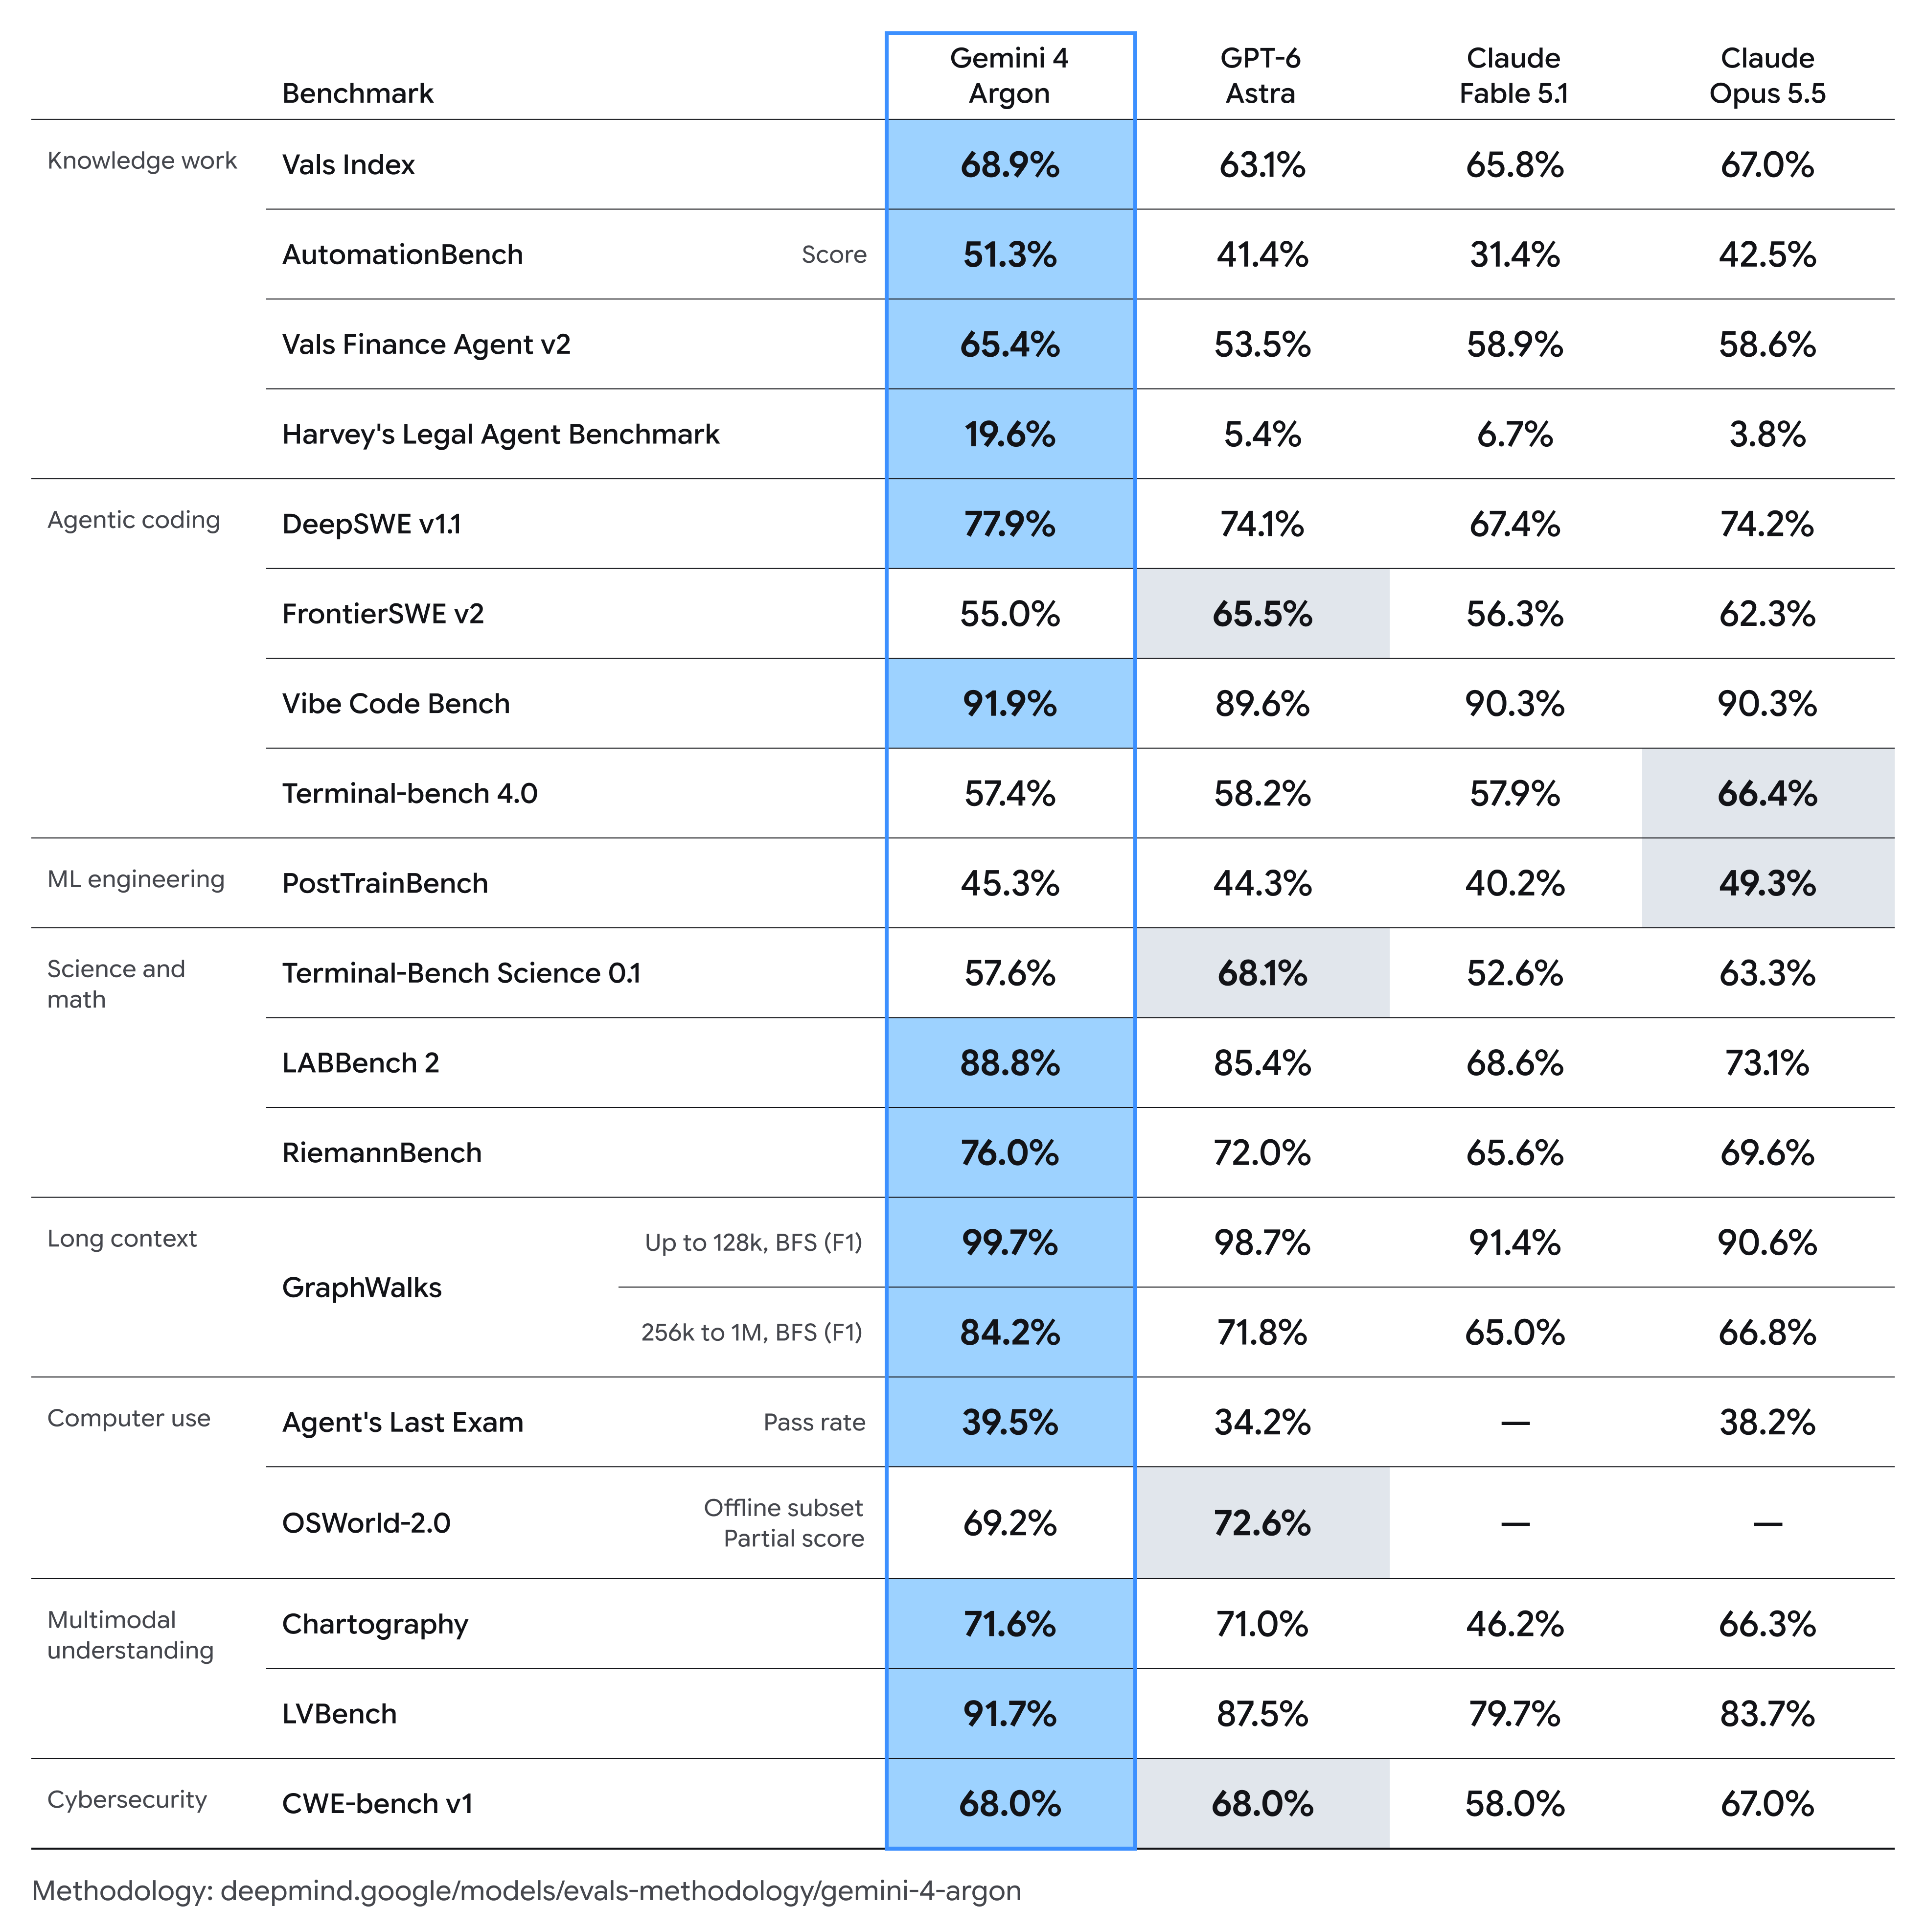
Artificial Analysis lista $1.99 por tarea para ejecutar su Índice de Inteligencia en Gemini 4 Argon (Alto) a precios introductorios; The Decoder sitúa la misma ejecución en $3.98 a precios estándar. AA califica a Argon con 53, lo mismo que GPT-6 Astra (máximo), que lista en $3.26 por tarea.
La clave es el volumen de tokens. AA cuenta aproximadamente 62K tokens de salida por tarea para Argon (alto) frente a aproximadamente 27K para Astra en su configuración máxima, aproximadamente 2.3 veces más. Salida por tarea en introducción: 62,000 / 1M x $10 = $0.62, vs 27,000 / 1M x $50 = $1.35 para Astra. En estándar, la cifra de tarea completa de The Decoder para Argon ($3.98) se sitúa por encima de los $3.26 de AA para Astra (máximo), a pesar de que las tarifas estándar de Argon son un 60% inferiores a las de Astra.
Vals AI muestra el mismo patrón. Lista $15.68 por prueba para Argon en el Índice Vals, frente a $32.14 para Claude Opus 5.5, $21.34 para Claude Sonnet 5.5 y $3.24 para GPT-6.1 Sol, y lista a Argon con la tarifa estándar de $4/$20. Sonnet 5.5 y GPT-6.1 Sol comparten el precio introductorio de Argon en teoría, sin embargo, sus costos por prueba difieren en más de 6 veces.
Presupueste a partir de sus propios recuentos de tokens, no de la lista de tarifas.
Controles de costos a configurar antes de que se lance Argon
- Limite la salida. En generateContent, `generationConfig.maxOutputTokens` establece un límite. Google dice que los nuevos modelos se lanzan en la API de interacciones, así que establezca el límite equivalente allí una vez que la documentación lo liste para Argon. Un límite de 1M es un límite de salida de $20 por llamada a tarifas estándar.
- Almacene en caché el contenido estable. Las instrucciones del sistema, los esquemas y los documentos de referencia que se repiten en las llamadas son donde el descuento del 95% vale la pena.
- Elija el nivel de pensamiento a propósito. Google no ha publicado los niveles de Argon. Hoy, gemini-3.1-pro-preview se establece por defecto en `high` y gemini-3.8-flash en `medium`. Cuando se documenten los de Argon, pruebe si un nivel inferior mantiene la calidad en su tarea.
- Afirme el uso. Cada respuesta de generateContent termina con `usageMetadata`. En Apidog, guarde la solicitud con el modelo en una variable de entorno `GEMINI_MODEL`, agregue una aserción posterior a la respuesta que calcule el costo a partir del recuento de tokens en `usageMetadata`, y haga que la prueba falle cuando una llamada supere su límite. Ejecútelo hoy contra gemini-3.8-flash; cuando se envíe la ID de Argon, cambie una variable y vuelva a ejecutar el conjunto de pruebas.
La aritmética para esa aserción:
cost = uncached_input / 1,000,000 x input_rate
     + cached_input   / 1,000,000 x cached_rate
     + (output + thinking) / 1,000,000 x output_rate
Lo que Google aún no ha puesto precio
La duración del período introductorio y la fecha en que comienzan los $4/$20; si los prompts de más de 200K cuestan más; precios de Batch o Flex (3.1 Pro tiene ambos, a $1/$2 de entrada y $6/$9 de salida); tarifas de almacenamiento en caché; límites de tasa; y si hay algún nivel gratuito.
Preguntas frecuentes
¿Cuánto cuesta Gemini 4 Argon por millón de tokens? $2 de entrada y $10 de salida durante el período introductorio, luego $4 y $20. La entrada en caché tiene un 95% de descuento: $0.10, luego $0.20.
¿Cuánto dura el precio introductorio? Google no lo ha dicho. La publicación de lanzamiento no especifica una fecha de finalización ni una duración.
¿Se facturan los tokens de "pensamiento" como salida? En los modelos Gemini actuales, sí. Google no ha documentado las reglas de Argon específicamente.
¿Cuánto cuesta una respuesta de salida de 1 millón de tokens? $10 con precio introductorio y $20 con precio estándar, antes de la entrada.
¿Es Argon más barato que Claude Opus 5.5 o GPT-6 Astra? Por token, el Argon estándar equivale a Opus 5.5 y se sitúa un 60% por debajo de Astra. Por tarea, depende del volumen de tokens: Artificial Analysis midió que Argon usa aproximadamente 2.3 veces los tokens de salida de Astra. Para un Gemini más barato hoy, consulte los precios de Gemini 3.8 Flash.
¿Puedo pagar por Argon hoy? No. Se está implementando solo para los socios del Programa Fairwind. Los clientes de API de pago y los suscriptores de Google AI Ultra son los siguientes, sin fecha.
Presupuéstate ahora, mídelo después
Multiplique el recuento de tokens de su tráfico actual por $2/$10 y $4/$20, y obtendrá el rango introductorio y estándar de Argon.
Luego, cree la medición: descargue Apidog, guarde su solicitud contra gemini-3.8-flash con `GEMINI_MODEL` como variable y agregue una aserción de costo en `usageMetadata`.
Cuando Google publique la ID del modelo, solo tendrá que cambiar un valor y verá su costo real por llamada desde el primer día.