
Todavía no existe una API pública de Gemini 4 Argon, y Google no ha publicado un ID de modelo. Google anunció Argon el 30 de septiembre de 2026, y hoy solo está disponible para los defensores del Programa Fairwind: un conjunto de socios de Fairwind lo utilizan como un modelo administrado en Gemini Enterprise. Artificial Analysis enumera Google AI Studio como el único proveedor de API de Argon, pero sin datos de velocidad o latencia, lo que se ajusta a un acceso de pre-lanzamiento con lista blanca en lugar de un punto final al que uno puede suscribirse. Cuando comience el despliegue más amplio, Google dice que se inicia "con clientes de API de pago y suscriptores de Google AI Ultra", por lo que una clave de API de Gemini de pago te pone primero en la fila.
Esa brecha entre el anuncio y el acceso es tiempo que puedes aprovechar. Esta guía separa lo que Google ha confirmado sobre la API de Argon de lo que no ha hecho, y luego te guía a través de un código que puedes ejecutar hoy en Gemini 3.8 Flash para que el cambio a Argon sea un cambio de una sola variable. Construirás la solicitud, configurarás una alerta de lanzamiento, simularás la respuesta en Apidog y añadirás un límite de coste a los precios de Argon. Para el modelo en sí, empieza con qué es Gemini 4 Argon; para las fases de despliegue, consulta la guía de la fecha de lanzamiento de Gemini 4 Argon.
Qué está confirmado sobre la API de Gemini 4 Argon y qué no
La publicación de lanzamiento de Google proporciona precios y un límite de salida. Casi todo lo demás que necesita una integración aún no se ha publicado.
| Elemento | Estado | Detalle |
|---|---|---|
| Precio de entrada | Confirmado | $2 por 1M de tokens (introductorio), $4 después del período introductorio |
| Precio de salida | Confirmado | $10 por 1M de tokens (introductorio), $20 después |
| Entrada en caché | Confirmado | 95% de descuento en la entrada: $0.10 introductorio, $0.20 estándar |
| Límite de salida | Confirmado | 1M de tokens, de 64K |
| Superficie de la API | Señalado | La documentación de Google dice que todos los modelos nuevos se lanzan en la API de Interacciones |
| ID del modelo | No publicado | Ausente de la página de modelos, página de precios y registro de cambios |
| Ventana de contexto de entrada | No publicado | La evaluación de contexto largo de Google utilizó prompts de hasta 1M de tokens, pero eso no es una especificación |
| Niveles de pensamiento | No publicado | Las evaluaciones se ejecutaron en la "configuración de pensamiento más alta"; nombres y valores predeterminados desconocidos |
| Límites de tasa | No publicado | No se anunciaron niveles |
| Soporte por lotes | No publicado | Sin precios por lotes o Flex |
| Nivel de prompt largo | No publicado | 3.1 Pro cobra más por encima de 200K; la regla de Argon no está establecida |
| Duración del período introductorio | No publicado | Sin fecha de finalización para $2/$10 |
Dos filas merecen una mirada más atenta. La fila de superficie de la API proviene de la documentación de la API de Interacciones, que dice que los nuevos modelos "se lanzarán en la API de Interacciones". Argon es un modelo nuevo, así que espéralo allí primero; Google no ha dicho si generateContent lo servirá. La fila de salida es el límite declarado por Google para el modelo, pero Vals AI enumera una salida máxima de 262K para la configuración que probó, así que no asumas que cada punto final servirá el millón completo el primer día. Nuestra guía de 1M de tokens de salida cubre cómo ese límite afecta la transmisión, los tiempos de espera y el almacenamiento.
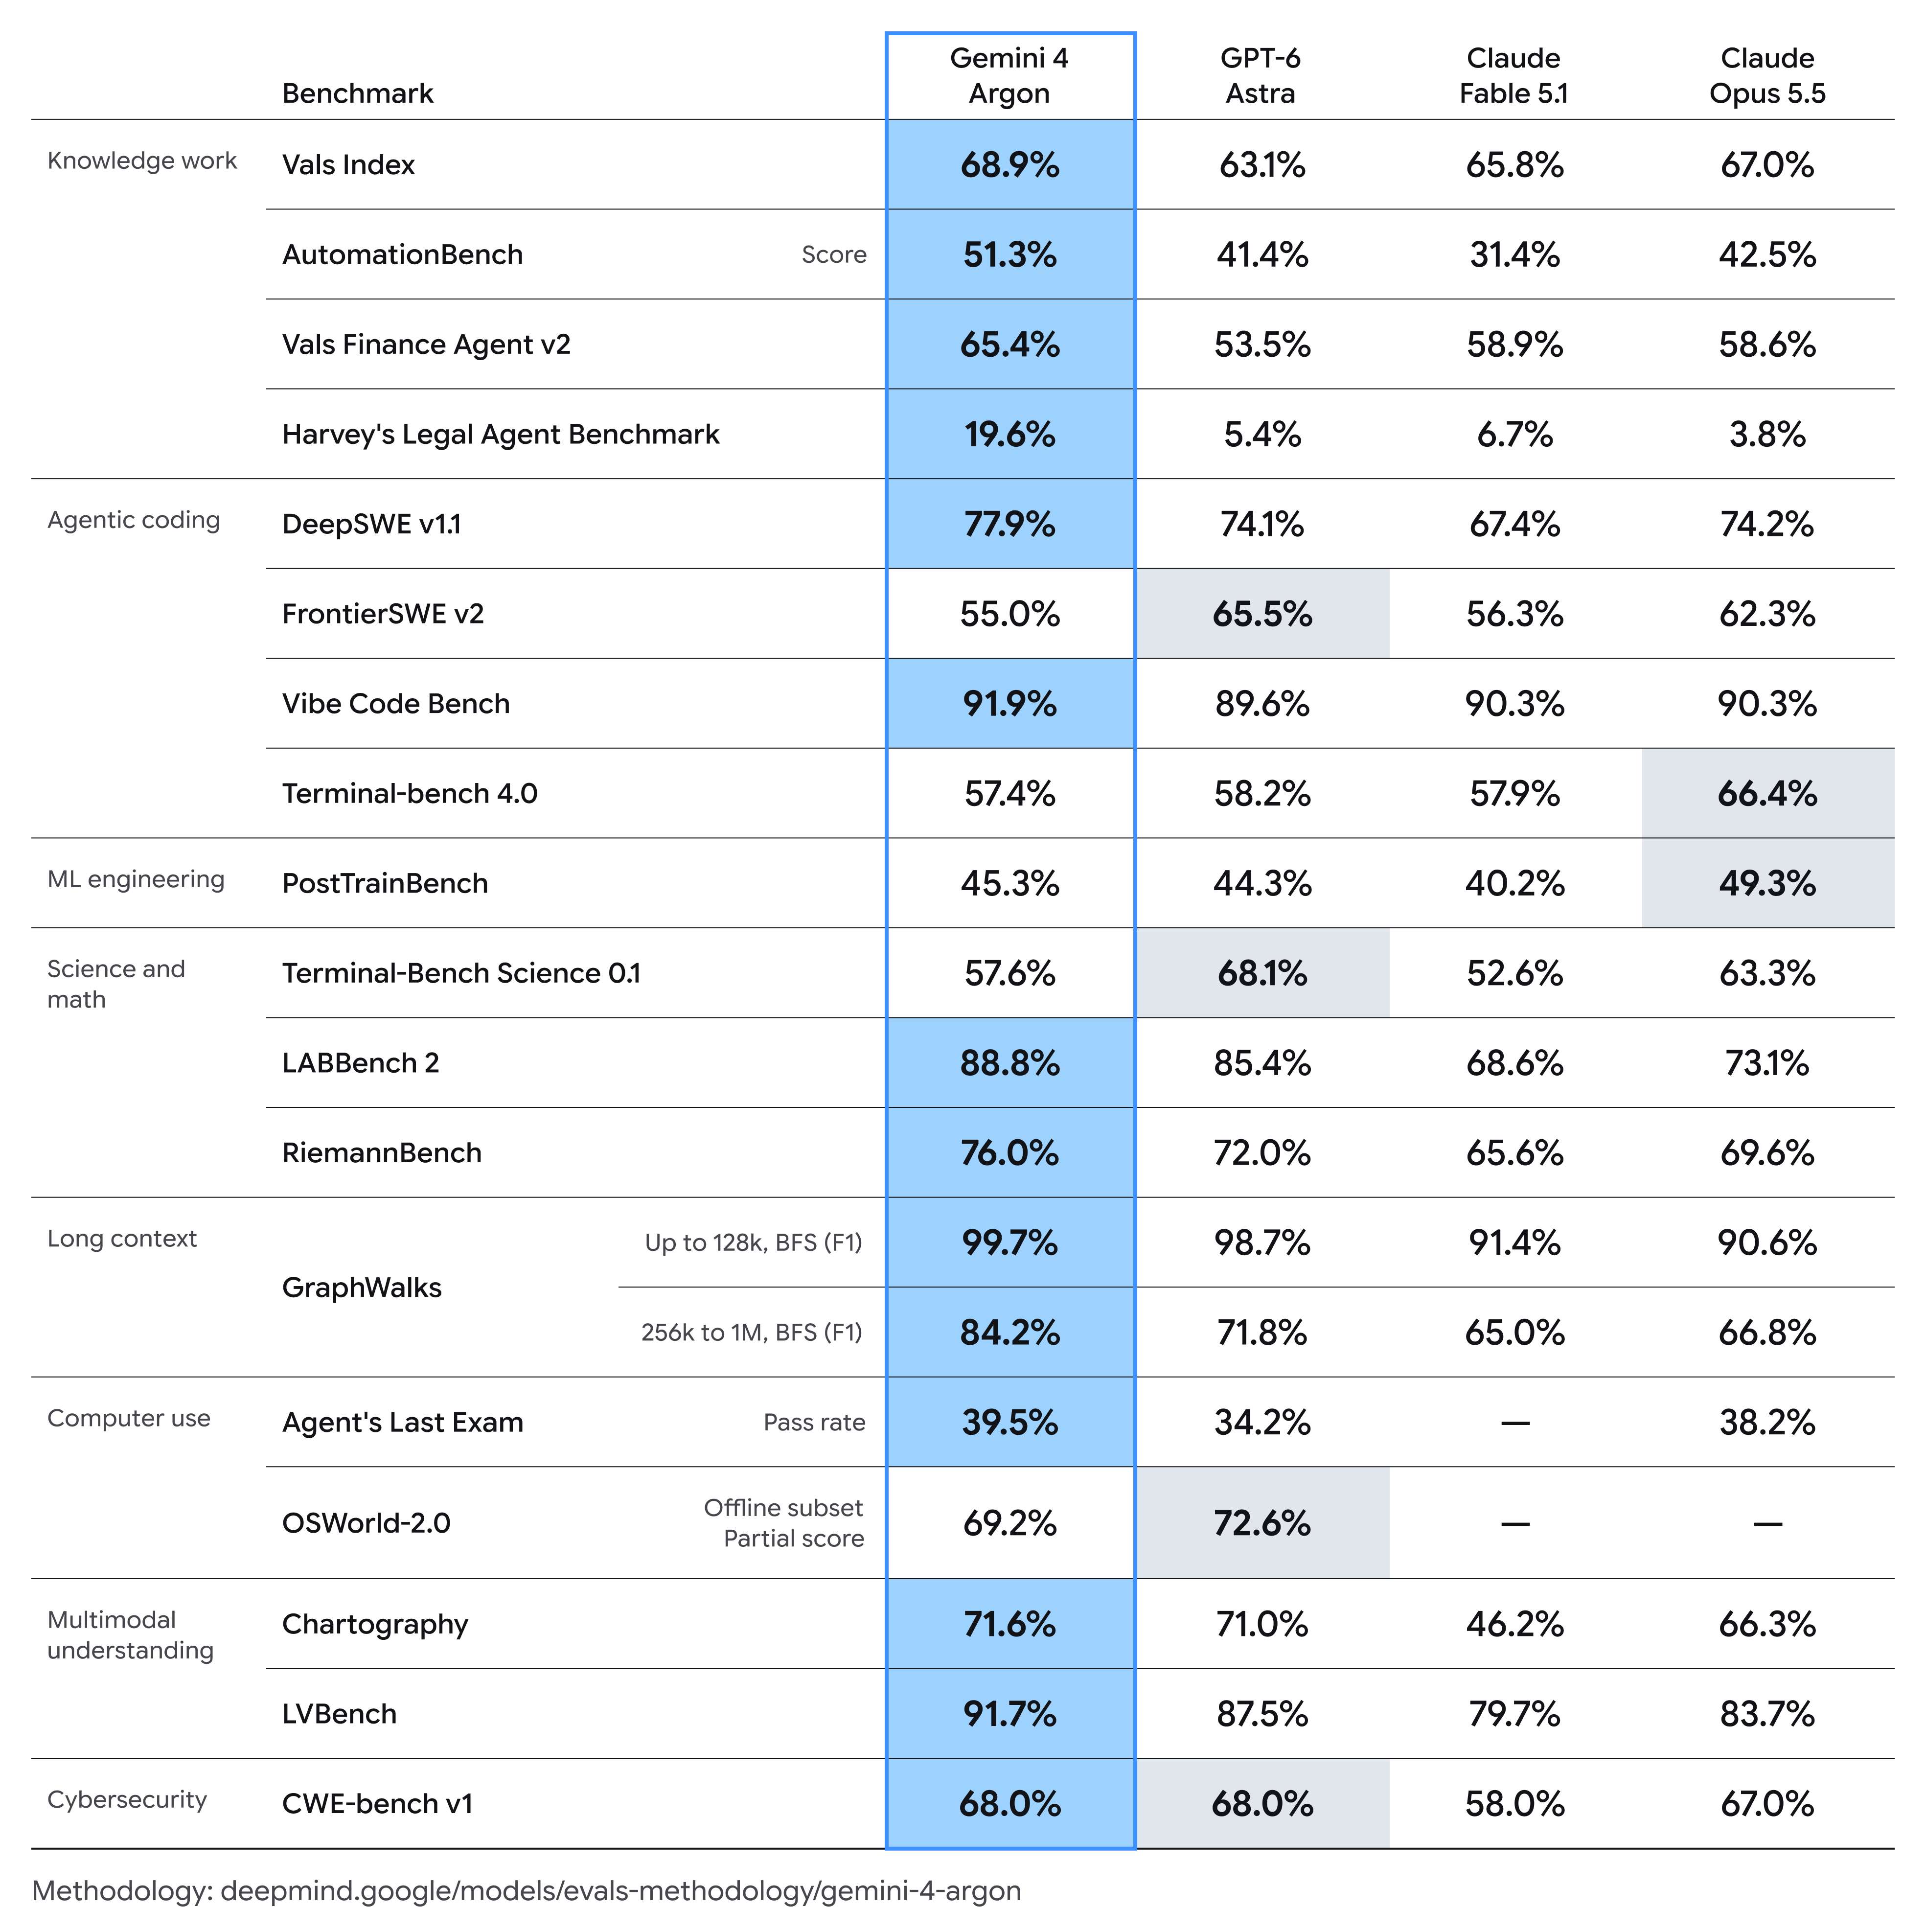
En cuanto al precio, un párrafo es suficiente aquí. Una solicitud con un prompt de 20,000 tokens y 5,000 tokens de salida cuesta 20,000 x $2/1M + 5,000 x $10/1M = $0.04 + $0.05 = $0.09 a tarifas introductorias, y $0.18 a la tarifa estándar de $4/$20. El precio de salida introductorio de Argon ($10) está por debajo de los $12 de Gemini 3.1 Pro Preview, y su precio estándar coincide exactamente con Claude Opus 5.5. El desglose de precios de Gemini 4 Argon ejecuta los escenarios completos, incluyendo la entrada en caché y una respuesta maximizada de 1M de tokens.
No codifiques un ID de modelo que encuentres en línea
Busca el ID del modelo Argon y encontrarás cadenas en sitios de referencia, agregadores y solicitudes de extracción de código abierto. Son marcadores de posición. Vals AI utiliza su propio slug para su página de modelo, una solicitud de extracción de GitHub agrega un ID "provisionalmente", y la ruta estilo OpenRouter conduce a una página no encontrada. Google no ha confirmado ninguno de ellos, y varios medios advierten explícitamente contra la codificación de una suposición.
Un ID adivinado falla de la manera menos útil: un error 404 en producción el día del despliegue, o una reversión silenciosa si tu envoltorio captura errores de forma demasiado amplia. En su lugar, mantén el nombre del modelo en la configuración. En cada ejemplo a continuación, el modelo proviene de una variable de entorno `GEMINI_MODEL` que por defecto es `gemini-3.8-flash`, un modelo estable que puedes llamar hoy. Cuando Google publique el ID de Argon, cambiarás un solo valor.
Prepara tu código en Gemini 3.8 Flash
Gemini 3.8 Flash (`gemini-3.8-flash`) se ejecuta en los mismos puntos finales, encabezados y formas de respuesta que se espera que use Argon, a $0.75/$3.75 por 1M de tokens hasta el 31 de diciembre de 2026. Tu clave se encuentra en `GEMINI_API_KEY`; nunca la pegues en el código. La configuración completa está en nuestra guía de la API de Gemini 3.8 Flash.
Paso 1: Envía una solicitud a la API de Interacciones
La API de Interacciones es la API principal de Google, disponible de forma general desde junio de 2026. Mantén tanto el modelo como el nivel de pensamiento en variables, porque los nombres de los niveles de Argon no están publicados.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
El SDK de Python necesita `google-genai` 2.3.0 o posterior para la API de Interacciones:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
En 3.8 Flash, los niveles válidos son `low`, `medium` (el predeterminado) y `high`; `minimal` devuelve HTTP 400. Nuestra guía de niveles de pensamiento explica las compensaciones. Para trabajos multi-turno, pasa el ID de la respuesta anterior como `previous_interaction_id`, y envía `store: false` para optar por no almacenar en el servidor.
Paso 2: Mantén el funcionamiento de la ruta generateContent
La mayoría del código existente llama al punto final obsoleto `generateContent`, que Google dice que sigue siendo totalmente compatible. Aquí está la misma solicitud:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Ten en cuenta dónde reside el pensamiento: `generation_config.thinking_level` en Interacciones, `generationConfig.thinkingConfig.thinkingLevel` aquí. Si tu cliente envuelve ambos, enruta los nuevos modelos a través de Interacciones por defecto. Las definiciones de herramientas necesitan el mismo cuidado; consulta llamadas a funciones de Gemini 3.8 Flash.
Paso 3: Programa una verificación de lanzamiento con models.list
No actualices el registro de cambios. Pregúntale a la API. El endpoint `models` devuelve los modelos disponibles con sus límites de tokens y métodos compatibles:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
Ejecútalo cada hora desde cron o un programador de CI, usando la clave que usa tu aplicación de producción. Cuando ejecutamos esta llamada el 1 de octubre de 2026, con una clave de proyecto de pago, devolvió 61 modelos, sin `nextPageToken` y sin nombre que contuviera "argon". El día que coincida, la entrada te dirá tres cosas a la vez: el nombre real del modelo, si `outputTokenLimit` es el 1M completo y qué métodos se enumeran.
Paso 4: Simula la respuesta para que el cliente se construya antes del acceso
No necesitas Argon para construir el código que consume Argon. Guarda la solicitud del Paso 2 en Apidog con `GEMINI_API_KEY` y `GEMINI_MODEL` como variables de entorno, envíala una vez contra 3.8 Flash y extrae la respuesta real en el punto final como un ejemplo de respuesta. El Smart Mock predeterminado de Apidog genera datos a partir del esquema, así que configura el método de simulación predeterminado del proyecto como "Response example first" (Configuración del proyecto, Configuración de características, Configuración de simulación). La URL de simulación devuelve entonces tu respuesta guardada, para que tu front-end, los workers de la cola y los parsers puedan ejecutarla sin gastar tokens.
Sé claro sobre lo que es esta simulación: el esquema de respuesta actual de Gemini, no uno específico de Argon, porque Google no ha publicado uno. Sigue siendo la opción correcta, ya que se espera que Argon esté en la misma API. Para ensayar una respuesta pesada de Argon, edita `usageMetadata` del ejemplo a recuentos grandes y confirma que tu código de facturación y alertas reacciona.
Paso 5: Afirma sobre usageMetadata y un límite de costo
Cada respuesta de generateContent incluye `usageMetadata`. Agrega un script de postprocesamiento en Apidog que valora cada respuesta a las tarifas estándar de Argon, para que una prueba falle antes de que lo haga una factura:
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD por token de entrada después del período introductorio
const OUT = 20 / 1e6; // USD por token de salida; el pensamiento se factura como salida en los modelos Gemini actuales
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata está presente", () => pm.expect(u).to.be.an("object"));
pm.test("costo por debajo de $0.10 a tarifas de Argon", () => pm.expect(cost).to.be.below(0.10));
Elige el límite por solicitud; $0.10 es adecuado para un prompt corto como este. Google no ha declarado cómo Argon factura los tokens de pensamiento, por lo que el script asume la regla actual de Gemini. Mantén la misma solicitud guardada y ejecútala contra 3.8 Flash ahora y Argon más tarde: la diferencia en el recuento de tokens y el costo es tu comparación de regresión.
Preguntas Frecuentes
¿Está disponible la API de Gemini 4 Argon? No públicamente. Argon se está implementando solo para un conjunto de socios del Programa Fairwind, quienes lo utilizan a través de Gemini Enterprise. Los clientes de API de pago y los suscriptores de Google AI Ultra son los siguientes, sin fecha.
¿Cuál es el ID del modelo Gemini 4 Argon? Google no ha publicado ninguno. Las cadenas en sitios de terceros son marcadores de posición, así que mantén el modelo en una variable de entorno y observa `models.list`.
¿Cuánto costará la API de Gemini 4 Argon? $2 de entrada y $10 de salida por 1M de tokens durante un período introductorio de duración no especificada, luego $4 y $20. La entrada en caché tiene un 95% de descuento. Consulta precios de Gemini 4 Argon.
¿Funcionará Argon con generateContent? Google no lo ha dicho. Su documentación dice que todos los modelos nuevos se lanzan en la API de Interacciones, así que construye sobre Interacciones y trata `generateContent` como una alternativa.
¿Google AI Ultra me da acceso a la API? No. AI Ultra es una suscripción de consumidor, no una clave de API. Google dice que el acceso a la API comienza con los clientes de API de pago.
Tu siguiente paso
Establece `GEMINI_MODEL` en cada entorno, programa la verificación de `models.list` y guarda las solicitudes de Interacciones y `generateContent` con la aserción de costo adjunta. Descarga Apidog para mantener esas solicitudes, simulaciones y pruebas en un solo espacio de trabajo, luego cambia una variable cuando Google publique el ID.