
Google lanzó dos nuevos modelos de voz a voz el 15 de septiembre de 2026, y el hilo de Hacker News superó los 337 puntos en un día. Esa es una gran reacción para el lanzamiento de una API de voz, y la mayor parte de la discusión no fue sobre el video de demostración. Eran desarrolladores haciendo la misma pregunta: ¿cuánto cuesta construir con esto y cómo se conecta uno realmente a ello?
Esta es esa guía. gemini-3.8-live y gemini-3.8-live-extended-thinking se están implementando ahora en la API de Gemini y Google AI Studio, con acceso a Gemini Enterprise y Search Live en vista previa privada. Ambos modelos aceptan tokens de entrada y salida gratuitos además de un nivel de pago con tarifas por token y por minuto, lo cual es lo suficientemente inusual para un modelo de audio en vivo como para que valga la pena recorrer la sesión de WebSocket en sí, no solo la página de precios. Ya comparamos los asistentes de voz para el consumidor en GPT-Live vs Gemini Live; esta pieza es el camino del desarrollador hacia la API detrás de un lado de esa comparación.
Lo que realmente se lanzó el 15 de septiembre
El anuncio de Google cubre dos modelos. gemini-3.8-live es el modelo estándar de voz a voz. gemini-3.8-live-extended-thinking añade una capa de razonamiento que se ejecuta mientras el modelo habla, descrita a continuación. Ambos soportan 97 idiomas con cambio automático a mitad de conversación, lo que significa que una persona que llama puede comenzar una oración en inglés y terminarla en español sin una bandera de idioma manual.
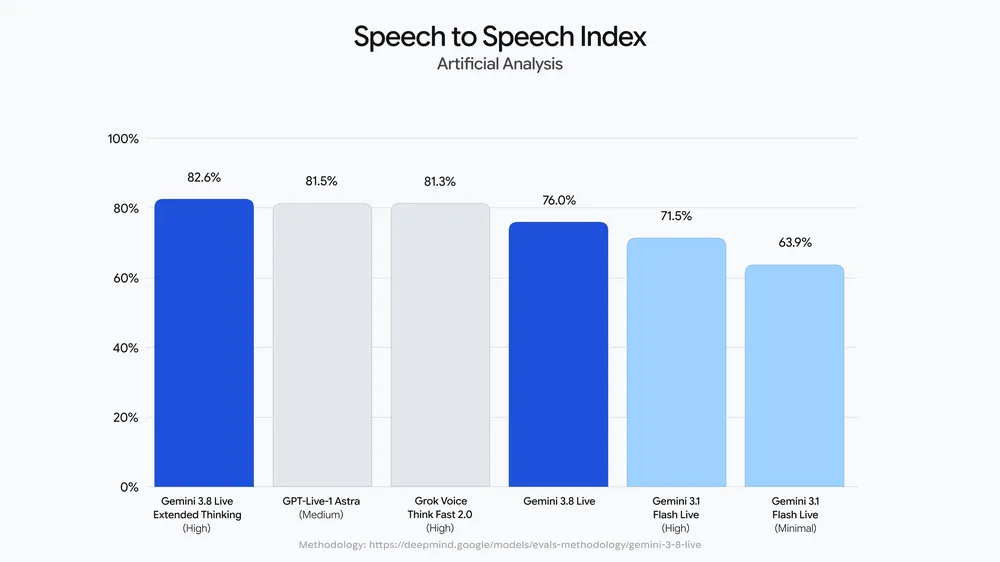
Disponibilidad en el lanzamiento: la API de Gemini y Google AI Studio (acceso general), además de Gemini Enterprise y Search Live (vista previa privada, por lo que la mayoría de los desarrolladores que lean esto comenzarán en la API o AI Studio). Los tokens gratuitos se aplican a ambos modelos tanto en la entrada como en la salida, lo que permite un prototipo real antes de usar una tarjeta de crédito.
Un detalle que Google no ha publicado: los límites de velocidad del nivel gratuito para los dos modelos Live. La página de límites de velocidad es la fuente de la verdad una vez que los liste; trate cualquier número que vea en otro lugar como no confirmado hasta que lo verifique usted mismo allí.
Que el acceso a Search Live y Gemini Enterprise sea solo para vista previa privada, en lugar de abierto como la API, es una señal que vale la pena leer: Google se siente cómodo permitiendo que los desarrolladores construyan sobre esto de formas adyacentes a la producción antes de comprometer el mismo modelo con la búsqueda de consumidores o los puestos empresariales de pago. Esto es normal para la implementación de un modelo de voz, y significa que la superficie de la API es el punto de partida estable en este momento, no una vista previa reducida de una mejor experiencia para el consumidor que llegará más tarde.
Obtén una clave API gratuita y abre una sesión
Una clave API de Gemini proviene de Google AI Studio, vinculada a una cuenta de Google, y funciona con los modelos Live el mismo día en que se lanzan, ya que no hay un paso de aprobación separado para el nivel gratuito. Una vez que tienes la clave, el punto de conexión es un WebSocket, no un endpoint REST, que es el primer ajuste si estás acostumbrado a las llamadas generateContent:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
Esa URL proviene del artículo práctico de Simon Willison del día del lanzamiento, publicado junto con su habitual lectura atenta de una nueva API. También señaló algo que vale la pena saber antes de construir una interfaz de usuario alrededor de esto: puedes interrumpir el modelo a mitad de la respuesta de la misma manera que interrumpirías a una persona que habla, y la transcripción que regresa puede incluir el habla que el modelo comenzó a generar pero nunca terminó de reproducir, porque la reproducción fue interrumpida por tu interrupción. Maneja esto como un estado distinto en tu cliente en lugar de asumir que cada línea de la transcripción se escuchó completa.
Una sesión bidireccional a través de ese socket sigue la forma que utiliza cada API de streaming basada en WebSocket: primero un mensaje de configuración, identificando el modelo y su configuración de generación, luego un flujo de mensajes de contenido que transportan fragmentos de audio o texto en cualquier dirección, con el servidor devolviendo segmentos de respuesta parciales y finales a medida que estén listos. El esquema exacto del mensaje es algo que Google debe documentar con precisión, y puede cambiar entre la vista previa y la disponibilidad general, así que verifica los nombres de los campos con la documentación de la API de Gemini en vivo y la referencia de tu SDK antes de comprometerte con un cliente de producción. Lo que es estable es el patrón: conectar, enviar la configuración, transmitir contenido, leer las respuestas transmitidas y esperar que la interrupción sea un evento normal en lugar de un caso de error.
Prácticamente, eso significa que tu primera sesión de trabajo debería apuntar al ciclo más pequeño posible: abre el socket, envía un mensaje de configuración nombrando el modelo que deseas (gemini-3.8-live o gemini-3.8-live-extended-thinking), envía un único y breve turno de audio o texto, y confirma que recibes una respuesta transmitida antes de agregar lógica de reintento, manejo de reconexión o una interfaz de usuario. Construye la ruta de interrupción en segundo lugar, una vez que la ruta feliz funcione, ya que probarla bien significa hablar deliberadamente sobre el modelo a mitad de la respuesta y verificar que tu cliente marque correctamente la transcripción cortada en lugar de tratarla como un turno completado.
Pensamiento extendido: cuando el razonamiento ocurre en voz alta
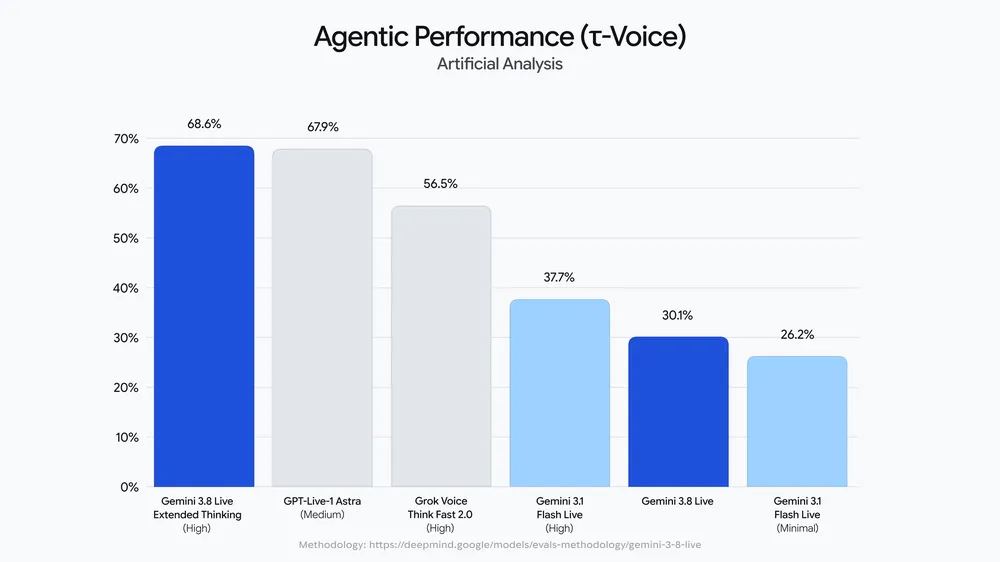
El modelo simple gemini-3.8-live responde directamente. gemini-3.8-live-extended-thinking hace algo diferente: Google dice que "razona y habla simultáneamente", manteniendo lo que llama "flujo conversacional ininterrumpido" llenando el tiempo de razonamiento con señales verbales, frases como "Déjame comprobar eso" en lugar de un silencio mientras el modelo trabaja.
Eso es importante para un tipo específico de aplicación: agentes de voz que llaman a herramientas o acceden a API externas a mitad de la conversación. El modelo de pensamiento extendido "ejecuta herramientas y llamadas API en segundo plano mientras continúa la conversación", y la llamada a funciones es compatible con ambos modelos. Imagine un agente de reservas que necesita verificar la disponibilidad en una API de calendario: en lugar de quedarse en silencio durante dos segundos mientras se realiza la búsqueda, el modelo puede reconocer la solicitud en voz alta y mantener el intercambio mientras la llamada se completa en segundo plano.
Elija el pensamiento extendido cuando su sesión incluya llamadas a herramientas, búsquedas de varios pasos o respuestas con mucho razonamiento, donde un silencio se sentiría roto. Elija el modelo simple para intercambios más cortos y de baja latencia donde la sobrecarga de razonamiento no sea necesaria. Ambos cuestan lo mismo por token, por lo que la elección es sobre el comportamiento, no sobre el presupuesto. Si su agente se basa específicamente en la llamada a funciones, nuestra guía de llamada a funciones para Gemini 3.8 Flash cubre la forma de solicitud que Google utiliza en la familia actual de Gemini 3.8, aunque confirme la carga útil de llamada a funciones específica de Live con la documentación de la API de Live antes de lanzar, ya que las API de texto y voz no tienen garantizado compartir un esquema.
Lo que cuesta, desglosado
Ambos modelos Live comparten el mismo precio estándar:
| Tipo | Tarifa |
|---|---|
| Entrada de texto | $0.75 por 1M de tokens |
| Entrada de audio | $3.00 por 1M de tokens, o $0.005 por minuto |
| Entrada de imagen/video | $1.00 por 1M de tokens, o $0.002 por minuto |
| Salida de texto | $4.50 por 1M de tokens |
| Salida de audio | $12.00 por 1M de tokens, o $0.018 por minuto |
Los tokens de pensamiento se facturan como salida, al igual que todos los demás modelos Gemini 3.x, por lo que el razonamiento en segundo plano del pensamiento extendido aparece en la línea de salida en lugar de como un cargo separado.
Ejemplo práctico: una llamada de voz de 10 minutos, audio de entrada y audio de salida todo el tiempo, en el nivel estándar de pago. Entrada de audio: 10 minutos x $0.005 = $0.05. Salida de audio: 10 minutos x $0.018 = $0.18. Total: $0.23 por una conversación completa de ida y vuelta de 10 minutos, antes de que se agreguen tokens de texto o de llamadas a herramientas. Ejecute esa misma llamada en el nivel gratuito durante la creación de prototipos y el costo de los tokens será cero, sujeto a cualquier límite de velocidad que Google publique eventualmente para ello.
El modelo gemini-3.1-flash-live-preview en la misma página de precios tiene tarifas idénticas a los dos nuevos modelos Live, lo cual vale la pena verificar si ya tiene una integración Live en ese modelo anterior; la decisión de precios no es una razón para posponer la migración.
Lo que dicen los desarrolladores, hasta ahora
La discusión en Hacker News no es uniformemente positiva. Una queja recurrente: los suscriptores de Google Workspace y Google AI Plus de pago aún no tienen acceso de consumidor a la nueva experiencia Live, a pesar de ser clientes de pago, mientras que el acceso a la API y AI Studio está abierto. Un informe del hilo describió un bucle agéntico donde el modelo inventó requisitos adicionales que no formaban parte de la tarea original, un modo de fallo que vale la pena probar específicamente si está conectando Live a un agente autónomo en lugar de un asistente de voz con intervención humana. Si está construyendo algo más cercano a un bucle autónomo que a un asistente supervisado, agregue una verificación explícita que compare lo que el modelo afirma que necesita con la definición de tarea que le dio, en lugar de confiar en los requisitos declarados del modelo al pie de la letra. Trate ambos puntos como una señal del primer día de un solo hilo, no como un informe de defecto verificado, y vuelva a probarlos con su propio caso de uso antes de generalizar a partir de ellos.
Vea el protocolo sin procesar antes de escribir el código del cliente
Antes de comprometerse con una biblioteca cliente, es útil observar los fotogramas reales que circulan por la red. Apidog puede abrir una conexión WebSocket al endpoint BidiGenerateContent, enviar manualmente el mensaje de configuración JSON y los mensajes de contenido subsiguientes, y mostrarle los fotogramas transmitidos que regresan en tiempo real, lo cual es la forma más rápida de comprender el patrón de configuración-y-luego-transmisión antes de escribir una sola línea de código SDK. Apidog no captura el audio del micrófono por usted; usted mismo suministra las cargas útiles de audio o texto y usa la conexión para inspeccionar lo que el servidor devuelve, confirmar que su mensaje de configuración es aceptado y observar cómo se comporta la interrupción antes de construir el manejo de errores para ello en producción. La referencia completa del protocolo para construir y probar APIs WebSocket de esta manera se encuentra en docs.apidog.com. Descargue Apidog para probar la conexión usted mismo antes de construir su primer cliente.
Para comparar, nuestro desglose WebSocket vs WebRTC cubre por qué Google eligió un WebSocket para esta transmisión bidireccional en lugar de la ruta WebRTC que usan algunas API de voz de la competencia, y qué significa ese compromiso específicamente para los clientes de navegador.
Preguntas Frecuentes
¿La API de Gemini 3.8 Live es gratuita? Sí, para ambos modelos, los tokens de entrada y salida son gratuitos en el nivel gratuito. Se aplican tarifas estándar de pago una vez que se supera cualquier límite de velocidad que Google establezca, y ese límite del nivel gratuito aún no se ha publicado, así que consulte directamente la página de límites de velocidad.
¿Cuál es la diferencia entre los dos nuevos modelos? gemini-3.8-live responde directamente. gemini-3.8-live-extended-thinking razona mientras habla, utilizando "relleno" verbal para cubrir llamadas a herramientas en segundo plano y búsquedas de varios pasos, al mismo precio por token.
¿Necesito WebRTC para usar esto? No. La API se basa en WebSocket, conectándose a un endpoint BidiGenerateContent en lugar de a una conexión de pares WebRTC.
¿Puedo probar esto sin escribir un cliente? Sí. Abra el WebSocket en Apidog, envíe manualmente los mensajes de configuración y contenido, y lea la respuesta transmitida antes de construir un cliente real alrededor de ella.