
Aquí está la decisión de antemano. Elige Gemini 3.5 Flash-Lite cuando realices tareas sencillas en gran volumen y te importe más el coste y la velocidad: clasificación, extracción, respuestas cortas de chat, respuestas RAG, autocompletar. Elige Gemini 3.6 Flash cuando la calidad importe más que la factura: agentes de varios pasos, uso de herramientas, codificación, uso de ordenador y respuestas en las que un resultado incorrecto es costoso.
Ambos modelos se lanzaron en la actualización de la categoría Flash de Google el 21 de julio de 2026. Ambos aceptan hasta 1 millón de tokens de entrada. Se sitúan en diferentes puntos de la misma curva, por lo que la pregunta no es realmente qué modelo es "mejor". Es qué compromiso se ajusta al trabajo que tienes delante.
Una particularidad en los nombres que hay que aclarar primero: el modelo principal saltó a la versión 3.6, pero la categoría Lite se mantuvo en la 3.5. Así que estás comparando un modelo 3.5 con un modelo 3.6, y eso es lo esperado, no un error tipográfico. Más información al respecto en las Preguntas Frecuentes.
La respuesta corta
Por defecto, usa Flash-Lite para cualquier cosa sencilla que ejecutes millones de veces, y recurre a 3.6 Flash en el momento en que la tarea requiera razonamiento, herramientas o código. Si no puedes decidirte, empieza con Flash-Lite, observa dónde las respuestas se quedan cortas y promueve solo esas llamadas a 3.6 Flash. Raramente necesitarás un solo modelo para toda la aplicación.
Precio y velocidad uno al lado del otro
| Atributo | Gemini 3.5 Flash-Lite | Gemini 3.6 Flash |
|---|---|---|
| ID del modelo | gemini-3.5-flash-lite |
gemini-3.6-flash |
| Precio de entrada | $0.30 / 1M de tokens | $1.50 / 1M de tokens |
| Precio de salida | $2.50 / 1M de tokens | $7.50 / 1M de tokens |
| Rendimiento | ~350 tokens de salida/seg | No publicado por separado |
| Ventana de contexto | 1M de tokens | 1M de tokens |
| Nivel gratuito | Sí (con límite de tarifa) | Sí (con límite de tarifa) |
Flash-Lite es más barato por cada token. La entrada cuesta 5 veces menos; la salida cuesta 3 veces menos. Google publica una cifra de rendimiento de alrededor de 350 tokens de salida por segundo para Flash-Lite, lo que hace que se sienta instantáneo en un cuadro de chat o en un campo de autocompletado. Google no publicó un número separado de tokens por segundo para 3.6 Flash, pero 3.6 Flash produce aproximadamente un 17% menos de tokens de salida que el 3.5 Flash al que reemplaza, por lo que finaliza el trabajo de varios pasos más rápido de lo que sugiere el precio de lista. Puedes confirmar las tarifas actuales en la página de precios de la API de Gemini y en nuestro desglose de precios de Gemini 3.6 Flash.
Calidad y puntos de referencia
La diferencia de precio te da margen en tareas difíciles. En Terminal-Bench 2.1, que mide el trabajo de terminal agentivo, Flash-Lite obtiene una puntuación de 54 y 3.6 Flash obtiene 78.0. Esa diferencia de 24 puntos lo dice todo: en trabajos genuinamente de varios pasos y basados en herramientas, 3.6 Flash es el modelo más fuerte por un margen claro.
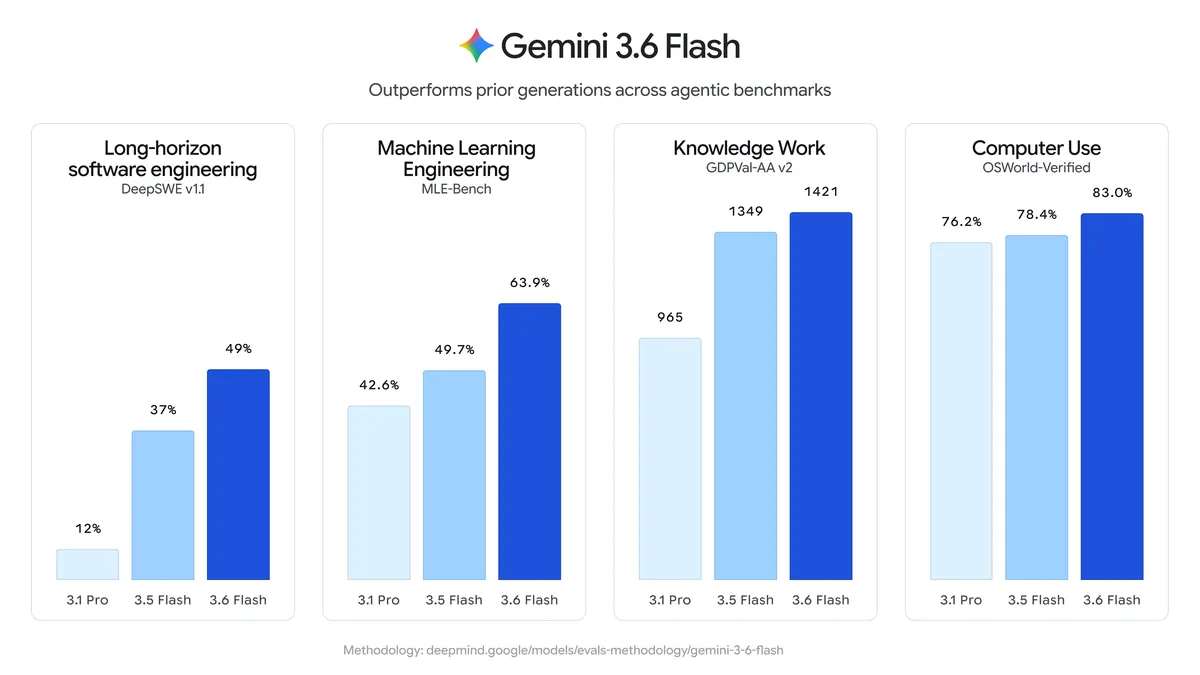
3.6 Flash también reporta 83.0 en OSWorld-Verified, el benchmark de uso de ordenador que mide la capacidad de operar un navegador o escritorio real. Flash-Lite no apunta a esa habilidad. Si tu carga de trabajo implica hacer clics en una pantalla, ese es un trabajo para 3.6 Flash. En cuanto a la codificación específicamente, 3.6 Flash registra un 58.7% en SWE-Bench Pro y un 49% en DeepSWE v1.1, el tipo de puntuaciones que lo sitúan en el territorio real de la codificación agentiva. Flash-Lite no está diseñado para ese trabajo.
Vale la pena ser justo con Flash-Lite aquí. Su puntuación de 54 en Terminal-Bench 2.1 ha subido desde 31 en la generación Lite anterior, por lo que la categoría barata ha mejorado mucho en esta ronda. No es un modelo débil. Es un modelo ajustado para un trabajo diferente: razonamiento rápido, barato y suficientemente bueno en tareas que no se ramifican. La propia página del modelo Flash de Google y el anuncio de lanzamiento enmarcan los dos de la misma manera: una categoría para volumen, una categoría para profundidad.
Qué modelo para qué trabajo
Usa esto como matriz inicial, luego ajusta con tus propias evaluaciones.
| Tarea | Mejor ajuste |
|---|---|
| Clasificación o extracción de alto volumen | Flash-Lite |
| Asistentes de chat y respuestas cortas | Flash-Lite |
| Respuestas RAG sobre contexto recuperado | Flash-Lite |
| UX de estilo autocompletar, crítica en latencia | Flash-Lite |
| Pipelines a escala de búsqueda, por cada solicitud | Flash-Lite |
| Agentes de varios pasos | 3.6 Flash |
| Uso de herramientas y cadenas de llamadas a funciones | 3.6 Flash |
| Codificación y revisión de código | 3.6 Flash |
| Uso de ordenador (navegador o escritorio) | 3.6 Flash |
| Respuestas de mayor riesgo donde los errores cuestan dinero | 3.6 Flash |
El patrón es simple. Flash-Lite gana donde la tarea es específica y el volumen es enorme. 3.6 Flash gana donde la tarea se ramifica y el costo de equivocarse es alto. Un modelo que etiqueta tickets de soporte por categoría diez millones de veces al día pertenece a Flash-Lite. Un modelo que lee un seguimiento de pila, edita tres archivos y abre una solicitud de extracción pertenece a 3.6 Flash. Si estás sopesando esto contra el antiguo 3.5 Flash en lugar de Flash-Lite, nuestra comparación de 3.6 Flash vs 3.5 Flash cubre esa ruta de actualización.
Una comparación de costes en la misma carga de trabajo
Los números concretan el compromiso. Digamos que un trabajo diario envía 10M de tokens de entrada y genera 2M de tokens de salida, una forma típica para un pipeline de resumen o extracción por lotes.
| Modelo | Entrada (10M) | Salida (2M) | Total diario |
|---|---|---|---|
| Flash-Lite | $3.00 | $5.00 | $8.00 |
| 3.6 Flash | $15.00 | $15.00 | $30.00 |
Con esa combinación, 3.6 Flash cuesta 3.75 veces más: $8.00 frente a $30.00 al día, o aproximadamente $240 frente a $900 al mes para el mismo volumen.
Sin embargo, el múltiplo no es fijo. Debido a que Flash-Lite es 5 veces más barato en la entrada y 3 veces más barato en la salida, tus ahorros reales se sitúan entre 3 y 5 veces, dependiendo de la forma de tu tráfico. El trabajo intensivo en entrada (contexto RAG largo, documentos grandes, clasificación de grandes entradas) se inclina hacia el extremo de 5x, y esas son exactamente las cargas de trabajo para las que Flash-Lite está diseñado. La generación intensiva en salida se inclina hacia 3x.
Así que la verdadera pregunta no es solo "¿puede 3.6 Flash hacer esto?". Es "¿vale la pena el aumento de calidad pagar de 3 a 4 veces más por llamada, a mi volumen?". Para un pipeline a escala de búsqueda, la respuesta suele ser no. Para un agente que edita código o presenta un ticket, la respuesta suele ser sí.
Cómo hacer A/B con ambos en Apidog
No tienes que adivinar qué nivel es suficientemente bueno. La API de Gemini es un endpoint REST simple, por lo que puedes enviar el mismo prompt a ambos modelos y comparar las respuestas directamente. Apidog es un cliente API creado precisamente para este tipo de verificación lado a lado.
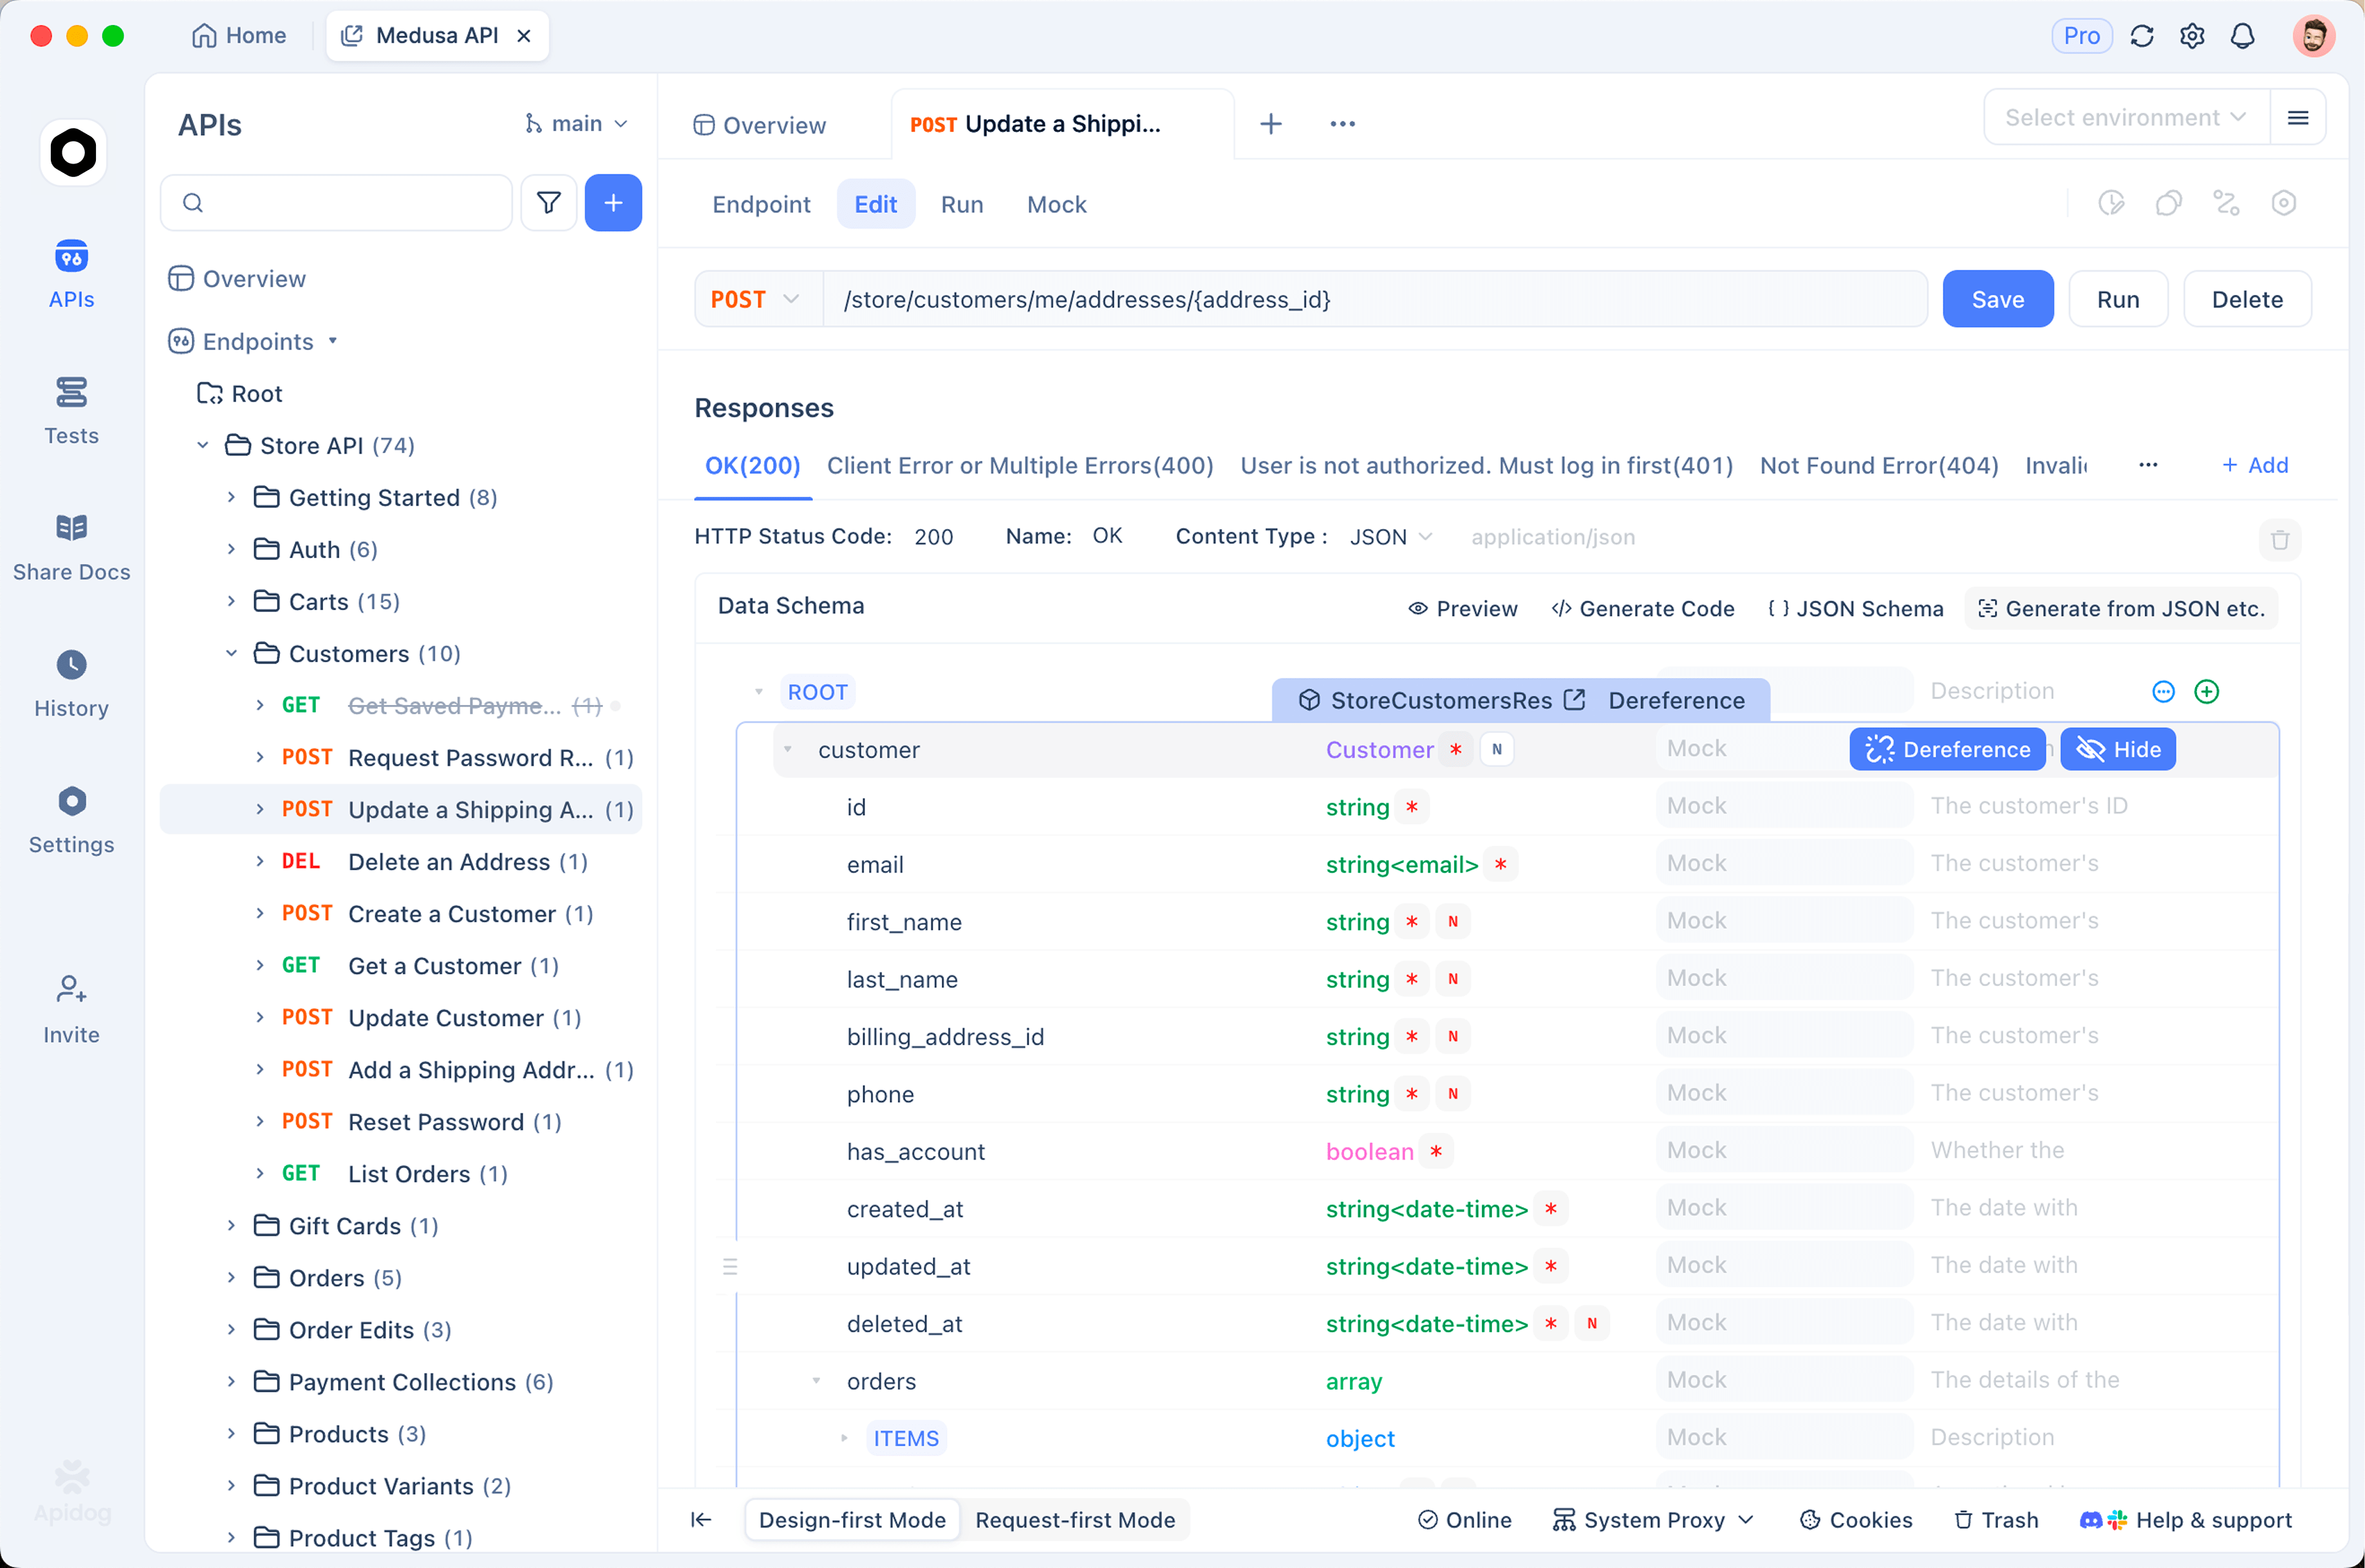
Aquí hay un flujo de trabajo que toma unos minutos:
- Crea una solicitud POST al endpoint de la API de Gemini y almacena tu clave API en una variable de entorno de Apidog, para que la clave nunca esté en el cuerpo de la solicitud o en el control de versiones.
- Envíala una vez con el modelo configurado como
gemini-3.5-flash-lite. Observa la respuesta y la latencia que informa Apidog. - Duplica la solicitud y cambia una cosa: el ID del modelo a
gemini-3.6-flash. Mismo prompt, mismos parámetros, por lo que la única variable es el modelo. - Compara las dos respuestas en cuanto a calidad, y compara los tiempos que Apidog registra para cada llamada.
- Añade aserciones sobre la respuesta (código de estado, campos JSON esperados, contenido requerido) para que "suficientemente bueno" se defina mediante una verificación, no a simple vista.
Una vez que existan las solicitudes, guárdalas y conviértelas en una prueba repetible. Puedes programar las pruebas de API en Apidog para volver a ejecutar los mismos prompts con una cadencia, lo que detecta la deriva de calidad o latencia cuando Google actualiza cualquiera de los modelos. Sé claro sobre el límite: Apidog envía las solicitudes y verifica tus aserciones, pero no ejecuta el modelo y no te dirá qué respuesta es más inteligente. Ese juicio queda contigo. Para seguir, descarga Apidog y dirige una solicitud al endpoint de Gemini.
Preguntas frecuentes
¿Es Flash-Lite simplemente una versión peor de 3.6 Flash? No. Es un punto diferente en la curva de costo, calidad y velocidad. Flash-Lite es más barato y rápido con un límite inferior en el razonamiento difícil; 3.6 Flash cuesta más y razona mejor. En tareas simples de alto volumen, Flash-Lite suele ser la respuesta correcta precisamente porque es más barato y rápido, no a pesar de ello.
¿Por qué uno se llama 3.5 y el otro 3.6? Versionado mixto. En esta actualización, Google movió el modelo principal de Flash a 3.6 pero mantuvo la categoría Lite en 3.5 (la misma versión también incluyó un modelo de seguridad Flash Cyber 3.5). Misma familia, diferentes números de versión. No interpretes el 3.5 en Flash-Lite como "antiguo y abandonado".
¿Comparten la misma ventana de contexto? Sí. Ambos aceptan hasta 1 millón de tokens de entrada, por lo que los prompts de contexto largo no son una razón para elegir uno sobre el otro. Elige en función de la calidad del razonamiento, el precio y la velocidad.
¿Puedo usar ambos en una aplicación? Ese es el patrón recomendado. Dirige las llamadas baratas, simples y de alto volumen a Flash-Lite y escala las difíciles a 3.6 Flash. Dado que la forma de la API es idéntica, el cambio es una modificación de un solo campo, lo que hace que la prueba A/B de Apidog mencionada anteriormente sea tan rápida de ejecutar.
¿Son gratuitos para probar? Ambos tienen un nivel gratuito en Google AI Studio, con límite de tarifas, y Google puede usar los datos del nivel gratuito para mejorar sus productos. Esto está bien para pruebas; lee los términos antes de enviar cualquier cosa sensible.
En resumen
Opta por Flash-Lite como tu opción predeterminada para trabajos baratos, rápidos y sencillos a escala, y eleva las llamadas difíciles, ramificadas o con mucha codificación a 3.6 Flash, donde la diferencia de 24 puntos en Terminal-Bench justifica su precio de 3 a 4 veces mayor. No elijas en abstracto: envía tus prompts reales a ambos, mide la calidad y la latencia, y deja que los números decidan. Apidog convierte esa comparación en un trabajo de dos solicitudes.