
El Firecrawl autoalojado solía significar una sola cosa: clonar el repositorio, ejecutar Docker Compose y mantener vivos en tu máquina una API, un servicio Playwright, Redis, RabbitMQ y Postgres. El 18 de noviembre de 2026, Firecrawl lanzó una segunda opción. Firecrawl Local es un único binario en Rust que scrapea, rastrea y mapea sitios a markdown y responde a la misma API v2 en localhost:3002, sin base de datos, cola ni contenedor.
Respuesta rápida: elige Firecrawl Local si quieres hacer scrape, crawl, map y batch scrape en un portátil o en el conjunto de herramientas de un agente con cero infraestructura. Mantén el stack de Docker autoalojado si necesitas trabajos persistentes, los formatos json y summary, extracción con LLM mediante tu propio modelo, o una ruta de búsqueda que nunca toque Firecrawl Cloud.
¿Qué es Firecrawl autoalojado y qué es Firecrawl Local?
Firecrawl autoalojado es el servidor completo de Firecrawl de apps/api, ejecutado en tu propia infraestructura con Docker Compose. Firecrawl Local es una compilación independiente y más ligera en apps/local: un único binario que obtiene y limpia páginas en tu máquina usando el mismo código de limpieza HTML, y delega la búsqueda, las páginas bloqueadas y Alexandria a Firecrawl Cloud.
Ambos viven en el repositorio de GitHub de Firecrawl, ambos sirven la API v2 en el puerto 3002 y ambos son de código abierto bajo AGPL-3.0. Firecrawl Local no reemplaza al servidor. El README de Firecrawl Local lo dice directamente: la guía de autoalojamiento "vive en apps/api y no cambia con Firecrawl Local".
¿No conoces Firecrawl? Empieza con nuestra guía de web scraping con Firecrawl.
Firecrawl Local vs Firecrawl autoalojado de un vistazo
Aquí tienes la versión breve, elaborada a partir de la guía de autoalojamiento, la página de código abierto vs cloud y el README de Local, todo consultado el 19 de noviembre de 2026.
| Firecrawl autoalojado | Firecrawl Local | |
|---|---|---|
| Qué ejecutas | Stack de Docker Compose: api, playwright-service, redis, rabbitmq, nuq-postgres | Un único binario, firecrawl-local |
| Instalación | git clone, escribir .env, docker compose up --build -d |
cargo install firecrawl-local |
| Requisitos previos | Git, Docker Engine, Compose v2 | Rust y un compilador de C; Chrome y Node 22+ opcionales |
| API | v2 en el puerto 3002 | v2 en el puerto 3002 (scrape, map, crawl, batch scrape, health) |
| Ruta de búsqueda | Incluida en el stack predeterminado | Redirigida a Firecrawl Cloud |
Formatos LLM (json, summary) |
Conecta un proveedor compatible con OpenAI o Ollama | Se omiten con una advertencia |
| Capturas de pantalla | Requieren Fire-engine, que no está en el stack predeterminado | Funcionan si Chrome está instalado |
actions del navegador |
Requieren Fire-engine | Se ignoran |
| Almacenamiento de trabajos | Cola respaldada por Postgres | En memoria, caduca a la hora |
| Alexandria | No incluida en la tabla de funciones de autoalojamiento | Mediante Firecrawl Cloud con una cuenta gratuita |
| Configuración de MCP | Apunta el servidor MCP a tu URL | firecrawl-local init escribe la configuración |
| Licencia | AGPL-3.0 | AGPL-3.0 |
Local cambia profundidad por ligereza: conserva las rutas que los agentes usan más y descarta lo que necesita una cola, un modelo o una granja de navegadores.
Qué ha cambiado: de cinco servicios a un único binario
La ruta de autoalojamiento fija la versión v2.11.162 en su guía. Clonas el repositorio, escribes un pequeño .env con las credenciales de Postgres y USE_DB_AUTHENTICATION=false, y luego compilas e inicias el stack:
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
docker compose up --build -d
docker compose ps --all
Ese archivo compose inicia un contenedor api (que también ejecuta los workers), un playwright-service para el renderizado, redis, rabbitmq y nuq-postgres para la cola de trabajos. El archivo compose limita la API a 4 CPU y 8 GB de memoria y el servicio Playwright a 2 CPU y 4 GB, y la guía señala que esos límites "no son requisitos mínimos verificados".
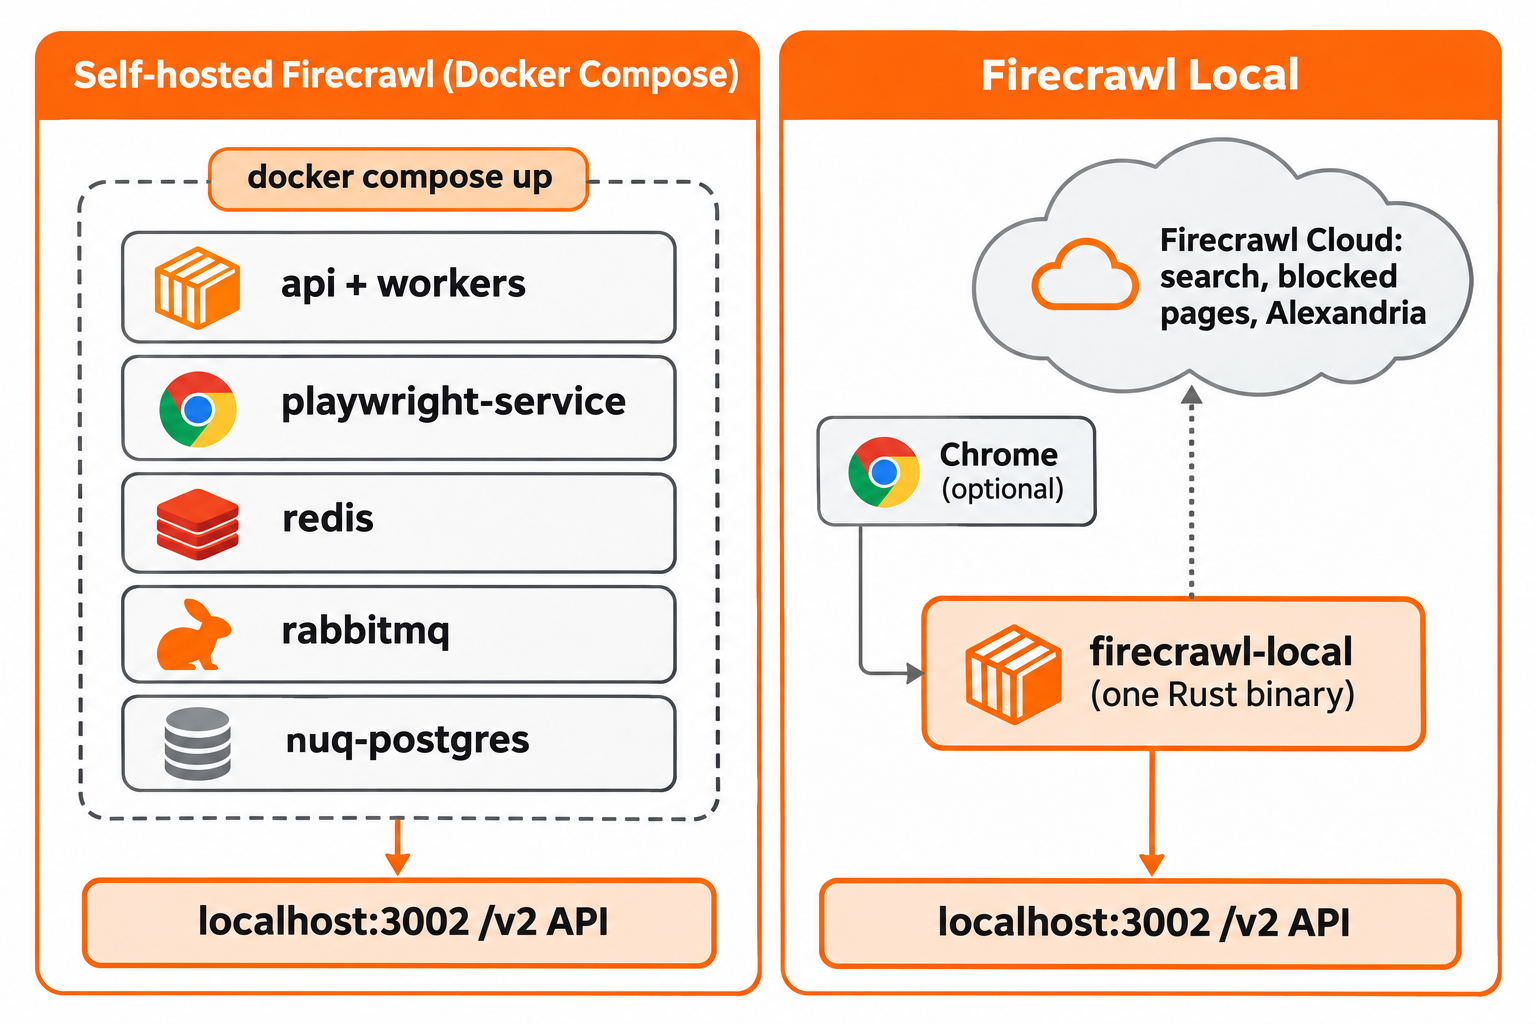
Firecrawl Local lo condensa todo en un solo comando:
cargo install firecrawl-local
firecrawl-local scrape https://example.com --markdown
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
firecrawl-local map https://firecrawl.dev
firecrawl-local serve
No hay .env ni contenedores. Las páginas JavaScript se renderizan en el Chrome o Chromium que ya tengas; si no tienes ninguno, las páginas estáticas siguen funcionando y el resto devuelve una advertencia.
Los comandos search, find-tools, data y login acceden a Firecrawl Cloud. firecrawl-local login reutiliza las credenciales de la CLI alojada de nuestra guía de instalación de Firecrawl CLI.
Cobertura de endpoints: qué sirve cada uno
Aquí es donde las migraciones se rompen, así que compruébalo antes de cambiar la URL base de un SDK.
Firecrawl Local sirve estas rutas en tu máquina:
POST /v2/scrapescrapea una URLPOST /v2/maplista las URLs de un sitioPOST /v2/crawl, además deGETyDELETE /v2/crawl/{id}POST /v2/batch/scrape, además deGETyDELETE /v2/batch/scrape/{id}GET /health
Cualquier otra ruta /v2, como /v2/search, se redirige a Firecrawl Cloud a menos que FIRECRAWL_CLOUD indique lo contrario. Las rutas v0 y v1 no se sirven en absoluto.
Firecrawl autoalojado cubre scrape, crawl, map y search básicos en su stack predeterminado, según la página de código abierto vs cloud. La extracción con LLM requiere un proveedor que conectes tú. Agent, Browser, Interact y el panel de control no están incluidos.
Dos trampas prácticas:
- Las comprobaciones de salud son distintas. La guía de autoalojamiento comprueba la disponibilidad en
/v0/health/readiness. Firecrawl Local no sirve v0, así que usaGET /healthen su lugar. Actualiza tus monitores y los healthchecks de compose. - La búsqueda cambia de lugar de ejecución. En el stack de Docker, la búsqueda se queda en tu infraestructura. En Local, va a Firecrawl Cloud, y la búsqueda sin clave tiene límite de peticiones. Configura
FIRECRAWL_CLOUD=offsi nada debe salir de la máquina; la búsqueda entonces deja de funcionar.
Velocidad y memoria: lee las afirmaciones con cuidado
La publicación de lanzamiento en X de Firecrawl dice que Firecrawl Local es "una primitiva de scrape en Rust 37 veces más rápida (frente a la autoalojada)" y que usa "230 veces menos memoria (11 MB en reposo)". La publicación acumuló unas 324K vistas y 3,2K me gusta en su primer día.
Toma esas cifras como afirmaciones de Firecrawl. El README no publica ningún método de benchmark, ni conjunto de páginas ni hardware, así que no podemos decirte qué midió el "37x". Lo que la arquitectura sí respalda es la dirección: un único proceso en reposo debería pesar mucho menos que cinco contenedores cuyos límites de compose permiten hasta 12 GB solo entre los servicios de API y Playwright.
Si la velocidad decide tu elección, mídelo con tus propias URLs. Ejecuta el mismo scrape contra ambos servidores, compara los tiempos y comprueba que el markdown coincida. La sección sobre Apidog CLI de abajo muestra una forma de convertir eso en una prueba repetible.
Seguridad, cesión a la nube y flujo de datos
El autoalojamiento te da control total y responsabilidad total. El quickstart de la guía desactiva la autenticación y advierte que "no es una arquitectura para producción", así que los volúmenes persistentes, la autenticación, TLS y la monitorización corren de tu cuenta.
Firecrawl Local viene con valores predeterminados más estrictos para una sola máquina:
servese vincula a127.0.0.1y rechaza localhost y las direcciones privadas a menos que pases--allow-private.- Las direcciones link-local y de metadatos de la nube están bloqueadas en todos los modos, incluso después de redirecciones.
scrape,crawlymcpaceptan--public-only, que el README recomienda cuando un agente navega por sitios en los que no confías.- Los crawls respetan
robots.txt.
El precio a pagar es la cesión a la nube. Con el valor predeterminado FIRECRAWL_CLOUD=auto, la búsqueda, las páginas que bloquean tu máquina y Alexandria van a Firecrawl Cloud. Esos resultados llevan "source": "firecrawl-cloud". Configura FIRECRAWL_CLOUD=search para permitir solo la búsqueda, u off para no enviar nada.
Alexandria, el catálogo de proveedores de datos de Firecrawl, requiere una cuenta gratuita y firecrawl-local login. Nuestra explicación de Firecrawl Alexandria cubre qué devuelve.
¿Cuál deberías elegir?
Elige Firecrawl Local si:
- Quieres que un agente de IA haga scrape y crawl en tu portátil.
firecrawl-local initañade el servidor MCP a Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI y Codex, haciendo copia de seguridad de cada configuración primero. - Ejecutas trabajos cortos que terminan en menos de una hora.
- Solo necesitas markdown, HTML, HTML en bruto y enlaces.
- No quieres encargarte de Postgres, Redis y RabbitMQ.
Mantén Firecrawl autoalojado si:
- Los trabajos de crawl deben sobrevivir a un reinicio o durar más de una hora.
- Necesitas salida
jsonosummarya través de tu propio modelo. - La búsqueda debe quedarse en tu infraestructura.
- Varios servicios o usuarios comparten un mismo backend de scraping detrás de tu autenticación.
Muchos equipos ejecutarán ambos: Local en portátiles y en agentes, el stack de Docker o Firecrawl Cloud en producción. Para configuraciones de agentes que solo necesitan búsqueda, nuestra recopilación de búsqueda web de código abierto para Claude incluye otras opciones, y la guía de Firecrawl MCP y llms.txt cubre el servidor MCP alojado.
Migrar el código del SDK del autoalojado a Local
Tu código del SDK no cambia, solo la URL: configura la URL de la API del SDK de Python o Node a http://localhost:3002, sin clave de API para las rutas locales. Antes de cambiarla, confirma que tu código no hace llamadas v0 o v1, nunca pide json, summary ni actions, y nunca consulta un ID de crawl con más de una hora de antigüedad ni que cruce un reinicio de serve.
Deja que tu agente de programación ejecute una prueba de paridad con Apidog CLI
Cambiar de backend es una cuestión de contrato: ¿/v2/scrape en Local devuelve la misma forma que tu código ya analiza? No compares respuestas a mano. Ejecuta ambos servidores en paralelo (Docker en 3002, firecrawl-local serve --port 3012) y deja que tu agente de programación pruebe ambos con Apidog CLI.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Luego dale a tu agente un único prompt:
Self-hosted Firecrawl runs on http://localhost:3002 and Firecrawl Local on
http://localhost:3012. In Apidog project <id>, create two environments,
"self-hosted" and "local". Add test cases for POST /v2/scrape on
https://example.com (assert 200, success: true, non-empty data.markdown) and
POST /v2/map (assert 200 and a non-empty links array). Run the cases against
both environments and tell me every assertion that differs.
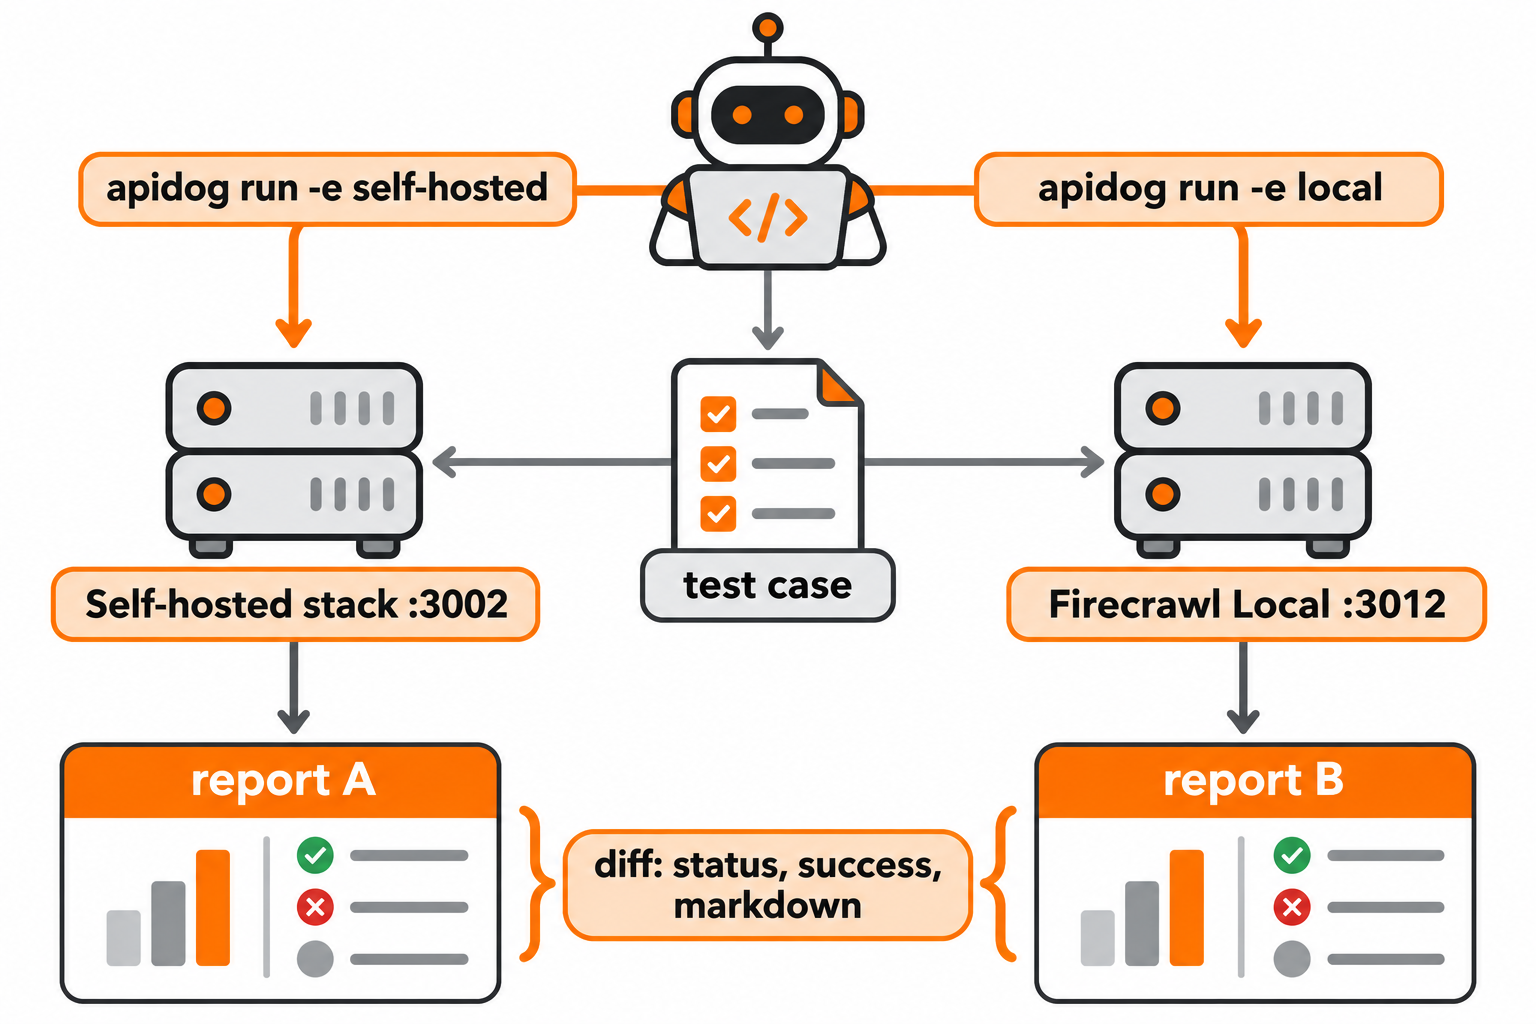
El agente lee el esquema de la carga útil, lo valida y ejecuta el mismo caso dos veces:
firecrawl-local serve --port 3012 &
apidog environment create self-hosted --project <id> --base-url http://localhost:3002
apidog environment create local --project <id> --base-url http://localhost:3012
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file scrape-case.json
apidog test-case create --project <id> --file scrape-case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json --out-file self-hosted
apidog run --test-case <caseId> --project <id> -e <localEnvId> -r cli,json --out-file local
Apidog CLI envía las peticiones desde tu máquina, así que ambos puertos de localhost son accesibles. Cambia -r cli,json por -r junit y la misma comprobación se ejecuta en CI con cada actualización de Firecrawl; nuestra guía de Apidog CLI para pipelines de CI/CD muestra la configuración, y Apidog CLI en Claude Code cubre el lado del agente. El plan gratuito de Apidog cubre equipos de hasta 4 usuarios.
Preguntas frecuentes
¿Firecrawl Local reemplaza al Firecrawl autoalojado? No. Es una compilación independiente en apps/local. El servidor completo en apps/api y su guía de autoalojamiento no cambian, y sigues necesitándolo para trabajos persistentes y formatos de LLM.
¿Es Firecrawl Local realmente 37 veces más rápido que el Firecrawl autoalojado? Esa es la afirmación de Firecrawl en su publicación de lanzamiento, junto con 230 veces menos memoria y 11 MB en reposo. El README no publica ningún método de benchmark, así que pruébalo con tus propias URLs.
¿Funciona Firecrawl Local sin la nube? Sí. Configura FIRECRAWL_CLOUD=off y el scrape, el crawl y el map se quedan en tu máquina. La búsqueda, el recurso alternativo para páginas bloqueadas y Alexandria dejan de funcionar.
¿Es gratuito el Firecrawl autoalojado? El código es gratuito bajo AGPL-3.0, tanto el del servidor como el de Local. Pagas por las máquinas y el tiempo de ejecutar Postgres, Redis y RabbitMQ por tu cuenta.
¿Cuál debería usar un agente de IA? Firecrawl Local, en la mayoría de los casos. firecrawl-local init lo registra como servidor MCP en seis herramientas de agentes, y --public-only impide que un agente llegue a tu red privada.