ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna se reduce a tres ofertas distintas. ERNIE 5.5 Flash Preview es gratis de llamar hoy mismo en OpenRouter. DeepSeek V4.1 Flash te ofrece pesos abiertos bajo MIT y precios de $0.30/$1.20 por 1M de tokens en horario pico, la mitad fuera de horario pico. GPT-6 Luna tiene el precio de lista más bajo: $0.10 de entrada, $0.50 de salida.
Los tres aceptan alrededor de 1M de tokens de contexto y llaman herramientas. Se diferencian en estructura de precios, pesos y madurez. Todos los precios a continuación se leyeron de las páginas oficiales el 12 de noviembre de 2026, y la última sección muestra a tu agente de código probando los tres con un solo prompt.
ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna de un vistazo
| ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna | |
|---|---|---|---|
| ID de modelo de API | baidu/ernie-5.5-flash-preview:free (OpenRouter) |
deepseek-flash |
gpt-6-luna |
| Entrada por 1M | Gratis en OpenRouter; precio de pago [VERIFY] | $0.30 en horario pico, $0.15 fuera de pico | $0.10 |
| Entrada en caché por 1M | n/d en el endpoint gratuito | $0.006 en horario pico, $0.003 fuera de pico | $0.01 |
| Salida por 1M | Gratis en OpenRouter; precio de pago [VERIFY] | $1.20 en horario pico, $0.60 fuera de pico | $0.50 |
| Ventana de contexto | 1,024,000 tokens | 1M de tokens | 1,050,000 tokens |
| Salida máxima | 1,024,000 (listado de OpenRouter) | 384K | 128,000 |
| Parámetros | 280B totales, 14B activos (MoE) | 552B backbone, 8B activos en prefill / 16B en decode | No publicado |
| Tipos de entrada | Texto | Texto, imagen | Texto, imagen |
| Pesos abiertos | Modelo base sí; Preview «pronto» bajo Apache 2.0 | Sí, MIT | No |
| Estado | Checkpoint de vista previa | Producción (versión 1017) | Producción |
Fuentes: la publicación de lanzamiento de Baidu, OpenRouter, precios de DeepSeek y la página de Luna de OpenAI.
Qué es cada modelo económico
ERNIE 5.5 Flash Preview es el primer modelo post-entrenado de Baidu sobre la base ERNIE 5.5 Flash Base que lanzó en Hugging Face a principios de noviembre. Es un modelo sparse mixture-of-experts de 280B con 14B de parámetros activos y un contexto de 1M de tokens. Baidu lo llama un checkpoint intermedio: el post-entrenamiento no está terminado. Antecedentes: qué es ERNIE 5.5 Flash y el anterior ERNIE 5.1.
DeepSeek V4.1 Flash es un MoE multimodal con 552B de parámetros backbone. Activa 8B de parámetros por token durante el prefill y 16B durante el decode, lo que mantiene bajo el costo del trabajo de agentes con mucha entrada. Los pesos están bajo MIT en Hugging Face. Consulta la explicación de DeepSeek V4.1 Flash.
GPT-6 Luna es el «modelo más eficiente de OpenAI para tareas enfocadas y de alto volumen». Acepta texto e imágenes, admite un esfuerzo de razonamiento desde none hasta max, y funciona con las herramientas de la Responses API. Consulta qué es GPT-6 Luna.
Precio por 1M de tokens y cuánto cuesta una llamada real de agente
Los bucles de agente reenvían el mismo contexto largo en cada paso, así que la caché y las reglas de horario importan tanto como la tarifa principal.
- GPT-6 Luna: $0.10 de entrada, $0.01 de entrada en caché, $0.125 por escrituras de caché, $0.50 de salida. Los prompts de más de 272K tokens de entrada cuestan 2x en entrada y 1.5x en salida para toda la solicitud. Batch y Flex corren al 50% del precio estándar.
- DeepSeek V4.1 Flash: $0.30 de entrada (fallo de caché), $0.006 acierto de caché, $1.20 de salida en horario pico. Las tarifas fuera de pico son la mitad. El horario pico es de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes; todo lo demás, incluidos los fines de semana, es fuera de pico.
- ERNIE 5.5 Flash Preview: $0 de entrada y salida en el endpoint
:freede OpenRouter, que OpenRouter indica que tiene límites de tasa. Baidu no ha publicado un precio de pago por token en una página que pudiéramos leer hoy, así que trata cualquier número que veas en otro lugar como [VERIFY].
Toma un paso de agente con 50,000 tokens de entrada y 2,000 de salida, sin caché:
| Modelo | Costo por llamada | Costo por 1,000 llamadas |
|---|---|---|
| GPT-6 Luna | $0.0060 | $6.00 |
| DeepSeek V4.1 Flash, horario pico | $0.0174 | $17.40 |
| DeepSeek V4.1 Flash, fuera de pico | $0.0087 | $8.70 |
ERNIE 5.5 Flash Preview, :free |
$0 | $0 (dentro de los límites de tasa) |
Ahora supón que el 90% de esa entrada es acierto de caché, algo normal para un agente que releer el mismo repositorio. Luna baja a unos $0.0020 por llamada (más una escritura de caché única). DeepSeek baja a unos $0.0042 en horario pico y $0.0021 fuera de pico. La brecha entre los dos modelos de pago casi se cierra fuera de pico.
Dos advertencias: cada proveedor tiene su propio tokenizador, así que los conteos de tokens difieren para el mismo prompt, y los tokens de razonamiento se facturan como salida, por lo que un esfuerzo de razonamiento alto infla la línea de salida. Nuestro desglose de precios de DeepSeek V4.1 Flash y la comparación del nivel de API por menos de $1 profundizan en el cálculo de caché.
Ventana de contexto, longitud de salida y velocidad
El contexto no decidirá esto. Los límites de salida difieren más: 384K para DeepSeek, 128,000 para Luna y 1,024,000 listados para el endpoint gratuito de ERNIE. Las afirmaciones de velocidad requieren cuidado:
- ERNIE 5.5 Flash Preview: la descripción del modelo en OpenRouter dice más de 200 tokens por segundo. El rendimiento P50 medido por el propio OpenRouter en los últimos 3 días fue de 79 tokens por segundo, con una latencia P50 de 2.53 segundos, en un solo proveedor (Baidu Qianfan).
- DeepSeek V4.1 Flash: sin cifra de tokens por segundo en la página de precios; lista un límite de concurrencia de 2,500.
- GPT-6 Luna: OpenAI la califica como «Fast», con límites del nivel Build de 5,000 solicitudes y 2,000,000 de tokens por minuto.
Mide desde tu propia región con tus propios prompts; la sección de Apidog a continuación te prepara para eso.
Pesos abiertos, acceso gratuito y licencias
- DeepSeek V4.1 Flash es el único con pesos de producción que puedes descargar hoy, bajo la licencia MIT. Autoalojalo o elige un proveedor alojado desde su tarjeta de Hugging Face.
- ERNIE 5.5 Flash tiene dos artefactos. El modelo Base (solo preentrenamiento, 33.5T de tokens) ya está en Hugging Face. El Preview, el modelo de chat y agentes, aún no tiene pesos públicos; Baidu dice que se abrirán bajo Apache 2.0 «pronto». Una fecha que puedes ver en línea no está confirmada [VERIFY].
- GPT-6 Luna es cerrada. Se accede a través de la API de OpenAI o Amazon Bedrock, y el nivel gratuito de la API figura como «Not supported».
Para pruebas a $0, el endpoint :free de ERNIE es la puerta más fácil. DeepSeek y Luna tienen sus propias rutas gratuitas, cubiertas en cómo usar DeepSeek V4.1 Flash gratis y cómo usar GPT-6 Luna gratis.
Mejor encaje para agentes y programación
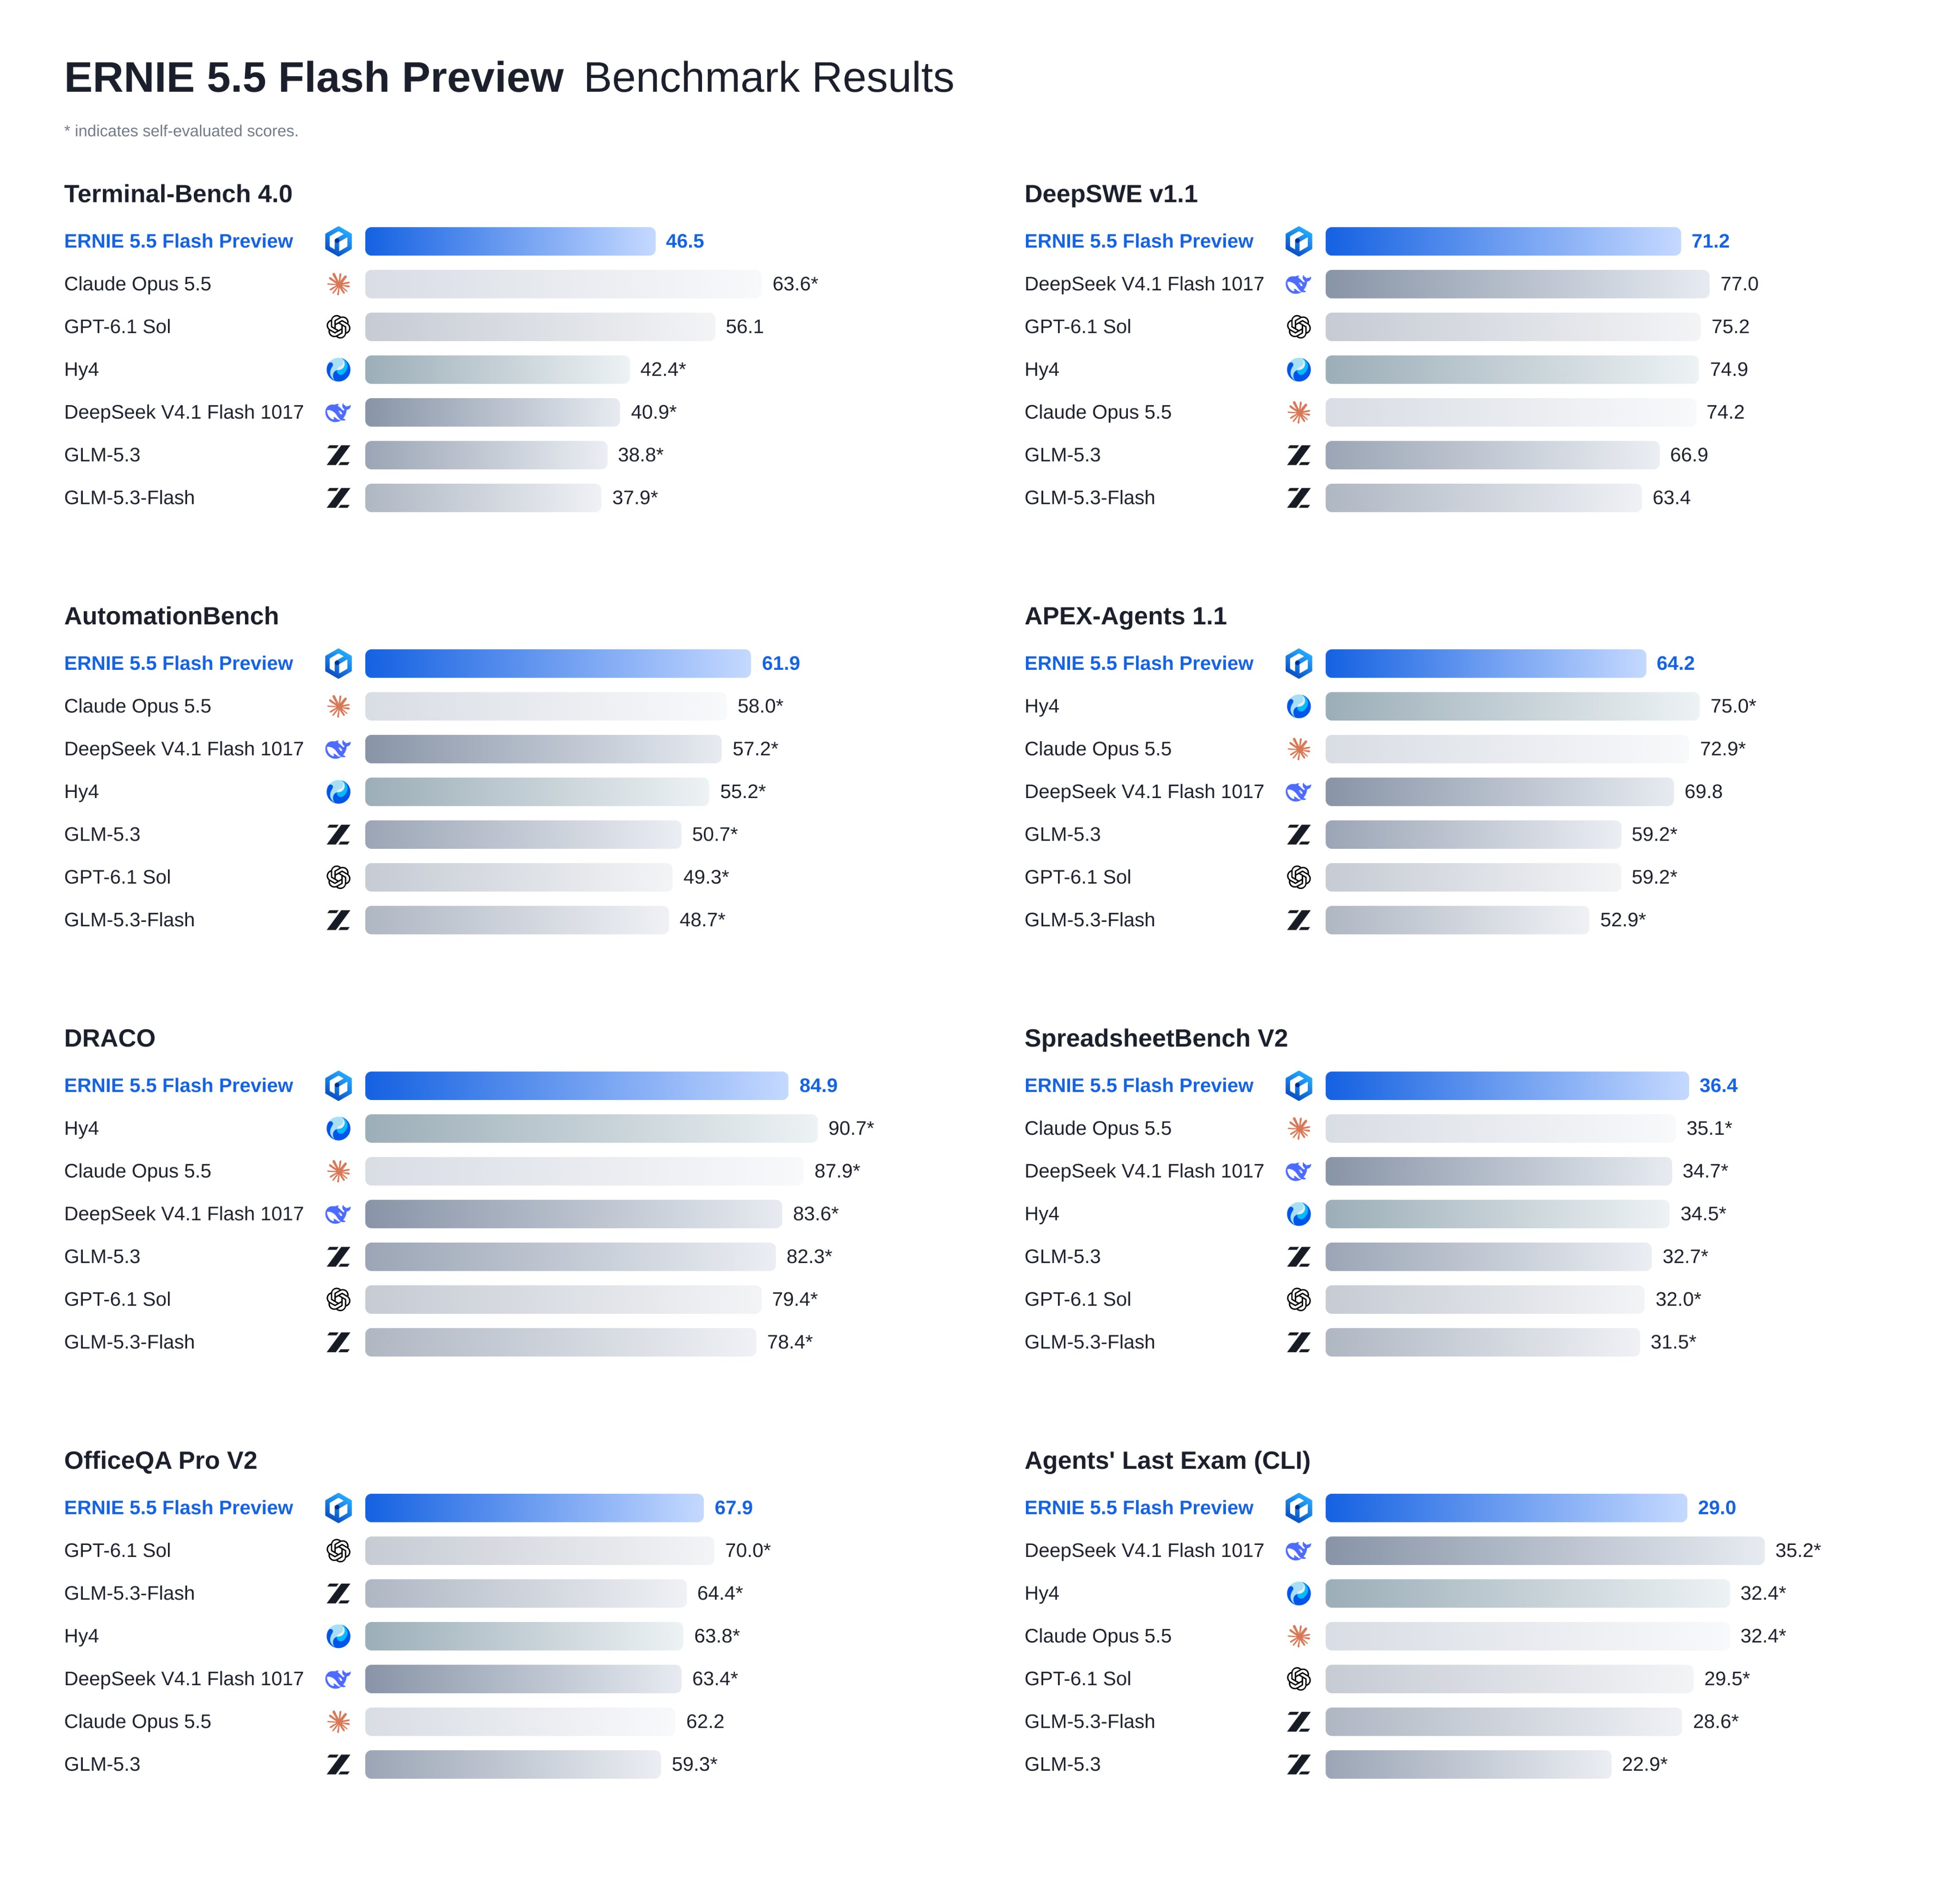
Cada proveedor hace benchmarks en su propio entorno, así que no alinees esos números como una sola prueba. Compara lo que cada uno enfatiza.
DeepSeek V4.1 Flash reporta 90.6 en Terminal-Bench 2.1 y 74.2 en DeepSWE v1.1 con esfuerzo de razonamiento máximo, ambos medidos por DeepSeek en su propio entorno. El esfuerzo de razonamiento es un dial de 1 a 100, y el endpoint habla formatos de OpenAI, Anthropic y Responses, así que se integra en Claude Code, Codex u OpenCode.
ERNIE 5.5 Flash Preview se muestra en la página de lanzamiento de Baidu construyendo un juego de Unreal Engine 5.8 en una sola tarea de programación de 11 horas y casi 100 minijuegos móviles a partir de documentos de diseño. Es solo de texto, así que los bucles de agentes basados en capturas de pantalla están descartados por ahora. El panel de OpenRouter también mostró una tasa de error de salida estructurada del 21.70% y una tasa de error de llamadas a herramientas del 1.01% en 3 días, así que valida las salidas JSON antes de confiar en ellas en un pipeline.
GPT-6 Luna gana en amplitud de herramientas. La Responses API le da shell alojado, apply patch, computer use y MCP. Una limitación: en Chat Completions, el function calling solo funciona con reasoning_effort configurado en none; usa la Responses API para herramientas con el razonamiento activado.
¿Qué modelo económico deberías elegir?
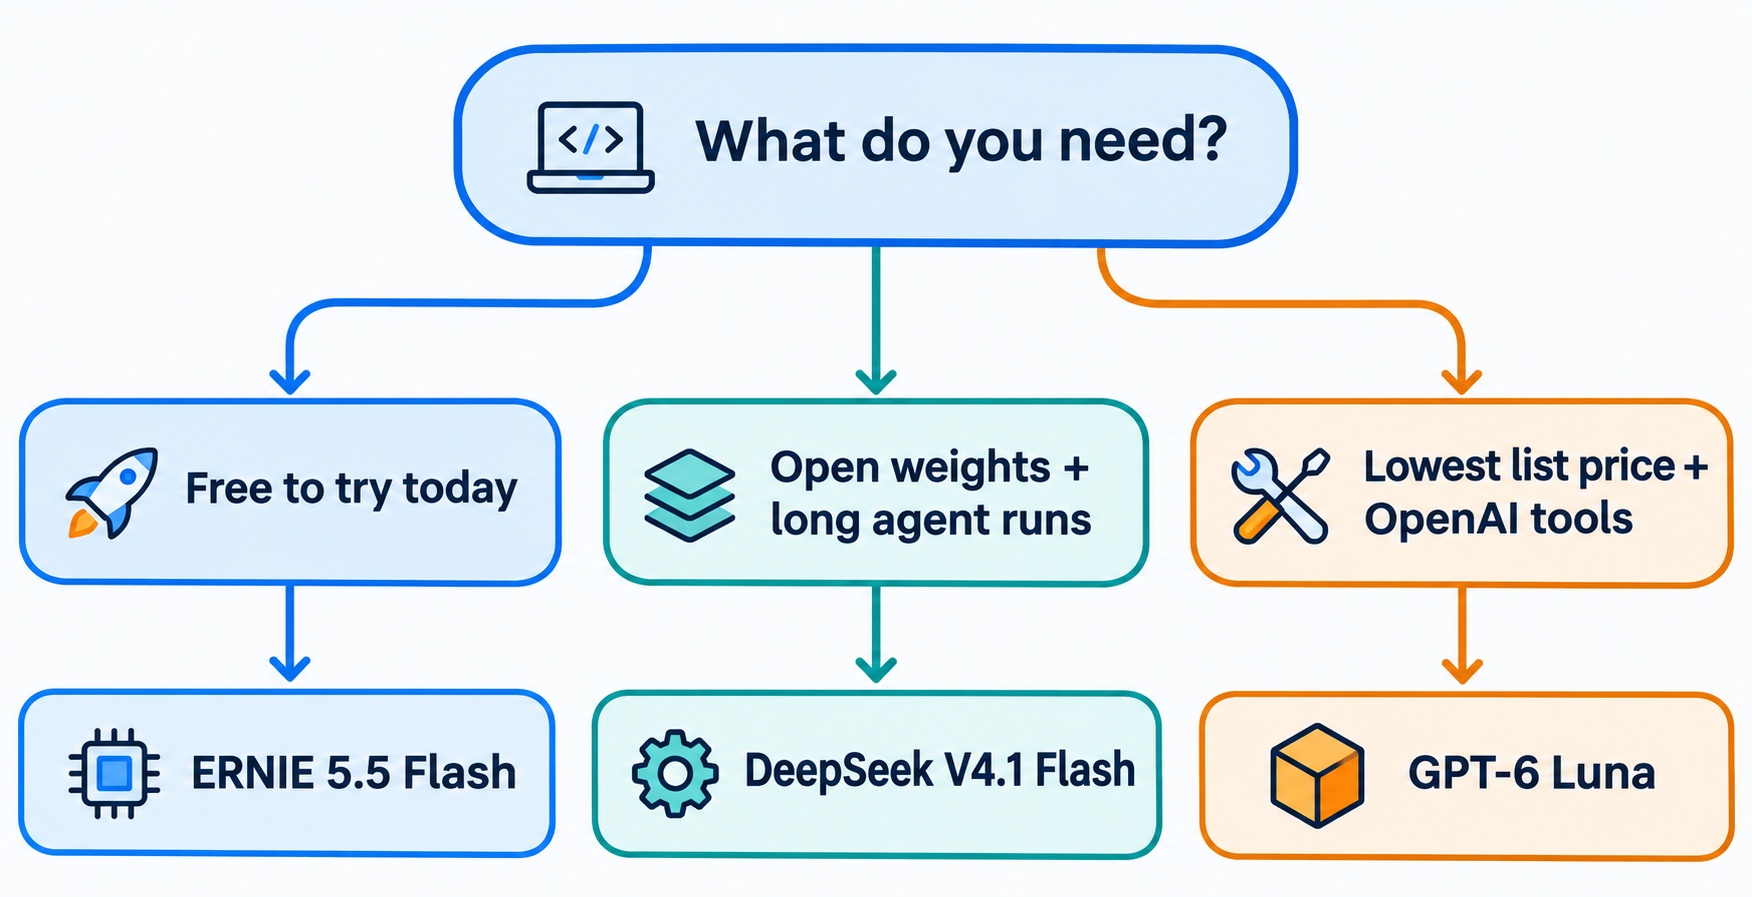
Elige por restricción, no por tabla de clasificación:
- Quieres probar un modelo nuevo a $0 hoy: ERNIE 5.5 Flash Preview en OpenRouter. Espera comportamiento de vista previa y límites de tasa.
- Necesitas pesos abiertos o planeas autoalojar: DeepSeek V4.1 Flash.
- Tu agente ejecuta sesiones largas con mucha entrada y puedes programar fuera de pico: DeepSeek V4.1 Flash, donde los aciertos de caché fuera de pico cuestan $0.003 por 1M.
- Quieres el precio de lista más bajo y las herramientas alojadas de OpenAI: GPT-6 Luna.
- Necesitas entrada de imagen: DeepSeek V4.1 Flash o GPT-6 Luna, no ERNIE.
Deja que tu agente de código compare los tres con Apidog CLI
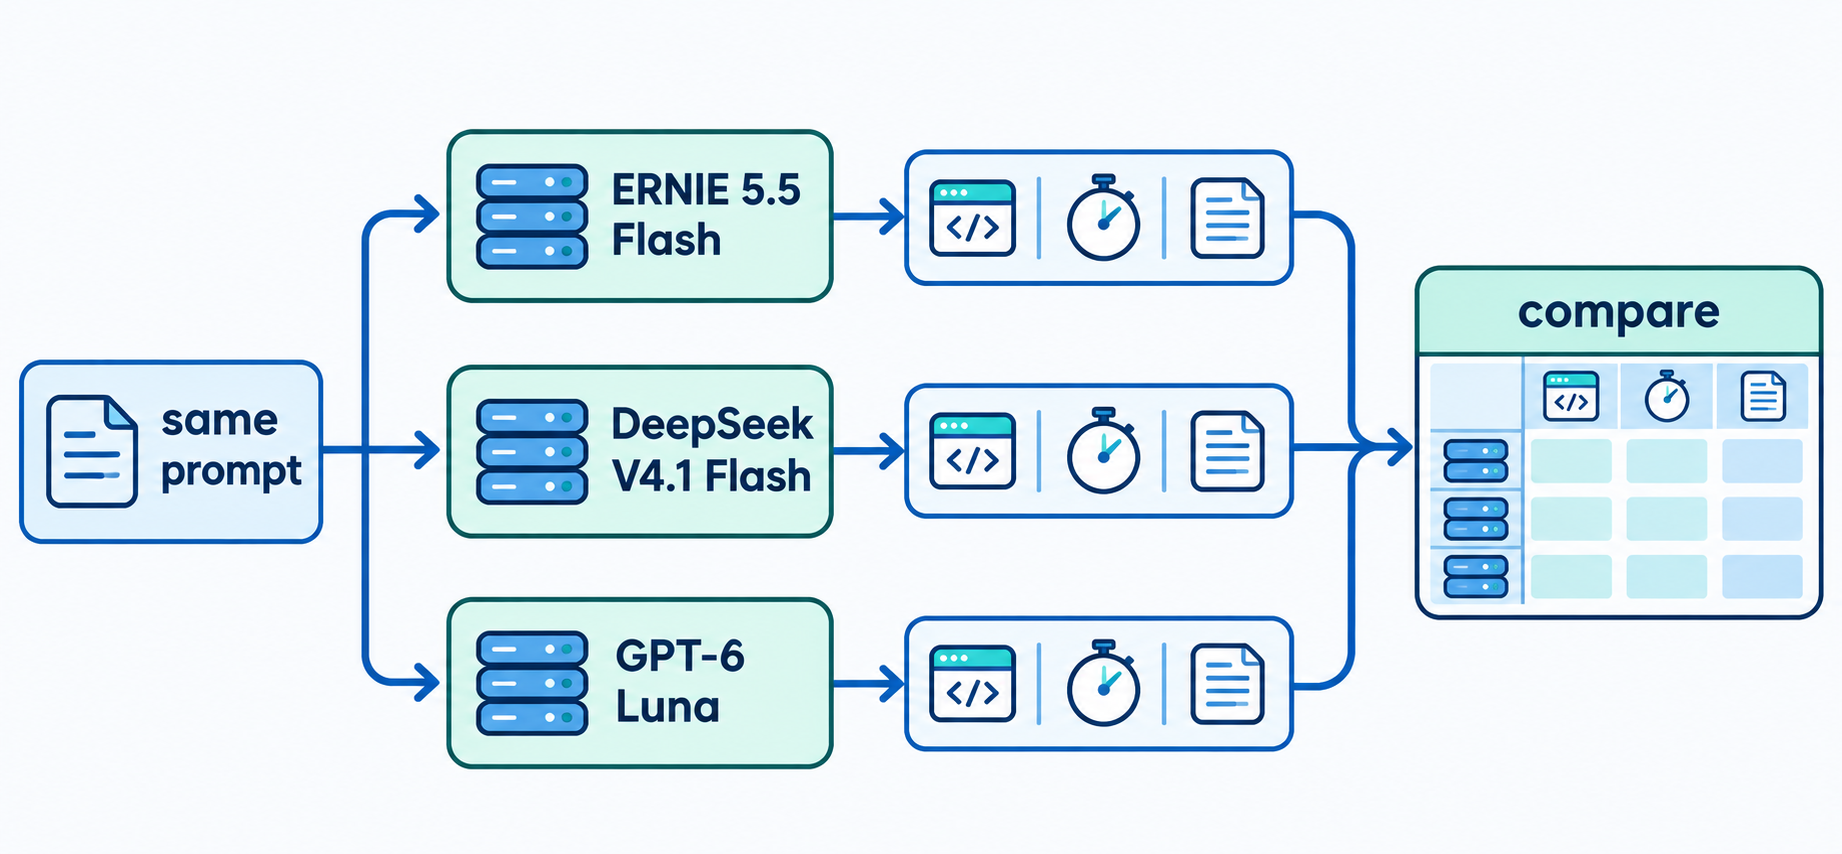
No hagas clic manualmente en tres llamadas de API cada vez que se actualiza un modelo. Deja que Claude Code, Codex o Cursor construyan un escenario y lo ejecuten contra cada proveedor con Apidog CLI. Los tres hablan OpenAI Chat Completions, así que solo cambian la URL base, el ID del modelo y la clave.
Configura la CLI una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Luego dale a tu agente un solo prompt:
In Apidog project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
El agente crea los entornos, verifica el payload del escenario contra el esquema, lo escribe y lo ejecuta:
apidog environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apidog environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apidog environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
Pasar claves con --env-var las mantiene fuera del entorno compartido. Repite la ejecución por entorno con la clave de ese proveedor; los reportes JSON alimentan tu tabla. El mismo comando de ejecución con -r junit se integra en CI; consulta la guía de CI/CD de Apidog CLI y el paso a paso de configuración con Claude Code. El plan Free de Apidog cubre hasta 4 usuarios, así que un equipo pequeño puede ejecutar esto sin un asiento de pago.
FAQ
¿ERNE 5.5 Flash es más barato que DeepSeek V4.1 Flash? Ahora mismo, sí: el endpoint :free de OpenRouter cuesta $0 dentro de sus límites de tasa. Baidu no ha publicado un precio de pago que pudiéramos verificar, así que una comparación de pago contra pago aún no es posible.
¿Cuál tiene la ventana de contexto más grande? Están muy cerca. GPT-6 Luna lista 1,050,000 tokens, ERNIE 5.5 Flash Preview 1,024,000 en OpenRouter, y DeepSeek V4.1 Flash 1M. El precio de Luna se duplica en entrada que pase de 272K tokens.
¿Puedo ejecutar alguno de estos modelos localmente? DeepSeek V4.1 Flash, sí: pesos MIT en Hugging Face. Los pesos de ERNIE 5.5 Flash Base son públicos, pero el modelo de chat Preview aún no se ha lanzado. GPT-6 Luna no tiene pesos públicos.
¿Cuál es mejor para agentes de código? Depende de tu entorno. DeepSeek V4.1 Flash reporta puntuaciones agénticas fuertes en sus propias pruebas y admite formatos de OpenAI y Anthropic. GPT-6 Luna tiene el conjunto más amplio de herramientas alojadas. ERNIE 5.5 Flash Preview es gratis de probar, pero es solo de texto y sigue en vista previa.
¿GPT-6 Luna tiene un nivel de API gratuito? No. La página del modelo de OpenAI lista el nivel Free como «Not supported». El uso de pago empieza en $0.10 por 1M de tokens de entrada.