
La API de ERNIE 5.5 Flash ya está disponible en dos lugares: Baidu Qianfan, donde llamas a ernie-5.5-flash-preview en https://qianfan.baidubce.com/v2/chat/completions, y OpenRouter, donde baidu/ernie-5.5-flash-preview:free cuesta $0 por token. Ambos hablan el formato de Chat Completions de OpenAI, así que puedes apuntar el SDK oficial de OpenAI a cualquiera de los dos cambiando la URL base, la clave y el nombre del modelo.
A continuación: claves, primeras solicitudes en curl, Python y JavaScript, streaming, tokens de razonamiento, la ventana de 1M y errores. Cada campo y límite proviene de las páginas oficiales de Qianfan y OpenRouter, verificados el 12 de noviembre de 2026.
Para más contexto, lee qué es ERNIE 5.5 Flash, o la guía de la API de ERNIE 5.1 para la generación anterior.
¿Qué es la API de ERNIE 5.5 Flash?
La API de ERNIE 5.5 Flash es el endpoint alojado de Baidu para ERNIE 5.5 Flash Preview, un modelo sparse de mezcla de expertos (mixture-of-experts) con 280B de parámetros totales, 14B activos por token y un contexto de 1M de tokens. Baidu lo lanzó el 11 de noviembre de 2026 como el primer modelo post-entrenado construido sobre ERNIE 5.5 Flash Base, y lo ofrece a través de Qianfan y OpenRouter.
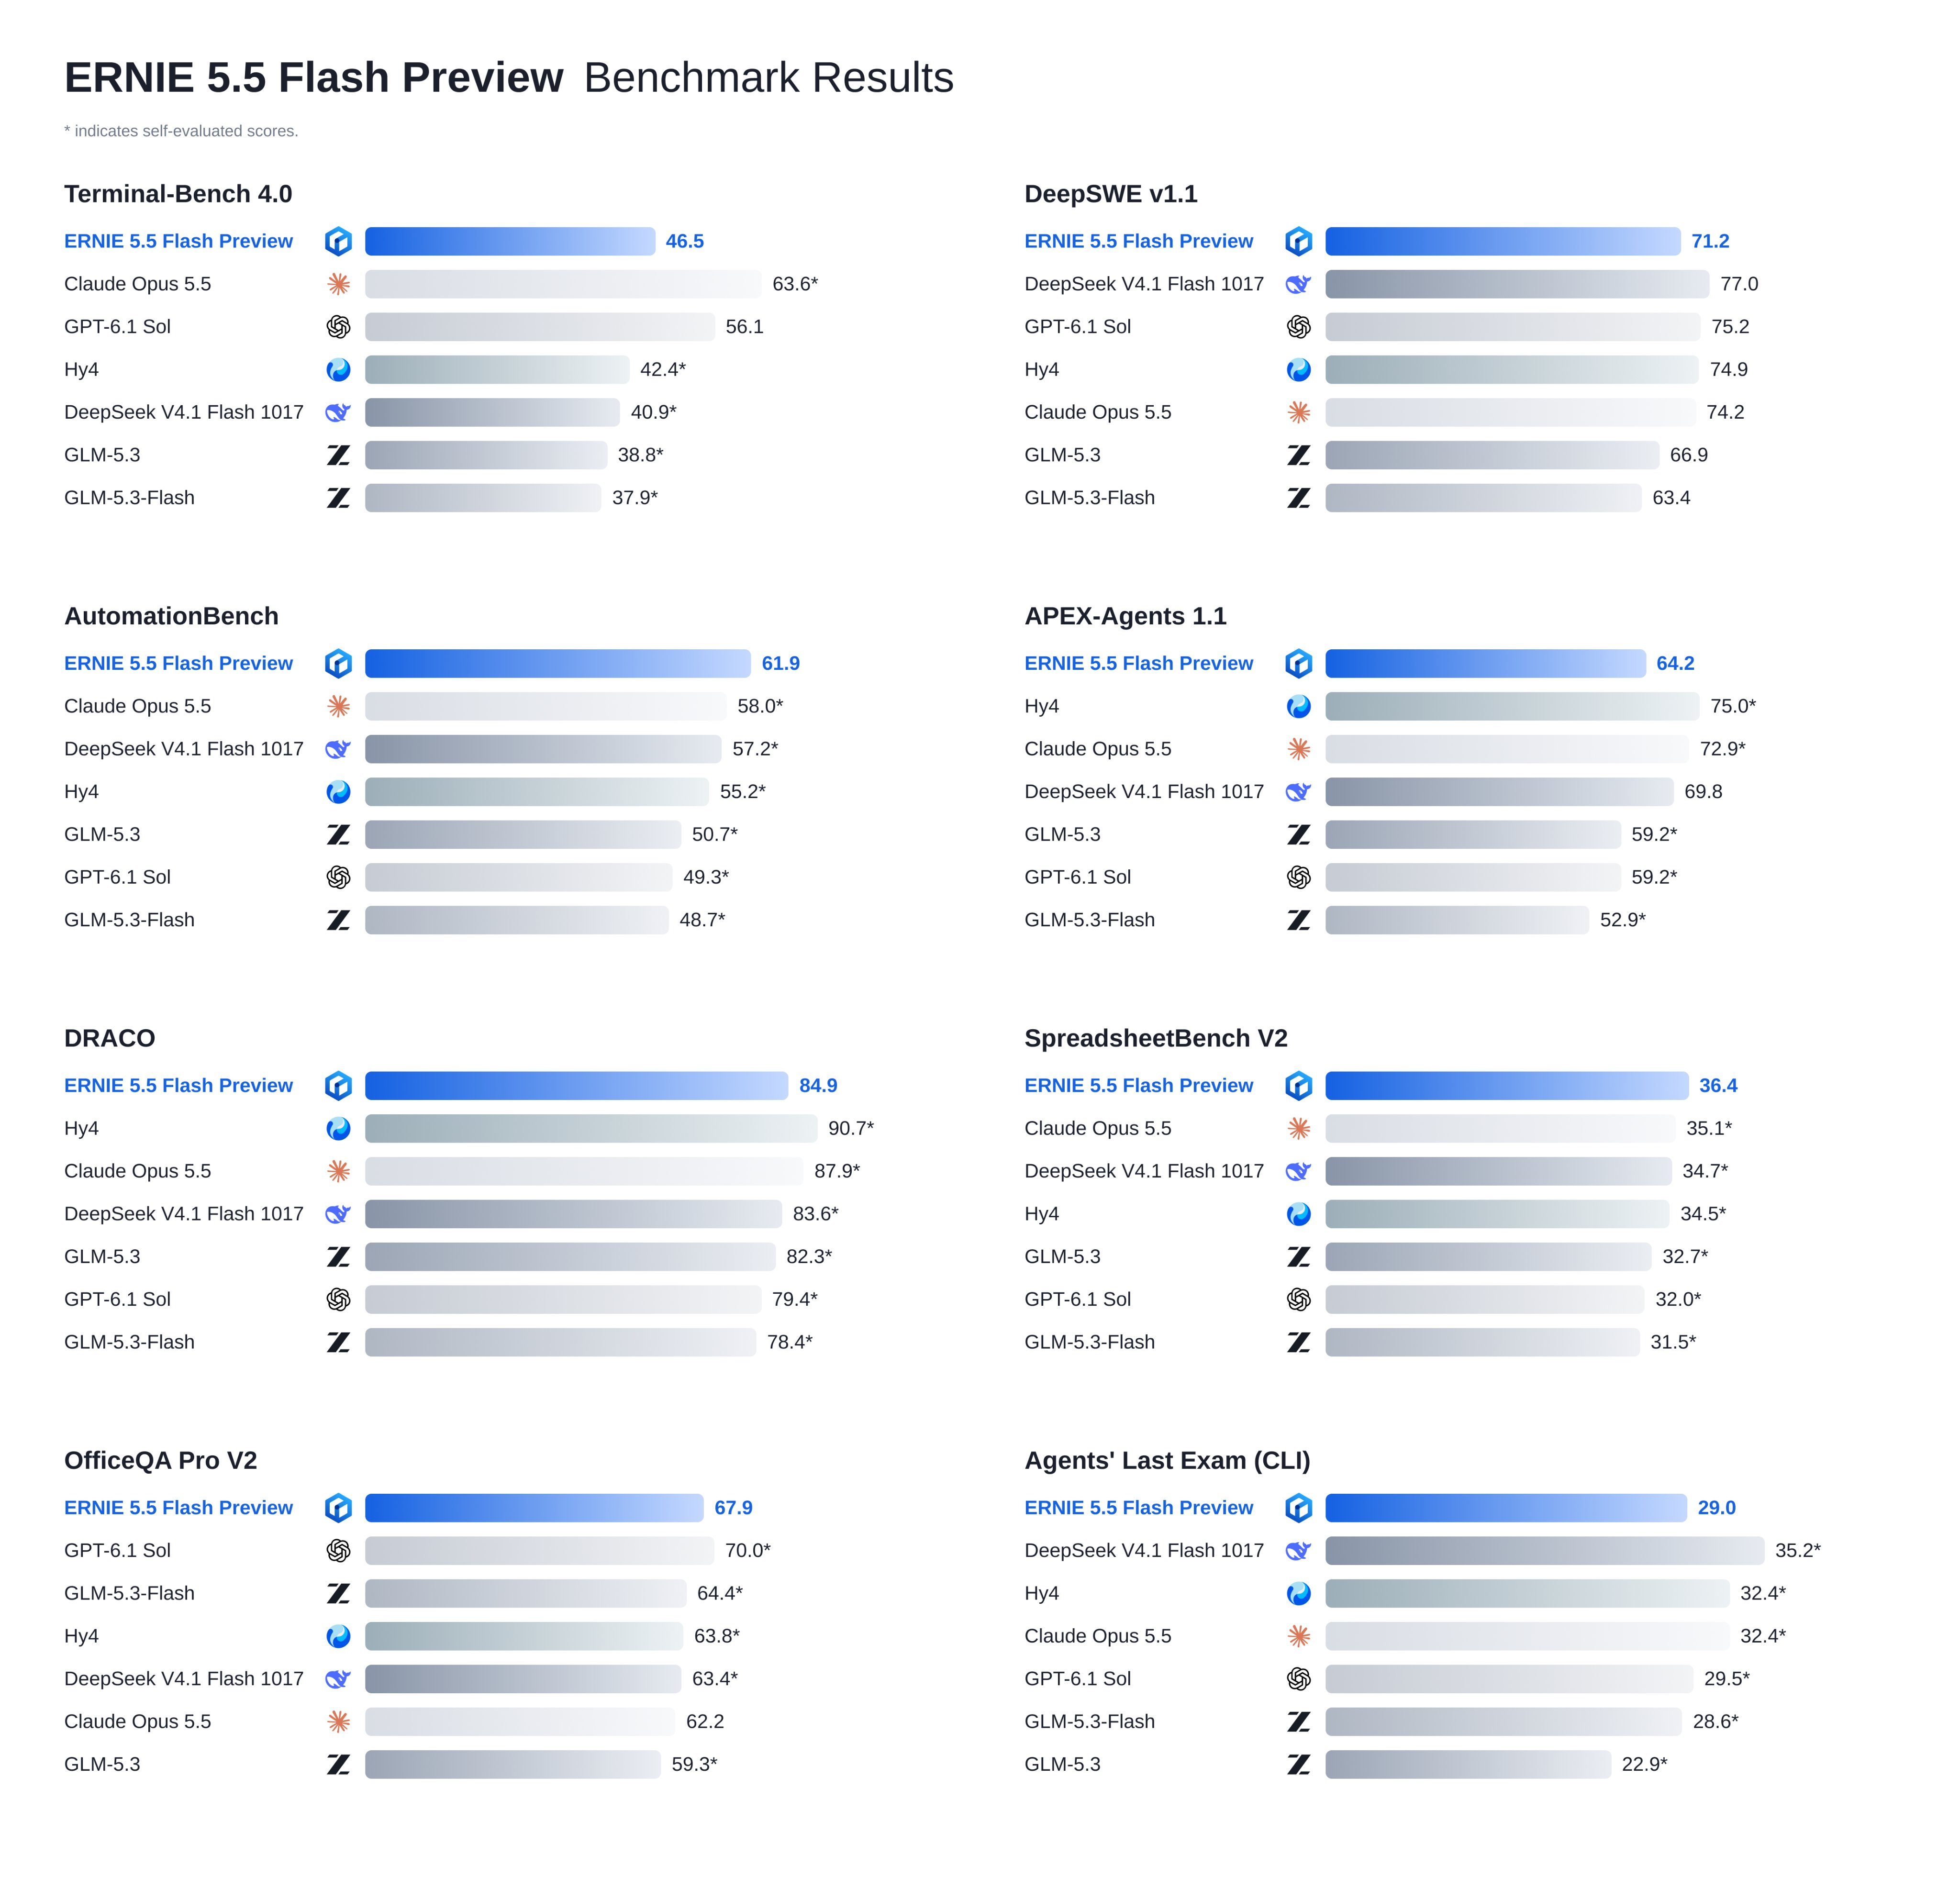
La publicación de lanzamiento de Baidu lo posiciona para programación, trabajo con agentes, modelado 3D, trabajo con conocimiento y creación de contenido. La empresa describe el modelo como un checkpoint intermedio, así que espera que su comportamiento cambie, y dice que los pesos se publicarán como código abierto bajo Apache 2.0 "pronto", sin fecha concreta.
Qianfan vs OpenRouter: ¿qué endpoint deberías usar?
Aquí tienes una comparación de las dos rutas, usando lo que cada plataforma publica actualmente.
| Baidu Qianfan | OpenRouter | |
|---|---|---|
| URL base | https://qianfan.baidubce.com/v2 |
https://openrouter.ai/api/v1 |
| ID del modelo | ernie-5.5-flash-preview |
baidu/ernie-5.5-flash-preview:free |
| Cabecera de autenticación | Authorization: Bearer <clave de API de Qianfan> |
Authorization: Bearer <clave de OpenRouter> |
| Contexto | 1M de entrada, 1M de salida | 1.024.000 tokens |
| Precio | Se cobra a tu saldo de Baidu AI Cloud; la consola muestra la tarifa | $0 en la variante :free |
| Límites predeterminados | 300 solicitudes/min, 3.000.000 de tokens/min | 20 solicitudes/min; 50/día, o 1.000/día tras comprar $10 en créditos |
| Razonamiento | Siempre activado, esfuerzo fijo en high |
Controlado con el objeto reasoning |
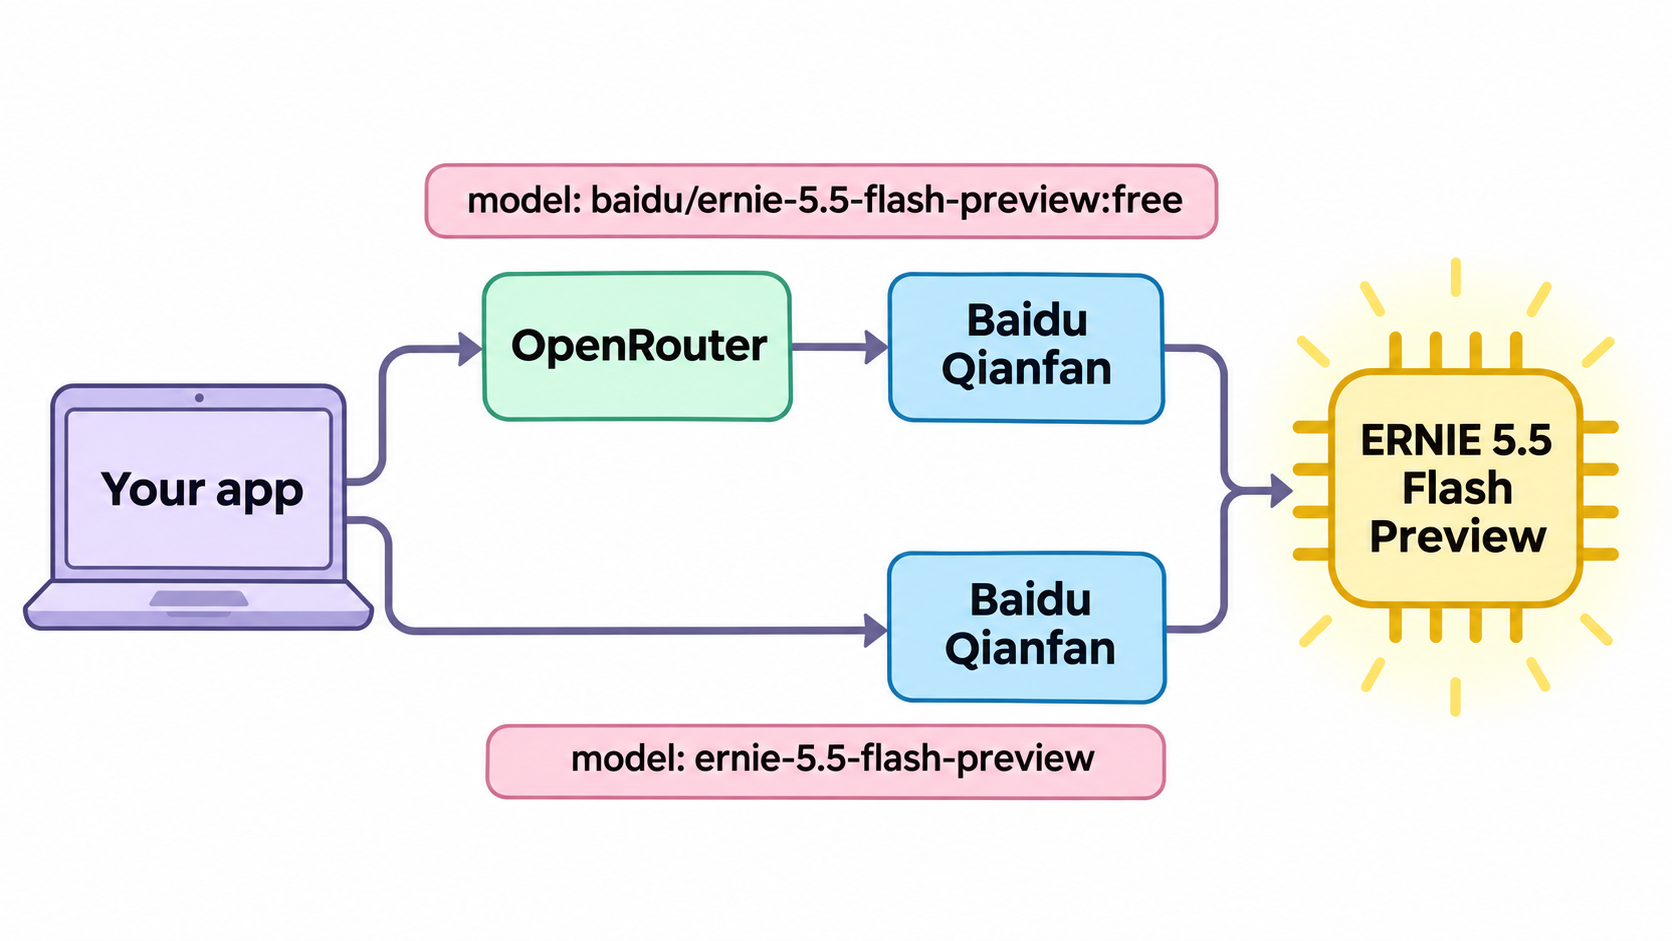
OpenRouter lista un solo proveedor, Baidu Qianfan, por lo que ambas rutas llegan al mismo backend. La diferencia real está en los límites: el nivel gratuito de OpenRouter es adecuado para prototipos y evaluaciones, mientras que los 300 RPM predeterminados de Qianfan son adecuados para producción. La guía de ERNIE 5.5 Flash gratuito cubre las rutas de $0 con más profundidad.
¿Cómo obtener una clave de API para ERNIE 5.5 Flash?
Qianfan
- Inicia sesión en la consola de Qianfan con una cuenta de Baidu AI Cloud.
- Abre API Key en la gestión del sistema y crea una clave. Tiene el formato
bce-v3/ALTAK-.... - Expórtala:
export QIANFAN_API_KEY="bce-v3/ALTAK-...".
Qianfan cobra las llamadas a tu saldo de Baidu AI Cloud. Un saldo negativo devuelve 403 account_overdue, así que recarga antes de hacer pruebas de carga.
OpenRouter
- Crea una cuenta y una clave en OpenRouter.
- Expórtala:
export OPENROUTER_API_KEY="sk-or-v1-...". - Usa el ID de modelo
baidu/ernie-5.5-flash-preview:free.
Envía tu primera solicitud a ERNIE 5.5 Flash
curl
Qianfan:
curl https://qianfan.baidubce.com/v2/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $QIANFAN_API_KEY" \
  -d '{
    "model": "ernie-5.5-flash-preview",
    "messages": [
      {"role": "system", "content": "You are a concise senior engineer."},
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
OpenRouter:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{
    "model": "baidu/ernie-5.5-flash-preview:free",
    "messages": [
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
Python
Instala el SDK con pip install openai y luego cambia la URL base según el proveedor:
import os
from openai import OpenAI

PROVIDERS = {
    "qianfan": ("https://qianfan.baidubce.com/v2", "QIANFAN_API_KEY", "ernie-5.5-flash-preview"),
    "openrouter": ("https://openrouter.ai/api/v1", "OPENROUTER_API_KEY", "baidu/ernie-5.5-flash-preview:free"),
}

base_url, key_env, model = PROVIDERS["qianfan"]
client = OpenAI(base_url=base_url, api_key=os.environ[key_env])

resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Explain idempotency keys in two sentences."}],
    max_completion_tokens=4096,
)
print(resp.choices[0].message.content)
print(resp.usage)
JavaScript
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://openrouter.ai/api/v1",
  apiKey: process.env.OPENROUTER_API_KEY,
});

const resp = await client.chat.completions.create({
  model: "baidu/ernie-5.5-flash-preview:free",
  messages: [{ role: "user", content: "List three causes of HTTP 499 errors." }],
});
console.log(resp.choices[0].message.content);
¿Cómo hacer streaming de las respuestas de ERNIE 5.5 Flash?
Añade "stream": true y ambos proveedores devuelven eventos enviados por el servidor que terminan con data: [DONE]. En Qianfan, añade "stream_options": {"include_usage": true} para obtener los recuentos de tokens en el último fragmento. Si no conoces bien el formato, la guía de streaming SSE explica el formato de la conexión.
stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Draft a README for a CLI tool."}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices:
        delta = chunk.choices[0].delta
        thinking = getattr(delta, "reasoning_content", None)
        if thinking:
            print(f"[thinking] {thinking}", end="", flush=True)
        if delta.content:
            print(delta.content, end="", flush=True)
    if chunk.usage:
        print("\n", chunk.usage)
Usa streaming por defecto: el modelo razona antes de responder, así que una llamada bloqueante puede quedarse en silencio durante un tiempo.
¿Cómo funcionan los tokens de razonamiento en cada proveedor?
ERNIE 5.5 Flash Preview es un modelo de razonamiento, y las dos plataformas lo exponen de forma diferente.
En Qianfan, la documentación de pensamiento profundo lista ernie-5.5-flash-preview como "solo activable, no se puede desactivar" para el parámetro thinking, y su valor predeterminado de reasoning_effort en high "no se puede ajustar". Así que aquí no puedes desactivar el razonamiento ni reducirlo. La cadena de pensamiento se devuelve en reasoning_content, separada de content. Qianfan la cuenta dentro de max_completion_tokens, por lo que un límite demasiado ajustado puede cortar la respuesta final y dejarte con finish_reason: "length".
En OpenRouter, controlas el razonamiento con el objeto reasoning y lees el rastro desde reasoning_details. Para ocultar el rastro de la respuesta:
{
  "model": "baidu/ernie-5.5-flash-preview:free",
  "reasoning": { "exclude": true },
  "messages": [{ "role": "user", "content": "Is 2^61 - 1 prime?" }]
}
En chats multi-turno, OpenRouter te pide pasar el reasoning_details completo de vuelta con el mensaje del asistente para que el modelo pueda continuar desde donde lo dejó. El recuento de tokens de razonamiento aparece en usage.completion_tokens_details.reasoning_tokens.
Consejos para la ventana de contexto de 1M de tokens
Un millón de tokens equivale a una base de código de tamaño medio. Cuatro hábitos mantienen predecibles las llamadas largas:
- Presupuesta según tokens por minuto, no solo solicitudes. El valor predeterminado de Qianfan es 3.000.000 de TPM, así que tres prompts completos de 1M de tokens en un minuto agotan toda la cuota. Vigila
X-Ratelimit-Remaining-Input-Tokensen cada respuesta. - Coloca el contenido estable al principio. Mantén el prompt del sistema y los documentos de referencia al inicio y la pregunta cambiante al final, para que los prefijos repetidos puedan aprovechar la caché. OpenRouter mostró una tasa de aciertos de caché del 90,83% para este modelo el 12 de noviembre.
- Deja espacio para el razonamiento. Configura
max_completion_tokenslo suficientemente alto para cubrir el razonamiento más la respuesta. - Mide antes de creerte las afirmaciones de velocidad. Baidu dice que el modelo genera más de 200 tokens por segundo. En el endpoint gratuito de OpenRouter, el rendimiento P50 el 12 de noviembre fue de 79 tokens por segundo, con una latencia P50 de 2,53 segundos.
Para salidas estructuradas, prueba a fondo antes de publicar. OpenRouter acepta response_format con un esquema JSON, pero su página reportó una tasa de errores del 21,70% en salidas estructuradas para este modelo durante tres días, frente a una tasa de errores del 1,01% en llamadas a herramientas. Valida cada respuesta JSON y reintenta ante fallos de análisis.
Errores y límites de tasa de la API de ERNIE 5.5 Flash
Estos son los códigos que verás con más frecuencia, según la tabla de códigos de error de Qianfan y la página de límites de OpenRouter:
| Estado | Proveedor | Código o causa | Solución |
|---|---|---|---|
| 400 | Qianfan | tokens_too_long |
Recorta el prompt por debajo del límite de entrada de 1M |
| 401 | Qianfan | invalid_iam_token |
La clave es incorrecta o ha expirado, o falta el prefijo Bearer |
| 401 | Qianfan | invalid_model |
Comprueba que el ID del modelo sea exactamente ernie-5.5-flash-preview |
| 403 | Qianfan | account_overdue |
Saldo por debajo de cero; recarga |
| 429 | Qianfan | rpm_rate_limit_exceeded, tpm_rate_limit_exceeded |
Espera; la cuota se renueva en un plazo de 60 segundos |
| 402 | OpenRouter | Saldo de créditos negativo | Añade créditos, incluso para :free |
| 429 | OpenRouter | Límite del modelo gratuito (20/min, 50 o 1.000/día) | Lee X-RateLimit-Reset, o consulta GET /api/v1/key |
En OpenRouter, GET https://openrouter.ai/api/v1/key devuelve free_model_daily_requests.remaining. Reintenta los errores 429 con retroceso exponencial y jitter; nunca reintentes un 400 o un 401.
Deja que tu agente de programación pruebe ambos endpoints con Apidog CLI
Una vez que ambos proveedores responden, quieres pruebas de que siguen respondiendo correctamente: estado correcto, formato correcto, latencia aceptable. Deja esa tarea en manos de tu agente de programación. Apidog CLI ofrece a Claude Code, Codex, Cursor u OpenCode los comandos para importar el endpoint, guardar un entorno por proveedor y ejecutar un escenario de pruebas contra cada uno.
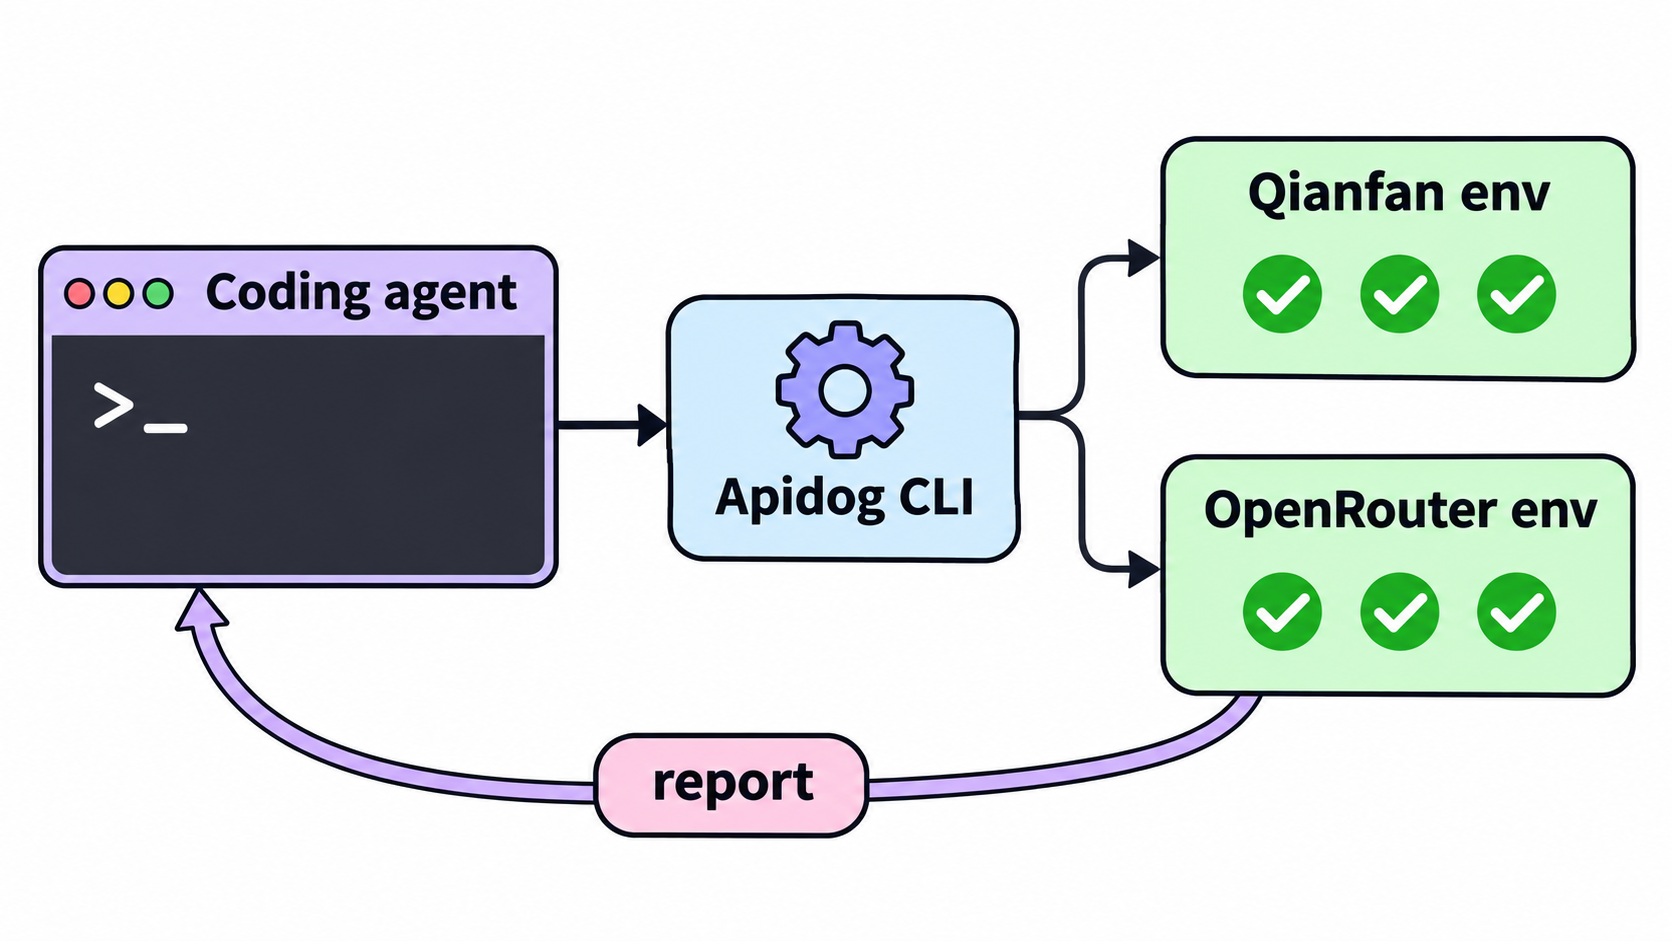
Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Luego dale a tu agente un solo prompt:
Write an OpenAPI 3 file for POST /chat/completions that matches the ERNIE 5.5 Flash
request and response shape (model, messages, stream; choices[0].message.content, usage).
Import it into Apidog project <projectId>. Create two environments: "qianfan" with base
URL https://qianfan.baidubce.com/v2 and "openrouter" with https://openrouter.ai/api/v1,
each with a "model" variable. Build one test scenario that sends a short prompt and
asserts status 200, the response schema, and a response time under 30 seconds. Run it
against both environments, passing the API keys as environment variables, and summarize
any failures.
El agente comprueba cada esquema, valida sus payloads y ejecuta comandos como estos:
apidog import --project <projectId> --format openapi --file ./ernie-5-5-flash.openapi.yaml
apidog environment create qianfan --project <projectId> --base-url https://qianfan.baidubce.com/v2
apidog environment create openrouter --project <projectId> --base-url https://openrouter.ai/api/v1
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <projectId> --name "ERNIE 5.5 Flash smoke" --folder-id <folderId> --priority <priority>
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointId> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <qianfanEnvId> --env-var "apiKey=$QIANFAN_API_KEY" -r cli,json
apidog run -t <scenarioId> --project <projectId> -e <openrouterEnvId> --env-var "apiKey=$OPENROUTER_API_KEY" -r cli,json
Pasar las claves con --env-var evita que queden guardadas en el proyecto, y un solo escenario te da una lectura comparativa de ambas rutas. El mismo apidog run con -r junit se integra en un pipeline; la guía de CI/CD con Apidog CLI muestra la configuración, y Apidog CLI en Claude Code cubre el lado del agente. El plan gratuito de Apidog cubre hasta 4 usuarios.
FAQ
¿Es gratuita la API de ERNIE 5.5 Flash? En OpenRouter, sí: baidu/ernie-5.5-flash-preview:free cuesta $0 por token, con límites de 20 solicitudes por minuto y 50 por día, o 1.000 por día una vez que hayas comprado $10 en créditos. Qianfan cobra las llamadas a tu saldo de Baidu AI Cloud.
¿Cuál es el ID del modelo para ERNIE 5.5 Flash? Usa ernie-5.5-flash-preview en Qianfan y baidu/ernie-5.5-flash-preview:free en OpenRouter.
¿Puedo desactivar el pensamiento en Qianfan? No. La documentación de Qianfan indica que el pensamiento solo puede estar activado para este modelo y que reasoning_effort se mantiene en high. Presupuesta tokens de salida para el rastro de razonamiento.
¿La API de ERNIE 5.5 Flash admite llamadas a herramientas? Sí. Qianfan lista Function Call y salida estructurada como compatibles, y OpenRouter acepta tools, tool_choice y response_format. Valida la salida estructurada, ya que OpenRouter reportó una tasa de errores alta para ella.
¿Puedo ejecutar ERNIE 5.5 Flash yo mismo? Baidu publicó ERNIE 5.5 Flash Base en Hugging Face, y los pesos de Preview están prometidos bajo Apache 2.0. Consulta cómo ejecutar ERNIE 5.5 Flash localmente con vLLM.
¿Cómo se compara con DeepSeek V4.1 Flash? Consulta ERNIE 5.5 Flash vs DeepSeek V4.1 Flash y la guía de la API de DeepSeek V4.1 Flash.