DeepSeek publicó la ficha del modelo para DeepSeek-V4.1-Flash el 10 de septiembre de 2026, y las cifras son incómodas para los clientes de V4-Pro. El modelo más pequeño y económico obtiene una puntuación más alta que el buque insignia en todos los puntos de referencia de codificación y agentes que DeepSeek enumera, cuesta entre un 70 y un 77% menos por token en horas pico, y el 14 de septiembre absorbe por completo a V4-Pro: cada solicitud de deepseek-v4-pro se redirige a V4.1-Flash y se factura a tarifas Flash.
Esto no es la típica compensación entre pequeño y grande. Es una comparación con fecha límite. Si ejecutas V4-Pro en producción, tienes cuatro días para saber qué cambia cuando se realice la redirección. Si ejecutas V4-Flash, el cambio ya ocurrió: el nombre deepseek-v4-flash es atendido hoy por V4.1-Flash.
A continuación: los tres modelos en arquitectura, los puntos de referencia reportados por DeepSeek, precios en USD y rendimiento, luego un flujo de trabajo para ejecutar un conjunto de prompts a través de deepseek-v4-pro y deepseek-flash en Apidog antes del cambio para comparar salidas, latencia y conteos de uso. Para una inmersión profunda en la arquitectura, lee primero qué es DeepSeek-V4.1-Flash; para la lista de verificación de migración, consulta la guía de retiro de V4-Pro.
En resumen
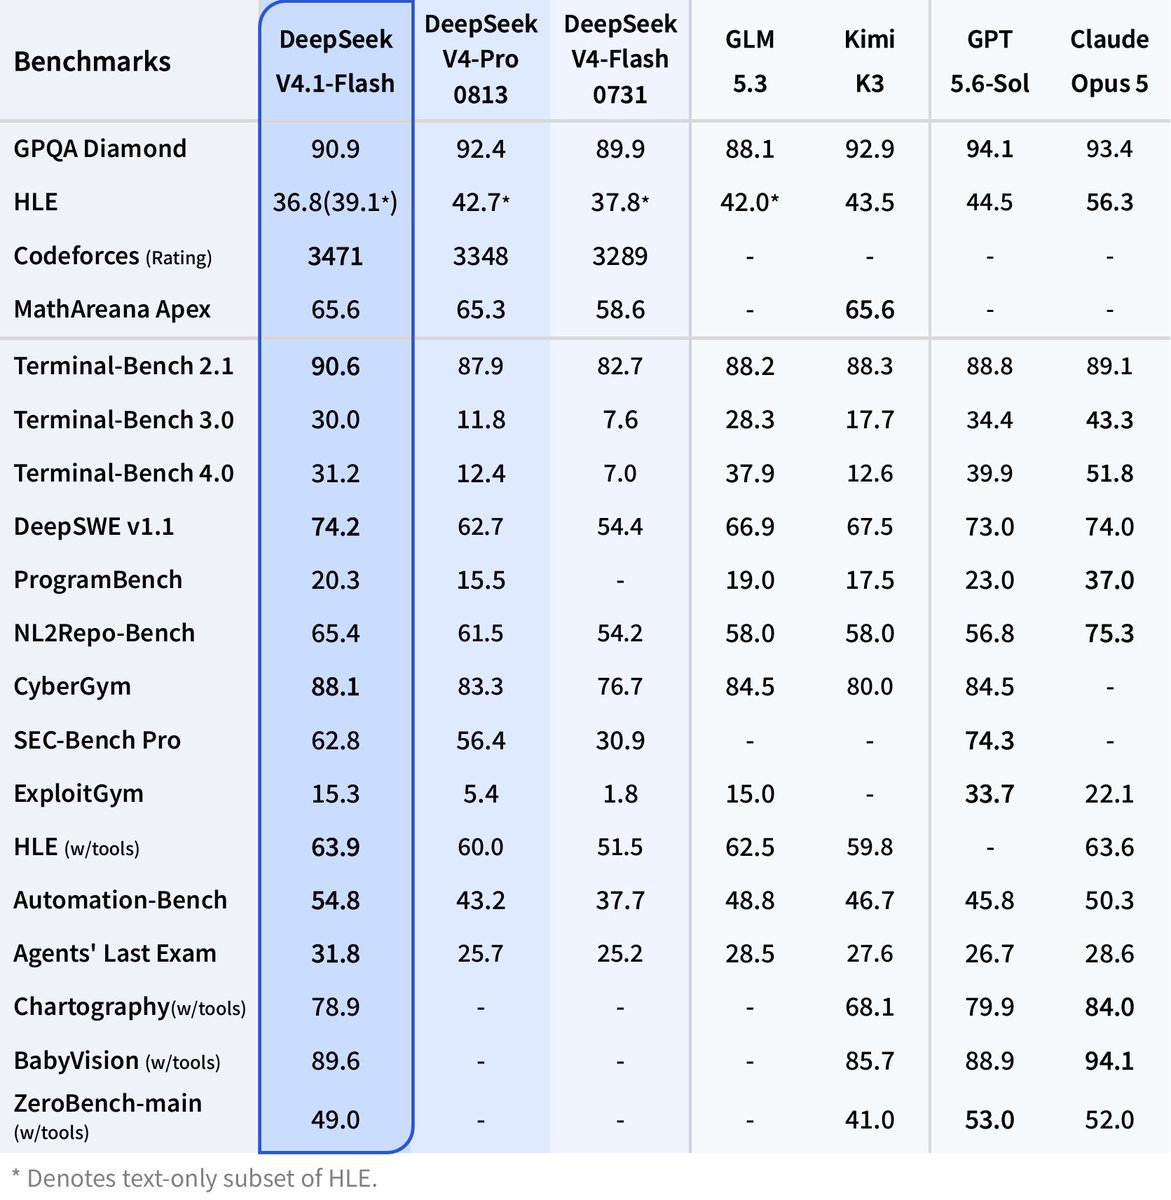
- V4.1-Flash gana en los propios puntos de referencia de DeepSeek. DeepSWE v1.1 es el titular: 74.2 contra 62.7 para V4-Pro y 54.4 para V4-Flash.
- Es el más económico de los tres. La entrada con fallo de caché en hora pico cuesta $0.30 por 1M de tokens frente a $1.32 para V4-Pro y $0.44 para el antiguo V4-Flash.
- Está diseñado para el rendimiento. 8B de parámetros activos en el prellenado, una caché KV de 890 bytes por token y un límite de concurrencia de 2,500.
- Después del 14 de septiembre solo hay una opción. El tráfico de V4-Pro se redirige a V4.1-Flash. La pregunta es qué ganas y qué pierdes, no cuál elegir.
Especificaciones comparadas
La generación V4.1 es una arquitectura nueva, no un re-entrenamiento. DeepSeek la llama Codificador-Decodificador Causal (CED): 40 capas divididas en 20 codificadoras y 20 decodificadoras, con 384 expertos enrutados más un experto compartido por capa. La ficha del modelo sitúa la base en 552B parámetros (763B con el codificador de visión).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Generación de arquitectura | V4 MoE | V4 MoE | V4.1 Codificador-Decodificador Causal, 40 capas |
| Parámetros totales | 284B (listado de OpenRouter de la versión de visión) | No revelado aquí | 552B base, 763B con codificador de visión |
| Parámetros activos | 13B | No revelado aquí | 8B prellenado, 16B decodificación |
| Ventana de contexto | 1M tokens | 1M tokens | 1M tokens |
| Salida máxima | 384K tokens | 384K tokens | 384K tokens |
| Visión | Versión Vision-Exp separada | No revelado aquí | Nativo, codificador DeepSeek-ViT |
| Licencia | No cubierto aquí | No cubierto aquí | MIT, pesos en Hugging Face |
| Límite de concurrencia | 2,500 | 500 | 2,500 |
| Estado de la API | Retirado, alias atendido por V4.1-Flash | Redirige a V4.1-Flash el 14 de septiembre | Disponibilidad general desde el 10 de septiembre, ID de modelo deepseek-flash |
El recuento de parámetros activos divididos es el detalle a tener en cuenta: V4-Flash usaba 13B para cada token, mientras que V4.1-Flash gasta 8B en la entrada y 16B en la salida, donde reside la calidad.
Puntos de referencia: de dónde vienen los 11.5 puntos
Cada número a continuación es reportado por DeepSeek de la ficha del modelo. No se han publicado ejecuciones independientes, y la frase "pruebas realizadas por múltiples partes" del aviso de retiro no las nombra. Trátelos como afirmaciones del proveedor y verifíquelos con sus propios prompts.
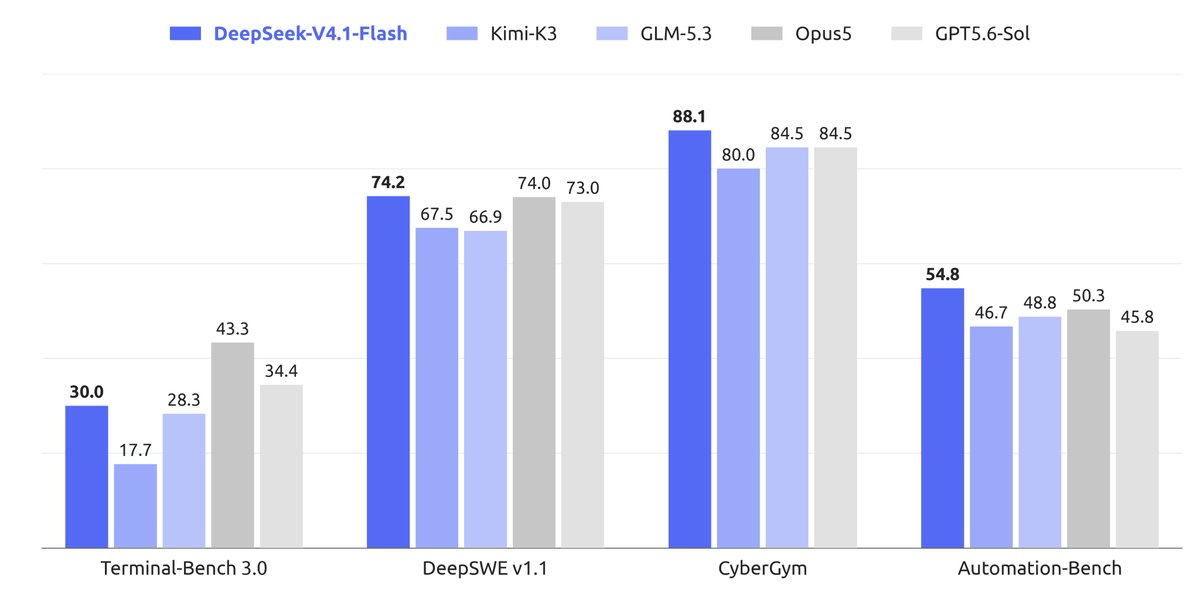
DeepSWE v1.1 (+11.5 sobre Pro, +19.8 sobre V4-Flash). El titular, y la única brecha lo suficientemente grande como para cambiar decisiones. DeepSWE mide tareas de ingeniería de software de múltiples archivos, la carga de trabajo que los agentes de codificación ejecutan todo el día. Si se mantiene en sus repositorios, V4.1-Flash supera en código al modelo que costaba cuatro veces más.
Terminal-Bench 2.1 (+2.7). Tareas de agente controladas por shell. V4-Flash-0731 ya superó a V4-Pro-Preview aquí en julio; V4.1 amplía la ventaja en menos de tres puntos. Real, no decisivo.
HumanEval (+2.6) y GSM8K (+0.4). Ambos están cerca de la saturación: cada modelo supera los 90 en GSM8K, y HumanEval dice poco sobre el código de producción. No le des peso a estas filas.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 tiene los números de la generación V4 frente a otros modelos abiertos; ninguno incluye V4.1 todavía.
Costo: tres modelos, seis niveles de precios
El horario pico es de lunes a viernes, de 01:00 a 04:00 y de 06:00 a 10:00 UTC; todo lo demás es fuera de pico a mitad de precio. Las tarifas son por 1M de tokens de la página de precios, efectivas a partir del 10 de septiembre. Las filas de V4-Flash utilizan sus tarifas en USD del 21 de agosto de 2026 como la columna "antes".
| Modelo y nivel | Entrada, acierto de caché | Entrada, fallo de caché | Salida |
|---|---|---|---|
| V4-Flash, fuera de pico (tarifas del 21 de agosto) | $0.007 | $0.22 | $0.66 |
| V4-Flash, pico (tarifas del 21 de agosto) | $0.014 | $0.44 | $1.32 |
| V4-Pro, fuera de pico | $0.022 | $0.66 | $1.98 |
| V4-Pro, pico | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, fuera de pico | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, pico | $0.006 | $0.30 | $1.20 |
Frente a V4-Flash, V4.1 reduce la entrada con acierto de caché en aproximadamente un 57%, la entrada con fallo de caché en aproximadamente un 32% y la salida en aproximadamente un 9%. Frente a V4-Pro, las reducciones son del 77% en la entrada con fallo de caché y del 70% en la salida en horas pico.
Un mes de trabajo. Un agente de codificación procesa 2B de tokens de entrada al mes con una tasa de acierto de caché del 70% (prompt del sistema y contexto del repositorio reutilizados en cada turno) y emite 300M de tokens de salida, todo en horas pico.
| V4-Pro, pico | V4-Flash, pico | V4.1-Flash, pico | V4.1-Flash, fuera de pico | |
|---|---|---|---|---|
| 1.4B entrada con acierto de caché | $61.60 | $19.60 | $8.40 | $4.20 |
| 600M entrada con fallo de caché | $792.00 | $264.00 | $180.00 | $90.00 |
| 300M salida | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Total mensual | $2,041.60 | $679.60 | $548.40 | $274.20 |
Eso es un 73% menos que V4-Pro, y mover los trabajos por lotes fuera de las horas pico lo reduce a la mitad nuevamente. Los tokens de salida dominan cada columna, por lo que la reducción del 70% en la salida importa más que el titular de acierto de caché. El desglose de precios de V4.1-Flash cubre los cálculos de acierto de caché.
Velocidad y rendimiento
DeepSeek no publica la cifra de tokens por segundo, por lo que la historia del rendimiento se basa en tres hechos arquitectónicos y una anécdota.
- Caché KV de 890 bytes por token. El almacenamiento en caché KV principal FP4 sitúa la caché global en aproximadamente una cuarta parte de la huella de V4-Flash. La nota de lanzamiento lo establece como 1/4 del HBM y 1/8 del almacenamiento SSD de la generación anterior. Un contexto completo de 1M de tokens necesita aproximadamente 0.9 GB de caché.
- 8B de parámetros activos en el prellenado. Menos computación por token de entrada que los 13B de V4-Flash, por lo que el tiempo hasta el primer token en contextos grandes debería disminuir.
- Concurrencia 2,500 vs 500. El tráfico de V4-Pro redirigido hereda el límite de Flash, una ganancia de 5x para las flotas de agentes.
- Informe de un usuario: "casi 400 t/s". Un usuario de X lo publicó a partir de pruebas de video durante la beta; es una anécdota, no un punto de referencia. El hilo beta de HN es en su mayoría el mismo entusiasmo.
Mide tu propio p50 y p95 antes de confiar en nada de esto.
Qué ganas y qué pierdes después del 14 de septiembre
No hay un "qué modelo debo elegir" después del cambio. deepseek-v4-pro se convierte en un alias, por lo que el enfoque honesto es un balance.
Ganas: puntuaciones más altas en todos los puntos de referencia listados, precios pico entre un 70 y un 77% más bajos, 5x de concurrencia, entrada de imagen nativa sin un ID de modelo de visión separado, y un dial de esfuerzo de razonamiento que DeepSeek describe como continuamente controlable en una escala de 1 a 100.
Pierdes: la capacidad de fijar un punto de control de la generación V4. Los prompts ajustados al estilo, la verbosidad o el formato de llamadas a herramientas de V4-Pro pueden variar. La longitud de la salida y el recuento de tokens de razonamiento pueden cambiar, lo que modifica tu factura de maneras que la tabla de tarifas no muestra. Y la redirección ocurre según el cronograma de DeepSeek, no el tuyo.
Esa segunda lista es la razón por la que debes hacer un diff antes del día 14, no después.
Compara V4-Pro con V4.1-Flash en Apidog antes del cambio
Apidog prueba la capa de la API, por lo que es el lugar adecuado para ejecutar un conjunto de prompts a través de ambos IDs de modelo y comparar los resultados.
- Añade el endpoint. Crea un proyecto y añade
POST https://api.deepseek.com/chat/completions, o importa una especificación OpenAPI. - Coloca la clave y el ID del modelo en los entornos. Almacena
DEEPSEEK_API_KEYy una variableMODEL. Crea dos entornos,v4-proconMODEL=deepseek-v4-proyv41-flashconMODEL=deepseek-flash, y referéncialos comoBearer {{DEEPSEEK_API_KEY}}en el encabezado y"model": "{{MODEL}}"en el cuerpo. - Guarda tus prompts reales como solicitudes. Elige entre 20 y 30 prompts que representen la producción: tu prompt del sistema, una llamada a herramienta, un resumen de contexto largo, una edición de código de varios archivos. Guarda cada uno con
stream: falsepara que el objetousageaparezca en el cuerpo de la respuesta. - Afirma sobre los campos que modifican tu factura. Crea un escenario de prueba a partir de las solicitudes guardadas y añade aserciones sobre
usage.prompt_tokens,usage.completion_tokensyusage.prompt_cache_hit_tokens. Registra el tiempo de respuesta por paso y añade un script de pre-solicitud que inserte el nombre del entorno en un encabezado para que las ejecuciones estén etiquetadas. - Ejecuta una vez por entorno y luego compara. Ejecuta el escenario bajo
v4-pro, luego bajov41-flash. Compara los recuentos de tokens de finalización (la redirección cambia tu factura de salida), la latencia por paso y el contenido en sí para detectar desviaciones de formato. - Vuelve a ejecutar en CI el día 14. Ejecuta el mismo escenario con
apidog-clien tu pipeline en el momento del cambio. Cualquier cosa que la redirección haya roto aparecerá como una aserción fallida en lugar de un ticket de soporte.
La misma comparación como script:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Ejecútalo en horas pico y fuera de pico y guarda los resultados. Descarga Apidog para mantener el diff, las aserciones y el historial de ejecuciones en un solo lugar.
Preguntas frecuentes
- ¿Es V4.1-Flash mejor que V4-Pro en codificación? Según los números reportados por DeepSeek, sí: 74.2 frente a 62.7 en DeepSWE v1.1 y 90.6 frente a 87.9 en Terminal-Bench 2.1. Para saber cómo se comparó la generación V4 con Claude en codificación, consulta DeepSeek V4 vs Claude Opus para codificación.
- ¿Qué le sucede a mi integración de V4-Pro el 14 de septiembre? A partir de las 04:00 UTC, cada solicitud de
deepseek-v4-proserá atendida por V4.1-Flash y facturada a tarifas Flash. Tu código seguirá funcionando; el modelo detrás de él cambiará. La guía de migración tiene la lista completa. - ¿Necesito renombrar deepseek-v4-flash a deepseek-flash? No por ahora.
deepseek-v4-flashydeepseek-v4-flash-vision-expsiguen siendo aceptados y atendidos por V4.1-Flash. DeepSeek no ha dado una fecha de eliminación, así que cambia adeepseek-flashla próxima vez que modifiques la configuración. - ¿Es V4.1-Flash más rápido que V4-Pro? DeepSeek lo afirma y no publica cifras. La arquitectura respalda la afirmación: 8B de parámetros activos en el prellenado y una caché KV de un cuarto del tamaño de la de V4-Flash. Mide el tuyo propio.
- ¿Puedo seguir ejecutando V4-Pro en algún lugar? No en la API de DeepSeek después del día 14. Los antecedentes de la generación V4 se encuentran en Qué es DeepSeek V4; los pesos de V4.1-Flash están en Hugging Face bajo licencia MIT.
La versión corta
V4.1-Flash es más pequeño, más económico y obtiene una puntuación más alta a la vez, al menos según la tabla del proveedor, y esa tabla no puede decirte si es mejor para tus prompts. Ejecuta ambos IDs de modelo con el mismo conjunto de prompts en Apidog esta semana, guarda las diferencias y sabrás qué cambia el 14 de septiembre antes que tus usuarios.