
Para Claude Fable 5.2 vs Opus 5.5, empieza con Opus 5.5 para tareas cotidianas de programación y trabajo de conocimiento. Prueba Fable 5.2 cuando un razonamiento difícil, migraciones ambiguas o proyectos largos con agentes superen tu línea base con Opus. Compara las configuraciones de esfuerzo y el costo por resultado aceptado antes de migrar toda tu carga de trabajo.
Esta recomendación sigue el anuncio de Fable 5.2 de Anthropic, verificado el 10 de noviembre de 2026. Esta es una comparación basada en fuentes; no hemos ejecutado un benchmark independiente frente a frente. Nuestra comparación anterior de Opus 5 vs Fable 5 cubre la generación anterior. Las tarifas, valores predeterminados y evidencia que se presentan a continuación corresponden a estas versiones más recientes.
Claude Fable 5.2 vs Opus 5.5 de un vistazo
| Punto de decisión | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Rol inicial | Razonamiento exigente y trabajo largo con agentes | Predeterminado para la mayoría de las cargas de trabajo |
| ID del modelo en la API de Claude | claude-fable-5-2 |
claude-opus-5-5 |
| Entrada estándar, por millón de tokens | $8 | $4 |
| Salida estándar, por millón de tokens | $40 | $20 |
| Esfuerzo predeterminado de la API | Alto | Medio |
| Ventana de contexto | 1M de tokens | 1M de tokens |
| Salida máxima | 128K de tokens | 128K de tokens |
| Etiqueta de latencia comparativa | Moderada | Moderada |
Fuente: la descripción general actual de los modelos de Claude. Ambos modelos aceptan texto e imágenes, producen texto, admiten herramientas y usan pensamiento adaptativo siempre activo. Por lo tanto, una ventana de contexto mayor no los diferencia. Lo que los distingue es su capacidad para completar tu tarea concreta.
Las tarifas estándar de tokens de Fable son el doble que las de Opus. Eso hace que Opus sea el punto de partida lógico cuando ambos modelos cumplen tus criterios de aceptación con un volumen de tokens similar. No establece cuál genera la factura más baja cuando la profundidad de razonamiento, los reintentos y las llamadas a herramientas difieren.
¿Qué tareas de programación justifican cambiar a Fable 5.2?
Usa Opus para cambios acotados con verificaciones claras. Prueba Fable cuando el agente deba descubrir el problema, coordinar varios cambios dependientes o recuperarse de un enfoque que falla. Estas son recomendaciones de carga de trabajo inferidas del posicionamiento y los resultados de Anthropic, no garantías medidas para tu repositorio.
| Tu tarea | Elección inicial | Evidencia que justificaría escalar |
|---|---|---|
| Agregar un endpoint documentado | Opus 5.5 | Fallos repetidos de contrato o integración |
| Actualizar tests tras una refactorización pequeña | Opus 5.5 | El agente no identifica la invariante modificada |
| Depurar un fallo intermitente entre servicios | Opus, luego Fable | Opus repite correcciones sin probar causas alternativas |
| Migrar un servicio con dependencias poco claras | Comparar ambos | Fable completa más cambios aceptados dentro del presupuesto |
| Coordinar un proyecto técnico largo | Piloto con Fable | Una mejor planificación sobrevive a la ejecución y la revisión |
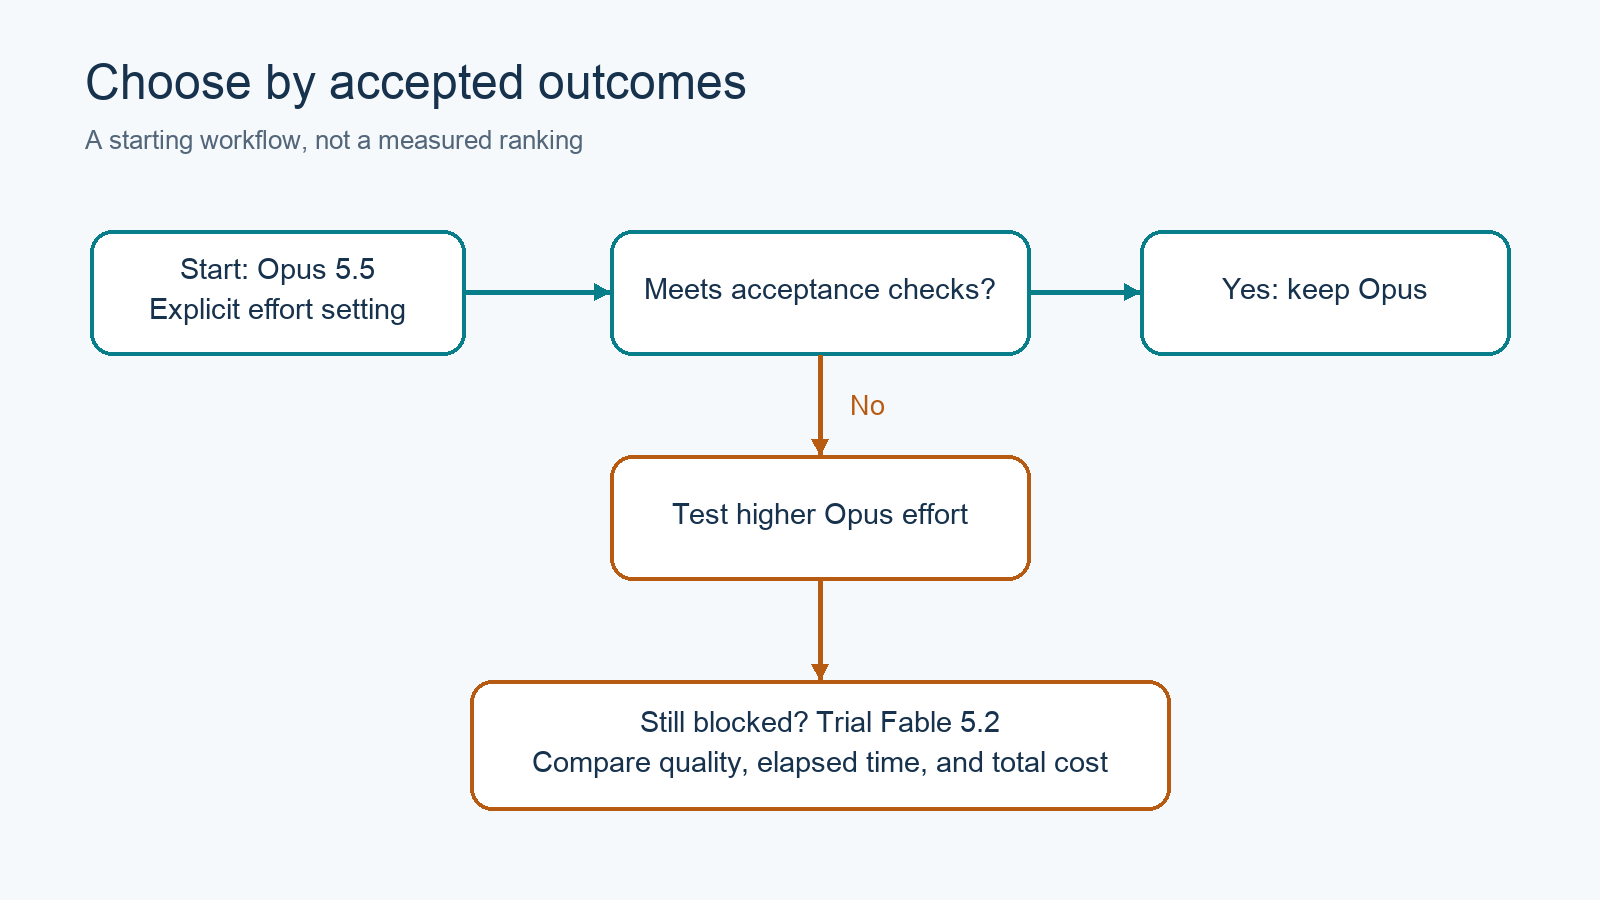
Escalado selectivo: mantén las tareas rutinarias en tu línea base y envía el trabajo difícil al modelo que supere tus verificaciones.
Considera un webhook de pagos que procesa intermitentemente un evento dos veces. Si la corrección requerida ya está especificada, Opus tiene una tarea de programación acotada. Si el agente debe reconstruir la concurrencia entre reintentos, almacenamiento y servicios aguas abajo, la investigación es un mejor candidato para un piloto con Fable.
Dale a cualquiera de los dos modelos la misma evidencia del incidente y las mismas restricciones. Un modelo más caro no puede compensar registros faltantes, dependencias inaccesibles o un test de aceptación que premia el comportamiento equivocado.
¿Qué muestran los benchmarks de Anthropic?
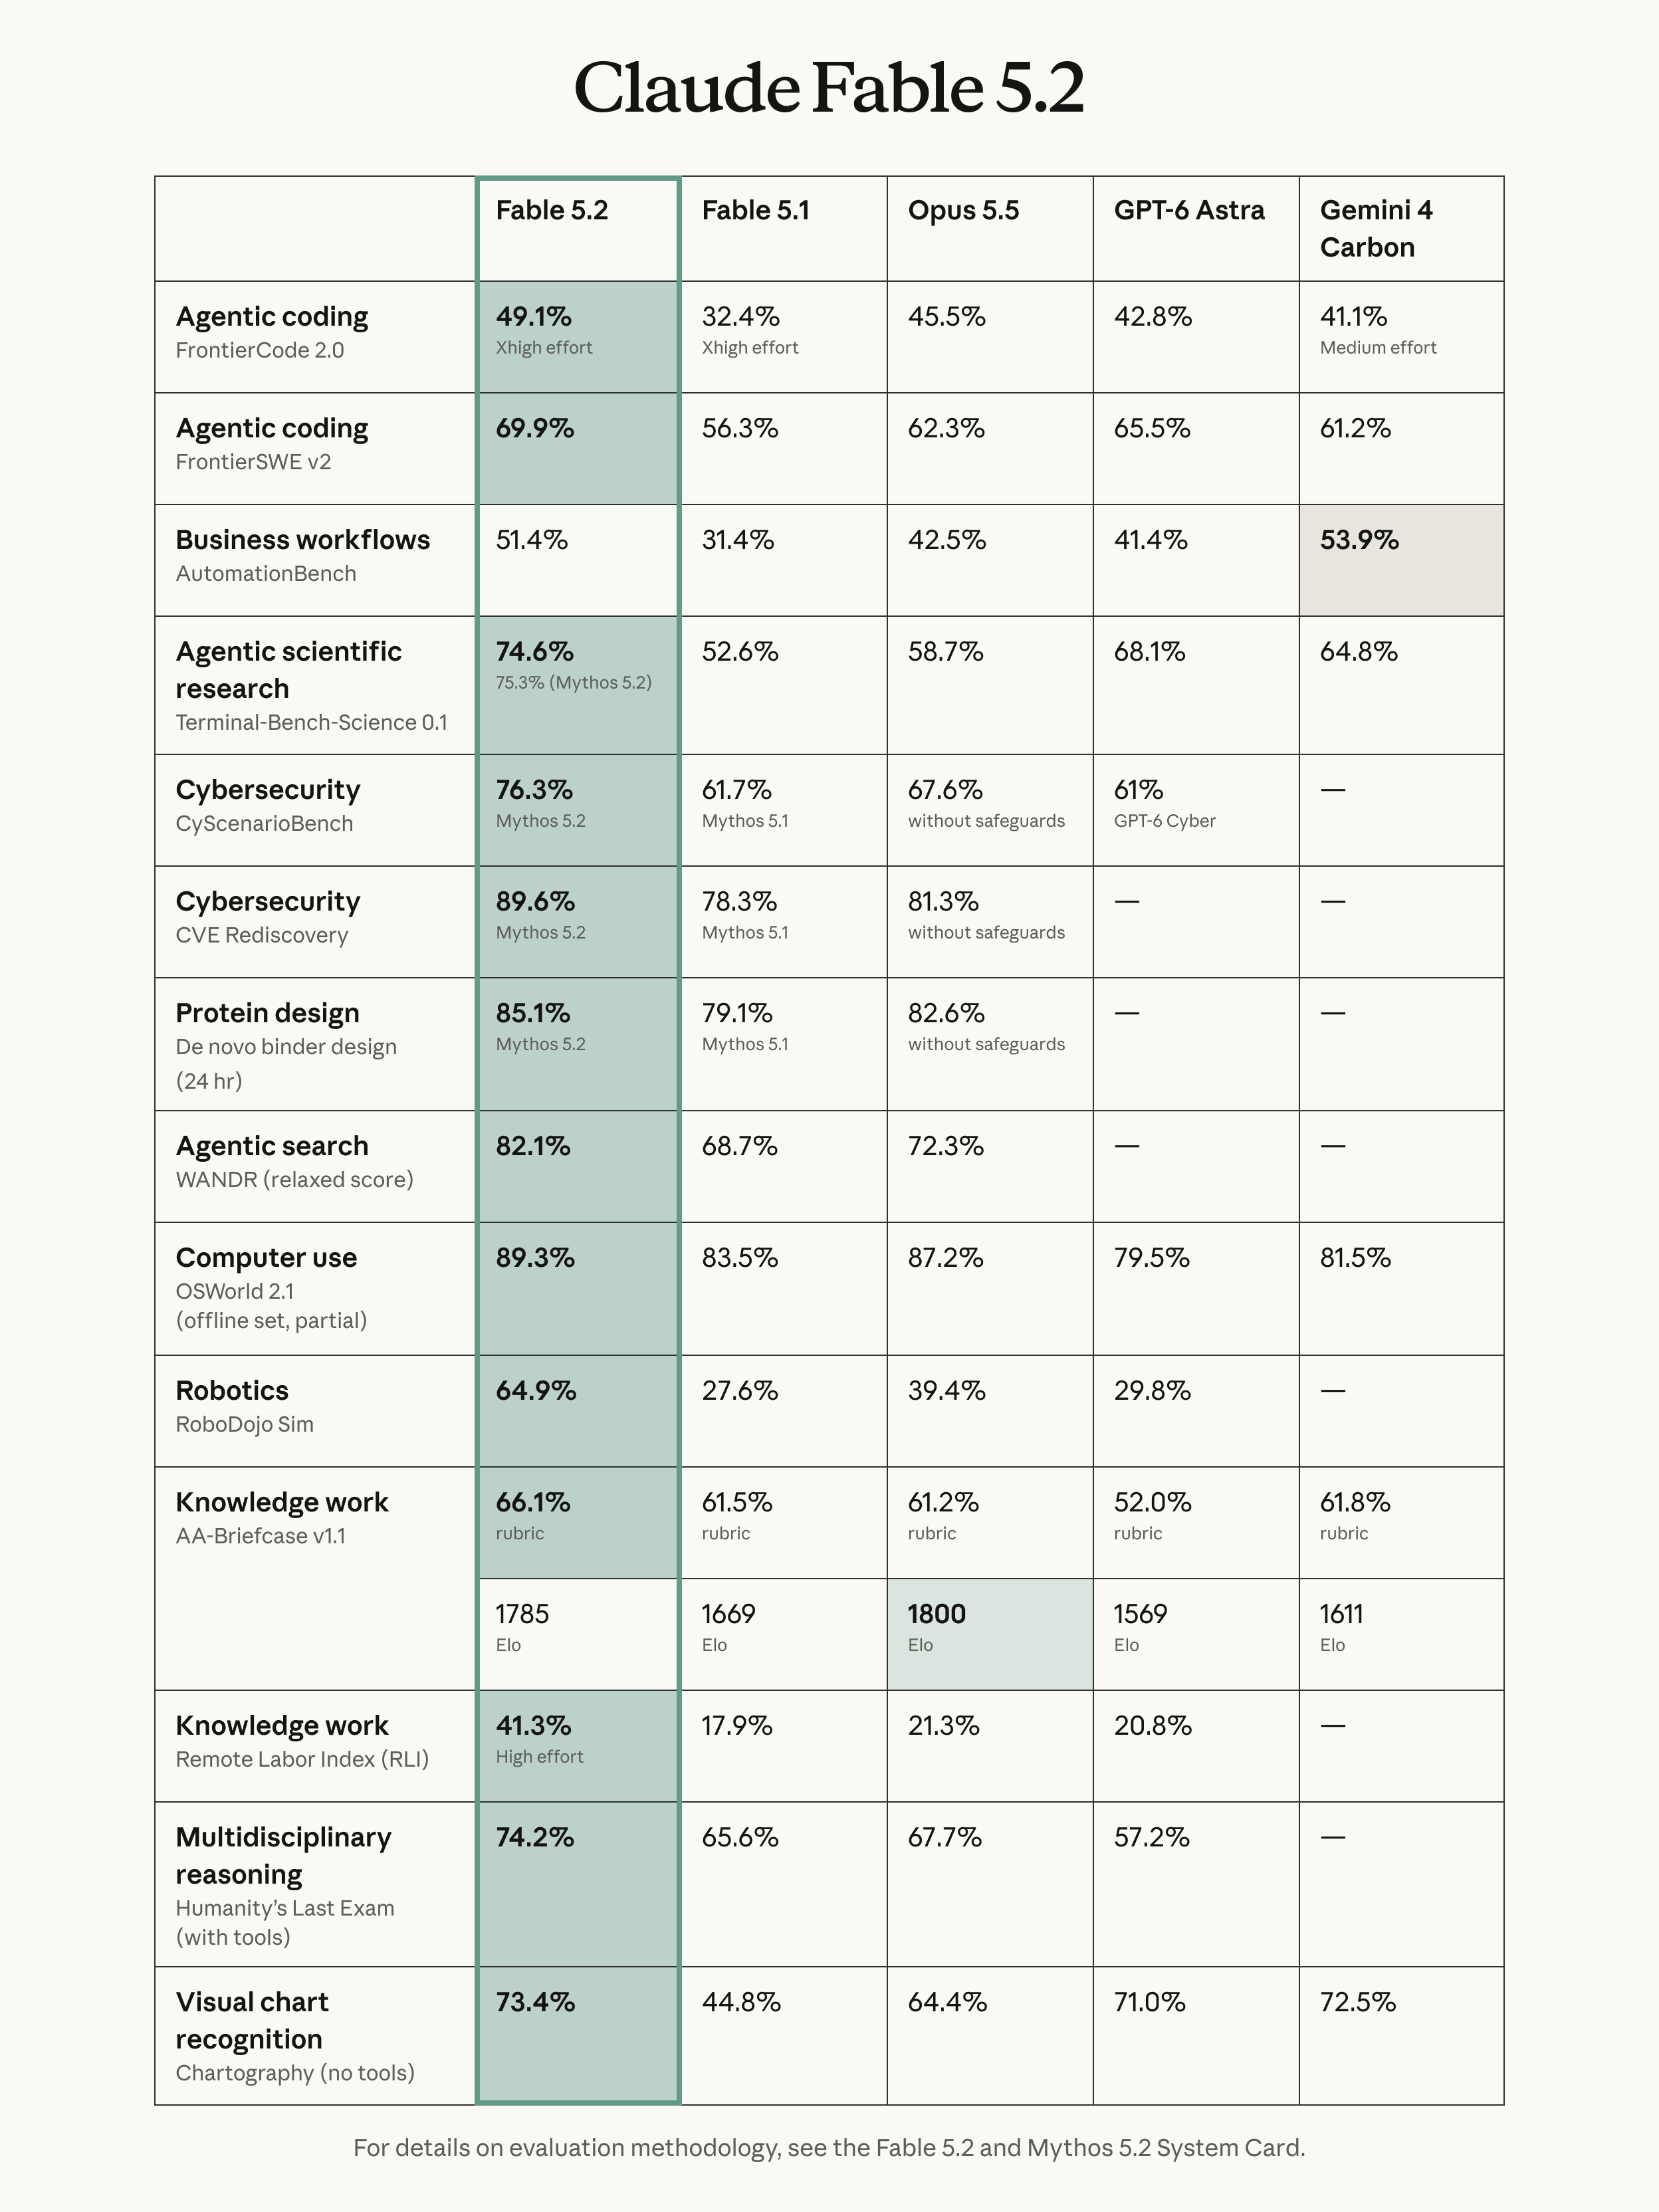
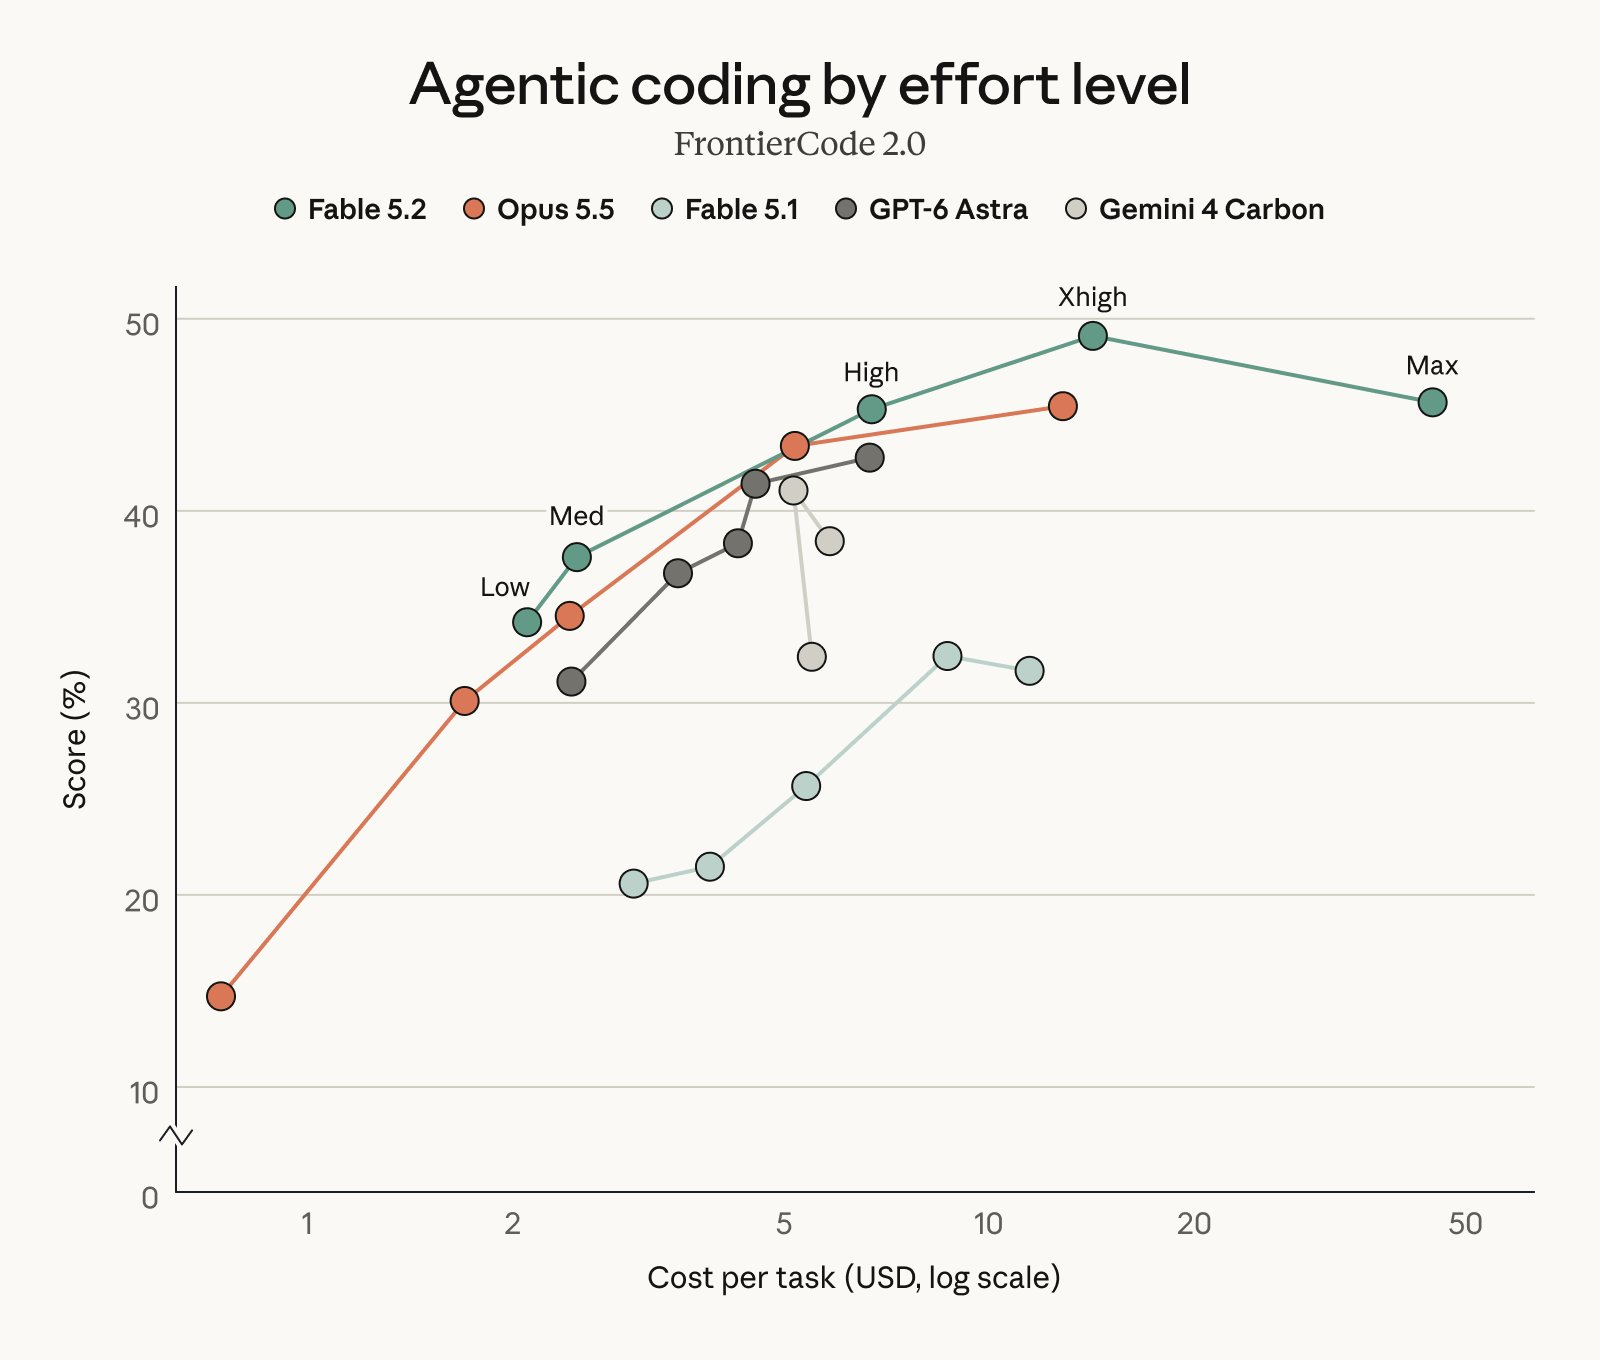
Anthropic reporta puntuaciones más altas para Fable 5.2 en varias evaluaciones de programación y razonamiento. La señal práctica más fuerte es su resultado de esfuerzo frente a costo: Fable en Alto casi iguala a Opus en Máximo en FrontierCode 2.0 con aproximadamente la mitad del costo por tarea en las pruebas iniciales de Anthropic.
| Evaluación reportada por el proveedor | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, programación agéntica | 49.1% en Xhigh | 45.5% |
| FrontierSWE v2, programación agéntica | 69.9% | 62.3% |
| WANDR, búsqueda agéntica, puntuación relajada | 82.1% | 72.3% |
| OSWorld 2.1, conjunto parcial offline | 89.3% | 87.2% |
Estas cifras provienen del anuncio, que indica que las puntuaciones usan el esfuerzo más alto disponible salvo indicación contraria. Describen las condiciones de evaluación de Anthropic, no los valores predeterminados ni una tasa de éxito esperada en tus tickets.
La comparación de costos es aún más estrecha. Fable en Alto obtiene 45.3%, frente al 45.5% de la mejor puntuación de Opus. Eso respalda probar la configuración más barata para esa evaluación. No significa que cada flujo de trabajo de Fable cueste la mitad que Opus.
Evita convertir un porcentaje de benchmark en una previsión de productividad. Una puntuación de programación no mide tu cola de revisión, el riesgo de despliegue ni el tiempo dedicado a reparar una migración incorrecta. Además, deja fuera de la ficha de Fable los resultados de ciberseguridad y biología exclusivos de Mythos: el anuncio identifica un modelo subyacente compartido pero con salvaguardas y accesos distintos.
Las configuraciones de esfuerzo cambian la comparación
Configura el esfuerzo de forma explícita al comparar modelos. Los valores predeterminados de la API son Alto para Fable 5.2 y Medio para Opus 5.5. El anuncio de Anthropic describe por separado Medio como el valor predeterminado en las apps de Claude y Claude Code. Registra el producto y la configuración en lugar de asumir que un solo valor predeterminado aplica en todas partes.
La documentación de esfuerzo define low, medium, high, xhigh y max para ambos modelos. El esfuerzo influye en el texto de respuesta, los argumentos de las herramientas y el pensamiento. Es una señal de comportamiento, no un límite estricto de gasto.
Empieza con tu configuración de Opus que ya funcione. Si se queda corta, compara un esfuerzo mayor de Opus con Fable en Medio o Alto. Reserva los pilotos con Xhigh y Máximo para tareas donde el razonamiento adicional tenga un beneficio plausible y puedas tolerar el gasto.
Una comparación con igual esfuerzo responde una pregunta: ¿cómo se comportan estos modelos bajo la misma configuración nominal? Una comparación con costos equivalentes responde otra: ¿qué configuración produce el resultado aceptable más sólido para tu presupuesto? Ninguna sustituye a la otra.
Latencia: mide toda la tarea
Ambos modelos llevan la etiqueta de latencia comparativa Moderada en la descripción general de Anthropic. Esa etiqueta no arroja un ganador universal. Mide el tiempo hasta un resultado revisado, incluidas las herramientas y los reintentos, en lugar de tratar la velocidad de salida como la velocidad de todo tu flujo de desarrollo.
Anthropic dice que Fable 5.2 genera salida hasta un 30% más rápido que Fable 5.1. Esa comparación es contra su predecesor, no contra Opus 5.5. Su modo rápido opcional ofrece hasta 2.5 veces la velocidad de generación de tokens, lo cual también es una afirmación del proveedor y no una reducción medida en la duración de tu tarea.
Una tarea dominada por la compilación o por una base de datos lenta no se acelerará en proporción a una generación de tokens más rápida. Por el contrario, un agente que evita dos enfoques fallidos puede terminar antes mientras genera tokens más lentamente. Mide estos factores por separado antes de pagar una prima de velocidad.
Compara el costo por resultado aceptado
Usa el gasto total del flujo de trabajo dividido entre los resultados aceptados como métrica de decisión. Los precios de los tokens determinan la tarifa, pero el volumen de tokens, el almacenamiento en caché, los intentos fallidos, las herramientas y la revisión determinan lo que compras. La aritmética siguiente es ilustrativa, no una medición del comportamiento de ninguno de los dos modelos.
Supón que una solicitud consume 100.000 tokens de entrada sin caché y 10.000 tokens de salida, con enrutamiento global estándar y sin cargos adicionales por herramientas:
| Configuración | Costo de entrada | Costo de salida | Total |
|---|---|---|---|
| Opus 5.5 estándar | $0.40 | $0.20 | $0.60 |
| Fable 5.2 estándar | $0.80 | $0.40 | $1.20 |
| Opus 5.5 rápido | $0.80 | $0.40 | $1.20 |
| Fable 5.2 rápido | $1.60 | $0.80 | $2.40 |
Las tarifas se verificaron contra la documentación de precios de Anthropic el 10 de noviembre de 2026. Las asignaciones de suscripción están separadas de estas tarifas de API. Los proveedores de nube, el almacenamiento en caché, las opciones de residencia y otras funciones pueden cambiar la factura.
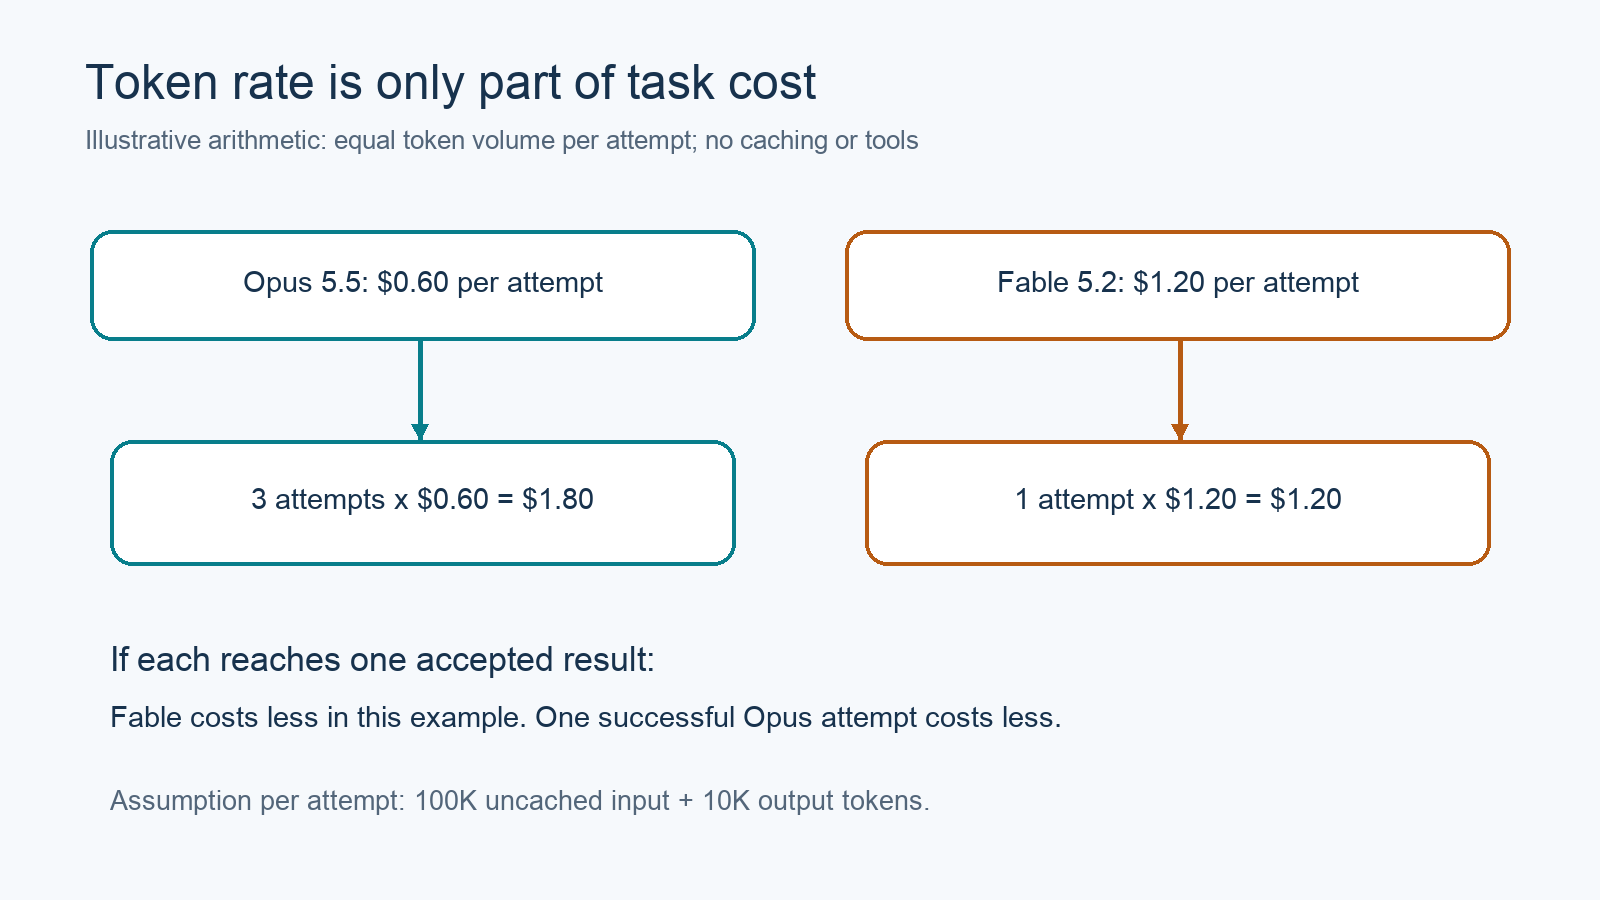
Compara todos los intentos necesarios para obtener un resultado exitoso, incluidos los reintentos y la revisión.
En este ejemplo simplificado, tres intentos de Opus con volúmenes idénticos cuestan $1.80; un intento de Fable cuesta $1.20. Eso hace que Fable sea más barato solo si alcanza el resultado aceptado en ese único intento. Un intento exitoso de Opus sigue siendo más barato. Los reintentos reales suelen consumir volúmenes distintos, así que usa el uso registrado en lugar de multiplicar un promedio estimado.
Mantén el tiempo de revisión de ingeniería junto al gasto de API. Un parche que pasa los tests pero requiere una corrección sustancial no ha superado la misma barra que un parche listo para revisión.
Deja que tu agente de programación verifique la API con Apidog CLI
Usa Apidog CLI para que tu agente de programación cree y ejecute verificaciones de API repetibles. Estas verificaciones pueden revelar regresiones en las solicitudes o respuestas cuando cambias de modelo. No establecen si los cambios del agente en el repositorio son correctos; mantén los tests del repositorio y la revisión humana junto a ellas.
Configura la CLI y luego deja que tu agente lea la guía oficial de instalación:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Dale a Claude Code o a tu agente preferido este prompt:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
El agente verifica el esquema, elige una categoría de caso de prueba válida, construye case.json y luego ejecuta comandos como estos. Las flags se verificaron contra la ayuda de la CLI 2.2.12 instalada:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Reemplaza los marcadores de posición con los recursos de tu proyecto. Esta es una plantilla de flujo de trabajo, no una comparación de modelos ejecutada. Consulta la guía de Apidog CLI en Claude Code o la guía de integración con Codex para la configuración del agente.
FAQ
¿Es Fable 5.2 mejor que Opus 5.5 para toda la programación?
No. Anthropic recomienda Opus 5.5 para la mayoría de las tareas de programación y conocimiento. Fable merece probarse cuando el trabajo difícil supera esa línea base. Sus puntuaciones de benchmark más altas del proveedor no garantizan un mejor resultado en cada tarea.
¿Fable 5.2 cuesta el doble?
Sus tarifas estándar de tokens de entrada y salida son el doble que las de Opus 5.5. El costo total de la tarea puede diferir porque las configuraciones consumen distintos tokens y requieren distinto número de intentos.
¿Deberías usar siempre el esfuerzo máximo?
No. Compara las configuraciones con tus verificaciones de aceptación y tu presupuesto. Un esfuerzo mayor permite más gasto de tokens; no garantiza una mejora útil para una tarea acotada.
¿Es Fable 5.2 más rápido que Opus 5.5?
Las fuentes revisadas aquí no establecen un ganador universal de latencia frente a frente. Ambos tienen la etiqueta de latencia Moderada. Mide tu flujo de trabajo real y trata el modo rápido como una configuración aparte.
¿Puede Apidog decidir qué modelo escribe mejor código?
Apidog CLI puede ayudar a tu agente a ejecutar verificaciones de API y recopilar evidencia de las respuestas. La calidad del código sigue necesitando tests del repositorio y revisión. Usa esos resultados aceptados para decidir qué modelo y configuración de esfuerzo justifican su costo.